

A mai világban a szolgáltatások magas rendelkezésre állását mindig és mindenhol megkövetelik, nem csupán a nagy, drága projektekben. Az időszakosan nem elérhető webhelyek, amelyek az 'Elnézést, karbantartás zajlik' üzenetet mutatják, még mindig előfordulnak, de általában csak lemondó mosolyt váltanak ki. Ehhez jön még az az élet a felhőkben, ahol egy további szerver indításához csak egy API-hívás szükséges, és nem kell a 'fém' üzemeltetéssel foglalkozni. Így már nincsenek kifogások arra, hogy miért nem készültek el megbízhatóan a kritikus rendszerek klasztertechnológiák és tartalékolás használatával.
Beszámolunk arról, milyen megoldásokat fontolgattunk az adatbázisok megbízhatóságának biztosítására a szolgáltatásainkban, és mibe torkolltak a döntéseink. Plusz egy bemutató, messzire mutató következtetésekkel.
Örökség a magas rendelkezésre állás biztosításának architektúrájában
Ez még jobban látható a különböző nyílt forráskódú rendszerek fejlődésének tükrében. A régi megoldások kénytelenek voltak magas rendelkezésre állású technológiákat hozzáadni a kereslet növekedésével. A minőségük változó volt. Az új generációs megoldások a magas rendelkezésre állást teszik architektúrájuk alapjába. Például a MongoDB klasztert alapértelmezett használati opcióként pozicionálja. A klaszter vízszintesen skálázható, ami jelentős versenyelőnyt jelent ennek az adatbázis-kezelő rendszernek.
Térjünk vissza a PostgreSQL-hez. Ez az egyik legrégebbi népszerű nyílt forráskódú projekt, amelynek első kiadása 1995-ben volt. A projekt csapata sokáig nem tartotta a magas rendelkezésre állást olyan feladatnak, amelyet a rendszer szintjén kellene megoldani. Ennek megfelelően a replikációs technológia, amely adatmásolatok létrehozását szolgálja, csak a 2006-os 8.2-es verzióban lett beépítve, de ez fájl alapú volt (log shipping). 2010-ben a 9.0-ás verzióban megjelent a folyamatmentes replikáció, amely számos klaszter létrehozásának alapját képezi. Ez valójában nagyon meglepi azokat az embereket, akik a PostgreSQL-t ismerik meg az Enterprise SQL vagy a modern NoSQL után — a közösség standard megoldása egyszerűen egy pár mester-replika szinkron vagy aszinkron replikációval. Ezenkívül a mester átkapcsolása manuálisan történik, és a kliensek átkapcsolásának kérdését is maguknak kell megoldaniuk.
Hogyan döntöttük el, hogy megbízható PostgreSQL-t készítünk, és mit választottunk ehhez
Mindazonáltal a PostgreSQL nem lenne olyan népszerű, ha nem lenne rengeteg projekt és eszköz, amelyek segítenek egy folyamatos figyelmet nem igénylő, megbízható megoldás felépítésében. A felhőben (MCS) a DBaaS indításától kezdve elérhetők voltak az egyetlen PostgreSQL szerverek és a master-replica párok aszinkron replikációval.
Természetesen szeretnénk megkönnyíteni mindenki életét, és elérhetővé tenni egy olyan PostgreSQL telepítést, amely alapját képezheti a nagy rendelkezésre állású szolgáltatásoknak, ahol nem kell folyamatosan figyelni, és nem kell éjszaka felébredni a váltás miatt. Ebben a szegmensben vannak régi, bevált megoldások és új eszközök generációja, amelyek a legfrissebb fejlesztéseket használják.
Ma a magas rendelkezésre állás problémája nem a redundanciáról szól (ez magától értetődő), hanem a konszenzusról – a vezető választási algoritmusról (Leader election). Leggyakrabban a nagy balesetek nem a szerverek hiánya miatt következnek be, hanem a konszenzussal kapcsolatos problémák miatt: nem választottak új vezetőt, vagy két vezető jelent meg különböző adatközpontokban, stb. Például – a Github MySQL klaszterének balesete – írták .
A matematikai alap ezen a téren nagyon komoly. Egyrészről létezik , amely elméleti korlátokat szab a HA megoldások kiépítésének lehetőségeire, másrészről a konszenzus meghatározásához matematikailag bizonyított algoritmusok, mint például és . Ezen a területen léteznek meglehetősen népszerű DCS-ek (decentralizált konszenzus rendszerek) – Zookeeper, etcd, Consul. Ezért, ha a döntéshozó rendszer valamilyen saját, írt algoritmuson alapul, rendkívül óvatosan kell vele bánni. Nagy mennyiségű rendszer elemzése után a Patroni mellett döntöttünk – egy open-source rendszer, amelyet főként a Zalando fejleszt.
Mint egy lírai kitérő, elmondom, hogy mi is megfontoltuk a multi-master megoldásokat, azaz azokat a klasztereket, amelyeket vízszintesen lehet skálázni írásra. Azonban két fő okból úgy döntöttünk, hogy nem készítünk ilyen klasztert. Először is, ezek a megoldások magas bonyolultsággal járnak, így több sebezhetőséget is magukban hordoznak. Nehéz lenne stabil megoldást találni minden esetre. Másodszor, ebben az esetben a PostgreSQL nem marad tiszta (native), egyes funkciók nem lesznek elérhetőek, és néhány alkalmazás esetében rejtett hibák léphetnek fel a működés során.
Patroni
Tehát hogyan működik a Patroni? A fejlesztők nem akartak újra feltalálni a kereket, ezért egy bevált DCS-megoldást javasoltak alapként. Minden szinkronizációs konfigurációval, vezetőválasztás kérdéseivel és kvórummal kapcsolatos feladatot rábíztak. Mi az etcd-t választottuk erre.
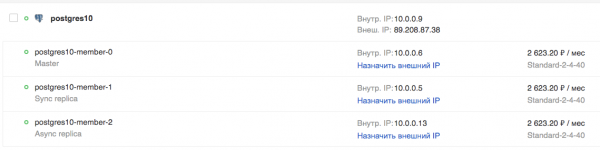
Ezt követően a Patroni a PostgreSQL beállításainak helyes alkalmazásával, a replikációs beállításokkal foglalkozik, valamint a switchover és failover parancsok végrehajtásával (azaz a mester normál és nem normál váltásával). Konkrétan a MCS felhőben létrehozhatunk egy klasztert egy mesterből, egy szinkron replikából és egy vagy több aszinkron replikából. A szinkron replika jelenléte biztosítja az adatok megőrzését legalább 2 szerveren, és ez a replika lesz a fő „mesterjelölt”.
Mivel az etcd ugyanazokon a szervereken fut, ajánlott a szerverek száma 3 vagy 5, az optimális kvórum értéke miatt. Ez a klaszter vízszintesen skálázható olvasás szempontjából (az írás skálázásáról fentebb írtam). Mindazonáltal figyelembe kell venni, hogy az aszinkron replikák hajlamosak a lemaradásra, különösen magas terhelések mellett.
Az ilyen olvasásra (hot standby) szánt replikák használata indokolt a jelentési vagy analitikai feladatokhoz, és tehermentesíti a mester szervert.
Ha szeretnél egy ilyen klasztert létrehozni önállóan, szükséged lesz rá:
- előkészíteni 3 vagy több szervert, beállítani az IP-címzést és a tűzfalszabályokat közöttük;
- telepíteni az etcd, Patroni, PostgreSQL szolgáltatások csomagjait;
- beállítani az etcd klasztert;
- beállítani a patroni szolgáltatást a PostgreSQL-hez való működéshez.
Tehát összesen körülbelül tíz konfigurációs fájlt kell létrehozni, és sehol sem hibázni. Ehhez mindenképpen érdemes konfigurációs menedzsment eszközt használni, például az Ansible-t. Mindeközben azonban itt továbbra sincs magas rendelkezésre állású TCP terheléselosztó. Ezt megcsinálni - külön munka.
Azok számára, akik kész klasztert szeretnének, de nem akarnak ezzel sokat bajlódni, igyekeztünk leegyszerűsíteni a dolgokat, és kész klasztert készítettünk Patroni-ban a felhőnkben, amelyet ingyenesen tesztelhetnek. A klaszter mellett készítettünk:
- TCP terheléselosztó; különböző portokon mindig a jelenlegi mesterre mutat, szinkron vagy aszinkron replikáló szerint;
- API a Patroni aktív mesterének váltásához.
Ezeket a felhő MCS API-n keresztül és a webes konzolon is beköthetjük.
Demos
A PostgreSQL klaszter lehetőségeinek teszteléséhez a felhő MCS-ben nézzük meg, hogyan viselkedik egy élő alkalmazás, ha problémái vannak az adatbázissal.
Az alábbiakban található az az alkalmazáskód, amely mesterséges eseményeket naplóz, és erről jelentést ad a képernyőn. Ha hibák lépnek fel, erről is tájékoztat, és folytatja a működését a ciklusban, amíg a Ctrl + C kombinációval meg nem állítjuk.
from __future__ import print_function

from datetime import datetime
from random import randint
from time import sleep
import psycopg2


def main():
    try:
        connection = psycopg2.connect(user = "admin",
                                      password = "P@ssw0rd",
                                      host = "89.208.87.38",
                                      port = "5432",
                                      database = "myproddb")

        cursor = connection.cursor()
        cursor.execute("SELECT version();")
        record = cursor.fetchone()
        print("Kapcsolódás megnyitva a(z)", record[0])

        cursor.execute(
            "INSERT INTO log VALUES ({});".format(randint(1, 10000)))
        connection.commit()
        cursor.execute("SELECT COUNT(event_id) from log;")
        record = cursor.fetchone()
        print("Egy érték naplózva, összes számosság: {}".format(record[0]))
    except Exception as error:
        print ("Hiba a PostgreSQL-hez való csatlakozáskor", error)
    finally:
        if connection:
            cursor.close()
            connection.close()
            print("Kapcsolat bezárva")


if __name__ == '__main__':
    try:
        while True:
            try:
                print(datetime.now())
                main()
                sleep(3)
            except Exception as e:
                print("Hiba elkapva:n", e)
                sleep(1)
    except KeyboardInterrupt:
        print("kilépés")
Az alkalmazás működéséhez PostgreSQL szükséges. Hozzunk létre egy klasztert a felhő MCS-ben az API használatával. A szokásos terminálban, ahol az OS_TOKEN változóban található az API-hoz való hozzáféréshez szükséges token (amelyet az openstack token issue parancs használatával kaphatunk), írjuk be a következő parancsokat:
Klaszter létrehozása:
cat < pgc10.json
{"cluster":{"name":"postgres10","allow_remote_access":true,"datastore":{"type":"postgresql","version":"10"},"databases":[{"name":"myproddb"}],"users":[{"databases":[{"name":"myproddb"}],"name":"admin","password":"P@ssw0rd"}],"instances":[{"key_name":"shared","availability_zone":"DP1","flavorRef":"d659fa16-c7fb-42cf-8a5e-9bcbe80a7538","nics":[{"net-id":"b91eafed-12b1-4a46-b000-3984c7e01599"}],"volume":{"size":50,"type":"DP1"}},{"key_name":"shared","availability_zone":"DP1","flavorRef":"d659fa16-c7fb-42cf-8a5e-9bcbe80a7538","nics":[{"net-id":"b91eafed-12b1-4a46-b000-3984c7e01599"}],"volume":{"size":50,"type":"DP1"}},{"key_name":"shared","availability_zone":"DP1","flavorRef":"d659fa16-c7fb-42cf-8a5e-9bcbe80a7538","nics":[{"net-id":"b91eafed-12b1-4a46-b000-3984c7e01599"}],"volume":{"size":50,"type":"DP1"}}]}}
EOF

curl -s -H "X-Auth-Token: $OS_TOKEN"
-H 'Accept: application/json'
-H 'Content-Type: application/json'
-d @pgc10.json https://infra.mail.ru:8779/v1.0/ce2a41bbd1434013b85bdf0ba07c770f/clusters
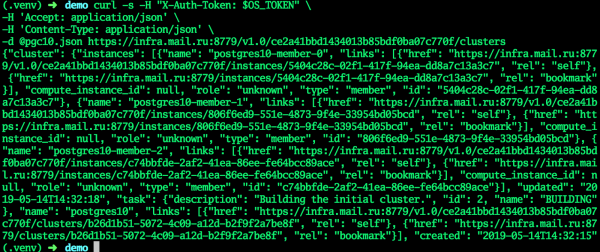
Amikor a klaszter ACTIVE állapotba kerül, minden mező a legfrissebb értékeket fogja kapni — a klaszter készen áll.
A GUI-ban:
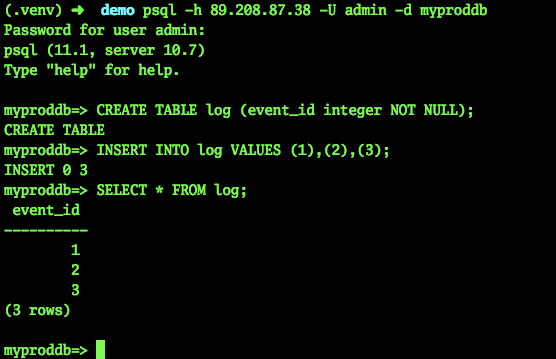
Próbáljuk meg csatlakozni és létrehozni egy táblát:
psql -h 89.208.87.38 -U admin -d myproddb
Jelszó az admin felhasználóhoz:
psql (11.1, szerver 10.7)
Írd be a "help" parancsot a segítségért.

myproddb=> CREATE TABLE log (event_id integer NOT NULL);
CREATE TABLE
myproddb=> INSERT INTO log VALUES (1),(2),(3);
INSERT 0 3
myproddb=> SELECT * FROM log;
 event_id
----------
        1
        2
        3
(3 sor)

myproddb=>
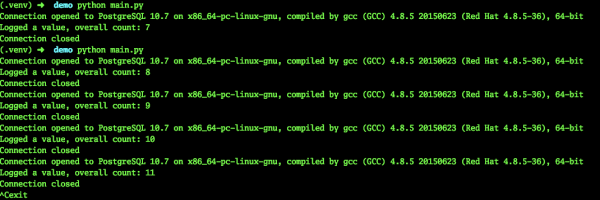
Az alkalmazásban megadjuk a megfelelő beállításokat a PostgreSQL-hez való csatlakozáshoz. Megadjuk a TCP-terheléselosztó címét, így nincs szükség manuális váltásra a mester címére. Elindítjuk. Ahogy látható, az események sikeresen logolódnak az adatbázisba.
Tervezett váltás a mesterhez
Most teszteljük az alkalmazásunk működését tervezett mester-váltás során:
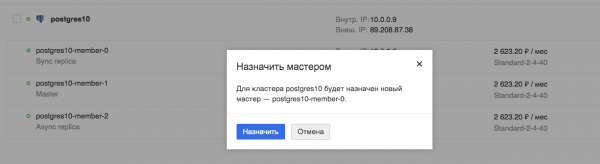
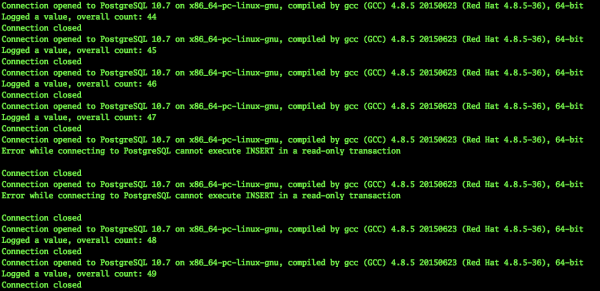
Figyeljük meg az alkalmazást. Látjuk, hogy az alkalmazás működése valóban megszakad, de ez csupán néhány másodpercig tart, ebben az esetben maximum 9 másodpercig.
Gépösszeomlás
Most próbáljuk meg szimulálni a virtuális gép összeomlását, amely a jelenlegi mester. Azonban egyszerűen le lehetne állítani a virtuális gépet a Horizon felületen, de ez a normál lekapcsolás lenne. Ezt a váltást minden szolgáltatás feldolgozná, beleértve a Patronit is.
Viszont nekünk váratlan leállításra van szükségünk. Ezért kértem az adminisztrátorainktól, hogy tesztelési célból állítsák le a virtuális gépet — a jelenlegi mestert — nem szokványos módon.
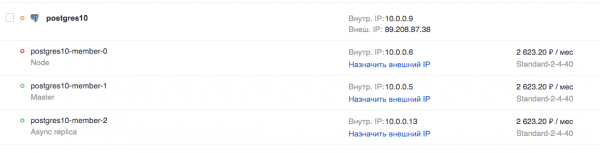
Ez idő alatt az alkalmazásunk folytatta a működését. Természetesen egy ilyen sürgősségi mester-váltás nem mehet észrevétlenül.
2019-03-29 10:45:56.071234
Kapcsolat nyitva a PostgreSQL 10.7-hez x86_64-pc-linux-gnu, gcc (GCC) 4.8.5 20150623 (Red Hat 4.8.5-36) által készítve, 64-bites
Egy érték bejegyezve, összesen: 453
Kapcsolat zárva
2019-03-29 10:45:59.205463
Kapcsolat nyitva a PostgreSQL 10.7-hez x86_64-pc-linux-gnu, gcc (GCC) 4.8.5 20150623 (Red Hat 4.8.5-36) által készítve, 64-bites
Egy érték bejegyezve, összesen: 454

Kapcsolat zárva
2019-03-29 10:46:02.661440
Hiba lépett fel a PostgreSQL szerverhez való csatlakozás során, a kapcsolat váratlanul zárva
        Ez valószínűleg azt jelenti, hogy a szerver rendellenesen leállt
        a kérés feldolgozása előtt vagy közben.

Elfogott hiba:
 helyi változó 'connection' hivatkozva lett, mielőtt inicializálva lett volna
……………………………………………………….. - itt egy bizonyos számú hiba található
2019-03-29 10:46:30.930445
Hiba lépett fel a PostgreSQL szerverhez való csatlakozás során, a kapcsolat váratlanul zárva
        Ez valószínűleg azt jelenti, hogy a szerver rendellenesen leállt
        a kérés feldolgozása előtt vagy közben.

Elfogott hiba:
 helyi változó 'connection' hivatkozva lett, mielőtt inicializálva lett volna
2019-03-29 10:46:31.954399
Kapcsolat nyitva a PostgreSQL 10.7-hez x86_64-pc-linux-gnu, gcc (GCC) 4.8.5 20150623 (Red Hat 4.8.5-36) által készítve, 64-bites
Egy érték bejegyezve, összesen: 455
Kapcsolat zárva
2019-03-29 10:46:35.409800
Kapcsolat nyitva a PostgreSQL 10.7-hez x86_64-pc-linux-gnu, gcc (GCC) 4.8.5 20150623 (Red Hat 4.8.5-36) által készítve, 64-bites
Egy érték bejegyezve, összesen: 456
Kapcsolat zárva
^Cexit
Mint látható, az alkalmazás kevesebb mint 30 másodperc alatt képes volt folytatni a működését. Igen, egy bizonyos számú felhasználó észlelheti a problémákat. Azonban ez egy komoly szerverhiba, ami nem túl gyakran fordul elő. Az administrator valószínűleg nem tudott volna ennyire gyorsan reagálni, hacsak nem ült éppen a konzolon készenlétben egy váltószkripttel.
Következtetés
Szerintem egy ilyen klaszter hatalmas előnyt nyújt az adminisztrátorok számára. Lényegében a súlyos hibák és az adatbázis-szerverek meghibásodása nem lesz észlelhető az alkalmazás vagy a felhasználó számára. Nem kell kapkodva javítani valamit és ideiglenes konfigurációkra, szerverekre váltani. És ha ezt a megoldást kész szolgáltatásként a felhőben használják, akkor nem kell időt tölteni a felkészüléssel. Más érdekes dolgokkal lehet foglalkozni.
Forrás: habr.com
