

Egy felhasználó új adathordozót szeretne írni a merevlemezére, de hiányzik a szabad hely ehhez. Törölni sem akar semmit, hiszen "minden nagyon fontos és szükséges". Mit tegyünk vele?
Ez a probléma nem csak nála merül fel. Merevlemezeink terabájtnyi információt tárolnak, és ez a mennyiség nem csökken. De mennyire egyedi ez? Végül is, minden fájl csak egy adott hosszúságú bitek halmaza, és valószínű, hogy az új fájl nem sokban különbözik azoktól, amik már tárolva vannak.
Nyilvánvaló, hogy a már tárolt információs darabok keresése a merevlemezen nem túl hatékony feladat. Másrészt, ha a különbség kicsi, akkor talán egy kicsit lehetne igazítani rajta…
TL;DR — második kísérlet, hogy egy furcsa adatoptimalizálási módszerről meséljek JPEG-fájlok segítségével, most érthetőbb formában.
A bitekről és a különbségről
Ha két teljesen véletlen adatdarabot veszünk, akkor átlagosan a benne lévő bitek fele egybeesik. Valóban, a lehetséges kombinációk mindkettője (’00, 01, 10, 11′) közül pontosan fele rendelkezik egybeeső értékekkel, itt minden egyértelmű.
De természetesen, ha egyszerűen csak két fájlt veszünk, és egyiket a másikhoz igazítjuk, akkor az egyiknek a feláldozásával járunk. Ha viszont megőrizzük a változásokat, akkor csak újból feltaláljuk , ami már nélkületlen is jól működik, bár nem szokták ilyen célokra használni. Megpróbálhatunk kisebb szekvenciákat beépíteni egy nagyobba, de még így is kockázatot vállalunk kritikus adatszegmensek elvesztésével, ha nem gondolkodunk előre.
Két dolog között hogyan lehet eltüntetni a különbséget? Tehát a felhasználó által írt új fájl egyszerűen csak bitek sorozata, amellyel önmagában nem tudunk mit kezdeni. Csak meg kell találni a merevlemezen olyan biteket, amelyeket módosíthatunk anélkül, hogy szükség lenne a különbség tárolására, hogy ezt a veszteséget komoly következmények nélkül túlélhessük. És nemcsak a fájl felületén való módosításnak van értelme, hanem valamilyen kevésbé érzékeny információ megváltoztatásának is. De milyennek és hogyan?
A hozzáigazolási módszerek
A segítségünkre jönnek a veszteségesen tömörített fájlok. Mindezek a jpeg, mp3 és egyéb formátumok, bár veszteséges tömörítést használnak, rengeteg bitet tartalmaznak, amelyek biztonságosan módosíthatók. Fejlettebb technikákat lehet alkalmazni, amelyek észrevétlenül módosítják ezeket az összetevőket a kódolás különböző szakaszaiban. Várj. Fejlettebb technikák… észrevétlen módosítás… egyik bit a másikba… hát ez majdnem !
Tényleg, egy információ beillesztése a másikba éppen úgy emlékeztet a módszereire. Az is lenyűgöző, hogy a végrehajtott változtatások észlelhetetlensége az emberi érzékszervek számára. Itt azonban eltérnek az utak — a titkosság a kulcs: a felhasználó számára további információt kell bevinni a merevlemezére, ami csak árthat neki. Még el is felejti.
Ezért, bár használhatjuk őket, bizonyos módosításokat kell végrehajtani. A következőben egy létező módszer és egy népszerű fájlformátum példáján keresztül fogom bemutatni ezeket.
A sakálokról
Ha már tömörítünk, akkor a világ legegyszerűbben tömöríthető formátumát kell figyelembe venni. Természetesen a JPEG-fájlokról van szó. Nemcsak azért, mert rengeteg eszköz és meglévő módszer áll rendelkezésre az adatok beillesztésére, hanem mert ez a legnépszerűbb grafikai formátum a földön.
Ennek ellenére, hogy ne foglalkozzunk a kutyatenyésztéssel, korlátozni kell a tevékenységünket ezen formátum fájljaira. Senki sem szereti a túlságosan tömörítéstől származó egyszínű négyzeteket, ezért a már tömörített fájlokkal kell dolgozni, elkerülve a re-kódolást. Konkrétabban — a teljes számú tényezőkkel, amelyek megmaradnak az adatok elvesztéséért felelős műveletek után — DCT és kvantálás, amit tökéletesen tükröz a kódolási ábra (köszönet a Bauman Nemzeti Könyvtár Wikipédiájának):
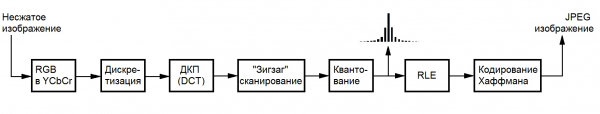
Számos lehetséges módszer létezik a jpeg-fájlok optimalizálására. Van veszteség nélküli optimalizálás (jpegtran), van a ‘‘, amely valójában még milyen változtatásokat hoz, de minket ez nem érdekel. Mert ha a felhasználó hajlandó egy információt egy másikba beilleszteni a merevlemez szabad helyének növelése érdekében, akkor a képeit vagy rég optimalizálta, vagy teljesen elkerüli azt a minőségvesztéstől való félelem miatt.
F5
Ezeknek a feltételeknek megfelel egy egész algoritmuscsalád, amelyről érdemes tájékozódni. . A legfejlettebb közülük a Andreas Westfeldt szerződésével, amely a fényesség komponenseinek arányával működik, mivel az emberi szem a legkevésbé érzékeny a változásaikra. Ráadásul a mátrixkódolás alapú beágyazási technikát alkalmazza, amely lehetővé teszi, hogy az egyes információk beágyazásakor a módosítások száma az adott konténer méretének növelésével csökkenjen.
A módosítások lényege, hogy a tényezők abszolút értékének csökkentése egy adott körülmény között (tehát nem mindig) lehetővé teszi az F5 használatát az adatok tárolásának optimalizálására. Az a helyzet, hogy a tényező a módosítás után valószínűleg kevesebb bitet foglal el a Huffman-kódolás során a JPEG értékek statisztikai eloszlása miatt, és az új nullák előnyösebbek lesznek RLE kódoláskor.
A szükséges módosításokat a titkosságot biztosító részek (jelszósor) eltávolítására kell korlátozni, ami erőforrásokat és feldolgozási időt takarít meg, míg egyidejűleg lehetőséget biztosít több fájl kezelésére, nem pedig egy fájlra. A változtatás folyamata valószínűleg nem érdekes a kedves olvasónak, ezért térjünk át a megvalósítás leírására.
Magas technológia
A megközelítés működésének bemutatása érdekében egy tiszta C nyelven valósítottam meg a módszert, és számos optimalizálást végeztem, mind a végrehajtás sebességében, mind a memóriában (el sem tudja képzelni, mennyire nehezek ezek a képek tömörítés nélkül, még DCT esetén is). A platformfüggetlenséget könyvtárak kombinációjának felhasználásával értem el. , és , ezért köszönet nekik. Mindezt a 'make'-el lehet összeállítani, így a Windows felhasználóknak javasolt valamilyen Cygwin telepítése vagy a Visual Studio és a könyvtárak önálló kezelése.
A megvalósítás konzolprogram és könyvtár formájában érhető el. A legutóbbi használatáról a GitHubon található repository README-jében tájékozódhatnak, a linket a bejegyzés végén meg fogom osztani.
Hogyan használható?
Óvatosan. Az összegyűjtött képek a megadott gyökérkönyvtárban végzett reguláris kifejezéssel történő keresés alapján kerülnek kiválasztásra. A fájlok befejezése után tetszés szerint áthelyezhetők, átnevezhetők és másolhatók a területen belül, lehetőség van fájl- és operációs rendszer változtatására is. Azt azonban rendkívül fontos megjegyezni, hogy a közvetlen tartalom megváltoztatása tilos. Még egy bit értékének elvesztése is helyrehozhatatlanná teheti az információt.
A munka befejezése után a segédprogram egy speciális archív fájlt hagy, amely tartalmazza az összes szükséges információt a kicsomagoláshoz, beleértve a felhasznált képek adatait. Maga a fájl körülbelül néhány kilobájt nagyságú, és nem gyakorol lényeges hatást a felhasznált lemezterületre.
A lehetséges kapacitás elemzése a '-a' kapcsolóval végezhető: './f5ar -a [keresési mappa] [Perl-kompatibilis reguláris kifejezés]'. A tömörítést a következő parancs végzi: './f5ar -p [keresési mappa] [Perl-kompatibilis reguláris kifejezés] [tömörített fájl] [archív név]', a kicsomagolás pedig: './f5ar -u [archív fájl] [visszaállított fájl neve]'.
A bemutató működése
A módszer hatékonyságának bemutatásához feltöltöttem egy 225 darab, teljesen ingyenes kutyás fényképből álló gyűjteményt a szolgáltatásból. és felfedeztem a dokumentumok között egy 45 méter hosszú pdf-et a második kötetből Knuth.
A sorrend meglehetősen egyszerű:
$ du -sh knuth.pdf dogs/
44M knuth.pdf
633M dogs/

$ ./f5ar -p dogs/ .*jpg knuth.pdf dogs.f5ar
Fájl tömörítése... rendben
Az archív kezdeményezése... rendben
A könyvtár kapacitásának elemzése... kész 17,0 másodperc alatt
Bizonyos fokú biztos kapacitás: 48439359 bájt
Lehetséges kapacitás maximum: 102618787 bájt
Tömörítés... kész 39,4 másodperc alatt
Az archív mentése... rendben

$ ./f5ar -u dogs/dogs.f5ar knuth_unpacked.pdf
Az archív kezdeményezése... rendben
Az archív fájl olvasása... rendben
A fájlokkal történő feltöltés... kész 1,4 másodperc alatt
Kicsomagolás... kész 21,0 másodperc alatt
Kibővített adatok írása... rendben

$ sha1sum knuth.pdf knuth_unpacked.pdf
5bd1f496d2e45e382f33959eae5ab15da12cd666 knuth.pdf
5bd1f496d2e45e382f33959eae5ab15da12cd666 knuth_unpacked.pdf

$ du -sh dogs/
551M dogs/
Képernyőképek a szerelmeseinek
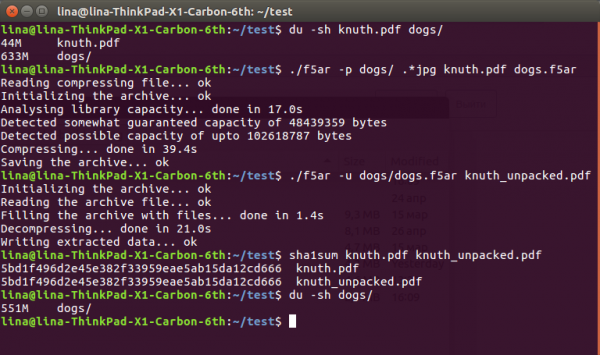
A kibővített fájl még mindig olvasható, és olvasni is kell:
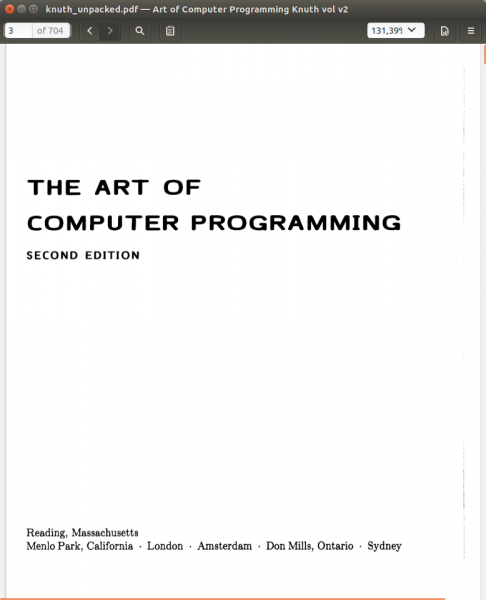
Mint látható, a kezdeti 633 + 36 == 669 megabájt adatról 551-re jutottunk a merevlemezen. Ez a radikális különbség a következő szorosabb arányok csökkenésének köszönhető, amelyek befolyásolják a későbbi veszteség nélküli tömörítést: egyetlen egység csökkentése akár néhány bájtot is 'levághat' a végső fájlból. Mindazonáltal ezek még mindig adathalmozódások, bár rendkívül kicsik, amelyeket el kell fogadni.
Szerencsére a szem számára teljesen láthatatlanok. A spoileren (mivel a habrastorage nem tudja kezelni a nagy fájlokat) az olvasó értékelheti a különbséget, mind vizuálisan, mind az intenzitásukban, ami az értékek módosított komponensből az eredetiből való kivonásával nyert: , , (minél sötétebb a szín, annál kisebb a különbség a blokkban).
Összegzésként
Mindezeket a nehézségeket nézve a merevlemez vásárlása vagy az összes adat felpakolása a felhőbe sokkal egyszerűbb megoldásnak tűnhet. De bár manapság egy csodás időben élünk, semmi garancia nincs arra, hogy holnap is elérhetjük az internetet és biztonságosan feltölthetjük a felesleges adatainkat valahová. Vagy bemehetünk a boltba, és megvehetjük a következő ezer terabájtos merevlemezt. Viszont a már otthon lévő merevlemezeket mindig is felhasználhatjuk.
->
Forrás: habr.com
