

Az ETL komponens az adattárolóban gyakran a tároló árnyékában marad, és kevesebb figyelmet kap, mint a fő adatbázis vagy a frontális komponens, a BI, a jelentéskészítés. Ugyanakkor a tároló adatokkal való feltöltésének mechanikája szempontjából az ETL kulcsszerepet játszik, és nem kevesebb figyelmet igényel az adminisztrátoroktól, mint a többi komponens. A nevem Alexander, jelenleg az ETL-t adminisztrálom a Rosztelekomnál, és ebben a cikkben megpróbálom megosztani azt, amivel az adminisztrátorok egy ismert ETL rendszerben a Rosztelekmon szembesülnek.
Ha a tisztelt olvasók már ismerik a projektünket az adattárolóról és az Informatica PowerCenter termékről, akkor közvetlenül átugorhatnak a következő szakaszra.
Néhány évvel ezelőtt a Rosztelekmon megérett és életre kelt az egyesített vállalati adattároló ötlete. Számos adattároló, amelyek különféle feladatokat láttak el, már létrejött, de a forgatókönyvek száma nőtt, a támogatási költségek is emelkedtek, és világossá vált, hogy a központosítás a jövő. Építészeti szempontból ez a tároló több rétegből áll, Hadoop és GreenPlum alapú, segédadatbázisokkal, ETL mechanizmusokkal és BI-val.
A sok földrajzilag elosztott, heterogén adatforrás miatt egy speciális adatexport mechanizmus jött létre, amelynek működését az Informatica irányítja. Ennek eredményeként az adatcsomagok a Hadoop interfész területén kerülnek elhelyezésre, majd elkezdődnek az adatok rétegek közötti betöltési folyamatai, a Hadoopba és a GreenPlumba, amelyeket az Informatica-ban megvalósított úgynevezett ETL irányító mechanizmus kezel. Így az Informatica rendszere egyike a tároló működését biztosító kulcselemeknek.
Részletesebben a tárolónkról a következő bejegyzések egyikében fogunk beszélni.
Az Informatica PowerCenter/Big Data Management jelenleg az adatintegrációs eszközök terén vezető szoftvernek számít. Ez az Informatica amerikai cég terméke, amely az ETL (Extract Transform Load), az adatok minőségének kezelésében, MDM (Master Data Management), ILM (Information Lifecycle Management) és más területeken az egyik legerősebb szereplő.
A általunk használt PowerCenter egy integrált Tomcat alkalmazásszerver, amelyen az Informatica alkalmazások futnak, megvalósítva a szolgáltatásait:
Domain, lényegében ez az alapja mindennek, a tartomány keretein belül működnek a szolgáltatások, felhasználók és GRID komponensek.
Administrator Console, webes irányító és monitorozó eszköz, az Informatica Developer kliens mellett a fő eszköz a termékkel való interakcióhoz
MRS, Model Repository Service, a metaadatok tárolója, egy réteg a fizikai tárolási adatbázis és az Informatica Developer kliens között, amelyben a fejlesztés zajlik. A repozitóriumok tárolják az adatok leírását és egyéb információkat, beleértve más Informatica szolgáltatásokhoz, például a feladatok ütemezéséhez (Schedules) vagy a monitorozási adatokhoz szükséges parameterset-eket, amelyek lehetővé teszik, hogy ugyanazt az alkalmazást különböző adatforrásokkal és -fogadókkal használják.
DIS, Data Integration Service, ez a szolgáltatás, ahol a fő funkcionális folyamatok történnek, az alkalmazások működnek, és itt kerül sor a Workflows (mappingek és azok interakcióinak leírása) és Mappings (transzformációk, blokkok, ahol a tényleges átalakítások, adatfeldolgozás zajlik) indítására.
GRID konfiguráció – lényegében egy komplexum létrehozásának lehetősége több szerver felhasználásával, ahol a DIS által generált terhelés a node-ok (azaz a domainbe tartozó szerverek) között kerül elosztásra. Ebben az esetben, a DIS terhelésének elosztása mellett a GRID egy további absztrakciós réteget biztosít, amely több node-ot egyesít, és amin a DIS működik, nem egyetlen node-on. További tartalék MRS példányokat is lehet létrehozni. Magas rendelkezésre állás megvalósítható, amikor a külső kérések a tartalék node-okon keresztül is teljesíthetők, ha a fő node meghibásodik. Ezt a megvalósítást egyelőre nem választottuk.
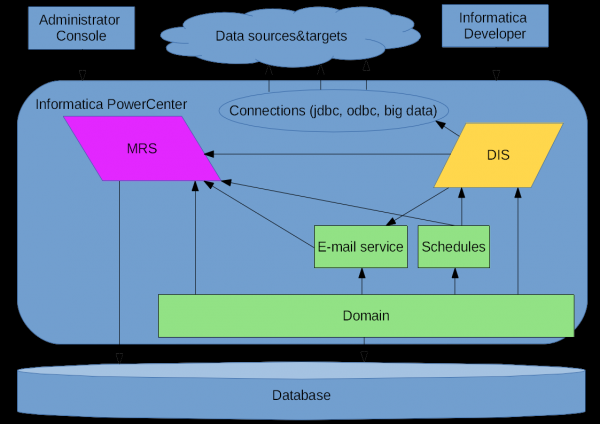
Informatica PowerCenter, schematikus
A data supply chain első szakaszaiban rendszeresen felmerültek problémák, néhányat az Informatica akkor még instabil működése okozott. Meg szeretném osztani néhány emlékezetes pillanatot ebből a sagából - az Informatica 10 elsajátítása.
Az Informatica korábbi logója
A felelősségi körünkbe tartozik más Informatica környezetek is, amelyek saját speciális követelményeikkel bírnak a különböző terhelések miatt, de most főként arról fogok beszélni, hogyan fejlődött az Informatica mint az adathalmozó ETL komponense.
Hogyan történt ez?
2016-ban, amikor átvettük az Informatica működésének felelősségét, az már a 10.0 verziónál járt, és a derűlátó kollégák számára, akik a termék komoly megoldásban a kisebb verziót választották, egyértelmű volt — a legújabb verziót kell használni! A hardver erőforrások szempontjából minden jó volt abban az időszakban.
2016 tavaszán a Informatica működését egy alvállalkozó irányította, és a rendszer kevés felhasználójának elmondása szerint 'hetente pár alkalommal működött'. Fontos megjegyezni, hogy a tároló de facto a PoC szakaszban volt, nem voltak adminisztrátorok a csapatban, és a rendszer folyamatosan összeomlott különböző okok miatt, amely után az alvállalkozó mérnöke újraindította.
Ősszel a csapatban megjelent három adminisztrátor, akik megosztották a felelősségi területeiket, és elkezdődött a normális üzemeltetési munka az informatikai rendszerek körül, beleértve az Informatica-t is. Külön meg kell említeni, hogy ez a termék nem elterjedt, és nincs nagy közössége, ahol bármilyen kérdésre választ találhatnánk, vagy problémát megoldhatnánk. Ezért nagyon fontos volt a teljes körű technikai támogatás az orosz Informatica partnertől, amely segített az összes hibánk és a fiatal Informatica 10 hibáinak javításában.
Az első dolog, amit meg kellett tennünk a csapatunk és az alvállalkozó fejlesztői számára — stabilizálni az Informatica működését, és elérni az adminisztrációs webkonzolt (Informatica Administrator) működőképességét.
Így gyakran találkoztunk az Informatica fejlesztőivel.
A fő ok, amiért a szoftveres leállások történtek, az a Informatica szoftver és a távoli adatbázis közötti interakciós séma volt, amely a hálózati táj felett viszonylag távoli szerveren helyezkedett el. Ez késedelmeket okozott, és megzavarta az Informatica domain állapotának ellenőrzéséért felelős mechanizmusok működését. A tároló optimalizálása, az adatbázis paramétereinek módosítása, amelyek toleránsabbá tették az Informatica-t a késések iránt, végül a Informatica 10.1 verzióra való frissítése és az adatbázis áthelyezése a korábbi szerverről a Informatica-hoz közelebb elhelyezkedő szerverre megoldotta a problémát, és azóta hasonló leállások nem fordultak elő.
Az Informatica Monitor működésének elérése érdekében tett egyik kísérlet
A rendszeradminisztrációval kapcsolatban is kritikus volt a helyzet. Mivel aktív fejlesztés folyt egy feltételesen éles környezetben, a kollégák folyamatosan szükségét érezték a mappings és workflow-k "akkor és ott" történő elemzésének. Az új Informatica Data Integration Service-jében nem létezett külön eszköz az ilyen típusú megfigyeléshez, de a webes adminisztrációs konzolban megjelent egy monitoring részleg (Informatica Administrator Monitor), ahol nyomon követhettük az alkalmazások, workflow-k és mappings munkáját, futtatásait és naplóit. Időszakosan teljesen hozzáférhetetlenné vált a konzol, vagy lehetetlenné vált a DIS aktuális folyamatainak adatait frissíteni, vagy hiba lépett fel az oldalak betöltésekor.
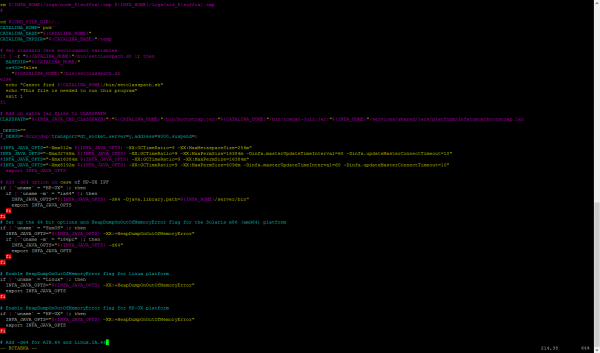
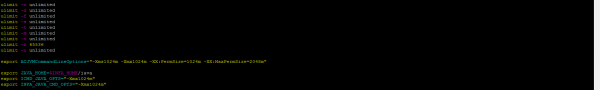
Java paraméterek beállítása a működés stabilizálása érdekében
A probléma megoldása sokféle úton haladt, kísérletek történtek a paraméterek módosítására, naplókat, jstack fájlokat gyűjtöttek, amelyeket a támogatásnak küldtek, párhuzamosan intenzív keresés folyt, és egyszerűen figyelni kezdték a folyamatokat.
Elsősorban egy külön MRS készült a monitorozásra, ami később kiderült, hogy az egyik legfőbb erőforrás-felhasználó a környezetünkben, mivel a mappings futtatásai nagyon intenzívek voltak. Megváltoztatták a java heap-re vonatkozó paramétereket, és számos egyéb paramétert is.
Ennek eredményeként a következő Informatica 10.1.1 frissítésre a konzol és a monitor működését sikerült stabilizálni, a fejlesztők hatékonyabban kezdtek dolgozni, és a rendszeres folyamatok egyre rendszerezettebbé váltak.
Érdekes tapasztalat lehet a fejlesztés és az adminisztráció közötti interakció. A kérdés, hogy közös megértéssel bírjunk arról, hogyan működik minden, és mit lehet, illetve mit nem lehet tenni, mindig fontos a bonyolult rendszerek használatakor. Ezért bátran ajánlom először kiképezni az adminisztrátorok csapatát arra, hogyan kell kezelni a szoftvert, és a fejlesztők csapatát arra, hogyan kell kódot írni és folyamatokat modellezni a rendszerben, majd utána küldeni őket a munkába az eredmény érdekében. Ez valóban fontos, amikor az idő nem végtelen erőforrás. Sok problémát véletlenszerű próbálgatással is meg lehet oldani, de néha néhány eset előzetes tudást igényel — a mi esetünk megerősíti ennek az axiómának a fontosságát.
Például, amikor megpróbáltuk aktiválni a verziókezelést az MRS-ben (ahogy végül kiderült, egy másik SVN verzióra volt szükség), egy idő után aggasztóan tapasztaltuk, hogy a rendszer újraindítási ideje több tucat percre nőtt. Miután felfedeztük a késedelmes indítás okát és deaktiváltuk a verziókezelést, minden visszatért a normális kerékvágásba.
Az Informatica-val kapcsolatos figyelemre méltó akadályok között említhetjük a növekvő Java szálakkal vívott epikus harcot. Egy ponton elérkezett az idő a másolásra, azaz a megszervezett folyamatok kiterjesztésére a forrásszámok széles körére. Ekkor kiderült, hogy messze nem minden folyamat működött jól a 10.1.1 verzióban, és egy idő után a DIS működésképtelenné vált. Tízezres nagyságrendű szálakat észleltünk, melyek száma különösen a alkalmazások telepítésekor növekedett. Néha naponta többször is újra kellett indítani a rendszert a működés helyreállítása érdekében.
Itt köszönetet kell mondani a támogatásnak, viszonylag gyorsan lokalizálták és javították a problémákat EBF (Emergency Bug Fix) segítségével – ezután mindenkinek olyan érzése volt, hogy az eszköz valóban működik.
Mégis működik!
A munkavégzés célzott üzemmódba lépésekor az Informatica a következőképpen nézett ki. Informatica 10.1.1HF1 (HF1 a HotFix1, a gyártó által létrehozott EBF csomagból) dolgozott, kiegészítő EBF-ekkel, amelyek orvosolták a méretezési problémáinkat és néhány egyéb gondot, egy a három GRID-be tartozó szerveren, 20 x86_64 maggal és tárolóval, egy hatalmas, lassú helyi lemezekből álló tömbön. szerver konfiguráció Hadoop klaszterhez. Egy másik, ugyanilyen szerveren található az Oracle DB, amelyhez az Informatica domain és az ETL vezérlési mechanizmus kapcsolódik. Mindezt a csapat által használt szokványos monitorozó eszközökkel figyeljük (Zabbix + Grafana), mindkét fél - maga az Informatica és annak szolgáltatásai, valamint a betöltési folyamatok, amik zajlanak. Jelenleg a teljesítmény és a működés stabilitása, figyelembe véve a külső tényezőket, a terhelés korlátozására vonatkozó beállításoktól függ.
Érdemes külön beszélni a GRID-ről. A környezet három node-on alakult ki, lehetőséggel a terhelés egyensúlyozására. Azonban a tesztelés során kiderült, hogy a futó példányok közötti interakciós problémák miatt ez a konfiguráció nem működött az elvárt módon, és átmenetileg elvetettük ezt a felépítési sémát, két node-ot kiemelve a domainből. A séma mindazonáltal változatlan maradt, és most ez valóban egy GRID-szolgáltatás, de lecsökkentve egy node-ra.
Jelenleg továbbra is bonyodalmak merülnek fel a monitorozó séma rendszeres tisztítása során bekövetkező teljesítménycsökkenés miatt - egyszerre folyamatban lévő CHNN folyamatok és a futó tisztítás mellett a vezérlési mechanizmus ETL működésében zavarok léphetnek fel. Ezt jelenleg 'barkács' módon oldjuk meg - a monitorozó séma kézi tisztításával, az összes korábbi adat elvesztésével. Ez nem túl kritikus a termelési környezetben normál működés esetén, de még keresjük a megfelelő megoldást.
Ebből a helyzetből adódik egy újabb probléma - néha többszörös elindulások történnek a vezérlési mechanizmusunknál.
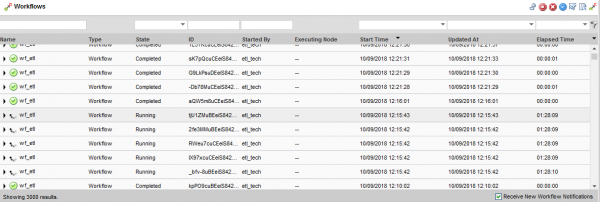
Többszörös elindulások az alkalmazásban, amelyek a mechanizmus meghibásodásához vezetnek.
Időzítéssel történő indításkor, a rendszer nagy terheltsége mellett néha olyan helyzetek fordulnak elő, amelyek a mechanizmus meghibásodásához vezetnek. Eddig a problémát kézzel javítják, folytatják a tartós megoldás keresését.
Összességében megállapítható, hogy nagy terhelés esetén rendkívül fontos megfelelő erőforrásokat biztosítani, ez vonatkozik az Informatica szoftverhez szükséges hardveres erőforrásokra, valamint az adatbázis-repozitóriumra, és biztosítani kell számukra az optimális beállításokat is. Továbbá nyitott kérdés marad, hogy melyik adatbázis-elhelyezési séma jobb — külön hoszton, vagy ugyanazon, ahol az Informatica szoftver működik. Egyrészt együtt olcsóbbnak tűnik, és a kombinálás szinte megszünteti a hálózati interakcióból adódó lehetséges problémát, másrészt az adatbázisból származó terhelés kiegészíti az Informatica terhelését.
Mint bármilyen komoly termék esetében, az Informatica esetében is vannak vicces pillanatok.
Egyszer, amikor egy balesetet elemeztem, észrevettem, hogy az MRS naplókban furcsán van jelölve az események időpontja.
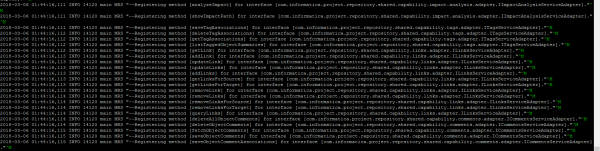
Időbeli dualizmus az MRS naplókban „tervezett módon”
Kiderült, hogy az időbélyegek 12 órás formátumban kerülnek rögzítésre, AM/PM megjelölés nélkül, tehát dél előtt vagy után. Ezzel kapcsolatban még jegyzéket is nyitottak, és hivatalos választ kaptak — így volt megtervezve, az MRS naplókban így rögzítik az időbélyegeket. Tehát néha fenntartja a rejtélyt egy ERROR felmerülésének időpontja…
A legjobbra törekedni
Ma az Informatica egy viszonylag stabil eszköz, amely kényelmes az adminisztrátorok és felhasználók számára, rendkívül erőteljes a jelenlegi lehetőségeivel és potenciáljával. Funkcionalitásban többszörösen meghaladja igényeinket, és de facto most nem a legkarakteresebb és tipikusabb módon használják a projektben. A nehézségek részben azzal összefüggésben adódnak, ahogyan a mechanizmusok működnek — a sajátosság az, hogy rövid idő alatt nagy mennyiségű szál indul el, amelyek intenzíven frissítik a parameterset-eket és dolgoznak az adatbázis-repozitóriummal, miközben a szerver hardveres erőforrásai gyakorlatilag teljesen ki vannak használva a CPU által.
Jelenleg közelítünk az Informatica 10.2.1 vagy 10.2.2 verzióra való áttéréshez, amelyekben néhány belső mechanizmus át lett dolgozva, és a támogatás ígéri, hogy megszűnnek számos, jelenleg nálunk fennálló teljesítmény- és működési probléma. És hardver szempontjából optimális konfigurációjú szerverek várhatók számunkra, figyelembe véve a közeljövőbeli növekedést és a tárolás fejlődését.
Természetesen, tesztelés, kompatibilitás-ellenőrzés, és esetlegesen architekturális változtatások várnak ránk a HA GRID területén. Az Informatica keretein belüli fejlődés folytatódni fog, mivel a rövid távú céljaink között nem szerepel a rendszer helyettesítése.
És azok, akik később felelni fognak ezért a rendszerért, biztosan képesek lesznek elérni a megrendelők által megkövetelt megbízhatósági és teljesítménybeli mutatókat.
A cikket a „Rostelecom” adatkezelő csapata készítette.
Az Informatica aktuális logója
Forrás: habr.com
