

Bevezetés
A felhasználó szempontjából az információs rendszer jól definiálható az ISO RV 51987 szerint – „automatikus rendszer, amelynek működése során a kimenő információk bemutatásának eredménye a további felhasználásra”. Ha a belső struktúrát nézzük, akkor lényegében bármely információs rendszer a kódban megvalósított kölcsönhatásban lévő algoritmusok rendszere. Szélesebb értelemben a Turing–Church tétel alapján az algoritmus (azaz az információs rendszer) a bemeneti adatok halmazát kimeneti adatok halmazává alakítja.
Még azt is mondhatjuk, hogy a bemeneti adatok átalakítása az információs rendszer létezésének értelme. Ennek megfelelően az információs rendszer és az egész információs rendszer komplexum értéke a bemeneti és kimeneti adatok értékén keresztül határozható meg.
Ezekből kiindulva a tervezésnek a legfontosabb adatokra kell épülnie, alkalmazkodva az adatok struktúrájához és jelentőségéhez.
Tárolt adatok
A tervezés előkészítése kulcsfontosságú lépése a feldolgozni és tárolni szándékozott adathalmazonként az összes jellemző közlése. Ezek a jellemzők a következőket tartalmazzák:
— Az adatok mennyisége;
— Az adatok életciklusával kapcsolatos információ (új adatok beáramlása, élettartam, elavult adatok feldolgozása);
— Az adatok üzleti szempontú osztályozása (az üzlet alapelvei szempontjából – a bizalmasság, integritás, rendelkezésre állás hármassága) együtt a pénzügyi mutatókkal (pl. az utolsó órában adatvesztés költsége);
— Az adatok feldolgozásának földrajzi elhelyezkedése (a feldolgozó rendszerek fizikai elhelyezkedése);
— A szabályozók követelményei minden egyes adatkategóriára vonatkozóan (pl. FZ-152, PCI DSS).
Információs rendszerek
Az adatok nemcsak tárolódnak, hanem az információs rendszerek által feldolgozódnak (átransformálódnak). Az adatok jellemzőinek megismerését követően a következő lépés egy maximálisan teljes információs rendszer leltár készítése, amely magában foglalja a rendszerek architektúrájának jellemzőit, kölcsönös függéseit és az infrastruktúrára vonatkozó követelményeket négyféle erőforrás kedvezményes egységeiben:
— A processzor számítási teljesítménye;
— Az operatív memória mennyisége;
— Az adatok tárolására és teljesítményére vonatkozó követelmények;
— Az adatok átvitelére vonatkozó hálózati követelmények (külső csatornák, csatornák az információs rendszerek komponensei között).
A követelményeknek minden szolgáltatásra/mikroszolgáltatásra vonatkozniuk kell az informatikai rendszer keretein belül.
Különösen fontos megjegyezni, hogy a megfelelő tervezéshez elengedhetetlen, hogy rendelkezésre álljanak az informatikai rendszer hatására vonatkozó adatok a cég fő üzletére nézve, a leállás költsége (forint/óra) formájában.
Fenntarthatósági Modellek
Kötelező, hogy rendelkezésre álljon egy hivatalos fenyegetésmodell, amely alapján védelmet terveznek az adatok/szolgáltatások számára. A fenyegetésmodellnek nemcsak a titkossággal, hanem az integritással és a rendelkezésre állással kapcsolatos aspektusokat is tartalmaznia kell. Például:
— Fizikai szerver meghibásodása;
— A top-of-the-rack switch meghibásodása;
— Az optikai kommunikációs csatorna megszakadása az adatközpontok között;
— Az operatív tárolórendszer teljes meghibásodása.
Bizonyos esetekben a fenyegetésmodellek nemcsak az infrastrukturális elemekre vonatkoznak, hanem konkrét informatikai rendszerekre vagy azok elemeire is, mint például az adatbázis logikai szerkezetének megszakadása.
Minden döntés a projekt keretein belül, amely a nem leírt fenyegetés elleni védekezést célozza, felesleges.
A szabályozók követelményei
Ha az kezelendő adatok különleges szabályok hatálya alá tartoznak, amelyeket a szabályozók állapítanak meg, kötelező információt szolgáltatni az adatcsoportokról és a feldolgozási/tárolási szabályokról.
Célértékek RPO / RTO
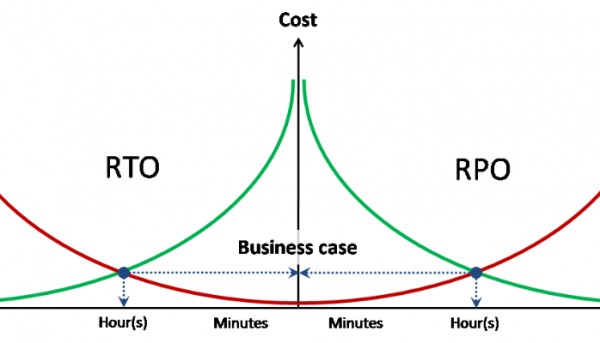
Bármilyen védelmi típus tervezése megköveteli a célzott adatveszteség és az érintett fenyegetések mindegyike számára a szolgáltatás helyreállításának célidőpontja meglétét.
Ideális esetben az RPO-nak és az RTO-nak társított költségekkel kell bírnia az adatveszteség és a leállás tekintetében időegységenként.
Erőforráspoolsra való felosztás
Az összes kezdeti információ gyűjtése után az első lépés a csoportok létrehozása az adathalmok és az informatikai rendszerek között a fenyegetésmodellek és a szabályozók követelményei alapján. Meg kell határozni a különböző poolok felosztásának módját - szoftveresen a rendszerprogram szintjén vagy fizikailag.
Példák:
— A személyes adatokat feldolgozó kör teljes mértékben fizikailag elkülönül a többi rendszertől;
— A biztonsági másolatok külön tárolórendszeren tárolódnak.
Ezek mellett a poolok rendelkezhetnek nem teljes függetlenséggel, például meghatározásra kerül két számítási erőforrás pool (processzáló teljesítmény + operatív memória), amelyek egyetlen tárolási adatpoolt és egyetlen adatátviteli erőforrás poolt használnak.
Processzáló teljesítmény
A virtuális adatközpont processzor teljesítményének absztrakt igénye a virtuális processzorok (vCPU) számában és a fizikai processzorok (pCPU) közötti konszolidációs arányban mérhető. Ebben az esetben 1 pCPU = 1 fizikai processzor mag (a Hyper-Threading figyelembevételével nélkül). A vCPU-k száma összeadódik az összes meghatározott erőforráspoolban (mindegyiknek lehet saját konszolidációs aránya).
A túlterhelt rendszerek konszolidációs arányát empirikus úton határozzák meg a már létező infrastruktúrából vagy próba telepítéssel és terheléses teszteléssel. A nem túlterhelt rendszerek esetében a "legjobb gyakorlatok" érvényesek. Különösen a VMware a 8:1 arányt említi átlagosnak.
Memória
A RAM iránti általános igény egyszerű összeadással határozható meg. A memória túratípusú használata nem ajánlott.
Tároló erőforrások
A tárolási erőforrások követelményeit a térfogat és a teljesítmény összeadásával állapítják meg.
A teljesítmény követelményei IOPS-ban fejezhetők ki az átlagos olvasás/írás arány megfelelő együttállásával és szükség esetén a maximális válaszidő figyelembevételével.
Külön kell megadni a szolgáltatásminőség (QoS) követelményeit a konkrét poolok vagy rendszerek esetében.
Adatátviteli hálózati erőforrások
Az adatátviteli hálózat igényei az összes sávszélesség-pool egyszerű összeadásával határozhatók meg.
Külön meg kell határozni a szolgáltatásminőség (QoS) és a késleltetési (RTT) követelményeket a konkrét poolok vagy rendszerek esetében.
Az adatátviteli hálózati erőforrások követelményei között szerepel a network traffic izolációs és/vagy titkosítási igényei, valamint a preferált mechanizmusok (802.1q, IPSec stb.) megadása is.
Architektúra kiválasztása
A jelen útmutató keretében más választást nem tárgyalunk, mint az x86 architektúrát és a szerverek 100%-os virtualizálását. Így a számítási alrendszer architektúrájának kiválasztása a szerver virtualizáló platform, a szerverek formátuma és a szerverek konfigurációs követelményeinek kiválasztására szűkül.
A választás kulcsfontosságú szempontja a klasszikus megközelítés, valamint a feldolgozás, tárolás és adatátvitel funkcióinak elválasztása vagy a konvergált architektúra használatának világossága.
Klasszikus architektúra tudja, hogy intelligens külső tároló- és adatátviteli alrendszerek használatát vonja maga után, míg a szerverek csak processzorteljesítményt és RAM-ot adnak hozzá a fizikai erőforrások összesített pooljához. Végső soron a szerverek teljesen névtelenné válhatnak, nemcsak saját lemezek nélkül, hanem még a rendszereik azonosítója nélkül is. Ilyen esetben a rendszert indítani lehet beépített flash meghajtókról vagy egy külső tárolórendszerről (boot from SAN).
A klasszikus architektúra keretein belül a választás a blade és rack szerverek között elsősorban az alábbi elvek alapján történik:
— Gazdasági hatékonyság (átlagosan a rack szerverek olcsóbbak);
— Számítási sűrűség (a blade szervereké magasabb);
— Energiafogyasztás és hőtermelés (a blade szerverek esetében az egy egységre jutó érték magasabb);
— Skálázhatóság és irányíthatóság (a blade szerverek általában kevesebb erőfeszítést igényelnek nagyobb telepítéseknél);
— Bővítőkártyák használata (blade esetén nagyon korlátozott választék).
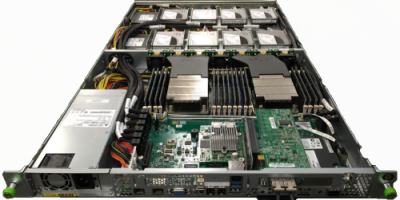
Konvergens architektúra (más néven hiper-konvergens) azt jelenti, hogy az adatfeldolgozás és tárolás funkcióit egyesítik, ami a szerverek helyi lemezeinek használatához vezet, ezzel elvetve a klasszikus blade formátumot. A konvergens rendszerekhez rack szerverek vagy cluster rendszerek használhatók, amelyek egy házban egyesítik a több blade szervert és a helyi lemezeket.
CPU / Memória
A konfiguráció helyes kiszámításához meg kell érteni a terhelés típusát a környezetben vagy az egyes független klaszterek esetében.
CPU bound – egy környezet, amelynek teljesítménye a processzorteljesítményre korlátozódik. A RAM hozzáadása nem változtat semmin a teljesítmény szempontjából (a szerveren futtatható VM-ek számát illetően).
Memory bound – egy környezet, amely a RAM-ra korlátozódik. Minél több RAM van a szerveren, annál több VM futtatható rajta.
GB / MHz (GB / pCPU) – az adott terhelés RAM- és processzorteljesítmény-igényének átlagos aránya. Használható a szükséges memória mennyiségének számításához egy meghatározott teljesítmény mellett és fordítva.
A szerver konfigurációjának kiszámítása
Először is meg kell határozni az összes terhelést, és el kell dönteni, hogy összesítjük vagy elválasztjuk a különböző számítási forrásokat különböző klaszterekben.
Ezután minden egyes kijelölt klaszter esetében meg kell határozni a GB / MHz arányt ismert terhelés mellett. Ha a terhelés nem ismert előre, de van egy körülbelüli elképzelés a processzor teljesítményének kihasználtságáról, akkor a vCPU:pCPU standard arányokat használhatjuk a követelmények fizikai szintre történő átvitelére.
Minden klaszter esetében a vCPU-követelmények összegét elosztjuk az aránnyal:
vCPUösszeg / vCPU:pCPU = pCPUösszeg – a szükséges fizikai magok száma
pCPUösszeg / 1.25 = pCPUht – a Hyper-Threading által korrigált magok számát
Tegyük fel, hogy egy 190 magos / 3.5TB RAM-os klaszter kiszámítására van szükség. Feltételezzük, hogy a cél 50%-os processzor kihasználtság és 75% RAM kihasználtság.
pCPU
190
CPU használat
50%
Mem
3500
Mem használat
75%
Foglalat
Mag
Srv / CPU
Srv Mem
Srv / Mem
2
6
25,3
128
36,5
2
8
19,0
192
24,3
2
10
15,2
256
18,2
2
14
10,9
384
12,2
2
18
8,4
512
9,1
Ebben az esetben mindig a legközelebbi egészre kerekítést használunk felfelé (=ROUNDUP(A1;0)).
A táblázatból nyilvánvaló, hogy a célállapotokhoz közelítő kiegyensúlyozott konfigurációk közé tartozik néhány szerverkonfiguráció:
— 26 szerver 2*6c / 192 GB
— 19 szerver 2*10c / 256 GB
— 10 szerver 2*18c / 512 GB
Ezen konfigurációk közül a választás a későbbiekben további tényezők, például a hőcsomag és az elérhető hűtés, már használt szerverek, vagy a költség alapján történik.
A szerverkonfiguráció kiválasztásának sajátosságai
Széles VM-ek. Ha széles VM-ek (1 NUMA csomóponttal és annál nagyobbal összehasonlítható) elhelyezésére van szükség, ajánlott a lehető legjobb konfigurációt választani, amely lehetővé teszi, hogy ezek a VM-ek a NUMA csomóponton belül maradjanak. Nagyszámú széles VM esetén fennáll a kockázata a klaszter erőforrásainak fragmentálódásának, és ilyen esetben olyan szervereket választanak, amelyek lehetővé teszik a széles VM-ek maximális sűrűségben való elhelyezését.
Egységnyi hibavédelmi domainek mérete.
A szerver méretének kiválasztása szintén azt a elvet követi, hogy minimalizálja az egységnyi hibavédelmi domainek méretét. Például a választás során:
— 3 x 4*10c / 512 GB
— 6 x 2*10c / 256 GB
Egyéb azonos körülmények között a második lehetőséget kell választani, mivel ha egy szerver meghibásodik (vagy karbantartásra kerül), akkor nem 33%-os erőforrás-veszteség keletkezik a klaszterben, hanem 17%. Hasonlóképpen, a VM-ek és az IS-ek száma is kétszeresére csökken, amelyekre a baleset hatással volt.
A klasszikus tárolórendszer teljesítményének számítása
A klasszikus tárolórendszert mindig a legrosszabb forgatókönyv (worst case scenario) alapján számítják, mellőzve a RAM gyorsítótár és a műveletek optimalizálásának hatását.
Alapvető teljesítménymutatóként a lemez mechanikai teljesítményét (IOPSdisk) vesszük alapul:
— 7.2k – 75 IOPS
— 10k – 125 IOPS
— 15k – 175 IOPS
Ezután a lemezek számát a lemezcsoportra az alábbi képlettel számítjuk: = TotalIOPS * ( RW + (1 –RW) * RAIDPen) / IOPSdisk. Ahol:
— TotalIOPS – az elvárt összteljesítmény IOPS-ban az adattároló csoporttól
— RW – az olvasási műveletek aránya
— RAIDpen – a választott RAID szint RAID büntetése
A RAID eszköz és a RAID büntetéssel kapcsolatos további részletek itt találhatóak — és és
A kapott lemezek számából a tárolási kapacitás követelményeinek megfelelő lehetséges változatokat számítunk ki, beleértve a többszintű tárolási lehetőségeket is.
Az SSD használatával működő rendszerek számítását külön tárgyaljuk.
A Flash Cache rendszerek sajátosságai
Flash Cache – a flash memória második szintű gyorsítótárként való felhasználásának célnak összefoglaló neve. Flash cache használata esetén a tárolórendszert általában a mágneses lemezek által nyújtott terhelés biztosítására számítják ki, míg a csúcsot a gyorsítótár kezeli.
Egyúttal meg kell érteni a terhelés profilját és a tároló kötetekhez való kérések lokalizációjának mértékét. A flash cache olyan technológia, amely a magas lokalizációval rendelkező terhelésekhez készült, és gyakorlatilag nem alkalmazható egyenletesen terhelt kötetek esetén (például analitikai rendszerekhez).
Hibrid rendszerek számítása low-end / mid-range kategóriákban
A hibrid alsó és középkategóriás rendszerek többszintű tárolást alkalmaznak, ahol az adatok áthelyezése szoros ütemezés alapján történik. Ebben az esetben a legjobb modellek többszintű tárolásának blokkmérete 256 MB. Ezek a sajátosságok nem teszik lehetővé, hogy a többszintű tárolást a teljesítmény növelésének technológiájának tekintsük, ahogy azt sokan tévesen gondolják. A többszintű tárolás az alsó és középkategóriás rendszerekben az ároptimalizáló technológia, a kifejezett egyenetlen terhelési profil mellett.
A többrétegű tárolás esetén elsősorban a felső szintű teljesítményt számítják, míg az alsó tárolási szint csak a tárolókapacitás kiegészítéseként számít. A hibrid többrétegű rendszer esetében elengedhetetlen a villamos cache technológia használata a többrétegű tárolópótlóhoz, hogy kompenzálja a hirtelen megemelkedett adatok teljesítménycsökkenését az alsó szintről.
SSD használata a többrétegű lemezpulton
Az SSD használata a többrétegű lemezpulton változatokban érhető el, attól függően, hogy az adott gyártó milyen flash cache algoritmusokat valósít meg.
Általános gyakorlati tárolási politika SSD szintű lemezpult esetén — SSD első.
Csak olvasható Flash Cache. Csak olvasható flash cache esetén az SSD tárolási szint jelentkezik, ha a műveletek írása jelentősen lokalizálódik a cache eltekintésével.
Olvasás / Írás Flash Cache. Írásra szánt flash cache esetén először a maximális cache méretet állítják be, az SSD tárolási szint pedig csak akkor jön létre, ha a cache mérete nem elegendő az egész lokalizált terhelés kezeléséhez.
Az SSD és a cache teljesítményének számítása mindig a gyártó ajánlásainak megfelelően történik, de mindig a legrosszabb forgatókönyv alapján.
Forrás: habr.com
