

Bevezetés
Itt az ideje, hogy tárhelyet vásároljunk. Melyiket válasszuk, kit hallgassunk? A vendor A a vendor B-ről beszél, de ott van C integrátor is, aki az ellenkezőjét állítja, és D vendorra bíztat. Ilyen helyzetben még a tapasztalt architekt is megzavarodhat, különösen a rengeteg új vendor és a ma divatos SDS és hiper-összevonások miatt.
Hogyan érthetjük meg mindezt, és hogyan ne kerüljünk bénán a helyzetbe? Mi ( Anton Zsbankov és Evgeny Elizarov) megpróbáljuk ezt orosz nyelven, tisztán elmondani.
A cikk nagyrészt összhangban van, valójában a "" című írás kiterjesztése az adatraktárak választásáról és a tárolási technológiák áttekintéséről. Röviden foglalkozunk az általános elmélettel, de javasoljuk, hogy nézzék meg a fent említett cikket is.
Miért
Gyakran megfigyelhető, hogy az új tagok hogyan érkeznek egy fórumra vagy egy speciális csoportba, mint például a Storage Discussions, és felteszik a kérdést: "két SYSTÉMA közül tudtok ajánlani — ABC SuperStorage S600 és XYZ HyperOcean 666v4, mit javasoltok"?
És elkezdődik az összehasonlítás az implementációs részletek rettenetes és érthetetlen trükkjei között, amelyek a felkészületlenek számára valóban kínai írásmódot jelentenek.
A legfontosabb és első kérdés, amit sokkal azelőtt fel kell tennünk, hogy a specifikációkat összehasonlítanánk a kereskedelmi ajánlatokban — MIÉRT? Miért van szükség erre a rendszerre?
A válasz meglepő lesz, és nagyon Tony Robbins stílusú — az adatok tárolására. Köszönjük, kapitány! Ennek ellenére néha olyan mélyen belemerülünk az részletek összehasonlításába, hogy elfelejtjük, miért csinálunk mindezt.
Tehát az adatőrző rendszer feladata az, hogy tárolja és hozzáférést biztosítson az ADATOKHOZ a megadott teljesítménnyel. Az adatokkal fogunk kezdeni.
Adatok
Adattípus
Milyen adatokat tervezünk tárolni? Ez egy nagyon fontos kérdés, amely számos tárolórendszert kizárhat a megfontolásból. Például, ha videofelvételek és fényképek tárolása a cél, akkor azonnal ki kell zárni azokat a rendszereket, amelyek véletlenszerű elérésre és kis blokkok kezelésére lettek optimalizálva, vagy amelyek gyártói megoldásokat kínálnak a tömörítésre / deduplikálásra. Ezek lehetnek egyszerűen kiváló rendszerek, nincs róluk rossz véleményünk. De ebben az esetben az erősségeik gyengévé válhatnak (a videók és fényképek nem tömöríthetők), vagy egyszerűen jelentősen megnövelik a rendszer költségeit.
Éppen ellenkezőleg, ha a célzott használat egy nagy terhelésű tranzakciós adatbázis, akkor a kiváló multimédiás streaming rendszer, amely másodpercenként gigabájtokat tud kibocsátani, rossz választás lesz.
Adatmennyiség
Mennyi adatot tervezünk tárolni? A mennyiség mindig minőséggé alakul, ezt sosem szabad elfelejteni, különösen manapság, amikor az adatok mennyisége exponenciálisan nő. A petabájtos osztályú rendszerek már nem ritkák, de minél nagyobb a petabájt mennyiség, annál specifikusabbá válik a rendszer, annál kevésbé állnak rendelkezésre a hagyományos, kis és közepes méretű véletlenszerű elérést biztosító rendszerek funkciói. Egyszerűen azért, mert már a statisztikai táblázatok blokkonkénti hozzáférése is meghaladja a vezérlők rendelkezésre álló memória kapacitását. Nem is beszélve a tömörítésről / rétegzésről. Tegyük fel, hogy egy erősebb tömörítési algoritmusra szeretnénk váltani, és tömöríteni akarunk 20 petabájtnyi adatot. Mennyibe fog ez kerülni: fél év, egy év?
Másrészről, miért is bonyolítanánk túl a dolgot, ha csak 500 GB adatot kell tárolni és feldolgozni? Csak 500. Az ilyen mennyiségű háztartási SSD-k (alacsony DWPD-vel) egészen olcsók. Miért építenénk Fiber Channel gyárat és vásárolnánk egy magas osztályú tárolórendszert, amely annyiba kerül, mint egy nehéz híd?
Mekkora a forró adatok aránya a teljes adathalmazon belül? Mennyire egyenletlen a terhelés az adatok mennyiségét tekintve? Itt segíthet a többlépcsős tárolási technológia vagy a Flash Cache, ha a forró adatok mennyisége elenyésző a teljeshez képest. Vagy éppen ellenkezőleg, ha a terhelés egyenletes az egész mennyiségben, ami gyakran előfordul az áramlási rendszerekben (videó megfigyelés, bizonyos elemző rendszerek), ezek a technológiák nem fognak hasznot hozni, és csak a rendszer költségeit/sz复杂itását növelik.
IS
Az adatok másik oldala egy informatikai rendszer, amely ezeket az adatokat használja. Az IS rendelkezik egy követelménykészlettel, amelyet az adatok örökölnek. Az IS-ről többet olvashatsz a "Virtualizált Adatközpont Tervezése" című dokumentumban.
Hibahatósági / elérhetőségi követelmények
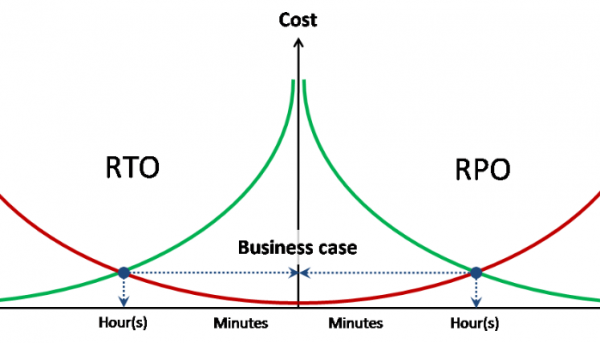
A hibahatósági / elérhetőségi követelmények az őket használó IS-ből származnak, és három számjegyben fejezik ki őket — RPO, RTO, elérhetősége..
Elérhetőség — az az időtartam, amely alatt az adatok elérhetők a használatra, egy megadott időintervallumon belül. Általában kilencesekben fejezik ki. Például, ha évente két kilencre van szükség, akkor az elérhetőség 99%-ot jelent, ami másképpen évente 95 óra leállást enged meg. Három kilences — évi 9,5 óra.
Az RPO / RTO nem összegző, hanem minden egyes incidensre (balesetre) vonatkozik, ellentétben az elérhetőséggel.
RPO — a baleset során elveszett adatok mennyisége (órákban). Például, ha napi egyszer készítenek biztonsági másolatot, akkor RPO = 24 óra. Tehát, egy baleset és az összes adatvesztés esetén akár 24 óra adat is elveszhet (a biztonsági másolat óta eltelt időre). Az IS-hez megadott RPO alapján például a biztonsági mentésre vonatkozó szabályzatot is megfogalmazzák. Emellett az RPO-ból megérthető, milyen mértékben szükséges a szinkron / aszinkron adat-replikáció.
RTO — a szolgáltatás (adatokhoz való hozzáférés) helyreállításának ideje baleset után. Az RTO megadott értéke alapján megállapítható, hogy szükséges-e metróklaszter, vagy elegendő az egyirányú replikáció. Szükség van-e a hi-end osztályú többvezérlős tárolóra — szintén.
Teljesítménykövetelmények
Bár ez egy meglehetősen nyilvánvaló kérdés, éppen ebben merülnek fel a legtöbb nehézség. Attól függően, hogy van-e már valamilyen infrastruktúrád, vagy sem, és hogyan fogják megépíteni a szükséges statisztikák gyűjtésének útvonalait.
Már van tárolórendszere, és keres egy cserét, vagy szeretne egy újat vásárolni a bővítéshez. Itt minden egyszerű. Tudja, milyen szolgáltatások állnak rendelkezésére, és melyeket kíván bevezetni a közeljövőben. A meglévő szolgáltatások alapján statisztikát állíthat össze a teljesítményről. Meg kell határoznia az aktuális IOPS számot és a jelenlegi késleltetéseket - milyenek ezek az adatok, és elegendőek-e az Ön feladataihoz? Ezt megteheti a tárolórendszeren, valamint a hozzá csatlakozó hosztok oldaláról is.
Fontos, hogy ne csak a jelenlegi terhelést nézze, hanem egy adott időszakot is (jobb, ha egy hónapot). Nézze meg, mik a maximális csúcsok a nappali időszakban, milyen terhelést generál a biztonsági mentés stb. Ha a tárolórendszere vagy a hozzá tartozó szoftver nem ad meg minden szükséges adatot, használhatja a ingyenes RRDtool-t, amely a legnépszerűbb tárolórendszerekkel és switch-ekkel tud dolgozni, és részletes teljesítménystatisztikát tud biztosítani. Érdemes figyelni a terhelést azokon a hosztokon is, amelyek e tárolórendszert használják, konkrét virtuális gépekre vagy arra, hogy pontosan mi fut az adott hoszton.
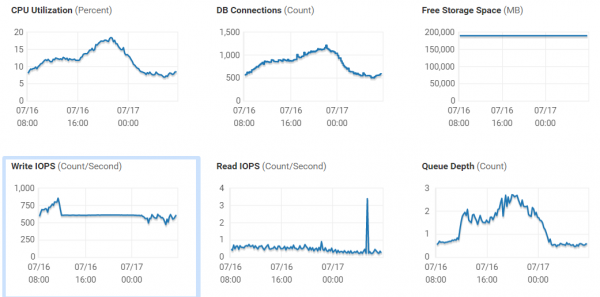
Külön érdemes megemlíteni, hogy ha az adott kötet és a rajta lévő adatbolt késleltetései jelentősen eltérnek, akkor figyelnie kell a SAN-hálózatára is, mert nagy a valószínűsége, hogy problémák vannak vele, és mielőtt új rendszert vásárolna, érdemes e kérdéssel foglalkozni, mivel nagyon nagy a valószínűsége a meglévő rendszer teljesítményének növelésére.
Ön nulláról épít infrastruktúrát, vagy vásárol egy rendszert valamilyen új szolgáltatás számára, amelynek terheléséről nem rendelkezik információval. Itt több lehetőség is van: beszélgessen kollégákkal szakmai forrásokon, hogy próbálja meg kideríteni és előre jelezni a terhelést; forduljon egy integrátorhoz, akinek van tapasztalata hasonló szolgáltatások bevezetésében, és aki el tudja számítani a terhelést az Ön számára. A harmadik lehetőség (általában a legnehezebb, különösen ha saját fejlesztésű vagy ritka alkalmazásokról van szó) megpróbálni kideríteni a teljesítménykövetelményeket a rendszer fejlesztőitől.
És figyelem, a gyakorlati alkalmazás szempontjából a leghelyesebb megoldás a pilóta a jelenlegi berendezésen, vagy a gyártó / integrátor által biztosított tesztberendezésen.
Speciális követelmények
A speciális követelmények — minden, ami nem tartozik a teljesítményi, megbízhatósági és funkcionális követelmények alá, amelyek közvetlenül az adatok feldolgozására és szolgáltatására vonatkoznak.
A leg egyszerűbb speciális követelmények közé tartozik az "átadható információs tárolóeszközök". Azonnal világossá válik, hogy a tárolórendszernek tartalmaznia kell egy szalagos könyvtárat vagy egyszerűen egy szalagos egységet, amelyre a biztonsági mentést lementik. Ezután egy hozzáértő személy aláírja a szalagot, és büszkén viszi azt a speciális széfbe.
Egy másik példa a speciális követelményre — a védett, ütésálló kivitel.
Ahol
A másik fő szempont a tárolórendszer kiválasztásában az, hogy HOL fog állni ez a tárolórendszer. Kezdve a földrajzi vagy éghajlati viszonyokkal, egészen a személyzetig.
Megrendelő
Kinek szól ez a tárolórendszer? A kérdés mögött a következő indokok állnak:
Állami megrendelő / kereskedelmi.
A kereskedelmi megrendelőnek nincsenek korlátozásai, és nincs kötelező tendertartási kötelezettsége, kivéve a saját belső szabályzataik alapján.
Az állami megrendelő — más dolog. 44. FZ és egyéb örömek a tenderekkel és a műszaki követelményekkel, amelyek megtámadhatók.
A megrendelő szankciók alatt
Itt a kérdés nagyon egyszerű — a választás csak az adott megrendelő számára elérhető ajánlatokra korlátozódik.
Belső szabályok / engedélyezett beszállítók / modellek
Ez a kérdés szintén rendkívül egyszerű, de érdemes figyelni rá.
Hol fizikailag
Ebben a részben minden földrajzi, kommunikációs csatornával és a létesítmény mikroklímájával kapcsolatos kérdést megvizsgálunk.
Személyzet
Ki fog dolgozni ezzel a tárolórendszerrel? Ez nem kevésbé fontos, mint az, amit a tárolórendszer közvetlenül tud.
Bármekkora is legyen az A gyártó tárolórendszere érdekes, menő és csodálatos, talán nincs értelme installálni, ha a személyzet csak a B gyártóval tud dolgozni, és nem terveznek további beszerzéseket és folyamatos együttműködést A-val.
És természetesen a kérdés másik oldala az, hogy mennyire elérhető a képzett személyzet a vállalatnál és potenciálisan a munkaerőpiacon az adott földrajzi helyen. A régiók számára jelentős lehet, hogy olyan tárolórendszert válasszanak, amely egyszerű interfészekkel vagy távoli központosított irányítással rendelkezik. Egy adott pillanatban ez különösen kínzó lehet. Az internet tele van történetekkel arról, hogyan konfigurálta el egy újonnan érkezett munkatárs, egy tegnapi hallgató úgy a rendszert, hogy az egész cég leállt.
Környezet
És természetesen egy másik fontos kérdés az, hogy milyen környezetben fog működni ez a tárolórendszer.
- Mi a helyzet az áramellátással/hűtéssel?
- Milyen csatlakozásra lesz szükség?
- Hová lesz telepítve?
- És így tovább.
Ezek a kérdések gyakran maguktól értetődőknek számítanak, és nem igazán foglalkoznak velük, de néha éppen ezek tudják megfordítani a helyzetet.
Mi?
Gyártó
Ma (2019 közepe) az orosz tárolórendszer-piacot körülbelül öt kategóriára lehet osztani:
- Első liga — elismert cégek széles termékpalettával a legegyszerűbb lemezkazettáktól a hi-end megoldásokig (HPE, DellEMC, Hitachi, NetApp, IBM/Lenovo)
- Második liga — korlátozott termékpalettával rendelkező cégek, niche játékosok, komoly SDS szállítók vagy feltörekvő újoncok (Fujitsu, Datacore, Infinidat, Huawei, Pure stb.)
- Harmadik liga — niche megoldások low end rangban, olcsó SDS, do-it-yourself megoldások ceph és más nyílt projektek alapján (Infortrend, Starwind stb.)
- SOHO szegmens — kis és nagyon kis tárolórendszerek forrása, ház/kevésbé iroda szintű (Synology, QNAP stb.)
- Importált tárolórendszerek — ide tartozik az első liga hardvere, amelyen új címkék vannak, illetve néhány ritka második liga képviselő (RAIDIX, adunk nekik egy esélyt a második), de főként a harmadik ligát képviselik (Aerodisk, Baum, Depo stb.)
Ez a felosztás meglehetősen relatív, és nem jelenti, hogy a harmadik vagy SOHO szegmens rossz, és hogy nem használhatóak. Specifikus projektekben, világosan meghatározott adathalmazon és terhelési profilon belül nagyon jól teljesíthetnek, messze felülmúlva az első ligát ár/érték arányban. Fontos, hogy először határozzuk meg a feladatokat, a növekedési kilátásokat, a szükséges funkcionalitást — és akkor a Synology hűségesen szolgálni fog, és a haj puha, selymes lesz.
Az egyik fontos tényező a beszállító kiválasztásakor a meglévő környezet. Milyen és hány tárolórendszerrel rendelkezik már, milyen tárolórendszerekkel tudnak dolgozni a mérnökök. Szüksége van még egy beszállítóra, egy új kapcsolatra, tervez-e fokozatosan áttelepíteni az összes terhelést az A beszállítóról a B beszállítóra?
Nem szabad felesleges entitásokat létrehozni.
iSCSI / FC / File
A hozzáférési protokollokkal kapcsolatban az mérnökök között nincs egyetértés, a viták inkább teológiai vitákra emlékeztetnek, mint mérnöki beszélgetésekre. De összességében a következő pontokat jegyezhetjük meg:
FCoE inkább halott, mint élő.
FC vs iSCSI. Az FC egyik kulcsfontosságú előnye 2019-ben az IP tárolórendszerekkel szemben, a dedikált gyár az adatokhoz való hozzáféréshez, elhomályosul a dedikált IP hálózattal. Az IP hálózatokkal szemben globális előnyöket nem lehet találni, és IP-alapú rendszerek bármilyen terhelés szintjén felépíthetők, egészen a nehéz DBMS rendszerekig egy nagy bank ABS-ért. Másrészt az FC halálát már évek óta megjósolják, de mindig akad valami, ami ezt megakadályozza. Jelenleg például a tárolórendszerek piacán néhány szereplő aktívan fejleszti az NVMeoF szabványt. Meg fogja-e osztani a FCoE sorsát – az idő megmondja.
Fájlszintű hozzáférés szintén nem érdemtelen figyelemre. Az NFS / CIFS kiválóan teljesít termelési környezetekben, és megfelelő tervezés mellett nem több panaszt kapnak, mint a blokk protokollok.
Hibrid / All Flash Array
A klasszikus tárolórendszerek 2 típusa létezik:
- AFA (All Flash Array) – az SSD használatára optimalizált rendszerek.
- Hibrid – lehetővé teszi HDD és SSD vagy ezek kombinációjának használatát.
Fő különbségük a támogatott tárolási technológiák hatékonyságában és a maximális teljesítmény szintjében (magas IOPS mutatók és alacsony késleltetés). Mindkét rendszer (a legtöbb modelljük, kivéve az alacsony kategóriás szegmenst) képes működni blokk eszközként és fájlok formájában is. A rendszer szintje határozza meg a támogatott funkciókat is, és az alacsonyabb modelleknél ezek általában minimalizáltak. Ezt érdemes figyelembe venni, amikor egy adott modell jellemzőit vizsgálja, nem csupán az egész termékpaletta lehetőségeit. Természetesen a rendszer szintje befolyásolja a technikai paramétereket is, mint például a processzor, a memória mennyisége, a gyorsítótár, a portok száma és típusa stb. Az irányelvek szempontjából az AFA a hibrid (lemezes) rendszerektől csupán az SSD tárolókkal való együttműködés megvalósításának módjában különbözik, és még ha SSD-t használ is egy hibrid rendszerben, az nem jelenti azt, hogy az AFA rendszer szintjén teljesítményt fog kapni. Továbbá a hibrid rendszerek esetében a hatékony tárolás inline mechanizmusai a legtöbb esetben ki vannak kapcsolva, és ezek aktiválása teljesítménycsökkenést eredményez.
Speciális tárolórendszerek
Az általános célú tárolórendszereken kívül, amelyek elsősorban az adatok valós idejű feldolgozására vannak optimalizálva, léteznek speciális tárolórendszerek, alapelveik gyökeresen eltérnek a megszokottaktól (alacsony késleltetés, sok IOPS):
Média.
Ezek a rendszerek médiafájlok tárolására és feldolgozására szolgálnak, amelyek általában nagy méretűek. Ennek megfelelően a késleltetés szinte lényegtelen, míg az adatátvitel széles sávjának és párhuzamos szálakban való fogadásának képessége kerül középpontba.
Deduplicáló tárolórendszerek biztonsági mentésekhez.
Mivel a biztonsági mentések általában ritkán hasonlítanak egymásra (a hétköznapi átlagos biztonsági mentés a tegnapitól 1-2%-kal eltér), ez a rendszerfajta rendkívül hatékonyan csomagolja be az adataikat viszonylag kis számú fizikai hordozón. Például bizonyos esetekben az adatkompressziós arány elérheti a 200:1-et.
Objektum tárolórendszerek.
Ezekben a tárolórendszerekben nincsenek megszokott kötetek blokkalapú hozzáféréssel és fájlszerverekkel, inkább óriási adatbázisokra hasonlítanak. A hasonló rendszerekben tárolt objektumok elérése egyedi azonosító vagy metadatok (például minden JPEG formátumú objektum, amelynek létrehozási dátuma XX-XX-XXXX és YY-YY-YYYY között van) alapján történik.
Megfelelőségi rendszerek.
Ma már nem olyan gyakoriak Oroszországban, de érdemes megemlíteni őket. Az ilyen tárolórendszerek célja a adatok garantált megőrzése a biztonsági politikáknak vagy a szabályozók követelményeinek való megfelelés érdekében. Néhány rendszerben (például az EMC Centera) létezett a törlés megakadályozásának funkciója — amint a kulcsot elfordítják, és a rendszer átáll ebbe a módba, sem az adminisztrátor, sem mások fizikailag nem tudják törölni a már rögzített adatokat.
Szabadalmaztatott technológiák
Flash cache
A Flash Cache - ez a megnevezés a flash memória második szintű cache-ként történő felhasználására vonatkozó minden szabadalmaztatott technológiára. Flash cache használata esetén a tárolórendszer általában a mágneses lemezek által elérhető terheléshez van optimalizálva, míg a csúcsidőszakokat a cache szolgálja ki.
Egyúttal meg kell érteni a terhelés profilját és a tároló kötetekhez való kérések lokalizációjának mértékét. A flash cache olyan technológia, amely a magas lokalizációval rendelkező terhelésekhez készült, és gyakorlatilag nem alkalmazható egyenletesen terhelt kötetek esetén (például analitikai rendszerekhez).
A piacon kétféle flash cache megoldás érhető el:
- Read Only. Ebben az esetben csak a Read-Ony adatokat cache-elik, míg az írás közvetlenül a lemezekre történik. Néhány gyártó, például a NetApp, úgy véli, hogy az írás az ő tárolórendszerükben optimálisan zajlik, és a cache nem ad hozzá értéket.
- Read/Write. Itt nemcsak az olvasás, hanem az írás is cache-elve van, ami lehetővé teszi a folyamat pufferezését, csökkentve a RAID büntetést, ezzel növelve a tárolórendszer összteljesítményét, ha nem optimális írási mechanizmussal dolgozik.
Tiers
A többlépcsős tárolás (tiering) olyan technológia, amely különböző teljesítményű szintek (például SSD és HDD) egyesítését jelenti egy közös lemezpuli létrehozására. Ha az adathozzáférés egyértelműen egyenetlen távoli blokkokra vonatkozik, a rendszer automatikusan képes újraelosztani a blokkokat, áthelyezve a terhelt blokkokat egy nagy teljesítményű szintre, míg a hideg blokkokat egy lassúbbra.
A hibrid alsó és középkategóriás rendszerek többszintű tárolást alkalmaznak, ahol az adatok áthelyezése szoros ütemezés alapján történik. Ebben az esetben a legjobb modellek többszintű tárolásának blokkmérete 256 MB. Ezek a sajátosságok nem teszik lehetővé, hogy a többszintű tárolást a teljesítmény növelésének technológiájának tekintsük, ahogy azt sokan tévesen gondolják. A többszintű tárolás az alsó és középkategóriás rendszerekben az ároptimalizáló technológia, a kifejezett egyenetlen terhelési profil mellett.
Snapshot
Bárhányat is beszélünk a tárolási rendszerek megbízhatóságáról, számos lehetőség létezik az adatok elvesztésére, amely nem függ a hardver problémáktól. Ezek lehetnek vírusok, hackerek vagy bármilyen egyéb, véletlen törlés / adatkárosodás. Emiatt a termelési adatok biztonsági mentése elengedhetetlen része az mérnök munkájának.
A pillanatkép egy tároló pillanatnyi állapota. A legtöbb rendszer, mint például a virtualizáció és az adatbázisok, esetében szükség van egy ilyen pillanatkép készítésére, amelyből adatokat másolunk a biztonsági mentéshez, miközben rendszereink nyugodtan folytathatják a munkát ezen a tárolón. De fontos megjegyezni, hogy nem minden pillanatkép egyformán hasznos. Különböző gyártók különböző megközelítéseket alkalmaznak a pillanatképek készítésénél, amelyek a saját architektúrájukkal kapcsolatosak.
CoW (Copy-On-Write). Amikor megpróbálunk egy adatblokkot írni, az eredeti tartalom másolódik egy speciális területre, majd a felvétel normálisan zajlik. Így megakadályozzuk az adatok megsérülését a pillanatképben. Nyilvánvaló, hogy ezek a "parazita" műveletek extra terhelést jelentenek a tárolási rendszerek számára, ezért az ilyen megvalósítással rendelkező gyártók nem javasolják, hogy több mint tíz pillanatképet használjanak, és erősen terhelt tárolók esetén ne is használjanak egyáltalán.
RoW (Redirect-on-Write). Ebben az esetben az eredeti tároló természetesen le lesz fagyasztva, és amikor megpróbálunk egy adatblokkot írni, a tárolási rendszer egy speciális területre írja az adatokat a szabad térben, megváltoztatva a blokk helyét a metaadat-táblázatban. Ez csökkenti az újraírási műveletek számát, ami végül semlegesíti a teljesítménycsökkenést és megszünteti a pillanatképek számának korlátozásait.
A pillanatképek két típusa van az alkalmazások szempontjából:
Application consistent. A pillanatkép létrehozásakor a tárolási rendszer meghívja a felhasználó operációs rendszerében található ügynököt, amely kényszeríti a lemezképek kiürítését a memóriából a lemezre, és kötelezi az alkalmazást is erre. Ebben az esetben a pillanatképből történő helyreállítás során az adatok konzisztens állapotúak lesznek.
Crash consistentEbben az esetben nincs ilyen, és a pillanatkép úgy jön létre, ahogy van. Ha egy ilyen pillanatképből állítunk helyre, a kép pontosan olyan, mintha hirtelen áramkimaradás történt volna, és lehetséges bizonyos adatvesztés, amely a cache-ben rekedt, és sohasem jutott el a lemezre. Az ilyen pillanatképek egyszerűbbek a megvalósítás szempontjából, és nem okoznak teljesítménycsökkenést az alkalmazásokban, de kevésbé megbízhatóak.
Miért szükségesek a pillanatképek az adattároló rendszerekben?
- Agent nélküli biztonsági mentés közvetlenül az adattárolóból
- Tesztkörnyezetek létrehozása valós adatok alapján
- Fájl alapú adattárolóknál a VDI környezetek létrehozására használható a pillanatképek használatával az adattárolón helyett a hypervisor használata helyett.
- Alacsony RPO biztosítása a pillanatképek ütemezett létrehozásával, amelynek gyakorisága jelentősen meghaladja a biztonsági mentések gyakoriságát.
Klónozás
A kötet klónozása hasonló elven működik, mint a pillanatképek, de nem csupán az adatok olvasására szolgál, hanem azokkal való teljes körű munkára is. Lehetőségünk van pontos másolatot kapni a kötetünkről, az összes rajta lévő adattal, anélkül hogy fizikailag lemásolnánk, ami helyet takarít meg. A kötetek klónozása általában vagy teszteléshez és fejlesztéshez, vagy ha szeretné ellenőrizni néhány frissítés működését a rendszerében használatos. A klónozás lehetővé teszi, hogy ezt a leggyorsabban és leggazdaságosabban végezze el a lemezforrások szempontjából, mivel csak a módosított adatrekordok lesznek feljegyezve.
Replikáció / naplózás
A replikáció — egy adat másolatának létrehozásának mechanizmusa egy másik fizikai adattárolón. Általában minden gyártónak van saját technológiája, amely csak a saját termékcsaládján belül működik. De vannak külső megoldások is, beleértve a hypervizor szintjén működőket, mint például a VMware vSphere Replikáció.
A gyártói technológiák funkcionalitása és használatuk kényelme általában jelentősen meghaladja az univerzális megoldásokat, de nem alkalmazhatók, ha például replikát kell létrehozni NetApp és HP MSA között.
A replikációt két altípusra osztják:
Szinkron. A szinkron replikáció során a írás műveletek azonnal továbbítódnak a második tárolórendszerre, és nem kerülnek megerősítésre, amíg a távoli tárolórendszer meg nem erősíti azt. Ennek következtében megnő a késleltetés, de ehelyett pontos tükörmásolatot kapunk az adatokból. Tehát az RPO = 0 a fő tárolórendszer elvesztése esetén.
Aszinkron. A írás művelet csak a fő tárolórendszeren hajtódik végre, és azonnal megerősítésre kerül, párhuzamosan felhalmozva a pufferben a távoli tárolórendszerre történő csomagküldés számára. Ez a típusú replikáció a kevésbé értékes adatok, vagy alacsony sávszélességű vagy nagy késleltetésű csatornák esetén releváns (amely jellemzően 100 km-nél hosszabb távolságokra vonatkozik). Ennek megfelelően az RPO = a csomagküldés gyakoriságával arányos.
Sok esetben a replikáció mellett létezik egy naplózási disk műveletek mellett. Ebben az esetben egy speciális területet különítenek el a naplózásra, és bizonyos időmélységű írási műveletek tárolódnak, vagy a napló mennyiségi korlátai szerint. Egyes szabadalmaztatott technológiáknál, mint például az EMC RecoverPoint, integráció lehetséges a rendszerszoftverrel, lehetővé téve bizonyos bejegyzések csatolását a naplóban. Ennek köszönhetően a kötet állapotának visszaállítása (vagy klón létrehozása) nem csupán 23 április 11:59:13.013 másodpercig lehetséges, hanem egy olyan pillanatra, amely megelőzte a “DROP ALL TABLES; COMMIT” parancsot.
Metro klaszter
A metro klaszter egy technológia, amely lehetővé teszi a két tárolórendszer közötti kétsirányú szinkron replikáció létrehozását oly módon, hogy ez a pár egy tárolórendszerként jelenik meg. Földrajzi értelemben szétválasztott klaszterek létrehozására alkalmazzák metro távolságokon (100 km-en belül).
A virtualizációs környezetben való használat példáján a metro klaszter lehetővé teszi, hogy egy tárolási területet hozzunk létre virtuális gépekkel, amely egyszerre két adatközpontból is írásra elérhető. Ebben az esetben egy hipervizorok szintjén létrejövő klaszter alakul ki, amely különböző fizikailag elhelyezkedő adatközpontok hosztjaiból áll, és csatlakozik a megadott tárolási területhez. Ez lehetővé teszi a következők végrehajtását:
- A teljes folyamat automatizálása a halál utáni helyreállításban, az egyik adatközpontban. Minden VM, amely a halott adatközpontban működött, mindenféle további eszköz nélkül automatikusan újraindul a megmaradt adatközpontban. RTO = a magas rendelkezésre állású klaszter időtúllépése (15 másodperc VMware esetén) + az operációs rendszer betöltési ideje és a szolgáltatások elindítása.
- Katasztrófaelkerülés vagy, ahogy oroszul mondják, кatasztrofák elkerülése. Ha tervezett elektromos munkák vannak az 1. adatközpontban, akkor lehetőségünk van a fontos terhelések folyamatos migrálására a 2. adatközpontba a munkák kezdete előtt.
Virtualizáció
A tárolóvirtualizáció technikailag azt jelenti, hogy más tárolók kötetét használjuk lemezként. A tárolóvirtualizáló egyszerűen átpasszolhatja a külső kötetet a felhasználóhoz mint sajátját, közben tükrözve azt egy másik tárolóra, vagy akár RAID-et is létrehozhat külső kötetekből.
A tárolóvirtualizáció klasszikus képviselői az EMC VPLEX és az IBM SVC. És természetesen a virtualizálási funkcióval rendelkező tárolók – NetApp, Hitachi, IBM / Lenovo Storwize.
Miért lehet szükség?
- Tárolón belüli tartalék. Tükör készül a kötetek között, ahol az egyik fél lehet HP 3Par, a másik pedig NetApp. És a virtualizátor az EMC-ből.
- Adatok áthelyezése minimális leállás mellett különböző gyártók tárolói között. Tegyük fel, hogy az adatokat egy régi 3Par-ról kell migrálni, ami elavul, egy új Dell-re. Ebben az esetben a felhasználók lekapcsolódnak a 3Par-ról, a kötetek átkerülnek a VPLEX alá és újra bemutatásra kerülnek a felhasználóknak. Mivel a kötet nem változott, a munka folytatódik. A háttérben elindul a kötet tükörzési folyamata az új Dell-re, és a tükör befejezése után szétválik, a 3Par leáll.
- Metrok klaszterek szervezése.
Tömörítés / deduplikáció
A tömörítés és deduplikáció olyan technológiák, amelyek lehetővé teszik, hogy helyet spóroljon el a tárolóján. Érdemes megemlíteni, hogy nem minden adat alkalmas tömörítésre és/vagy deduplikációra, emellett egyes adatfajták jobban tömöríthetők és deduplikálhatók, mint mások.
A tömörítés és deduplikáció 2 típusa létezik:
Inline — A tömörítés és a deduplikáció a blokkok előtárolásakor történik, mielőtt az adatokat a lemezre írnák. Így a rendszer csak kiszámítja a blokk hasht és összehasonlítja azt a már meglévő táblázattal. Egyrészt ez gyorsabban történik, mint a közvetlen lemezre írás, másrészt nem pazarlunk el felesleges lemezterületet.
Post — amikor ezeket a műveleteket már a lemezre írt adatokon hajtják végre. Ennek megfelelően az adatok először a lemezre íródnak, majd ezt követően számítják ki a hasht, és történik meg a felesleges blokkok törlése, ezzel felszabadítva a lemez erőforrásait.
Érdemes megemlíteni, hogy a legtöbb beszállító mindkét típust használja, ami lehetővé teszi ezeknek a folyamatoknak az optimalizálását és ezzel az effektivitás növelését. A legtöbb beszállító tárolórendszere rendelkezik olyan eszközökkel, amelyek lehetővé teszik az Ön adatközössel való elemzést. Ezek az eszközök ugyanazon logika szerint működnek, mint ami a tárolórendszerekben megvalósult, így az effektivitás becsült szintje is ütközik. Ne feledje, hogy sok beszállítónak vannak hatékonysági garancia programjai, amelyek megígérik a meghatározott (vagy minden) adat típusa számára legalább az ígért szintet. Ezt a programot nem érdemes figyelmen kívül hagyni, hiszen a rendszerét a feladataihoz igazítva, figyelembe véve az adott rendszer hatékonysági tényezőjét, elképzelhető, hogy spórolhat a szükséges kapacitáson. Érdemes azt is figyelembe venni, hogy ezek a programok AFA rendszerekre készültek, de mivel kevesebb SSD-t vásárolnak mint HDD-t a klasszikus rendszerekben, ez csökkentheti a költségeiket, és ha nem is azonos szintre, de közelíthet a lemezes rendszer költségéhez.
Modell
És itt eljutottunk a helyes kérdésfelvetéshez.
“Két tárolórendszert ajánlanak — ABC SuperStorage S600 és XYZ HyperOcean 666v4, mit tanácsolna?”
Átformálódik így: “Két tárolórendszert ajánlanak — ABC SuperStorage S600 és XYZ HyperOcean 666v4, mit tanácsolna?”
Célzott terhelés: vegyes VMware virtuális gépek termelési / teszt / fejlesztési kontúrok. Teszt = termelési. 150 TB minden egyeshez, csúcs teljesítménnyel 80 000 IOPS, 8 kb-os blokkkal, 50% véletlenszerű hozzáféréssel, 80/20 olvasás-írás. 300 TB a fejlesztéshez, 50 000 IOPS elegendő lesz, 80% véletlenszerű, 80% írás.
A termelés feltételezhetően metró klaszterben van, RPO = 15 perc, RTO = 1 óra, a fejlesztés aszinkron replikációban RPO = 3 óra, a teszt pedig egy helyszínen.
Lesz 50 TB adatbázis, jó lenne, ha lenne naplózásuk.
Nálunk mindenhol Dell szerverek vannak, a régi Hitachi tárolók alig bírják a terhelést, 50%-os növekedést tervezünk a kapacitás és a teljesítmény tekintetében.
Mint mondani szokás, egy jól megfogalmazott kérdés 80%-ban tartalmazza a választ.
Dokumentáció
Mivel érdemes még kiegészítőként foglalkozni a szerzők véleménye szerint.
Könyvek
- Olifer és Olifer 'Számítógépes hálózatok'. A könyv segít rendszerezni és esetleg jobban megérteni, hogyan működik az IP / Ethernet tárolórendszerek adatátviteli környezete.
- 'EMC Információtárolás és Menedzsment'. Csodálatos könyv a tárolórendszerek alapjairól, arról, hogy miért, hogyan és miért fontos ez.
Fórumok és chat szobák.
Általános ajánlások
Árak
Ami az árakat illeti — az adatkezelő rendszerek ára általában listaár, amelyből minden ügyfél egyedi kedvezményt kap. A kedvezmény mértéke sok tényezőből áll össze, így a végső ár kiszámítása a disztribútor megkeresése nélkül lehetetlen. Az utóbbi időben azonban az alacsony szintű modellek megjelentek a hagyományos számítógép boltokban, például vagy . Ezekben azonnal megvásárolhatja az Önt érdeklő rendszer egy fix áron, mint bármely számítógépes alkatrészt.
De szeretném azonnal hangsúlyozni, hogy a TB/$ arányú közvetlen összehasonlítás nem helyes. Ha e szempontból közelítünk, a legolcsóbb megoldás egy egyszerű JBOD + szerver lenne, ami nem nyújtja azt a rugalmasságot és megbízhatóságot, amit egy teljes értékű, két kontrollert tartalmazó tárolórendszer biztosít. Ez nem jelenti azt, hogy a JBOD rossz, egyszerűen csak nagyon tisztán kell érteni, hogy hogyan és milyen célokra fogja használni ezt a megoldást. Gyakran hallani, hogy a JBOD-ban nincs, ami eltörjön, ott egy bővítőlap található. Azonban a bővítőlapok is meghibásodhatnak. Minden elromlik előbb vagy utóbb.
Összesen
A rendszerek összehasonlítását nemcsak az ár, hanem a teljesítmény összessége alapján is el kell végezni.
Csak akkor vásároljon HDD-t, ha biztos benne, hogy szüksége van rá. Alacsony terhelés és tömöríthetetlen adatok esetén érdemes inkább SSD-meghajtók hatékonysággarancia-programjaira figyelni, amelyeket a legtöbb gyártó kínál (és valóban működnek, még Oroszországban is), de ez az alkalmazásoktól és az adatokról függ, amelyek ezen a tárolórendszeren fognak elhelyezkedni.
Ne csak az olcsóságra hajtson. Néha sok kellemetlen dolog rejlik mögötte, amiről Jevgenyij Elizárov írt a cikkeiben a . És végül ez az olcsóság akár még költségeket is okozhat önnek. Ne feledje — "aki olcsón akar vásárolni, kétszer fizet".
Forrás: habr.com
