

Idén júniusban a svájci Rapperswil városában tizedik alkalommal került megrendezésre az esemény, amelynek neve . Ez alkalommal több mint ötszáz Haskell-rajongó gyűlt össze, a kezdőktől a programozási nyelv alapító atyáiig. Bár a szervezők hackathonként emlegetik az eseményt, valójában nem klasszikus értelemben vett konferencia vagy hackathon. A formátuma eltér a megszokott programozói rendezvényektől. A ZuriHacról egy boldog véletlen folytán értesültünk, részt vettünk rajta, és most kötelességünknek érezzük, hogy beszámoljunk erről a különleges felfedezésről!
Rólunk
Ezt a cikket a harmadik éves "Alkalmazott matematika és informatika" program két hallgatója, Vaszilij Aljofjór és Jelezaveta Vasilenko készítette. Kettejük között a funkcionális programozás iránti érdeklődés a D. N. Moszkvin előadásain kezdődött a második év során az egyetemen. Jelenleg Vaszilij részt vesz a Google Summer of Code programban, ahol a Haskell nyelven algebrai gráfok megvalósításával foglalkozik a projektcsapat vezetése alatt. Jelezaveta a funkcionális programozás során megszerzett készségeit egy olyan kurzusmunkában alkalmazta, amely az antiszubsztitúciós algoritmus megvalósításáról szólt, amit később a tízorvosi elméletben használtak.
Az esemény formátuma
A célcsoportot a nyílt forráskódú projektek tulajdonosai, a fejlesztők, akik részt kívánnak venni a fejlesztésükben, a funkcionális programozás kutatói és egyszerűen a Haskell iránt lelkesedő emberek képviselik. Idén a rendezvény helyszínén, a HSR Hochschule für Technik Rapperswil egyetemen több mint ötven Haskell nyelvű nyílt projekt fejlesztője gyűlt össze a világ minden tájáról, hogy bemutassák termékeiket, és új embereket vonjanak be a fejlesztésükbe.
Twitterről készült fényképek
A rendszer nagyon egyszerű: előre meg kell írni néhány mondatot a projektünkről, és el kell küldeni a szervezőknek, akik a rendezvény weboldalán közzéteszik a projektünkről szóló információt. Ezen kívül az első napon a projekt szerzőinek harminc másodperc áll rendelkezésre, hogy röviden elmondják a színpadról, mivel foglalkoznak és mit kell tenniük. Ezután az érdeklődők keresni kezdik a szerzőket, és részletesebben érdeklődnek a feladatok felől.
Még nincsenek saját nyílt projektjeink, de nagyon szeretnénk hozzájárulni a már meglévőkhöz, ezért szimpla résztvevőkként regisztráltunk. Három nap alatt két fejlesztőcsoporttal dolgoztunk. Kiderült, hogy a kód közös tanulmányozása és a személyes interakció nagyon produktívvá teszi a projekt szerzői és a közreműködők közötti együttműködést – a ZuriHac alatt sikerült megértenünk számunkra új területeket, és segítettünk két teljesen különböző csapatnak, mindegyik projektben megoldva egy feladatot.
A ZuriHac során nagy értékű gyakorlati tapasztalatokon kívül számos előadást és mesterkurzust is hallgattunk. Két előadás különösen megmaradt bennünk. Az elsőn Andrej Mohov, a Newcastle Egyetem munkatársa beszélt a szelektív alkalmazási funktorokról – egy típuscsoport, amelynek köztes szerepet kell betöltenie az alkalmazási funktorok és a monádok között. A másik előadáson Simon Peyton Jones, a Haskell egyik alapítója mesélt a GHC fordító típuskiértékelésének működéséről.
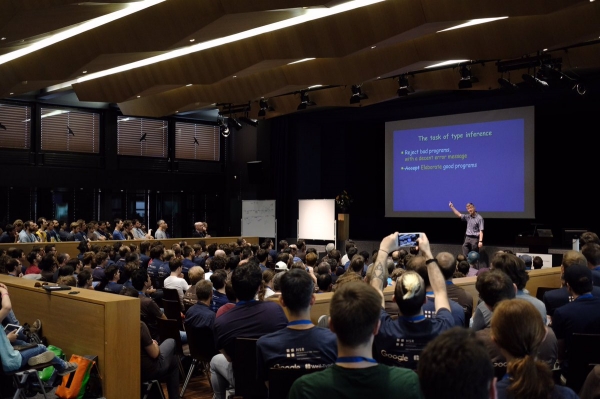
Simon Peyton Jones előadása. Fotó a Twitterről
A hackathon során tartott mesterkurzusokat három kategóriába sorolták a résztvevők felkészültségi szintje alapján. Azok a feladatok, amelyeket a projektek fejlesztéséhez csatlakozó résztvevőknek kínáltak, szintén nehézségi szint megjelölésével rendelkeztek. A kis, de összetartó funkcionális programozó közösség szívesen fogadja a kezdőket. Andrej Mohov és Simon Peyton Jones előadásaihoz azonban nagyon hasznos volt a felsőoktatásban szerzett funkcionális programozás kurzus.
Mind a szimpla résztvevők, mind a projekt szerzői számára a rendezvényre való regisztráció ingyenes. Június elején adtuk be a részvételi kérelmeinket, majd viszonylag gyorsan átkerültünk a várólistáról a megerősített résztvevők listájára.
Most pedig mesélni fogunk azokról a projektekről, amelyek fejlesztésében részt vettünk.
Pandoc
— ez egy univerzális szövegformátum átalakító, gyakorlatilag bármilyen formátumot át tud alakítani bármilyen másra. Például docx-ből pdf-be, vagy Markdown-ból MediaWiki-be. A szerzője, John MacFarlane, a Berkeley-i Kaliforniai Egyetem filozófiaprofesszora. A Pandoc egyébként elég ismert, és néhány ismerősünk meglepődött, amikor megtudták, hogy a Pandoc Haskelben készült.
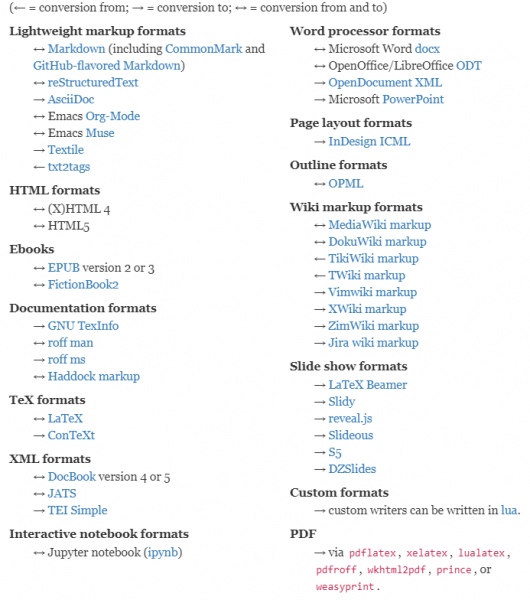
A dokumentumformátumok listája, amelyeket a Pandoc támogat. A weboldalon van egy teljes grafika is, de ez a kép nem fér be a cikkbe.
Természetesen a Pandoc nem valósítja meg a közvetlen átkonvertálást minden formátumpár esetében. Annyira sokféle átalakítást támogatva egy hagyományos architekturális megoldást alkalmaz: először az egész dokumentumot egy különleges belső köztes reprezentációra fordítja, majd erről a belső reprezentációról generálja a dokumentumot egy másik formátumban. A fejlesztők ezt a belső reprezentációt „AST”-nak hívják, ami az Abstract Syntax Tree rövidítése, vagyis . A köztes reprezentációt nagyon egyszerűen megtekinthetjük: ehhez csak annyit kell tennünk, hogy a kimeneti formátumot „native”-ra állítjuk.
$ cat example.html
<h1>Hello, World!</h1>

$ pandoc -f html -t native example.html
[Header 1 ("hello-world",[],[]) [Str "Helló,",Space,Str "Világ!"]]
Azok az olvasók, akik legalább egy kicsit dolgoztak Haskell-lel, már ebből a kisebb példából is sejthetik, hogy a Pandoc pontosan Haskell-ben készült: ennek a parancsnak a kimenete a Pandoc belső struktúráinak reprezentációja egy olyan sztringben, amely úgy készült, ahogyan azt általában a Haskell-ben szokták csinálni, például a szabványos könyvtárban.
Tehát itt látható, hogy a belső reprezentáció egy rekurzív struktúra, amelyben minden belső csomópont egy listát tartalmaz. Például a legfelső szinten egy elemből álló lista található - egy első szintű fejléc „hello-world” attribútumokkal, [], []. Ennek a fejlécnek a belsejében található a „Hello,”, egy szóköz és a „World!” sztringből álló lista.
Mint látható, a belső reprezentáció nem nagyon különbözik a HTML-től. Ez egy fa, ahol minden belső csomópont információt közöl az utódai formázásáról, és a levelekben található a dokumentum tényleges tartalma.
Ha a konkrét megvalósítás szintjén nézzük, a dokumentum teljes típusát így határozzák meg:
data Pandoc = Pandoc Meta [Block]Itt a Block éppen azok a belső csúcsok, amelyekről a fentiekben beszélnek, míg a Meta a dokumentum meta-információit tartalmazza, mint a cím, a létrehozás dátuma, a szerzők - különböző formátumok esetén ez változó, és a Pandoc próbálja megőrizni ezt az információt az átkonvertálás során.
Szinte az összes Block típusú konstruktor — például a Header vagy Para (bekezdés) — argumentumként fogadja az attribútumokat és egy alacsonyabb szintű elemek listáját — általában Inline. Például a Space vagy Str Inline típusú konstruktorok, és az HTML tag is saját speciális Inline-ként jelenik meg. Nincs értelme teljes definíciót adni ezekről a típusokról, azonban megjegyzendő, hogy azt itt meg lehet nézni. .
Érdekes, hogy a Pandoc típus egy monoid. Ez azt jelenti, hogy van valamiféle üres dokumentum, és a dokumentumokat össze lehet adni egymással. Ezt hasznos használni a Reader-ek írásakor — a dokumentumot tetszőleges logika szerint lehet részekre bontani, mindegyiket külön-külön elemezni, majd mindent egy dokumentummá összerakni. Ilyenkor a meta-információ minden rész dokumentumból egyszerre összegyűlik.
A konverzió során, mondjuk, LaTeX-ből HTML-be, először egy speciális modul, amelyet LaTeXReader-nek hívnak, átalakítja a bemeneti dokumentumot AST-vé, majd egy másik modul, amelyet HTMLWriter-nek hívnak, átalakítja az AST-t HTML-vé. Ennek az architektúrának köszönhetően nem szükséges kadratikus számú konverziót írni — elég minden új formátumhoz egy Reader-t és egy Writer-t létrehozni, és minden lehetséges konverziós pár automatikusan támogatva lesz.
Evidens, hogy ennek az architektúrának megvannak a saját hátrányai is, amelyeket a szoftverarchitektúra területén dolgozó szakemberek régóta előre jeleztek. A leglényegesebb hátrány a szintaktikai fa módosításának költsége. Ha a módosítás elég komoly, akkor minden Reader-ben és Writer-ben módosítani kell a kódot. Például az egyik kihívás, amellyel a Pandoc fejlesztőinek szembe kell nézniük, a bonyolult táblázatformátumok támogatása. Jelenleg a Pandoc csak a legegyszerűbb táblázatokat tudja kezelni, fejléc, oszlopok és cellánkénti értékek meglétével. Mondjuk, az HTML-ben a colspan attribútumot egyszerűen figyelmen kívül hagyja. Ennek az eljárásnak az egyik oka a táblázatok egységes reprezentációs séma hiánya minden, vagy legalábbis sok formátumban — így nem világos, milyen formában kellene tárolni a táblázatokat a belső reprezentációban. De még a konkrét reprezentáció kiválasztása után is meg kell változtatni az összes olyan Reader-t és Writer-t, amely táblázatokkal kapcsolatos munkát támogat.
A Haskell nyelvet nemcsak a funkcionális programozás iránti nagy szeretet választotta a szerzők. A Haskell széleskörű lehetőségekkel rendelkezik a szövegek feldolgozásában. Az egyik példa a könyvtár — egy könyvtár, amely aktívan használja a funkcionális programozás koncepcióit — monoidek, monádák, applikatív és alternatív funktorok — az önálló parser-ek írásához. A Parsec teljes erejét láthatjuk a HaskellWiki-n, ahol egy egyszerű imperatív programozási nyelv teljes parser-ét elemezzük. Természetesen a Parsec-ot aktívan használják a Pandoc-ban is.
Röviden szólva, a monádák a szekvenciális parsolásra használatosak, amikor először ez, majd az következik. Például az alábbi példa:
whileParser :: Parser Stmt
whileParser = whiteSpace >> statement
Először a whitespace-t kell beolvasni, majd az statement-t, amely szintén Parser Stmt típusú.
Az alternatív funktorok a visszalépésre szolgálnak, ha a parsolás nem sikerült. Például,
statement :: Parser Stmt
statement = parens statement  sequenceOfStmt
Ez azt jelenti, hogy vagy megpróbáljuk beolvasni az statement-t zárójelben, vagy egymás után több statement-t próbálunk meg beolvasni.
Az applikatív funktorokat leginkább a monádák rövidítéseként használják. Például tegyük fel, hogy a tok függvény egy tokent olvas be (ez egy valós függvény a LaTeXReader-ből). Nézzük meg ezt a kombinációt:
const tok tokEz két tokent olvas be egymás után, és az elsőt fogja visszaadni.
Mindezekhez a klasszikusokhoz Haskell-ben szép szimbolikus operátorok léteznek, ami a Reader-ek programozását ASCII-művészethez hasonlítja. Csak csodálja meg ezt a csodálatos kódot.
A feladataink a LaTeXReader-hez kapcsolódtak. Vaszilij feladata a mbox és hbox parancsok támogatása volt, amelyek hasznosak csomagok írásakor LaTeX-ben. Elizabet felelőssége az epigraph parancs támogatása volt, amely lehetővé teszi a epigrafok megformázását LaTeX dokumentumokban.
Hatrace
A UNIX-szerű operációs rendszerekben gyakran megtalálható a ptrace rendszerhívás. Ez hasznos a programok környezetének hibakeresésénél és szimulálásánál, lehetővé téve a program által végrehajtott rendszerhívások nyomon követését. Például a nagyon hasznos strace segédprogram belsőleg éppen a ptrace-t használja.
A Hatrace egy könyvtár, amely interfészt biztosít a ptrace-hez Haskellben. A ptrace önmaga nagyon összetett, és közvetlen használata viszonylag nehéz, különösen funkcionális nyelvek esetén.
A Hatrace az indításkor úgy működik, mint a strace, és hasonló argumentumokat fogad. A különbség a strace-hez képest az, hogy ez is egy könyvtár, amely egyszerűbb interfészt kínál, mint csupán a ptrace.
A hatrace segítségével már sikerült észlelni egy kellemetlen hibát a Haskell GHC fordítójában — ha nem megfelelő időben állítják le, akkor érvénytelen objektumfájlokat generál és nem fordítja újra azokat újraindításkor. A rendszerhívások alapján történő szkriptelés lehetővé tette, hogy garantáltan reprodukáljuk a hibát egy futtatás során, amikor a véletlenszerű leállítások körülbelül két órába telt a hiba előidézése.
A könyvtárhoz rendszéhívások interfészeit adtunk — Elizabet brk-t, Vaszilij pedig mmap-et adott hozzá. A munkánk eredményeként egyszerűbben és pontosabban használhatók a rendszéhívások argumentumai a könyvtár használata során.
Forrás: habr.com
