

Megjegyzés fordítás.: Dailymotion — a világ egyik legnagyobb videóhosting szolgáltatása, és emiatt kiemelkedő felhasználója a Kubernetesnek. Ebben az anyagban David Donchez, a rendszerarchitekt, megosztja a cég K8s alapú production-platformjának létrehozásának eredményeit, amely egy felhő alapú telepítéssel indult a GKE-n, és végül hibrid megoldásként zárult, lehetővé téve a jobb reakcióidők elérését és az infrastrukturális költségek csökkentését.
A fő API átalakításáról hozott döntéskor három évvel ezelőtt szeretnénk egy hatékonyabb alkalmazásbehelyezési mód kidolgozására, és megkönnyíteni Ehhez a célhoz konténerorchestráló platformot döntöttünk használni, és természetes módon a Kubernetes mellett döntöttünk.
Miért érdemes saját Kubernetes alapú platformot létrehozni?
API production szintje a lehető legrövidebb időn belül a Google Cloud segítségével.
2016 nyara
Három évvel ezelőtt, közvetlenül a Dailymotion Vivendi általi megvásárlása után , mérnöki csapataink egy globális célra összpontosítottak: egy teljesen új Dailymotion termék létrehozására.
A konténerek, az orchestration megoldások elemzése és korábbi tapasztalataink alapján megerősítettük, hogy a Kubernetes a megfelelő választás. Néhány fejlesztőnknek már volt ismerete az alapvető fogalmakról, és tudták, hogyan kell használni, ami óriási előnyt jelentett az infrastrukturális átalakítás során.
Infrastruktúra szempontjából egy erőteljes és rugalmas rendszerre volt szükségünk az új típusú felhőalapú alkalmazások telepítésére. Az utazásunk kezdetén úgy döntöttünk, hogy a felhőben maradunk, hogy nyugodtan felépíthessük a lehető legmegbízhatóbb helyi platformot. Alkalmazásainkat a Google Kubernetes Engine segítségével szerettük volna telepíteni, bár tudtuk, hogy előbb-utóbb saját adatközpontba fogunk áttérni, és hibrid stratégiát fogunk alkalmazni.
Miért választottuk a GKE-t?
Elsősorban technikai megfontolások alapján hoztuk ezt a döntést. Ezen kívül gyorsan kellett biztosítanunk olyan infrastruktúrát, amely megfelel a vállalat üzleti igényeinek. Volt néhány követelményünk az alkalmazásbehelyezéssel kapcsolatban, például a földrajzi elosztottság, a skálázhatóság és a hibabiztosság.
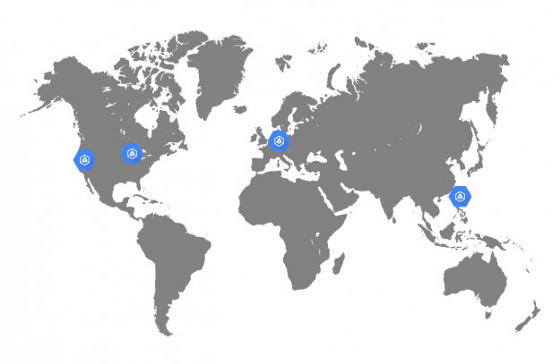
GKE klaszterek Dailymotionnál
Mivel a Dailymotion egy világszerte elérhető videoplatform, kiemelten fontos volt számunkra a szolgáltatás minőségének javítása a várakozási idő csökkentése érdekében. (latency)Korábban csak Párizsban volt elérhető, ami nem volt optimális. Azt szerettem volna, hogy az alkalmazásokat ne csak Európában, hanem Ázsiában és az Egyesült Államokban is telepíthessük.
Ez a késleltetés iránti érzékenység azt jelentette, hogy komolyan kell dolgozni a platform hálózati architektúráján. Míg a legtöbb felhőszolgáltatás megkövetelte, hogy saját hálózatot hozzunk létre minden régióban, és azt VPN-en vagy valamilyen kezelőszolgáltatáson keresztül összekapcsoljuk, a Google Cloud lehetővé tette egy teljesen irányítható, egyetlen hálózat létrehozását, amely minden Google régiót átfog. Ez nagy előny a rendszer üzemeltetése és hatékonysága szempontjából.
Továbbá, a Google Cloud hálózati szolgáltatásai és terheléselosztói is kiválóan teljesítenek. Csak lehetővé teszik a nyilvános IP-címek önkényes használatát minden régióból, és a csodálatos BGP protokoll gondoskodik minden másról (azaz átirányítja a felhasználókat a legközelebbi klaszterhez). Nyilvánvaló, hogy hiba esetén a forgalom automatikusan egy másik régióba irányul emberi beavatkozás nélkül.
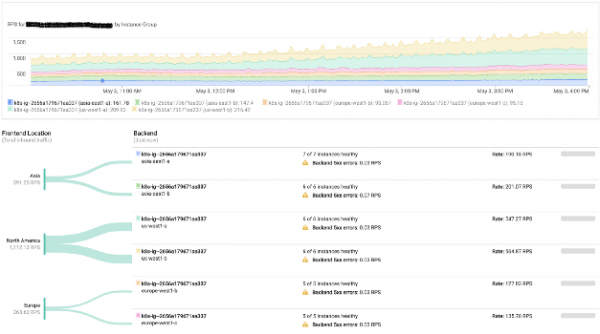
A Google terheléselosztásának figyelése
Platformunk szintén aktívan alkalmaz grafikus feldolgozó egységeket. A Google Cloud lehetővé teszi, hogy ezeket rendkívül hatékonyan használjuk a Kubernetes klaszterekben.
Abban az időben az infrastruktúra csapat többségében a régi stack-re összpontosított, amely fizikai szervereken volt telepítve. Ezért a kezelt szolgáltatás használata (ideértve a Kubernetes master komponenseket) megfelelt az igényeinknek, és lehetővé tette a csapatok képzését a helyi klaszterekkel való munkára.
Ennek eredményeként mindössze 6 hónap elteltével elkezdtük elfogadni a production forgalmat a Google Cloud infrastruktúrán.
Azonban a számos előny ellenére a felhőszolgáltatóval való munka hármas költségekkel jár, amelyek a terheléstől függően növekedhetnek. Ezért alaposan elemeztük az összes kezelt szolgáltatást, hogy a jövőben megvalósíthassuk azokat on-premises. Valójában a helyi klaszterek bevezetése 2016 végén kezdődött, és akkor indult el a hibrid stratégia is.
A Dailymotion helyi tároló konténer-orchestráló platformjának elindítása
2016 őszén
Abban a helyzetben, amikor az egész stack készen állt a production-ra, és a munka az API-n , eljött az idő, hogy a regionális klaszterekre összpontosítsunk.
Ekkor a felhasználók havonta több mint 3 milliárd videót néztek meg. Természetesen már több éve működött a saját kiterjedt Content Delivery Network rendszerünk. Ki akartuk használni ezt a lehetőséget, és Kubernetes klasztereket szeretnénk telepíteni a meglévő adatközpontokban.
A Dailymotion infrastruktúrája több mint 2500 szerverből állt hat adatközpontban. Mindegyiket Saltstack segítségével konfiguráltuk. Elkezdjük előkészíteni az összes szükséges receptet a master és worker csomópontok, valamint az etcd klaszter létrehozásához.
Hálózati rész
A hálózatunk teljes mértékben routolható. Minden szerver az Exabgp segítségével jelzi az IP-címét a hálózatban. Összehasonlítottunk több hálózati plugint, és az egyetlen, amely kielégítette az összes igényünket (a használt L3 szintű megközelítés miatt), az volt, . Tökéletesen illeszkedett a meglévő infrastruktúra hálózati modelljébe.
Mivel az összes meglévő infrastruktúraelemet szeretnénk kihasználni, először is meg kellett értenünk a saját hálózati eszközünket (amit minden szerveren használunk): ezt állítottuk be az IP-címek tartományának bejelentésére a Kubernetes csomópontokkal. Engedtük, hogy a Calico allokálja az IP-címeket a podoknak, de nem használtuk és nem használjuk a BGP ülésekhez a hálózati berendezéseken. Valójában a routolást az Exabgp végzi, amely a Calico által használt alhálózatokat hirdeti. Ez lehetővé teszi számunkra, hogy elérjük bármelyik podot a belső hálózatból (különösen a terheléselosztókból).
Hogyan kezeljük az ingress forgalmat
A bejövő kérések megcélzott szolgáltatásra történő átirányításához az Ingress Controller használata mellett döntöttünk, mivel integrálódik a Kubernetes ingress-erőforrásaihoz.
Három évvel ezelőtt az nginx-ingress-vezérlő volt a legfejlettebb vezérlő: az Nginx-t régóta használták, és ismert volt stabilitásáról és teljesítményéről.
Rendszerünkben úgy döntöttünk, hogy a vezérlőket dedikált 10 gigabites blade szervereken helyezzük el. Minden vezérlő a megfelelő klaszter kube-apiserver végpontjához csatlakozott. Ezeken a szervereken az Exabgp-t is használtuk nyilvános vagy magán IP-címek bejelentésére. Hálózatunk topológiája lehetővé teszi, hogy a BGP-t ezekből a vezérlőkből a podok közvetlen forgalmának irányítására használjuk, elkerülve a NodePort típusú szolgáltatásokat. Ez a megközelítés segít elkerülni a vízszintes forgalmat a csomópontok között, és növeli a hatékonyságot.
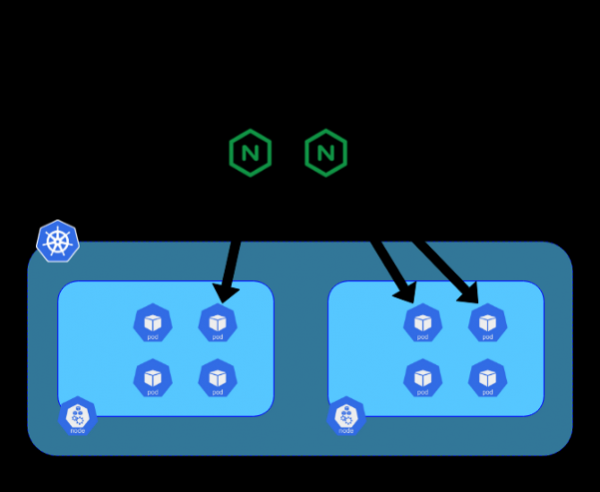
A forgalom irányítása az internetről a podokhoz
Most, hogy tisztáztuk a hibrid platformunkat, mélyebbre áshatunk a forgalom migrálási folyamatába.
A forgalom migrálása a Google Cloud-ból a Dailymotion infrastruktúrájába
2018 őszén
Majdnem két év fejlesztés, tesztelés és beállítás után végre megkaptuk a teljes Kubernetes stacket, amely készen áll a forgalom egy részének kezelésére.
Jelenlegi forgalomirányítási stratégiánk meglehetősen egyszerű, de teljesen kielégíti az igényeket. A nyilvános IP-címeken (Google Cloud-ban és Dailymotion-ban) kívül az AWS Route 53-at használjuk politikák meghatározására és a felhasználók átirányítására a választott klaszterünk felé.
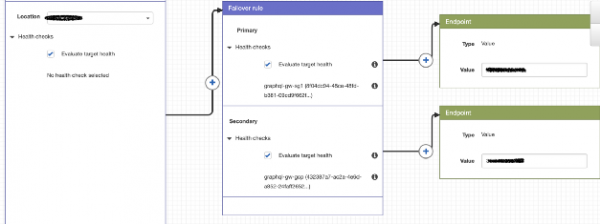
Példa irányítási politikára Route 53 használatával
A Google Cloud-dal ez egyszerű, mivel egyetlen IP-t használunk az összes klaszterhez, és a felhasználó a legközelebbi GKE klaszterhez van átirányítva. A klaszterink más technológiát használnak, mivel az IP-címük eltér.
A migrálás során arra törekedtünk, hogy a regionális kéréseket a megfelelő klaszterekhez irányítsuk, és értékeltük ennek a megközelítésnek az előnyeit.
Mivel GKE klasztereink automatikus skálázásra vannak konfigurálva egyedi metrikák segítségével, a bejövő forgalom alapján növelik/csökkentik a kapacitásukat.
Normál üzemmódban az összes regionális forgalmat a helyi klaszterre irányítjuk, míg a GKE tartalékot képez a problémák esetére (health-check-eket a Route 53 végez).
…
A jövőben teljesen automatizálni szeretnénk a forgalomirányítási politikákat, hogy egy önálló hibrid stratégiát valósítsunk meg, amely folyamatosan javítja a felhasználók elérhetőségét. Az előnyök között említést nyer, hogy jelentősen csökkentek a felhőkiadások, és sikerült még az API válaszidejét is csökkenteni. Bízunk a kialakult felhőplatformban, és készen állunk, hogy szükség esetén több forgalmat irányítsunk rá.
Fejlesztési eszközök, amelyek Kubernetesben futnak
Lehet, hogy egy másik, nemrég megjelent Dailymotion publikáció is érdekli önt a Kubernetesről. Ez a Helm alkalmazások tömeges telepítésével foglalkozik több Kubernetes klaszteren keresztül, és körülbelül egy hónappal ezelőtt.
Olvasson további információkat a blogunkban:
- «».
- «»;
- «»;
- «»;
- «»;
- «»;
- «»;
- «»;
- «»;
- «»;
- «».
Forrás: habr.com
