

3. Strukturális lehetőségek globálok használatakor
Az egységes fa struktúra különböző speciális esetei vannak. Tekintsük azokat, amelyek gyakorlati értékkel bírnak globálokkal való munka során.
3.1 Speciális eset 1. Egy csomópont ágbélkül
 Globálokat nem csak tömbként használhatunk, hanem mint hagyományos változókat is. Például, mint számláló:
Set ^counter = 0  ; számláló beállítása
Set id=$Increment(^counter) ; atomikus inkrementálás
Eközben a globálnak a tárolt érték mellett ágai is lehetnek. Az egyik nem zárja ki a másikat.
3.2 Speciális eset 2. Egy csúcs és sok ág
Általánosságban ez egy klasszikus kulcs-érték alap. Ha az értékként értékpárokat tárolunk, akkor a legszokványosabb táblázatot kapjuk elsődleges kulccsal.
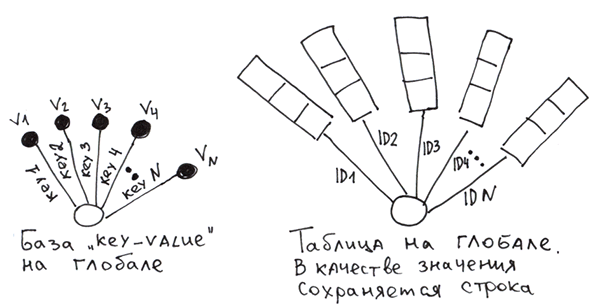
A globálokon táblázat létrehozásához nekünk magunknak kell formálnunk a sorokat az oszlopok értékeiből, majd elmenteni őket a globálba az elsődleges kulcs szerint. Ahhoz, hogy olvasáskor újra el lehessen választani a sorokat az oszlopoktól, használhatunk:
- elválasztó karaktereket.
Set ^t(id1) = "col11/col21/col31" Set ^t(id2) = "col12/col22/col32" - szigorú sémát, amelyben minden mező előre meghatározott számú bájtot foglal el. Ahogyan azt relációs adatbázisok esetén is szokás.
- speciális $LB (elérhető a Cache-ben) funkciót, ami sorként állítja össze az értékeket.
Set ^t(id1) = $LB("col11", "col21", "col31")
Set ^t(id2) = $LB("col12", "col22", "col32")
Ami érdekes, hogy globálok esetén könnyen létrehozhatunk hasonlót a relációs adatbázisok másodlagos indexeihez. Ezeket az adatstruktúrákat indexglobáloknak nevezzük. Az indexglobál egy segédfa a gyors kereséshez a mezőkön, amelyek nem alkotják a fő globál elsődleges kulcsának részét. Ennek feltöltéséhez és használatához további kódot kell írni.
Hozzunk létre egy indexglobált az első oszlop alapján.
Set ^i("col11", id1) = 1
Set ^i("col12", id2) = 1
Most már az első oszlopon történő gyors kereséshez bele kell néznünk a globálba ^i és megkeresni az első oszlop megfelelő értékéhez tartozó elsődleges kulcsokat (id).
Amikor értéket adunk hozzá, az indexglobálokat is azonnal létrehozhatjuk a szükséges mezők szerint. A megbízhatóság érdekében mindezt egy tranzakcióba zárjuk.
TSTART
Set ^t(id1) = $LB("col11", "col21", "col31")
Set ^i("col11", id1) = 1
TCOMMIT
Részletek arról, hogyan lehet M-ben , .
Az ilyen táblák ugyanolyan gyorsan fognak működni, mint a hagyományos adatbázisok (vagy akár még gyorsabban is), ha a sorok beszúrását/frissítését/törlését COS/M nyelven írjuk meg és lefordítjuk.Ezt az állítást tömeges INSERT és SELECT tesztekkel ellenőriztem egy kétoszlopos táblán, a TSTART és TCOMMIT (tranzakciók) parancsok felhasználásával.
Bonyolultabb forgatókönyveket párhuzamos hozzáféréssel és tranzakciókkal nem teszteltem.
Tranzakciók alkalmazása nélkül az 1.000.000 értéknél 778 361 beszúrás/másodperc sebességet mértem.
300 millió értéknél 422 141 beszúrás/másodperc volt.
Tranzakciók használatával 572 082 beszúrás/másodperc sebességet értünk el 50 millió beszúrásnál. Minden művelet lefordított M-kódból készült.
A merevlemezek hagyományosak, nem SSD-k. RAID5 Write-back módban. A processzor Phenom II 1100T.
Hasonló SQL adatbázis teszteléséhez egy tárolt eljárást kell írni, amely ciklusban végzi el a beszúrásokat. A MySQL 5.5 (InnoDB tároló) tesztelése során e módszer alkalmazásával 11 ezer beszúrást sem értem el másodpercenként.
Igen, a globális táblák megvalósítása bonyolultabbnak tűnik, mint a relációs adatbázisoké. Ezért az ipari globális adatbázisok SQL hozzáféréssel rendelkeznek, hogy megkönnyítsék a táblás adatokkal való munkát.
 Ha pedig az adatmodell nem változik gyakran, a beszúrási sebesség nem kritikus, és az egész adatbázis könnyen ábrázolható normalizált táblák formájában, akkor egyszerűbb az SQL-t használni, mivel ez magasabb szintű absztrakciót biztosít.
 Ebben az egyedi esetben azt akartam bemutatni, hogy a globális táblák más adatbázisok létrehozására szolgáló építők lehetnek.. Olyan, mint egy assembler, amelyre más nyelveket lehet írni. Íme, példák arra, hogyan lehet globális táblák segítségével analógokat létrehozni
Ha valamilyen nem szabványos adatbázist kell létrehozni minimális erőfeszítéssel, érdemes a globális táblák irányába nézni.
3.3 Egyedi eset 3. Kétszintű fa, ahol a második szintű csomópontoknak fix számú ága van.
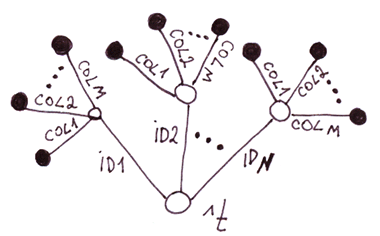 Valószínűleg kitalálták: ez egy alternatív megvalósítás a globális táblákra. Hasonlítsuk össze ezt a megvalósítást az előzővel.
Táblák kétszintű fán vs. egyszintű fán.
Hátrányok
Előnyök
- Lassabb a beszúrás, mivel a csomópontok számát a sorok számával kell beállítani.
- Több lemezterület-felhasználás. Mivel a globális indexek (a tömbök indexeiként értendők) oszlopnevekkel helyet foglalnak a lemezen, és minden sorhoz megismétlődnek.
- Gyorsabb hozzáférés az egyes oszlopok értékeihez, mivel nem szükséges párhuzamosan elemezni a sort. A tesztjeim szerint 11,5%-kal gyorsabb 2 oszlop esetén, és még nagyobb számú oszlopnál.
- Könnyebben változtatható az adatséma.
- Áttekinthetőbb kód.
Következtetés: az ízlés dolga. Mivel a sebesség az egyik legfontosabb előnye a globálisaknak, ennek következtében szinte nincs értelme ezt az megvalósítást használni, mert valószínűleg nem működik gyorsabban, mint a relációs adatbázisok táblái.
3.4 Általános eset. Fák és rendezett fák.
Bármilyen adatszerkezet, amely fakként ábrázolható, tökéletesen illeszkedik a globálisakhoz.
3.4.1 Objektumok alsóobjektumokkal.
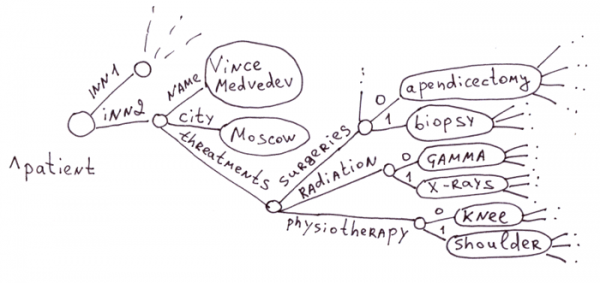
Ez a globálisok hagyományos alkalmazási területe. Az orvostudományi területen hatalmas a betegségek, gyógyszerek, tünetek és kezelési módszerek száma. Nem praktikus minden pácienshez egy milliónyi mezőből álló táblázatot létrehozni, főleg, hogy a mezők 99%-a üres lesz.
Képzeljünk el egy SQL adatbázist táblázatokkal: "páciens" ~ 100 000 mező, "Gyógyszer" — 100 000 mező, "Terápia" — 100 000 mező, "Szövődmények" — 100 000 mező stb. Vagy létrehozhatunk egy adatbázist több ezer táblából, mindegyik egy adott típust kezelve (és még átfedések is lehetnek!), kezelés, gyógyszer és ezer másik táblázat a kapcsolatok között.
A globálisak tökéletesen illeszkednek az orvostudományhoz, mivel lehetővé teszik, hogy minden páciens számára pontos leírást adjunk a betegség történetéről, különböző terápiákról és a gyógyszerek hatásairól fákként, anélkül, hogy felesleges lemezterületet pazarolnánk üres oszlopokra, ahogy az relációs esetben történne.
 Globálisokon kényelmesen lehet adatbázist létrehozni emberekről., amikor fontos, hogy a lehető legtöbb változatos információt gyűjtsük és rendszerezzük az ügyfélről. Ez keresett az orvostudományban, a banki szektorban, a marketingben, az archívumokban és más területeken.
.
Természetesen az SQL-en is lehet szimulálni a fát néhány táblával (, ,,,,,,,,,), de ez lényegesen összetettebb és lassabban fog működni. Alapvetően globális megoldást kellene írni táblázatokra, és minden táblázati műveletet egy absztrakciós réteg alá rejteni. Nem helyes alacsonyabb szintű technológiát (globális) magasabb szintű eszközökkel (SQL) szimulálni. Nem célszerű.
Nem titok, hogy az adatséma módosítása hatalmas táblázatokon (ALTER TABLE) jelentős időt vehet igénybe. A MySQL például az ALTER TABLE ADD|DROP COLUMN műveleteknél az információ teljes másolását végzi a régi táblából az új táblába (teszteltem a MyISAM és InnoDB motorokat). Ez akár napokig, sőt hetekig is felfüggesztheti a munkát egy milliárd rekordot tartalmazó adatbázis esetén.
 Az adatszerkezet módosítása, ha globálokat használunk, nem jelent számunkra semmit. Bármikor új tulajdonságokat adhatunk bármely objektumhoz, bármilyen hierarchiai szinten. A fiók újjánevezésére vonatkozó változtatásokat a működő adatbázison a háttérben hajthatjuk végre.
Ezért, ha nem kötelező tulajdonságokkal rendelkező objektumok tárolásáról van szó, a globálok remek választás.
Ráadásul emlékeztetek, hogy bármely tulajdonsághoz való hozzáférés azonnali, mivel a globálban minden út B-fa formájában jelenik meg.
A globális adatbázisok általában dokumentum-orientált adatbázisoknak számítanak, hierarchikus információk tárolásának lehetőségével. Így az orvosi kártyák tárolási terén a globálok versenyezhetnek a dokumentumorientált adatbázisokkal. De azért ez mégsem teljesen az.Vegyük például a MongoDB-t összehasonlításként. Ebben a szektorban a globálokkal szemben hátrányos helyzetben van az alábbi okok miatt:
- A dokumentum mérete. A tárolási egység a JSON (pontosabban BSON) formátumú szöveg, amelynek maximális mérete körülbelül 16MB. Ezt a korlátozást kifejezetten azért határozták meg, hogy a JSON-adatbázis ne lassuljon le a parszolás során, ha hatalmas JSON-dokumentumot tárolnak benne, amelyhez később mezőkön keresztül férnek hozzá. Ebben a dokumentumban kell összpontosítani minden információt a betegtől. Mind tudjuk, milyen vastagok lehetnek a betegdossziék. A maximum 16MB-os kártyaméret azonnal elkaszálja azokat a betegeket, akiknek a betegségkártyáik tartalmaznak MRI fájlokat, röntgenfelvételeket és egyéb vizsgálatokat. Egy globál ágán viszont gigabájtokat és terabájtokat is tárolhatunk. Elvileg itt le lehetne zárni a dolgot, de folytatom.
- A páciens térképének új tulajdonságainak tudomásul vétele / megváltoztatása / eltávolítása. Ez az adatbázis az egész térképet RAM-ba kell, hogy töltsön (ez nagy mennyiség!), értelmeznie kell a BSON-t, hozzá kell adnia / meg kell változtatnia / el kell távolítania egy új csomópontot, frissítenie kell az indexeket, be kell csomagolnia BSON-ba, és le kell mentenie a lemezre. A globális szintű hozzáféréshez elegendő, hogy közvetlenül egy adott tulajdonságra hivatkozzon, és manipulálja azt.
- A hozzáférés sebessége a különálló tulajdonságokhoz. Ha sok tulajdonság van a dokumentumban, és az több szintű struktúrával rendelkezik, akkor a különálló tulajdonságokhoz való hozzáférés gyorsabb lesz, mivel minden globális útvonal egy B-fához tartozik. A BSON-ban azonban lineárisan kell értelmezni a dokumentumot, hogy megtalálja a szükséges tulajdonságot.
3.3.2 Asszociatív tömbök
Az asszociatív tömbök (még a beágyazott tömbökkel is) tökéletesen illeszkednek a globális tárolóba. Például egy ilyen PHP tömb az első képen látható 3.3.1-ben jelenik meg.
$a = array(
  "name" => "Vince Medvedev",
  "city" => "Moscow",
  "treatments" => array(
    "surgeries" => array("apedicectomy", "biopsy"),
    "radiation" => array("gamma", "x-rays"),
    "physiotherapy" => array("knee", "shoulder")
  )
);
3.3.3 Hierarchikus dokumentumok: XML, JSON
Ugyanúgy tárolhatók a globális tárolóban is. A tárolás különféle módon végezhető.
XML
A legsimplebb módja az XML globalisra való lefordításának az, amikor a csomópontokban a címkék attribútumait tároljuk. Ha gyors hozzáférésre van szükség az attribútumokhoz, akkor azokat külön ágakba is rendezhetnénk.
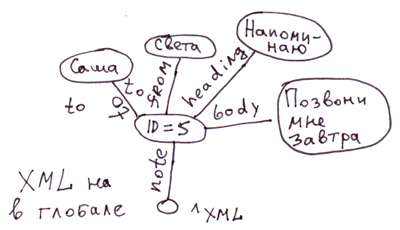
<note id="5">
<to>Vasila</to>
<from>Világ</from>
<heading>Emlékeztető</heading>
<body>Hívj fel holnap!</body>
</note>
A COS esetében ennek megfelelő kód:
Set ^xml("note")="id=5"
Set ^xml("note","to")="Sasha"
Set ^xml("note","from")="Sveta"
Set ^xml("note","heading")="Emlékeztető"
Set ^xml("note","body")="Hívj fel holnap!"
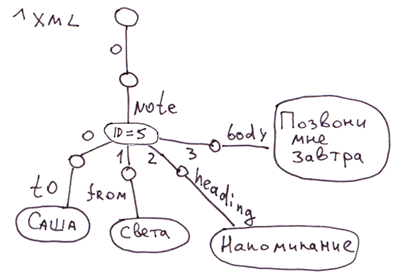
Megjegyzés: Az XML, JSON, asszociatív tömbök számára sokféle módon elképzelhető a globális tárolás. Ebben az esetben nem tükröztük a beágyazott címkék sorrendjét a note címkében. A globálban ^xml a beágyazott címkék ábécé rendben jelennek meg. A szigorú sorrend tükrözésére például ilyen megjelenítést használhatunk:
JSON.
Az 3.3.1-es fejezet első képe bemutatja ennek a JSON-dokumentumnak a megjelenítését:
var document = {
  "name": "Vince Medvedev",
  "city": "Moscow",
  "treatments": {
    "surgeries": ["apedicectomy", "biopsy"],
    "radiation": ["gamma", "x-rays"],
    "physiotherapy": ["knee", "shoulder"]
  },
};
3.3.4 Azonos struktúrák, hierarchikus kapcsolatokkal
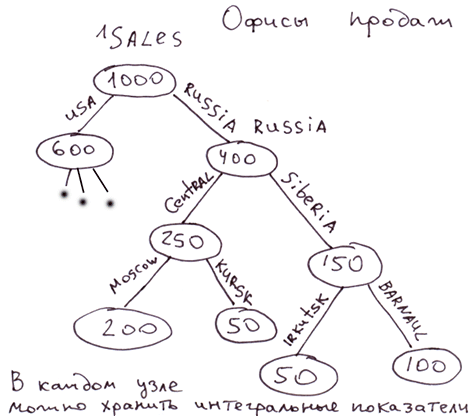
Példák: az értékesítési irodák struktúrája, emberek elhelyezése MLM struktúrában, a sakk megnyitók adatbázisa.
A megnyitók adatbázisa. A globális csomópont indexértékeként a lépés erejének értéke használható. Így a legerősebb lépés kiválasztásához elegendő a legnagyobb súlyú ágat választani. A globálisban minden ág minden szinten az lépés ereje szerint lesz rendezve.
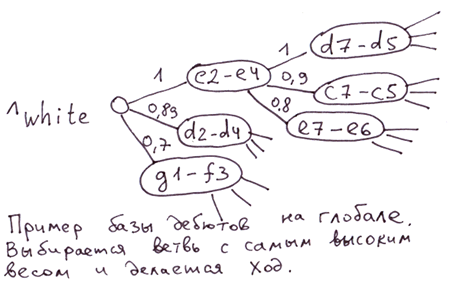
Az értékesítési irodák struktúrája, az MLM-ben résztvevő emberek struktúrája. A csomópontokban tárolhatók olyan gyorsítótárazott értékek, amelyek az egész részfa jellemzőit tükrözik. Például a megadott részfa értékesítési voluméja. Bármikor megkaphatjuk a számot, amely bármely ág teljesítményét tükrözi.
4. Mely esetekben a legkedvezőbb a globálisok használata?
Az első oszlopban azok az esetek vannak feltüntetve, amikor a globálisok használatával jelentős sebességnyereséget érhet el, a második oszlopban pedig amikor egyszerűbbé válik a fejlesztés vagy az adatminta.
Sebesség
Az adatok feldolgozásának/bemutatásának kényelme
- Beszúrás [automatikus rendezéssel minden szinten], [indexelés a fő kulcs szerint]
- A részfák eltávolítása
- Olyan objektumok, amelyek sok beágyazott tulajdonsággal rendelkeznek, amelyekhez egyedi hozzáférés szükséges.
- Hierarchikus struktúra, amely lehetővé teszi a gyermekágak bejárását bármilyen, akár nem létező ágból.
- Részfák mélységi bejárása
- Olyan objektumok/entitások, amelyek óriási mennyiségű opcionális [és/vagy beágyazott] tulajdonsággal/entitásokkal rendelkeznek.
- Sémamentes adatok (schema-less). Amikor gyakran új tulajdonságok jelenhetnek meg, és régi tulajdonságok eltűnhetnek.
- Nem szabványos adatbázist kell létrehozni.
- Útvonalak és döntési fák. Amikor az utakat fák formájában kényelmes bemutatni.
- Hierarchikus struktúrák eltávolítása rekurzió használata nélkül.
Folytatás .
Megjegyzés: Ez a cikk és az ehhez fűzött megjegyzéseim a saját véleményemet tükrözik, és nem állnak kapcsolatban az InterSystems vállalat hivatalos álláspontjával.
Forrás: habr.com
