

Hogyan lehet tízszeresére növelni az adatbázis-lekérdezések számát anélkül, hogy nagyobb teljesítményű szerverre kellene váltani, miközben a rendszer működőképességét megőrizzük? Elmondom, hogyan küzdöttünk az adatbázisunk teljesítménycsökkenésével, és hogyan optimalizáltuk az SQL lekérdezéseket úgy, hogy minél több felhasználót szolgálhassunk ki anélkül, hogy növelnénk a számítási erőforrásokra fordított költségeket.
Én egy szolgáltatást készítek az építőipari vállalatok üzleti folyamataik kezelésére. Körülbelül 3000 cég dolgozik velünk. Több mint 10 000 ember használja naponta a rendszerünket 4-10 órán keresztül. Különböző feladatokat old meg, mint például tervezés, értesítés, figyelmeztetés, és validálás… A PostgreSQL 9.6-ot használjuk. Az adatbázisunkban körülbelül 300 tábla található, és naponta akár 200 millió lekérdezés érkezik (10 ezer különböző). Átlagosan 3-4 ezer lekérdezésünk van másodpercenként, a legaktívabb időszakokban pedig több mint 10 ezer lekérdezés másodpercenként. A lekérdezések nagy része OLAP jellegű. Az új adatok hozzáadása, módosítása és törlése sokkal kevesebb, tehát az OLTP terhelés viszonylag kicsi. Mindezeket a számokat azért hoztam, hogy fel tudja mérni a projektünk méretét és megérthesse, milyen hasznos lehet a tapasztalatunk az Ön számára.
Első kép. Lírai
Amikor elkezdtük a fejlesztést, nem különösebben foglalkoztunk azzal, hogy mekkora terhelés nehezedik az adatbázisra, és hogy mit fogunk tenni, ha a szerver nem bírja a terhelést. Az adatbázis tervezésekor a általános ajánlásokat követtük, és igyekeztünk elkerülni a saját magunk ellen elkövetett hibákat, de ezen túlmenően, olyan általános tanácsok mint például az, hogy „ne használj mintát, nem mentünk tovább. A normalizálás elveit figyelembe véve terveztünk, elkerülve az adatduplikálódást, és nem törődtünk a különböző lekérdezések gyorsításával. Ahogy megérkeztek az első felhasználók, a teljesítménnyel kapcsolatos problémával találkoztunk. Mint mindig, teljesen felkészületlenül álltunk a helyzethez. Az első problémák viszonylag egyszerűek voltak. Általában új indexek hozzáadásával oldottuk meg őket. De elérkezett az idő, amikor az egyszerű megoldások megálltak. Felismerve, hogy a tapasztalataink hiányoznak és egyre nehezebb megérteni a problémák okát, szakértőket hívtunk, akik segítettek nekünk megfelelően beállítani a szervert, csatlakoztatni a megfigyelést, és megmutatták, hová érdemes figyelni, hogy .
második kép. Statisztikai
Tehát naponta körülbelül 10 ezer különböző lekérdezés fut a rendszerünk adatbázisában. Ezek közül a 10 ezer közül vannak óriások, amelyek 2-3 millió alkalommal futnak, átlagosan 0,1-0,3 ms végrehajtási idővel, és vannak olyan lekérdezések, amelyeknek az átlagos végrehajtási ideje 30 másodperc, és napi 100 alkalommal hívják meg őket.
Mivel lehetetlen volt optimalizálni az összes 10 ezer lekérdezést, úgy döntöttünk, hogy megtudjuk, hová irányítsuk az erőfeszítéseinket a megfelelő adatbázis teljesítmény javítása érdekében. Néhány iteráció után elkezdtük a lekérdezéseket típusok szerint kategorizálni.
TOP lekérdezések
Ezek a legnehezebb lekérdezések, amelyek a legtöbb időt (teljes idő) igénylik. Ezek olyan lekérdezések, amelyeket vagy nagyon gyakran hívnak meg, vagy nagyon hosszú ideig futnak (a hosszú és gyakori lekérdezéseket már az első iterációk során optimalizáltuk a sebesség növelése érdekében). Ennek eredményeként a szerver összességében a legtöbb időt ezek végrehajtására fordítja. Fontos megkülönböztetni a TOP lekérdezéseket a teljes végrehajtási idő és az IO idő alapján. Az ilyen lekérdezések optimalizálásának módszerei kissé eltérőek.
Minden cég szokásos gyakorlata a TOP lekérdezések kezelése. Ezekből van néhány, egyetlen lekérdezés optimalizálása akár 5-10% -os erőforrást is felszabadíthat. Azonban a projekt „életkorával” az ilyen lekérdezések optimalizálása egyre bonyolultabb feladattá válik. Minden egyszerű megoldást már alkalmaztak, és a leg „nehéz” lekérdezés is csak 3-5% -os erőforrást igényel. Ha a TOP lekérdezések összesen kevesebb mint 30-40% -ot használnak, akkor valószínűleg már tett erőfeszítéseket, hogy gyorsan működjenek, és itt az ideje áttérni a következő csoport lekérdezéseinek optimalizálására.
Még válaszolni kell a kérdésre, hány felső lekérdezést érdemes belevonni ebbe a csoportba. Általában nem kevesebb mint 10, de nem több mint 20 lekérdezést szoktam figyelembe venni. Megpróbálom úgy alakítani, hogy az első és az utolsó a TOP csoportban ne térjen el 10-szeresnél többel. Tehát, ha a lekérdezések végrehajtási ideje drámaian csökken az 1. helyről a 10. helyre, akkor a TOP-10-be sorolom, ha a csökkenés fokozatosabb, akkor a csoport méretét 15-re vagy 20-ra növelem.
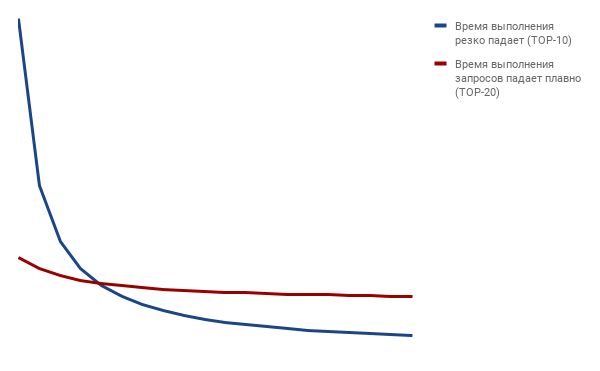
Középsők (medium)
Ezek azok a lekérdezések, amelyek közvetlenül a TOP után következnek, kivéve az utolsó 5-10%-ot. Általában ezek a lekérdezések optimalizálása rejti magában a szerver teljesítményének jelentős növelésének lehetőségét. Ezek a lekérdezések akár 80%-ot is „nyomhatnak”. De még ha a részarányuk meghaladja az 50%-ot is, akkor ideje rájuk figyelmesebben nézni.
Farok (tail)
Ahogy mondtuk, ezek a lekérdezések a végén vannak, és 5-10%-ot igényelnek az időből. Rájuk csak akkor lehet elfelejteni, ha nem használ automatikus lekérdezéselemző eszközöket, akkor az optimalizálás is olcsón megoldható.
Hogyan értékeljünk minden egyes csoportot?
SQL lekérdezést használok, amely segít az ilyen értékelés elkészítésében PostgreSQL esetén (biztos vagyok benne, hogy sok más DBMS-hez is írható hasonló lekérdezés).
SQL lekérdezés a TOP-MEDIUM-TAIL csoportok méretének értékelésére.
SELECT sum(time_top) AS sum_top, sum(time_medium) AS sum_medium, sum(time_tail)
FROM
(
  SELECT CASE WHEN rn  20 AND rn  800              THEN tt_percent ELSE 0 END AS time_tail
  FROM (
    SELECT total_time / (SELECT sum(total_time) FROM pg_stat_statements) * 100 AS tt_percent, query,
    ROW_NUMBER () OVER (ORDER BY total_time DESC) AS rn
    FROM pg_stat_statements
    ORDER BY total_time DESC
  ) AS t
)
AS ts
A lekérdezés eredménye három oszlop, amelyek mindegyike tartalmazza a lekérdezések kezelésére fordított idő százalékát ebből a csoportból. A lekérdezésen belül két szám található (az én esetemben ez 20 és 800), amelyek elválasztják az egyik csoport lekérdezéseit a másiktól.
Így körülbelül így aránylanak a lekérdezések arányai az optimalizálási munkák megkezdésekor és most.
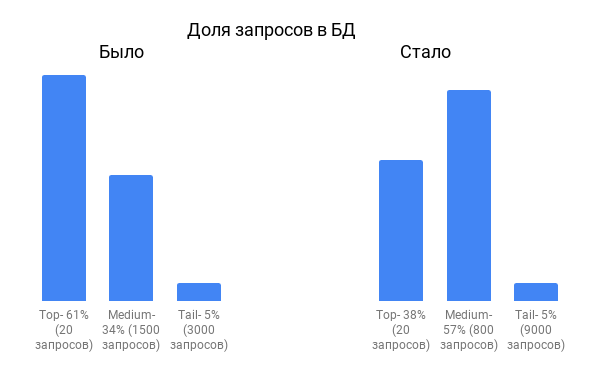
A diagramról látszik, hogy a TOP lekérdezések aránya élesen csökkent, viszont növekedtek a „középsők”.
Kezdetben a TOP lekérdezések közé nyilvánvaló hibák kerültek. Idővel a gyermekbetegségek eltűntek, a TOP lekérdezések aránya csökkent, egyre nagyobb erőfeszítéseket kellett tennünk a nehéz lekérdezések felgyorsításához.
A lekérdezések szövegének lekérésére a következő lekérdezést használjuk:
SELECT * FROM (
  SELECT ROW_NUMBER () OVER (ORDER BY total_time DESC) AS rn, total_time / (SELECT sum(total_time) FROM pg_stat_statements) * 100 AS tt_percent, query
  FROM pg_stat_statements
  ORDER BY total_time DESC
) AS T
WHERE
rn  20 AND rn  800  -- TAIL
Íme a leggyakrabban használt módszerek listája, amelyek segítettek nekünk a TOP lekérdezések felgyorsításában:
- A rendszer újratervezése, például a hirdetési logika újraszervezése üzenetkezelőn keresztül ahelyett, hogy időszakos lekérdezéseket végeznénk az adatbázison.
- Indexek hozzáadása vagy módosítása.
- ORM lekérdezések átírása tiszta SQL-re.
- A késleltetett adatok betöltésének logikájának átírása.
- Adatok denormalizálásán keresztüli caching. Például van egy kapcsolat a táblák között: Szállítás -> Számla -> Lekérdezés -> Kérelem. Azaz minden szállítás kapcsolódik a kérelemhez más táblákon keresztül. Annak érdekében, hogy ne kelljen minden lekérdezésben összekapcsolni az összes táblát, a kérelmet a Szállítás táblában is duplikáltuk.
- A statikus táblák gyorsítótárazása a program memóriájában lévő adókkal és ritkán változó táblákkal.
Néha a változtatások jelentős átalakítást igényeltek, de 5-10%-os rendszerleterhelést eredményeztek, így igazolták magukat. Idővel a haszon egyre csökkent, és az átalakítás egyre komolyabbá vált.
Ekkor figyeltünk fel a második kérdéscsoport, a középszerűek csoportjára. Sokkal több kérdés volt benne, és úgy tűnt, hogy az egész csoport elemzésére rengeteg idő fog elmenni. Azonban a legtöbb kérdés nagyon egyszerű volt az optimalizálás szempontjából, és sok probléma többször is előfordult különböző variációkban. Íme, néhány tipikus optimalizációs példa, amelyet hasonló kérdések tucatjaira alkalmaztunk, mindegyik optimalizált kérdéscsoport 3-5%-kal csökkentette az adatbázis terhelését.
- A COUNT használata helyett a rekordok meglétének ellenőrzésére az EXISTS használatára váltottunk.
- Megszabadultunk a DISTINCT-től (nincs általános recept, de néha könnyű lemondani róla, és ezzel 10-100-szor gyorsítani a lekérdezést).
Például a nagyméretű DELIVERY táblából az összes sofőr kiválasztására szánt lekérdezés helyett.
SELECT DISTINCT P.ID, P.FIRST_NAME, P.LAST_NAME
FROM DELIVERY D JOIN PERSON P ON D.DRIVER_ID = P.ID
a RELATIVELY SMALL PERSON táblára állítottuk a lekérdezést.
SELECT P.ID, P.FIRST_NAME, P.LAST_NAME
FROM PERSON
WHERE EXISTS(SELECT D.ID FROM DELIVERY WHERE D.DRIVER_ID = P.ID)
Úgy tűnik, hogy korreláló alműveket használtunk, de ez több mint 10-szer gyorsabb eredményt ad.
- Sok esetben teljesen lemondtunk a COUNT-ról és
- $CI_COMMIT_TAG
UPPER(s) LIKE JOHN%’használunk
s ILIKE 'John%'
Minden egyes konkrét lekérdezésnek sikerült olykor 3-1000-szer gyorsabbá tenni. A lenyűgöző mutatók ellenére kezdetben nem tűnt értelmesnek egy olyan lekérdezés optimalizálása, amely 10 ms-ot vesz igénybe, a legnehezebb lekérdezések harmadik századának része, és az adatbázis összes terhelésének csupán ezredmásodpercét képviseli. De ugyanazt a receptet alkalmazva hasonló lekérdezések csoportjaira, néhány százalékot nyertünk. Anélkül, hogy időt pazaroltunk volna az összes száz lekérdezés kézi átnézésére, írtunk néhány egyszerű szkriptet, amelyek reguláris kifejezésekkel azonosították a hasonló lekérdezéseket. Végül az automatikus lekérdezéscsoportra vonatkozó keresés még inkább növelte a teljesítményünket, csekély erőfeszítéssel.
Már három éve dolgozunk ugyanazon a hardveren. Az átlagos napi terhelés körülbelül 30%, a csúcsok során 70%-ig is elérheti. A lekérdezések száma és a felhasználók száma körülbelül tízszeresére nőtt. Mindez a TOP-MEDIUM lekérdezési csoportok folyamatos figyelésének köszönhető. Amint új lekérdezés jelenik meg a TOP csoportban, azonnal elemezzük és próbáljuk felgyorsítani. A MEDIUM csoportot hetente egyszer, lekérdezés-elemző szkriptek segítségével nézzük át. Ha új lekérdezéseket találunk, amelyeket már tudunk optimalizálni, akkor gyorsan változtatunk rajtuk. Néha új optimalizálási módokat találunk, amelyeket több lekérdezésre is azonnal alkalmazhatunk.
A becsléseink szerint a jelenlegi szerver képes a felhasználók számának 3-5-szörös növekedését elviselni. Igaz, hogy van még egy ütőlap a kezünkben - még mindig nem állítottuk át a SELECT lekérdezéseket tükrözésre, ahogy javasolják. De ezt szándékosan nem tesszük, mert először ki akarjuk aknázni a 'intelligens' optimalizálás lehetőségeit, mielőtt bevezetnénk a 'nehéz tüzérséget'.
A munkánk kritikus szemlélése arra utalhat, hogy érdemes lenne függőleges skálázást alkalmazni. Erősebb szervert venni, ahelyett, hogy időt pazarolnánk a szakembereinkre. Egy szerver nem feltétlenül drága, tekintettel arra, hogy a függőleges skálázás határai még nincsenek kihasználva. Azonban csak a lekérdezések száma nőtt tízszeresére. Az évek során a rendszer funkcionalitása is nőtt, és most már többféle lekérdezés létezik. Az a funkcionalitás, ami korábban volt, a gyorsítótárazás révén kevesebb, de hatékonyabb lekérdezéseket igényel. Tehát mondhatjuk, hogy bátran szorozhatjuk még 5-tel, hogy megkapjuk a valós sebességnövelési arányt. Így a legmodestabb számításaink szerint a sebességnövelés 50 és több szoros lehetett. A szervert 50-szer felfelé skálázni sokkal drágább lett volna. Különösen figyelembe véve, hogy egyszer végrehajtott optimalizálás folyamatosan működik, míg a bérelt szerver számlája minden hónapban érkezik.
Forrás: habr.com
