

A modern information system is quite complex. Its complexity is largely due to the complexity of the data being processed. The complexity of the data often lies in the variety of data models used. For instance, when data becomes 'big', one of the characteristics that causes inconvenience is not only their volume, but also their variety.
If you don't see any flaws in the reasoning so far, read on.
Tartalom
Polyglot persistence
The above leads to the situation where, within a single system, it often becomes necessary to use several different databases to store data and solve various processing tasks, each of which supports its own data model. Thanks to M. Fowler, a number of well-known books and one of the of the Agile Manifesto, this situation has been termed polyglot persistence. (‘polyglot persistence’).
Fowler also provides the following example of organizing data storage in a fully functional and highly loaded e-commerce application.
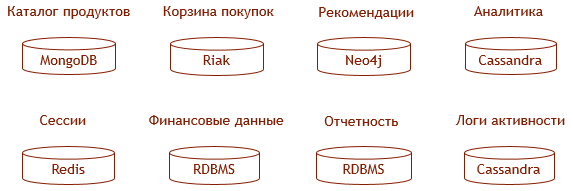
This example, of course, is somewhat exaggerated, but there are considerations in favor of choosing a particular database for a specific purpose, for instance, .
It is obvious that being a keeper in such a zoo is not easy.
- The volume of code responsible for data storage grows in proportion to the number of databases used; the volume of code that synchronizes the data — if not in proportion to the square of that number.
- The costs for ensuring enterprise characteristics (scalability, fault tolerance, high availability) of each database used increase exponentially with the number of databases.
- It is impossible to ensure enterprise characteristics for the storage subsystem as a whole — especially transactionality.
From the perspective of the zoo director, it looks like this:
- An exponential increase in the cost of licenses and support from the database vendor.
- A munkatársak számának növelése és a határidők elhúzódása.
- Közvetlen pénzügyi veszteségek vagy bírságok az adatok nem összehangoltsága miatt.
Jelentős növekedés tapasztalható a rendszer összesített tulajdonlási költségében (TCO). Van kiút a "multimodális tárolás" helyzetéből?
Multimodality
A "multimodális tárolás" kifejezés 2011-ben vált elterjedtté. A megközelítés problémáinak tudatosítása és a megoldás keresése évekbe telt, és 2015-re a Gartner elemzői megfogalmazták a választ:
- Az "»:
Az adatbázis-kezelő rendszerek jövője, architektúráik és felhasználási módjaik — multimodalitás.
- Az "»:
A vezető operációs adatbázis-kezelő rendszerek több modellt fognak kínálni — relációsat és nem relációsat — egyetlen platform részeként.
Úgy tűnik, hogy ezúttal a Gartner elemzői nem tévedtek a jóslatukkal. Ha ellátogatunk a DB-Engines adatbáziskezelői rangsorához, láthatjuk, hogy aóvezetőik többsége multimodális adatbázis-kezelőként pozicionálja magát. Ugyanezt láthatjuk bármely részletes rangsor oldalán is.
Az alábbi táblázatban az egyes részletes rangsorok vezető adatbázis-kezelő rendszerei találhatók, amelyek multimodalitásukat hangoztatják. Minden adatbázis-kezelő esetében szerepel az eredeti támogatott modell (ami valaha egyedüli volt), valamint az általa most támogatott modellek. Szintén találhatók azok az adatbázisok, amelyek "eredendően multimodálisnak" vallják magukat, és a készítők állítása szerint nem rendelkeznek semmiféle eredeti örökölt modellel.
| DBMS | Eredeti modell | További modellek |
|---|---|---|
| Oracle | Relációs | Grafikus, dokumentumos |
| MS SQL | Relációs | Grafikus, dokumentumos |
| PostgreSQL | Relációs | Grafikus*, dokumentumos |
| MarkLogic | Dokumentumos | Grafikus, relációs |
| MongoDB | Dokumentumos | Kulcs-érték, grafikus* |
| DataStax | Széles oszlopú | Dokumentumos, grafikus |
| Redis | Kulcs-érték | Dokumentumos, grafikus* |
| ArangoDB | — | Grafikus, dokumentumos |
| OrientDB | — | Grafikus, dokumentumos, relációs |
| Azure CosmosDB | — | Grafikus, dokumentumos, relációs |
Megjegyzések a táblázathoz
Csillaggal jelölt állítások a táblázatban fenntartásokat igényelnek:
- A PostgreSQL adatbázis-kezelő nem támogatja a grafikus adattípust, azonban egy olyan termék támogatja, például az AgensGraph.
- A MongoDB esetében helyesebb inkább grafikus operátorok meglétéről beszélni a lekérdezések nyelvében (, ), mint grafikus modell támogatásáról, bár természetesen bevezetésük némi optimalizálást igényelt a fizikai tárolási szinten a grafikus modell támogatásának irányában.
- A Redis esetében azt értjük, hogy kiterjesztés .
A következőben minden osztályhoz bemutatjuk, hogyan valósul meg a több modell támogatása ezen osztály SQL adatbázisaiban. A legfontosabbak a relációs, dokumentum és gráf modellek, és konkrét SQL adatbázis példáin keresztül mutatjuk be, hogyan valósulnak meg a „hiányzó” modellek.
Multimodal databases based on the relational model
A vezető SQL adatbázisok jelenleg a relációsok, Gartner előrejelzése nem lenne kivitelezhető, ha a relációs adatbázisok nem mutatnának mozgásokat a multimodell irányába. És mutatnak. Most már az a meglátás, hogy a multimodell SQL adatbázis olyan, mint egy svájci bicska, amellyel semmit sem lehet jól megcsinálni, azonnal Larry Ellisonra irányítható.
A szerző azonban jobban kedveli a multimodell implementációt a Microsoft SQL Serverben, amelynek példáján bemutatásra kerül a relációs adatbázisok dokumentum- és gráf modellek támogatása.
Document model in MS SQL Server
A MS SQL Server dokumentummodellel kapcsolatos támogatásáról a Habr-on már két kiváló cikk jelent meg, korlátozom magam egy rövid összefoglalóra és megjegyzésre:
A dokumentummodell támogatásának módja a MS SQL Serverben meglehetősen tipikus a relációs SQL adatbázisok számára: a JSON dokumentumokat sima szöveges mezőkben javasolják tárolni. A dokumentummodell támogatása speciális operátorok biztosításában áll a JSON elemzésére:
- az attribútumok skaláris értékeinek kinyerésére,
- a rész-dokumentumok kinyerésére.
A két operátor második argumentuma egy JSONPath-szerű szintaxist követő kifejezés.
Absztrakt módon elmondható, hogy ilyen módon tárolt dokumentumok nem számítanak a relációs SQL adatbázis "első osztályú entitásainak", ellentétben a tuple-ökkel. A MS SQL Serverben jelenleg nincsenek indexek a JSON dokumentum mezőkön, ami megnehezíti a táblák összekapcsolásának műveleteit ezeknek a mezőknek az értékeivel, sőt még a dokumentumok kinyerését is ezekkel az értékekkel. Ennek ellenére lehetséges olyan mezőre számított oszlopot és indexet létrehozni.
Továbbá a MS SQL Server lehetővé teszi a JSON dokumentumok kényelmes előállítását a táblák tartalmából az — lehetőség, amely bizonyos értelemben ellentétes a korábbi, hagyományos tárolással. Nyilvánvaló, hogy bármennyire is gyors egy RDBMS, ez a megközelítés ellentmond a dokumentumalapú DBMS filozófiájának, amelyek lényegében a népszerű lekérdezések kész válaszait tárolják, és csupán a fejlesztés kényelmi problémáit oldják meg, de nem a teljesítményt.
Végül is, az MS SQL Server lehetővé teszi ennek ellenkező problémájának megoldását: szét lehet bontani a JSON-t táblákra a segítségével. Ha a dokumentum nem teljesen lapos, szükség lesz a CROSS APPLY.
Graph model in MS SQL Server
támogatására is. A grafikus (LPG) modell támogatása a Microsoft SQL Serverben is jól : speciális táblák használata javasolt a csomópontok és a grafok élei tárolására. Az ilyen táblákat az alábbi kifejezések használatával hozhatjuk létre: CREATE TABLE AS NODE és CREATE TABLE AS EDGE vagy.
Az első típusú táblák hasonlítanak a normál rekordok tárolására szolgáló táblákhoz, annyiban különböznek, hogy a táblában egy rendszeres mező található, $node_id — egyedi az adatbázison belül, amely a graf csomópontjának azonosítója.
Hasonlóképpen, a második típusú táblák rendelkeznek a következő rendszeres mezőkkel, $from_id és $to_id, ezekben a táblákban a bejegyzések egyértelműen definiálják a csomópontok közötti kapcsolatokat. A kapcsolatok minden típusához külön táblát használnak.
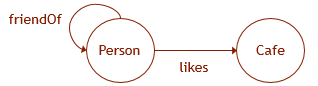 Illusztráljuk az elmondottakat egy példával. Tételezzük fel, hogy a grafikus adatok sémája a megadott illusztrációnak megfelelően van. Akkor a megfelelő struktúra létrehozásához az adatbázisban szükség van a következő DDL lekérdezések végrehajtására:
CREATE TABLE Person (
  ID INTEGER NOT NULL,
  name VARCHAR(100)
) AS NODE;

CREATE TABLE Cafe (
  ID INTEGER NOT NULL,
  name VARCHAR(100),
) AS NODE;

CREATE TABLE likes (
  rating INTEGER
) AS EDGE;

CREATE TABLE friendOf
  AS EDGE;

ALTER TABLE likes
  ADD CONSTRAINT EC_LIKES CONNECTION (Person TO Cafe);
Ezeknek a tábláknak a fő jellemzője, hogy lekérdezéseikben grafikus mintázatokat lehet használni Cypher-szerű szintaxissal (bár a „*” és egyéb hasonlók egyelőre nem támogatottak). Teljesítménymérések alapján azt is feltételezhetjük, hogy az ezekben a táblákban tárolt adatok tárolási módja eltér a hagyományos táblák adatok tárolási mechanizmusától és optimalizált a hasonló grafikus lekérdezések végrehajtására.
SELECT Cafe.name
  FROM Person, likes, Cafe
  WHERE MATCH (Person-(friendOf)-(likes)->Cafe)
  AND Person.name = 'John';
Továbbá, meglehetősen nehéz elkerülni a gráf minták használatát az ilyen táblák kezelésekor, mert a hasonló feladatok megoldásához a hagyományos SQL lekérdezésekben további erőfeszítéseket kell tenni a rendszerszintű "gráf" azonosítók beszerzésére a csomópontokhoz ($node_id, $from_id, $to_id; ugyanezen okból a beszúrási lekérdezések itt nem szerepelnek, mivel túlságosan terjedelmesek).
A dokumentum- és gráfmodellek MS SQL Serverben való megvalósításának összegzéseként megjegyezném, hogy az ilyen módon egyik modell a másik fölé építése nem tűnik szerencsésnek, elsősorban a nyelvi tervezés szempontjából. Egyik nyelvet a másikra kell kiterjeszteni, a nyelvek nem teljesen "ortogonálisak", a kompatibilitási szabályok pedig meglehetősen furcsák lehetnek.
Multimodal databases based on the document model
Ebben a részben szeretném illusztrálni a multimodalitás megvalósítását a dokumentumos adatbázisokban egy kevésbé népszerű példa, a MongoDB esetén (ahogy említettem, csak feltételes gráf operátorai vannak $lookup és $graphLookup, amelyek nem működnek shardolt gyűjteményekkel), hanem egy érettebb és "vállalati" adatbázis példáján keresztül. .
Tegyük fel, hogy a gyűjtemény XML-dokumentumok következő típusát tartalmazza (a MarkLogic is lehetővé teszi JSON-dokumentumok tárolását):
John
  Smith
Relational model in MarkLogic
A dokumentum gyűjtemény relációs reprezentációja létrehozható (az alábbi példában az elemek tartalma érték bármilyen XPath lehet):
/Person


      Person


          SSN
          @SSN
          string


          name
          name


          surname
          surname
A létrehozott nézethez SQL-lekérdezést lehet címkézni (például ODBC-n keresztül):
SELECT name, surname FROM Person WHERE name="John"Sajnos, az ábrázolási sablonnal létrehozott relációs nézet csak olvasásra van elérhető. A MarkLogic megpróbálja az indexeket felhasználni, amikor lekérdezést feldolgoz. . Korábban a MarkLogic-ban voltak korlátozott relációs nézetek, amelyek teljes mértékben és írásra elérhetőek voltak, de most már elavultnak számítanak.
Graph model in MarkLogic
A gráf modellek (RDF) támogatásával nagyjából így állnak a dolgok. Ismét, azzal, hogy lehetséges létrehozni az előző példa dokumentumainak RDF-képviseletét:
/Person
PREFIX
"http://example.org/example#"
sem:iri( $PREFIX || @SSN )
sem:iri( $PREFIX || surname )
sem:iri( $PREFIX || @SSN )
sem:iri( $PREFIX || name )
A kapott RDF gráfhoz SPARQL lekérdezést lehet címezni:
PREFIX :
SELECT ?name ?surname {
  :631803299804 :name ?name ; :surname ?surname .
}
A relációs modelltől eltérően a MarkLogic gráfmodellt még két másik módon támogatja:
- Az adatbázis egy teljes értékű külön RDF-adattároló lehet (a tripleteket megnevezés alatt tartják, ellentétben a fent leírtakkal) ).
- Az RDF különleges sorosításban egyszerűen beágyazható XML- vagy JSON-dokumentumokba (és akkor a tripleteket ). Valószínűleg ez egy alternatíva az
idrefés így tovább.
Jó kép érthető arról, hogyan is működik valójában a MarkLogic, az , ebben az értelemben alacsony szintű, bár a célja inkább az, hogy megpróbáljon absztrakciót nyújtani az alkalmazott adatmodellektől, valamint biztosítani a koherens munkát az adatokkal különböző modellekben, tranzakciós lehetőség és hasonlók.
Multimodal databases 'without a primary model'
A piacon már elérhetőek olyan adatbázisok is, amelyek az alapjaikban multimodálisak, és nincs semmilyen öröklött alapmodelljük. Ezek közé tartozik , (2018 óta a fejlesztő cég az SAP része) és (szolgáltatás a Microsoft Azure felhőplatform részeként).
Valójában az ArangoDB és az OrientDB "alap" modelljei léteznek. Mindkét esetben saját adatmodellek, amelyek a dokumentum orientált modellek általánosításai. Az általánosítások főként a gráf- és relációs jellegű lekérdezések egyszerűsítésében rejlenek.
Ezek a modellek a megadott DBMS-ekben az egyedül elérhetők a használatra, saját lekérdezési nyelveik vannak. Bár ezek a modellek és DBMS-ek ígéretesek, a szabványos modellekkel és nyelvekkel való inkompatibilitás lehetetlenné teszi azok használatát örökölt rendszerekben — már meglévő DBMS-ek helyettesítése velük nem lehetséges.
Az ArangoDB-ről és OrientDB-ről már volt egy nagyszerű cikk a Habr-on: .
ArangoDB
Az ArangoDB támogatja a gráf adatmodellt.
A gráf csomópontjai az ArangoDB-ben szokásos dokumentumok, míg az élek speciális típusú dokumentumok, amelyek rendes rendszerszintű mezők mellett (_key, _id, _rev) rendszerszintű mezők _from és _to. A dokumentumok a dokumentum-alapú DBMS-ekben hagyományosan gyűjteményekbe csoportosulnak. Az éleket képviselő dokumentumgyűjtemények az ArangoDB-ben a széleket képviselő gyűjtemények. Érdekesség, hogy a széleket képviselő dokumentumok is dokumentumok, ezért az élek az ArangoDB-ben csomópontokként is szolgálhatnak.
Forrásadatok
Tegyük fel, hogy van egy gyűjtemény, persons, dokumentumai így néznek ki:
[
  {
    "_id"  : "people/alice" ,
    "_key" : "alice" ,
    "name" : "Alice"
  },
  {
    "_id"  : "people/bob" ,
    "_key" : "bob" ,
    "name" : "Bob"
  }
]
Tegyük fel, hogy van egy gyűjtemény is, cafes:
[
  {
    "_id" : "cafes/jd" ,
    "_key" : "jd" ,
    "name" : "John Donne"
  },
  {
    "_id" : "cafes/jj" ,
    "_key" : "jj" ,
    "name" : "Jean-Jacques"
  }
]
Akkor a gyűjtemény, likes a következőképpen nézhet ki:
[
  {
    "_id" : "likes/1" ,
    "_key" : "1" ,
    "_from" : "persons/alice" ,
    "_to" : "cafes/jd",
    "since" : 2010
  },
  {
    "_id" : "likes/2" ,
    "_key" : "2" ,
    "_from" : "persons/alice" ,
    "_to" : "cafes/jj",
    "since" : 2011
  } ,
  {
    "_id" : "likes/3" ,
    "_key" : "3" ,
    "_from" : "persons/bob" ,
    "_to" : "cafes/jd",
    "since" : 2012
  }
]
Lekérdezések és eredmények
Az ArangoDB nyelvén használt gráf-stílusú lekérdezés, amely emberi olvasásra alkalmasan adja vissza, hogy kinek melyik kávézó tetszik, így néz ki:
FOR p IN persons
  FOR c IN OUTBOUND p likes
  RETURN { person : p.name , likes : c.name }
Relációs stílusban, amikor inkább „számítjuk” a kapcsolatokat, nem tároljuk őket, ezt a lekérdezést így lehetne átírni (érdekesség, hogy gyűjtemény nélkül likes is megoldható lett volna):
FOR p IN persons
  FOR l IN likes
  FILTER p._key == l._from
    FOR c IN cafes
    FILTER l._to == c._key
    RETURN { person : p.name , likes : c.name }
Mindkét esetben ugyanaz lesz az eredmény:
[
  { "person" : "Alice" , likes : "Jean-Jacques" } ,
  { "person" : "Alice" , likes : "John Donne" } ,
  { "person" : "Bob" , likes : "John Donne" }
]
További lekérdezések és eredmények
Ha úgy tűnik, hogy az eredmény formátuma inkább relációs DBMS-re jellemző, mint dokumentum orientáltra, megpróbálhatjuk ezt a lekérdezést (vagy használhatjuk ):
FOR p IN persons
  RETURN {
    person : p.name,
    likes : (
      FOR c IN OUTBOUND p likes
      RETURN c.name
    )
}
Az eredmény a következőképpen fog kinézni:
[
  { "person" : "Alíz" , likes : ["Jean-Jacques" , "John Donne"]  } ,
  { "person" : "Bob" , likes : ["John Donne"] }
]
OrientDB
A grafikon modell dokumentum alapú megvalósítása az OrientDB-ben azon alapul, hogy a dokumentumok mezőinek nemcsak többé-kevésbé szabványos skaláris értékeket kell tartalmazniuk, hanem olyan típusú értékeket is, mint például LINK, LINKLIST, LINKSET, LINKMAP és LINKBAG. Ezeknek a típusoknak az értékei hivatkozások vagy hivatkozásgyűjtemények dokumentumok.
A rendszer által hozzárendelt dokumentum azonosítója "fizikai értelemben" jelöli a bejegyzés helyét az adatbázisban, és körülbelül így néz ki: @rid : #3:16. Így a hivatkozásos tulajdonságok értékei valóban inkább mutatók (mint a gráfmodellben), nem pedig kiválasztási feltételek (mint a relációs adatbázisban).
Ahogyan az ArangoDB-ben, az OrientDB-ben az élek külön dokumentumokként jelennek meg (bár ha az élnek nincsenek saját tulajdonságaik, akkor ez lehet , és nem fog külön dokumentumot igényelni).
Forrásadatok
A formátumban, amely közel áll az OrientDB adatbázisban, az előző példában az ArangoDB-ből származó adatok körülbelül így néznének ki:
[
     {
      "@type": "document",
      "@rid": "#11:0",
      "@class": "Person",
      "name": "Alíz",
      "out_likes": [
        "#30:1",
        "#30:2"
      ],
      "@fieldTypes": "out_likes=LINKBAG"
    },
    {
      "@type": "document",
      "@rid": "#12:0",
      "@class": "Person",
      "name": "Bob",
      "out_likes": [
        "#30:3"
      ],
      "@fieldTypes": "out_likes=LINKBAG"
    },
    {
      "@type": "document",
      "@rid": "#21:0",
      "@class": "Cafe",
      "name": "Jean-Jacques",
      "in_likes": [
        "#30:2",
        "#30:3"
      ],
      "@fieldTypes": "in_likes=LINKBAG"
    },
    {
      "@type": "document",
      "@rid": "#22:0",
      "@class": "Cafe",
      "name": "John Donne",
      "in_likes": [
        "#30:1"
      ],
      "@fieldTypes": "in_likes=LINKBAG"
    },
    {
      "@type": "document",
      "@rid": "#30:1",
      "@class": "likes",
      "in": "#22:0",
      "out": "#11:0",
      "since": 1262286000000,
      "@fieldTypes": "in=LINK,out=LINK,since=date"
    },
    {
      "@type": "document",
      "@rid": "#30:2",
      "@class": "likes",
      "in": "#21:0",
      "out": "#11:0",
      "since": 1293822000000,
      "@fieldTypes": "in=LINK,out=LINK,since=date"
    },
    {
      "@type": "document",
      "@rid": "#30:3",
      "@class": "likes",
      "in": "#21:0",
      "out": "#12:0",
      "since": 1325354400000,
      "@fieldTypes": "in=LINK,out=LINK,since=date"
    }
  ]
Ahogyan láthatjuk, a csúcsok is tárolják az új bejegyzéseket és kimenő éleket. Amikor A dokumentum API-n a hivatkozási integritást maga kell figyelje, míg a Graph API ezt a feladatot átvállalja. Nézzük meg, hogyan néz ki az OrientDB-hez való lekérdezés a „tiszta”, programozási nyelvekbe nem integrált lekérdezési nyelveken.
Lekérdezések és eredmények
A lekérdezés, amely céljában hasonló az ArangoDB példájában bemutatotthoz, így néz ki az OrientDB-ben:
SELECT name AS person_name, OUT('likes').name AS cafe_name
   FROM Person
   UNWIND cafe_name
Az eredmény a következő formában fog érkezni:
[
  { "person_name": "Alíz", "cafe_name": "John Donne" },
  { "person_name": "Alíz", "cafe_name": "Jean-Jacques" },
  { "person_name": "Bob",  "cafe_name": "Jean-Jacques" }
]
Ha az eredmény formátuma túl „relációsnak” tűnik, el kell távolítania a sort, amely tartalmazza a :
[
  { "person_name": "Alíz", "cafe_name": [ "John Donne", "Jean-Jacques" ] },
  { "person_name": "Bob",  "cafe_name": [ "Jean-Jacques" ] }
]
Az OrientDB lekérdezési nyelve SQL-ként jellemezhető, Gremlin-szerű beillesztésekkel. A 2.2-es verzióban megjelent egy Cypher-szerű lekérdezési forma. :
MATCH {CLASS: Person, AS: person}-likes->{CLASS: Cafe, AS: cafe}
RETURN person.name AS person_name, LIST(cafe.name) AS cafe_name
GROUP BY person_name
Az eredményformátum megegyezik az előző lekérdezéssel. Gondolja át, mit kell eltávolítani, hogy a lekérdezés „relációsabb” legyen, mint az első lekérdezés.
Azure CosmosDB
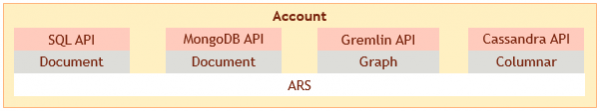
A fentiekhez képest az ArangoDB és az OrientDB minderre kisebb mértékben vonatkozik az Azure CosmosDB-re. A CosmosDB a következő API-kat kínálja az adatok elérésére: SQL, MongoDB, Gremlin és Cassandra.
Az SQL API és a MongoDB API a dokumentum alapú modell adataihoz való hozzáférésre szolgál. A Gremlin API és a Cassandra API pedig az adatokhoz való hozzáférésre szolgál graf- és oszloptípusúak esetén. Minden modell adatai a CosmosDB belső modelljének formátumában kerülnek tárolásra: ("atom-record-sequence"), amely szintén közel áll a dokumentum alapúhoz.
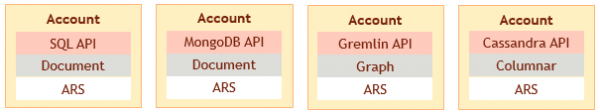
De a felhasználó által választott adatmodellek és az alkalmazott API-k a fiók létrehozásakor rögzítve vannak. Nem lehetséges hozzáférni az egy modellbe feltöltött adatokhoz egy másik modell formátumában, amit nagyjából így ábrázolhatnánk:
Ezzel együtt az Azure CosmosDB multimodelitása jelenleg csak annyit jelent, hogy egy gyártótól több adatbázist lehet használni, amelyek különböző modelleket támogatnak, ami nem oldja meg a többváltozós tárolás minden problémáját.
Multimodal databases based on the graph model?
Figyelemre méltó, hogy a piacon eddig nincs multimodális DBMS, amelynek alapja grafikus modell lenne (ha a multimodalitás alatt nem a két grafikus modell, az RDF és az LPG egyidejű támogatását értjük; erről bővebben lásd a ). A legnagyobb nehézséget a dokumentum grafikus modellje, nem pedig a relációs megvalósítása jelenti.
A kérdés, hogy a relációs modell hogyan valósítható meg a grafikus modell felett, már a relációs modell kialakulásának idején is terítéken volt. Mint , például, :
A grafikus megközelítésben nincs olyan belső korlát, amely megakadályozza egy olyan réteg létrehozását (pl. megfelelő indexeléssel) egy grafikus adatbázison, amely lehetővé teszi a relációs nézetet (1) a hozzávetőleges érték-párokból származó adatok visszanyerését és (2) a relációs típus szerint történő csoportosítást.
A grafikus modellre épülő dokumentummodell megvalósítása során figyelembe kell venni például a következőket:
- A JSON tömb elemei rendezettek, míg a gráfra támaszkodó élek kiinduló pontja nem;
- A dokumentummodellben az adatok általában denormalizáltak, nem szívesen tárolnánk több példányt ugyanarról a beágyazott dokumentumról, és a részadatoknak általában nincs azonosítójuk;
- Másrészt a dokumentum-alapú DBMS-ek ideológiája éppen az, hogy a dokumentumok kész 'aggregátumok', amelyeket nem szükséges minden alkalommal újraépíteni. A grafikus modellben gyorsan hozzáférhetővé kell tenni a kész dokumentumnak megfelelő alegységet.
Kicsit reklám
A cikk szerzője a NitrosBase DBMS fejlesztéséhez kapcsolódik, amelynek belső modellje grafikus, míg a külső modellek — relációs és dokumentum — annak reprezentációi. Minden modell egyenrangú: szinte bármely adat elérhető bármelyikben a saját lekérdezési nyelvén. Sőt, bármilyen megjelenítésben az adatok módosíthatók. A változtatások tükröződnek a belső modellen, és ennek megfelelően más megjelenítésekben is.
Hogyan néz ki a modellek megfeleltetése a NitrosBase-ban — remélem, az egyik következő cikkben le tudom írni.
Zárás
Remélem, hogy a multimodellal kapcsolatos általános kontúrok a kedves olvasó számára többé-kevésbé világossá váltak. A multimodellás adatbázisok általában különböznek egymástól, és a 'több modell támogatása' különbözőképpen nézhet ki. Ahhoz, hogy megértsük, mit neveznek 'multimodelezésnek' egy adott esetben, hasznos válaszolni a következő kérdésekre:
- A hagyományos modellek támogatásáról van szó, vagy egyfajta 'hibrid' modellről?
- A modellek 'egyenlő jogúak', vagy az egyik a másik fő modellje?
- „Indifferens” a modellek egymás iránt? Lehetséges, hogy az egyik modellben rögzített adatok olvashatók másikban, sőt át is írhatók?
Azt gondolom, hogy a multimodális DBMS-ek relevanciájára már pozitív választ lehet adni, de érdekes a kérdés, hogy mely típusok lesznek a legkeresettebbek a közeljövőben. Úgy tűnik, hogy a legkeresettebbek azok a multimodális DBMS-ek lesznek, amelyek támogatják a hagyományos modelleket, elsősorban a relációsat; a multimodális DBMS-ek népszerűsége, amelyek új modelleket kínálnak, amelyek különféle hagyományosak előnyeit ötvözik, pedig távolabbi jövő kérdése.
Csak a regisztrált felhasználók vehetnek részt a szavazáson. , kérem.
Használ multimodális DBMS-eket?
Nem használunk, minden adatot egy DBMS-ben és egy modellben tárolunk
Használjuk a hagyományos DBMS-ek multimodális lehetőségeit
Gyakorlunk többféle tárolást (polyglot persistence)
Új multimodális DBMS-eket használunk (Arango, Orient, CosmosDB)
19 felhasználó szavazott. 4 felhasználó tartózkodott.
Forrás: habr.com
