

Eddig az Odnoklassnikiben körülbelül 50 TB adat, amelyet valós időben dolgoznak fel, SQL Serverben tárolódott. Ilyen mennyiség esetén gyors és megbízható, sőt, még a meghibásodásokkal szemben is ellenálló adatközpont-hozzáférés biztosítása SQL DBMS használatával gyakorlatilag lehetetlen. Ilyen esetekben általában az egyik NoSQL tárolót használják, de nem mindent lehet áthelyezni NoSQL-be: egyes entitások ACID-tranzakciós garanciákat igényelnek.
Ez vezette el minket a NewSQL-tároló használatához, vagyis olyan DBMS-hez, amely a NoSQL rendszerek meghibásodás-ellenállóságát, skálázhatóságát és teljesítményét biztosítja, miközben megőrzi a klasszikus rendszerekben megszokott ACID garanciákat. Az iparban működő ilyen új osztályú rendszerek száma korlátozott, ezért mi saját rendszert valósítottunk meg, és üzembe helyeztük.
Hogyan működik és mi lett az eredmény – ezt olvashatod a kattintás után.
Ma az 'Odnoklassniki' havi közönsége több mint 70 millió egyedi látogatót számlál. Mi szociális hálózat közé tartozunk a világon, és a legforgalmasabb weboldalak húsz legjobbjának listáján található. Az "OK" infrastruktúra rendkívül magas terheléseket dolgoz fel: több mint egymillió HTTP-kérelmet másodpercenként a frontoknál. A szerverpark egy része, több mint 8000 gép, közel helyezkedik el egymáshoz – négy moszkvai adatközpontban, ami lehetővé teszi a hálózati késleltetés 1 ms-nál alacsonyabb értékének biztosítását.
2010 óta használjuk a Cassandrát, kezdve a 0.6 verziótól. Ma több tucat klaszter van üzemeltetésben. A leggyorsabb klaszter több mint 4 millió műveletet dolgoz fel másodpercenként, a legnagyobb pedig 260 TB-ot tárol.
Mindazonáltal mindezek tipikus NoSQL klaszterek, amelyeket az adatok tárolására használnak. Mi pedig azt szerettük volna, ha a fő konszolidált tárolót, a Microsoft SQL Servert, amelyet az 'Odnoklassniki' alapítása óta használunk, lecseréljük. A tároló több mint 300 SQL Server Standard Edition gépből állt, amelyekben 50 TB adat – üzleti entitások – találhatók. Ezek az adatok ACID-tranzakciók keretében módosulnak, és .
SQL Server adatainak csomópontok közötti elosztásához mind függőleges, mind vízszintes (shardolás). Történelmileg egyszerű adatmegosztási sémát használtunk: minden entitáshoz egy token volt rendelve — az entitás ID-jának függvénye. Azonos tokennel rendelkező entitások egy SQL-szerverre kerültek. A master-detail típusú kapcsolatot úgy valósították meg, hogy az eredeti és a származtatott rekord tokenei mindig megegyeztek és egy szerveren voltak. A közösségi hálózatban szinte minden bejegyzést a felhasználó nevében generálnak — tehát minden felhasználói adat egy funkcionális alkérdés keretein belül egy szerveren tárolódik. Ez azt jelenti, hogy a üzleti tranzakciók során szinte mindig ugyanazon SQL-szerver táblái vettek részt, ami lehetővé tette az adatok konzisztenciájának fenntartását helyi ACID-tranzakciókon keresztül, anélkül, hogy szükség lenne elágazott ACID-tranzakciókra.
A shardolásnak és az SQL teljesítményének javítása érdekében:
- Nem használunk külső kulcs korlátozásokat, mivel a shardolás során az entitás ID-je másik szerveren lehet.
- Nem használunk tárolt eljárásokat és trigger-eket a DBMS CPU-jának további terhelése miatt.
- Nem használunk JOIN-kat az előbb említettek és a sok véletlen leolvasás miatt a lemezen.
- Tranzakciók nélkül a holtpontok csökkentése érdekében a Read Uncommitted izolációs szintet alkalmazzuk.
- Csak rövid tranzakciókat hajtunk végre (átlagosan 100 ms-nál rövidebb).
- Nem használunk több soros UPDATE és DELETE parancsokat a sok holtpont miatt — csak egy-egy rekordot frissítünk.
- A lekérdezéseket mindig csak indexeken hajtjuk végre — egy olyan lekérdezés, amely teljes táblázat megtekintési tervével rendelkezik, számunkra a DB túlterhelését és leállását jelenti.
Ezek a lépések lehetővé tették, hogy majdnem maximális teljesítményt nyerjünk ki az SQL-szerverekből. Azonban a problémák egyre szaporodtak. Nézzük meg őket.
SQL problémák
- Mivel saját fejlesztésű shardolást használtunk, új shardok manuális hozzáadását az adminisztrátorok végezték. Ez idő alatt a skálázható adatmásolatok nem szolgálták ki a lekérdezéseket.
- Ahogy nőtt a rekordok száma a táblában, a beszúrás és módosítás sebessége csökkent, és ha indexeket adtunk hozzá a meglévő táblához, a sebesség drámaian esett, az indexek létrehozás és újrabefoglalás kieséssel járt.
- A produkciós környezetben lévő néhány Windows SQL Server megnehezíti az infrastruktúra kezelését
De a legnagyobb probléma —
Hibatűrés
A klasszikus SQL-szervernek gyenge a hibatűrése. Tegyük fel, hogy csak egy adatbázis-szervere van, és az három évente leáll. Ilyenkor a weboldal 20 percig nem működik, ami elfogadható. Ha 64 szervere van, akkor a weboldal háromhetente egyszer áll le. Ha pedig 200 szervere van, akkor a weboldal minden héten leáll. Ez probléma.
Mit tehetünk a SQL-szerver hibatűrésének növelése érdekében? A Wikipédia javasolja, hogy építsünk : ahol bármelyik komponens leállása esetén van egy másodlagos megoldás.
Ez költséges berendezéseket igényel: rengeteg duplikálás, optikai szál, közös tárolók, és a tartalék bekapcsolása is megbízhatatlanul működik: az indítások körülbelül 10%-a a tartalék csomópont leállásával ér véget a fő csomópont mögött.
De a legnagyobb hátránya ennek a magas rendelkezésre állású klaszternek, hogy a dátacentrum leállása esetén nulla rendelkezésre állást biztosít. Az "Odnoklassniki" négy adatközponttal rendelkezik, és biztosítanunk kell a működést, ha az egyik teljesen leáll.
Erre alkalmazhatnánk replikációt, amely be van építve az SQL Serverbe. Ez a megoldás jelentősen drágább a szoftver költsége miatt, és a replikációval kapcsolatos jól ismert problémáktól szenved, mint például a szinkron replikáció esetén a tranzakciók előre nem látható késlekedése, illetve a aszinkron replikációk alkalmazásának késlekedései (ezáltal pedig elveszett módosítások). A kézi konfliktusmegoldás pedig ezt a lehetőséget számunkra teljesen alkalmazhatatlanná teszi. teljesen alkalmazhatatlanná teszi ezt a lehetőséget számunkra.
Mindezek a problémák radikális megoldásokat igényeltek, és elkezdtük a részletes elemzésüket. Itt meg kell ismernünk, hogy az SQL Server alapvetően mit csinál — tranzakciókat.
Egyszerű tranzakció
Vizsgáljuk meg a legegyszerűbb tranzakciót, a szemszögéből nézve egy alkalmazás SQL-programozója számára: egy fénykép hozzáadása egy albumhoz. Az albumok és fényképek külön táblázatokban vannak tárolva. Az albumnak van egy számlálója a nyilvános fényképekre. Ebben az esetben a tranzakció a következő lépésekre oszlik:
- Zároljuk az albumot kulcs alapján.
- Létrehozunk egy bejegyzést a fényképek táblájában.
- Ha a fénykép nyilvános státuszú, akkor növeljük az album nyilvános fényképek számát, frissítjük a bejegyzést és elkötelezzük a tranzakciót.
Vagy álnéven:
TX.start("Albums", id);
Album album = albums.lock(id);
Photo photo = photos.create(…);

if (photo.status == PUBLIC ) {
    album.incPublicPhotosCount();
}
album.update();

TX.commit();
Látjuk, hogy a legelterjedtebb üzleti tranzakciós forgatókönyv az, amikor adatokat olvasunk az adatbázisból a alkalmazás szerver memóriájába, módosítunk valamit, és a új értékeket visszatesszük az adatbázisba. Általában egy ilyen tranzakcióban több entitást frissítünk, több táblázatot.
A tranzakció végrehajtása során a konkurens módosítások történhetnek ugyanazon adatokkal más rendszerekből. Például az antispam rendszerek úgy dönthetnek, hogy a felhasználó gyanús, ezért minden fotónak nem szabad nyilvánosnak lennie, ezeket moderációra kell küldeni, ami azt jelenti, hogy meg kell változtatni a photo.status-ot egy másik értékre, és vissza kell állítani a megfelelő számlálókat. Nyilvánvaló, hogy ha ez az eljárás atomikus alkalmazásának és a konkuráló módosítások elszigetelésének garanciái nélkül történik, mint a , akkor az eredmény nem az lesz, ami szükséges – vagy a fotószámláló helytelen értéket fog mutatni, vagy nem minden fotó kerül moderációra.
Hasonló kódok, amelyek különböző üzleti entitásokkal manipulálnak egy tranzáció keretein belül, az Odnoklassnikik létezése alatt nagyon sokat írtak. A NoSQL-ra való migrációk tapasztalata alapján tudjuk, hogy a legnagyobb nehézséget (és időráfordítást) az adatok konzisztenciájának fenntartására irányuló kód fejlesztésének szükségessége jelenti. Ezért a legfőbb követelmény új tárolónk számára az volt, hogy biztosítsa az alkalmazás logikája számára a valódi ACID tranzakciókat.
Más, nem kevésbé fontos követelmények voltak:
- Adatközpont meghibásodása esetén az új tárolón belül mind az olvasás, mind a írás hozzáférhető kell legyen.
- A jelenlegi fejlesztési sebesség fenntartása. Tehát az új tárolóval való munka során a kód mennyiségének körülbelül ugyanannak kell lennie, nem szabad szükségessé tenni a tárolóba való további írást, konfliktusok megoldására szolgáló algoritmusok kifejlesztését, másodlagos indexek fenntartását stb.
- Az új tároló sebességének elég magasnak kell lennie, mind az adatok olvasásakor, mind a tranzakciók feldolgozásakor, ami ténylegesen azt jelentette, hogy az akadémiailag szigorú, univerzális, de lassú megoldások, mint például .
- Automatikus skálázás valós időben.
- Hétköznapi olcsó szerverek használata, egzotikus hardverek vásárlásának szükségessége nélkül.
- A tároló fejlesztési lehetősége a vállalat fejlesztői által. Más szóval, a prioritás a saját, vagy nyílt forráskódú megoldásokra összpontosult, lehetőleg Java nyelven.
Megoldások, megoldások
A lehetséges megoldásokat elemezve két architektúra alternatívát találtunk:
Az első — bármilyen SQL szerver kiválasztása, és a szükséges hibatűrés, skálázási mechanizmus, hibatűrő klaszter, konfliktuskezelés és elosztott, megbízható és gyors ACID tranzakciók megvalósítása. Ezt a lehetőséget elég összetettnek és időigényesnek ítéltük.
A második lehetőség — egy már kész NoSQL tároló választása, amely megvalósított skálázással, hibatűrő klaszterrel, konfliktuskezeléssel és az SQL és tranzakciók saját magunk általi megvalósítása. Első pillantásra még az SQL megvalósítása, nem beszélve az ACID tranzakciókról, évekig tartó feladatnak tűnt. De később rájöttünk, hogy az SQL lehetőségek, amelyeket a gyakorlatban használunk, messze állnak az ANSI SQL-től, éppen úgy, ahogy messze áll az ANSI SQL-től. Alaposabban megvizsgálva a CQL-t, rájöttünk, hogy az elég közel áll ahhoz, amire szükségünk van.
Cassandra és CQL
Tehát miért érdekes a Cassandra, milyen lehetőségekkel rendelkezik?
Először is, itt különböző adatsorokkal rendelkező táblákat lehet létrehozni, lehetőség van SELECT vagy UPDATE végrehajtására az elsődleges kulcs alapján.
CREATE TABLE photos (id bigint KEY, owner bigint,…);
SELECT * FROM photos WHERE id=?;
UPDATE photos SET … WHERE id=?;
A replikák adatainak konzisztenciájának biztosítása érdekében a Cassandra A legegyszerűbb esetben ez azt jelenti, hogy ha három másolatot helyezünk el ugyanannak a sorozatnak a különböző csomópontjaiban, a rekord akkor számít sikeresnek, ha a csomópontok többsége (tehát kettő a három közül) megerősítette a művelet sikerét. A sorozat adatainak akkor számítanak konszolidáltnak, ha a legtöbb csomópontot megkérdezték olvasáskor, és megerősítették őket. Így három másolat esetén teljes és azonnali adatok konzisztenciáját garantálják egy csomópont meghibásodása esetén. Ez a megközelítés lehetővé tette számunkra, hogy egy még megbízhatóbb sémát valósítsunk meg: mindig elküldjük a kéréseket mindhárom másolatnak, és várakozunk a két leggyorsabb válaszára. A harmadik másolat késlekedő válasza ilyenkor elvetésre kerül. A késlekedő csomópontnak eközben súlyos problémái lehetnek — lassulás, szemétgyűjtés a JVM-ben, közvetlen memória visszaigénylés a linux kernelben, hardverhiba, hálózati leválás. Azonban ez a kliens műveleteire és az adatokra semmilyen hatással nincs.
A megközelítés, amikor három csomóponthoz fordulunk, és két válasz érkezik, úgynevezett : a felesleges másolatokra vonatkozó kérés még azelőtt elindul, hogy a "leválás" megtörténne.
A Cassandra másik előnye a Batchlog — egy mechanizmus, amely garantálja a csomag teljes alkalmazását vagy teljes elutasítását, így megoldjuk az A-t az ACID-ben — az atomaritást alapértelmezés szerint.
A Cassandra legközelebbi tranzakciós megfelelője a „”. De a „valódi” ACID-tranzakcióktól távol állnak: valójában ezt a lehetőséget csak egy adatok egyetlen rekordjára alkalmazni, a Paxos nehéz protokoll konszenzusa segítségével. Ezért ezek a tranzakciók nem túl gyorsak.
Ami hiányzik a Cassandrától
Így a Cassandraban valódi ACID-tranzakciókat kellett megvalósítanunk, amelyek segítségével könnyen megvalósíthatnánk a klasszikus DBMS két másik kényelmes lehetőségét: a konzisztens gyors indexeket, ami lehetővé tenné számunkra az adatok lekérdezését nemcsak a primer kulcs szerint, hanem egy normál monoton automatikus növelő ID generálóját is.
C*One
Így született meg az új adatbázis-kezelő rendszer C*One, amely három típusú szervercsomópontból áll:
- Tárhelyek — (majdnem) standard Cassandra szerverek, amelyek a helyi lemezeken tárolják az adatokat. A terhelés és az adatmennyiség növekedésével a számuk könnyen bővíthető akár tucatokra és százakra.
- A tranzakciókoordinátorok biztosítják a tranzakciók végrehajtását.
- Az ügyfelek – az alkalmazásszerverek, amelyek üzleti műveleteket hajtanak végre és indítják a tranzakciókat. Az ilyen ügyfelekből akár ezrek is lehetnek.
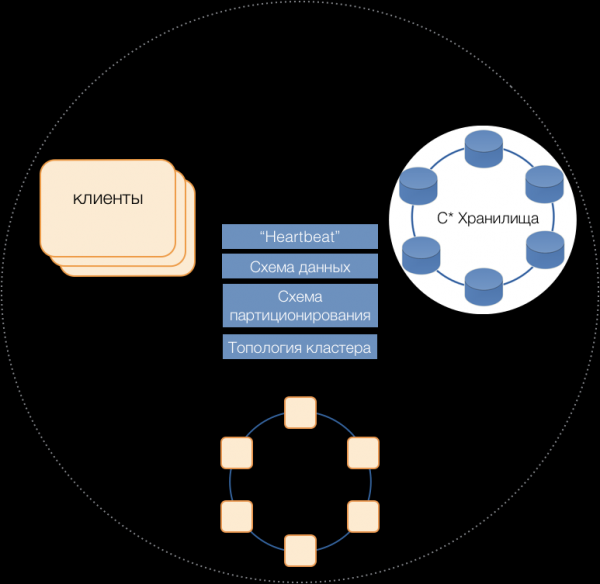
Minden típusú szerver egy közös klaszterben van, a Cassandra belső üzenetprotokollját használják az egymással való kommunikációhoz és a klaszterinformációk cseréjére. A Heartbeat segítségével a szerverek értesülnek a kölcsönös meghibásodásokról, fenntartják az egységes adatmodelt – táblák, azok szerkezete és replikáció; a partícionálási séma, a klaszter topológiája stb.
Ügyfelek
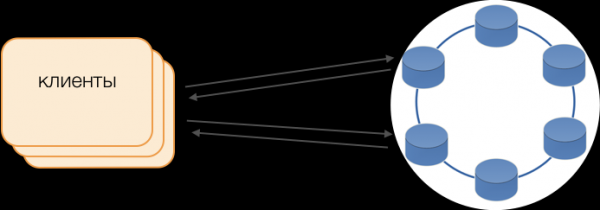
A hagyományos meghajtók helyett Fat Client üzemmódot használunk. Az ilyen csomópont nem tárol adatokat, de a lekérdezések végrehajtásának koordinátoraként működhet, azaz az ügyfél maga hajtja végre a lekérdezések koordinálásának funkcióját: lekérdezi a tároló replikáit és feloldja a konfliktusokat. Ez nemcsak megbízhatóbb és gyorsabb, mint a távoli koordinátorral kommunikáló hagyományos meghajtó, hanem lehetővé teszi a lekérdezések átvitelének kezelését is. Az ügyfél által megnyitott tranzakción kívül a lekérdezések a tárolókhoz irányulnak. Ha azonban az ügyfél megnyitott egy tranzakciót, akkor a tranzakción belüli összes lekérdezés a tranzakciókoordinátorhoz kerül.
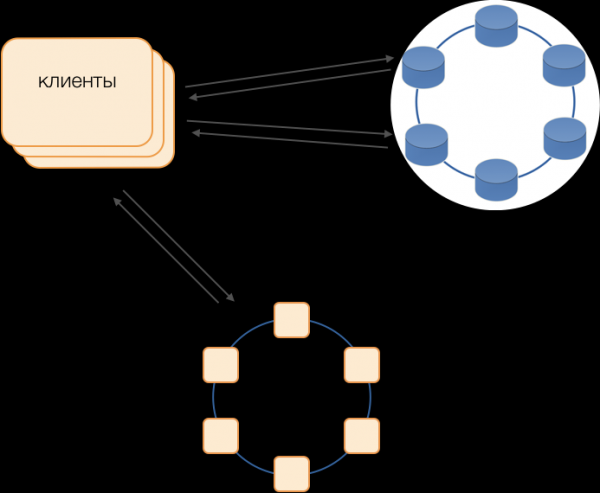
C*One tranzakciókoordinátor
A koordinátor az, amit a C*One-hoz teljesen nulláról valósítottunk meg. Ő felelős a tranzakciók, zárolások és a tranzakciók alkalmazásának sorrendjének kezeléséért.
Minden kezelt tranzakcióhoz a koordinátor létrehoz egy időbélyeget: minden következő nagyobb, mint az előző tranzakció időbélyege. Mivel a Cassandra rendszer konfliktusfeloldása időbélyegek alapján működik (két konfliktusos bejegyzés közül a későbbi időbélyeggel rendelkező ér véget), mindig a következő tranzakció javára dől el a konfliktus. Így valósítottuk meg – olcsó módszert a konfliktusok feloldására elosztott rendszerben.
Zárolások
A szigetelés biztosítása érdekében a legegyszerűbb módszert választottuk – pesszimista zárolásokat a bejegyzés elsődleges kulcsa szerint. Más szavakkal, a tranzakcióban a bejegyzést először zárolni kell, csak ezután lehet elolvasni, módosítani és elmenteni. Csak a sikeres elkötelezés után oldható fel a bejegyzés, hogy a versenytárs tranzakciók használhassák.
A blokkolás megvalósítása egyszerű a nem elosztott környezetben. Elosztott rendszerben két fő megoldás létezik: vagy meg kell valósítani az elosztott blokkolást a klaszterben, vagy el kell osztani a tranzakciókat úgy, hogy a közvetlenül kapcsolódó tranzakciókat mindig ugyanaz a koordinátor kezelje.
Mivel a mi esetünkben az adatok már csoportosítva vannak a helyi tranzakciók szerint SQL-ben, úgy döntöttünk, hogy a helyi tranzakciócsoportok számára rögzített koordinátorokat állítunk be: az egyik koordinátor az összes tranzakciót kezeli, amelynek azonosítója 0-9, a másik a 10-19 közötti tranzakciókat, és így tovább. Ennek eredményeként minden koordinátor példány a tranzakciós csoport mestere lesz.
Ekkor a blokkolások megvalósíthatók egy egyszerű HashMap formájában a koordinátor memóriájában.
A koordinátorok hibái
Mivel egy koordinátor kizárólag egy tranzakciócsoportot szolgál ki, nagyon fontos gyorsan meghatározni a leállását, hogy a tranzakció újbóli végrehajtása beleférjen a határidőbe. Ehhez gyors és megbízható megoldásként egy teljesen összekapcsolt kvorum alapú heartbeat protokollt alkalmaztunk:
Minden adatközpontban legalább két koordinátor csomópont található. Időszakosan minden koordinátor megküldi heartbeat üzenetét a többi koordinátornak, tájékoztatja őket a működéséről, valamint arról, hogy mely koordinátoroktól kapta meg utoljára a heartbeat üzeneteket a klaszterben.
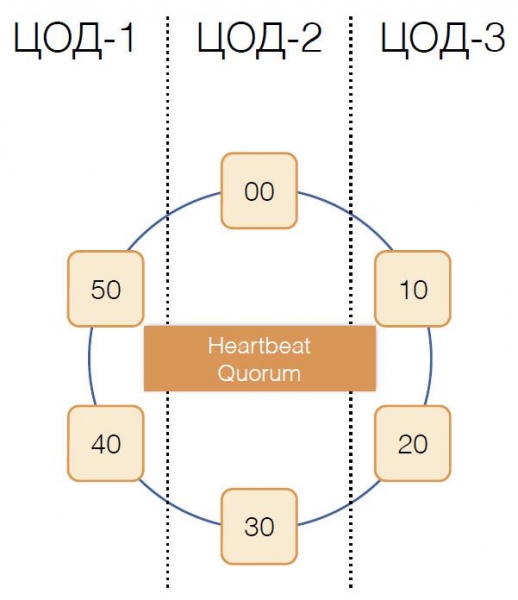
A többi koordinátortól kapott hasonló információk alapján minden koordinátor eldönti, hogy a klaszter mely csomópontjai működnek és melyek nem, a kvorum elvét követve: ha a X csomópont a klaszter többségétől információt kap arról, hogy a Y csomóponttól a heartbeat üzenetek rendben megérkeztek, akkor Y működik. És fordítva, amint a többség jelez arról, hogy nem kapott üzeneteket Y csomóponttól, akkor Y meghibásodott. Érdekes, hogy ha a kvorum értesíti az X csomópontot arról, hogy többé nem kap tőle üzeneteket, akkor magát a X csomópontot is hibásnak fogja tekinteni.
A heartbeat message is sent at a high frequency, about 20 times per second, with a period of 50 ms. In Java, it is difficult to guarantee an application response within 50 ms due to comparable pause durations caused by the garbage collector. We managed to achieve such a response time using the G1 garbage collector, which allows specifying a target for the duration of GC pauses. However, sometimes, quite rarely, the garbage collector pauses exceed 50 ms, which can lead to false failure detection. To prevent this, the coordinator does not report the failure of a remote node upon losing the first heartbeat message from it, only if several in a row are lost. This way, we managed to achieve the detection of a coordinator node failure in 200 ms.
But it is not enough to quickly understand which node has stopped functioning. Something needs to be done about that.
Kölcsönzés
The classic scheme suggests initiating new elections in case of a master failure using one of the algorithms. However, these algorithms have well-known problems with convergence over time and the duration of the election process itself. We managed to avoid such additional delays using a coordinator replacement scheme in a fully connected network:
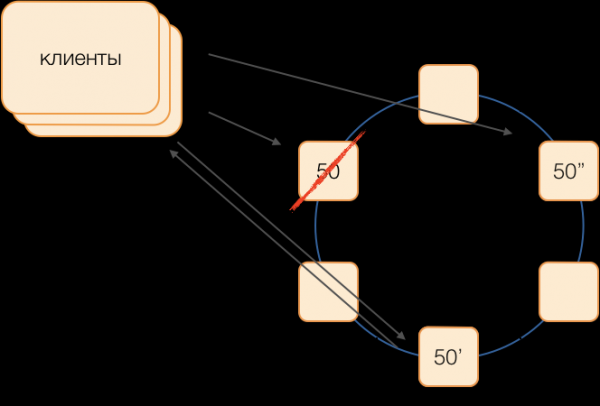
Suppose we want to execute a transaction in group 50. We will predefine the replacement scheme, that is, which nodes will perform transactions for group 50 in case of the primary coordinator's failure. Our goal is to maintain system operability in the event of a data center failure. We will define that the first backup will be a node from another data center, and the second backup will be a node from a third. This scheme is selected once and does not change until the cluster topology changes, that is, until new nodes join it (which happens very rarely). The order of selecting a new active master in case of the old one failing will always be as follows: the first backup will become the active master, and if it also stops functioning, the second backup.
This scheme is more reliable than a universal algorithm, as activating a new master requires only determining the fact of the old one's failure.
De hogyan érthetik meg az ügyfelek, hogy melyik mester dolgozik éppen? 50 ms alatt lehetetlen információt küldeni ezer ügyfélnek. Olyan helyzet fordulhat elő, amikor az ügyfél egy tranzakció megnyitására küld kérdést, még nem tudva, hogy ez a mester már nem aktív, és a kérdése időtúllépés miatt megakadhat. Ennek elkerülése érdekében az ügyfelek spekulatívan küldenek tranzakciómegnyitó kérelmet az adott csoport mestere felé és mindkét tartalékának, de a kérdésre csak az aktív mester fog válaszolni. A tranzakció keretein belül minden további kommunikációt az ügyfél csak az aktív mesterrel folytathat.
A tartalék mesterek a nekik nem tartozó tranzakciókra érkező kérelmeket a még meg nem született tranzakciók sorába helyezik, ahol egy ideig tárolják őket. Ha az aktív mester elhalálozik, akkor az új mester dolgozza fel a tranzakciók megnyitására vonatkozó kérelmeket a saját sorából és válaszol az ügyfélnek. Ha az ügyfél már megnyitott egy tranzakciót a régi mesternél, akkor a második válasz figyelmen kívül marad (és nyilvánvalóan a tranzakció nem zárul le, és az ügyfél újra megpróbálja).
Hogyan működik a tranzakció
Tegyük fel, hogy az ügyfél elküldött egy kérelmet az koordinátornak egy tranzakció megnyitására egy bizonyos entitásra egy adott elsődleges kulccsal. Az koordinátor letiltja ezt az entitást és elhelyezi a zárolási táblázatban a memóriában. Ha szükséges, az koordinátor kiolvassa ezt az entitást a tárolóból és a kapott adatokat a tranzakció állapotába menti a koordinátor memóriájában.
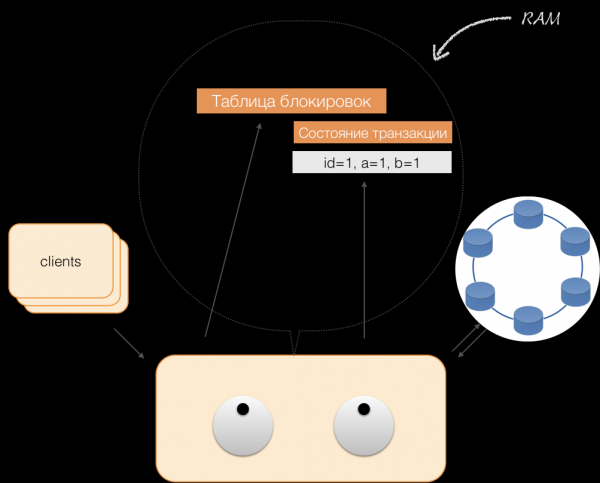
Amikor az ügyfél módosítani szeretné az adatokat a tranzakció keretében, elküldi az koordinátornak a módosításhoz szükséges kérelmét, amelybe az új adatokat elhelyezi a tranzakciók állapot táblájába a memóriában. Ezen a ponton a bejegyzés befejeződik — a tárolóba nem történik írás.
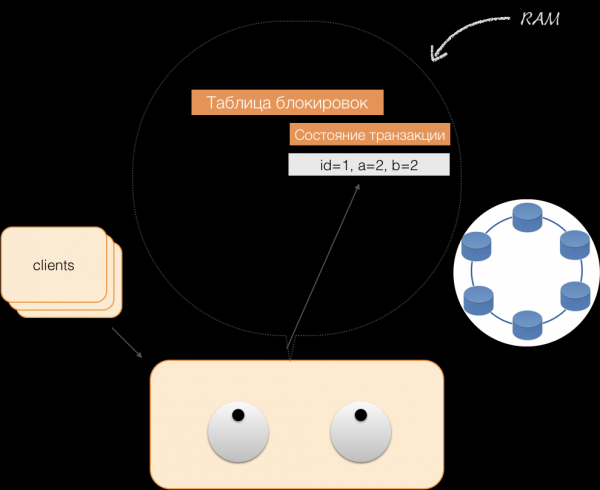
Amikor az ügyfél kér egy lekérdezést az aktív tranzakció keretében az általa módosított adatokra, az koordinátor a következő módon jár el:
- ha az ID már létezik a tranzakcióban, akkor az adatok a memóriából származnak;
- ha az ID nincs a memóriában, akkor a hiányzó adatokat kiolvassák a csomópont-tárolókból, egyesítik a már meglévő adatokkal, és az eredményt visszaadják az ügyfélnek.
Így az ügyfél olvashatja a saját módosításait, míg más ügyfelek nem látják ezeket a változásokat, mivel csak a koordinátor memóriájában tárolódnak, a Cassandra csomópontokban még nincsenek ott.
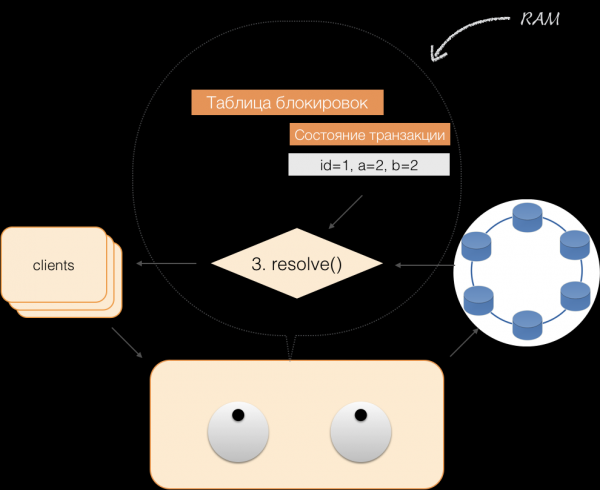
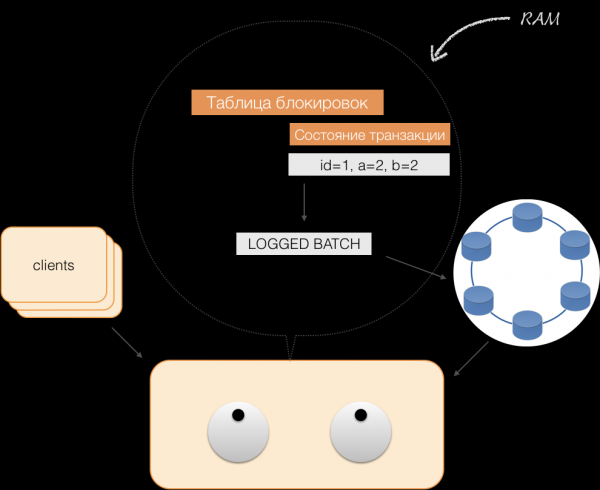
Amikor egy ügyfél elküldi a commitot, a szolgáltatás memóriájában lévő állapotot a koordinátor a logged batch-ben menti, ami már logged batch formában kerül a Cassandra tárolókhoz. A tárolók mindent megtesznek annak érdekében, hogy ez a csomag atomikusan (teljes mértékben) alkalmazásra kerüljön, és válaszolnak a koordinátornak, aki felszabadítja a zárolásokat, és megerősíti a tranzakció sikerességét az ügyfélnek.
A visszagörgetéshez a koordinátornak csupán annyira van szüksége, hogy felszabadítsa a tranzakció állapotát foglaló memóriát.
A fent említett fejlesztések eredményeként megvalósítottuk az ACID-elveket:
- Atomaritás. Ez garantálja, hogy egy tranzakció sem lesz részben rögzítve a rendszerben, vagy az összes altranszáció teljesül, vagy egy sem. Nálunk ezt az elvet a Cassandra logged batch rendszere biztosítja.
- Következetesség. Minden sikeres tranzakció definíciószerűen csak megengedett eredményeket rögzít. Ha a tranzakció nyitása után és egyes műveletek végrehajtása után kiderül, hogy az eredmény érvénytelen, visszagörgetést hajtunk végre.
- Szélsőséges szigetelés. Tranzakció végrehajtása során a párhuzamos tranzakcióknak nem szabad befolyásolniuk az eredményét. A versengő tranzakciókat pesszimista zárolásokkal izolálják a koordinátoron. A tranzakción kívüli olvasásoknál a szigetelés elve a Read Committed szintjén érvényesül.
- Stabilitás. Függetlenül az alsóbb szintű problémáktól — rendszeráramkimaradás, berendezés meghibásodása — a sikeresen befejezett tranzakció által végrehajtott változásoknak meg kell maradniuk a működés helyreállítása után.
Indexek szerinti olvasás
Vegyünk egy egyszerű táblázatot:
CREATE TABLE photos (
id bigint primary key,
owner bigint,
modified timestamp,
…)
Mindez tartalmaz egy azonosítót (elsődleges kulcs), a tulajdonost és a módosítás dátumát. Készítenünk kell egy nagyon egyszerű lekérdezést — válasszuk ki az adatokat a tulajdonos szerint a "múlt 24 órában" módosított dátummal.
SELECT *
WHERE owner=?
AND modified>?
Ahhoz, hogy az ilyen lekérdezés gyorsan végrehajtható legyen, egy klasszikus SQL DBMS-ben indexet kell építenünk a (owner, modified) oszlopokra. Ezt elég egyszerűen megtehetjük, mivel most már megvannak az ACID-garanciáink!
Indexek a C*One-ban
Van egy eredeti táblázatunk fényképekkel, ahol a bejegyzés azonosítója az elsődleges kulcs.
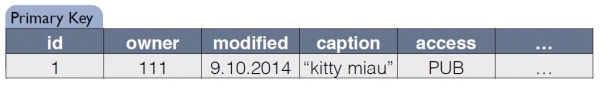
A C*One indexhez egy új táblát hoz létre, amely az eredeti másolata. A kulcs megegyezik az indexkifejezéssel, és ebbe a kulcsba még az eredeti táblázat bejegyzésének elsődleges kulcsa is beletartozik:
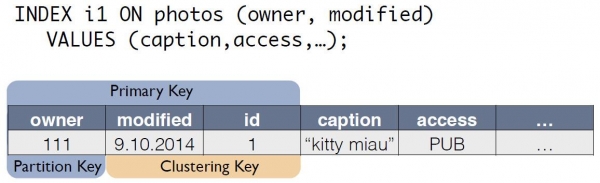
Most már a „tulajdonos az utolsó 24 órában” lekérdezést átírhatjuk egy másik táblából származó select-re:
SELECT * FROM i1_test
WHERE owner=?
AND modified>?
A photos alaptabla és az indexelt i1 táblák adatinak konzisztenciáját automatikusan a koordinátor tartja fenn. Csak az adatmodell alapján, amikor változást észlel, a koordinátor nemcsak a fő tábla változásait generálja és tárolja, hanem a másolatok változásait is. Nincsenek további műveletek az index táblán, a naplózás nem történik, zárolások nem használatosak. Ezért az indexek hozzáadása szinte nem fogyaszt erőforrást és gyakorlatilag nem befolyásolja a módosítások végrehajtásának sebességét.
Az ACID segítségével valósítottuk meg az indexeket „mint a SQL”-ben. Ezek konzisztens, skálázhatók, gyorsan működnek, lehetnek összetettek és beleépítettek a CQL lekérdezési nyelvbe. Az indexek támogatásához nem szükséges a alkalmazás kód módosítása. Minden egyszerű, mint a SQL. És ami a legfontosabb, az indexek nem befolyásolják a tranzakciós főtábla módosításainak végrehajtási sebességét.
Mi lett az eredmény
Három éve fejlesztettük ki a C*One-t, és indítottuk el ipari használatra.
Mit nyertünk végül? Nézzük meg ezt a fényképek feldolgozási és tárolási alrendszer példáján keresztül, amely a legfontosabb adat típusa a közösségi hálózatban. Nem maguknak a fényképeknek a testéről van szó, hanem a különböző metaadatokról. Jelenleg az „Osztálytársakban” körülbelül 20 milliárd ilyen bejegyzés található, a rendszer másodpercenként 80 ezer olvasási kérést, 8 ezer ACID-tranzakciót kezel, amelyek adatok módosításához kapcsolódnak.
Amikor SQL-t használtunk replication factor = 1 (de RAID 10-ben), a fényképek metaadatai egy 32 gépből álló, Microsoft SQL Serverrel rendelkező, nagy rendelkezésre állású klaszterben tárolódtak (plusz 11 tartalék). 10 szerver különült el biztonsági másolatok tárolására. Összesen 50 drága gép volt. A rendszer eközben névleges terheléssel működött, tartalékok nélkül.
Az új rendszerre való migrálás után replication factor = 3-at kaptunk — másolat minden adatközpontban. A rendszer 63 Cassandra tároló nodból és 6 koordináló gépből áll, összesen 69 szerver. De ezek a gépek jelentősen olcsóbbak, összes költségük körülbelül 30%-a a SQL-re épülő rendszerének.
A C*One bevezetésével csökkentek a késések is: az SQL írási művelete 4,5 ms körüli időt vett igénybe. A C*One esetében ez körülbelül 1,6 ms. A tranzakciók átlagos hossza kevesebb mint 40 ms, a kötelező commit 2 ms alatt zajlik, az olvasás és írás hossza átlagosan 2 ms. A 99. percentilis mindössze 3-3,1 ms, az időkorlátok száma 100-szoros csökkenésen ment keresztül - mindez a spekulációk széles körű alkalmazásának köszönhető.
Jelen pillanatban a SQL Server csomópontok jelentős része már ki van vonva a termelésből, az új termékek csak a C*One használatával készülnek. A C*One-t az felhőnkkel való együttműködéshez alakítottuk át. , amely lehetővé tette az új klaszterek gyorsabb telepítését, a konfiguráció egyszerűsítését és a működés automatizálását. Az alapforráskód nélkül ez jelentősen nehezebb és bonyolultabb lett volna.
Jelenleg más adattárolóink felhőbe való áthelyezésén dolgozunk - de ez már egy teljesen másik történet.
Forrás: habr.com
