

Ma, szerdán, megjelenik a Kubernetes legújabb verziója — 1.16. A blogunk hagyományai szerint, itt már tizedik alkalommal számolunk be a legfontosabb változásokról az új verzióban.
A cikk előkészítéséhez használt információk a következő forrásból származnak: , és a megfelelő issues, pull requestek, valamint Kubernetes Enhancement Proposals (KEP). Tehát, kezdjük!..
Csomópontok
Valóban nagy számú figyelemre méltó újdonság (alpha státuszban) érkezik a K8s klaszterek oldali csomópontokhoz (Kubelet).
Először is, bemutatásra kerültek az úgynevezett «» (Ephemeral Containers), melyek célja a podokban való hibakeresési folyamatok egyszerűsítése.Az új mechanizmus lehetővé teszi speciális konténerek indítását, amelyek a meglévő podok névtartományában indulnak és rövid ideig élnek. Céljuk a más podokkal és konténerekkel való interakció a problémák megoldása és hibakeresés érdekében. E lehetőség megvalósítása érdekében egy új parancs került bevezetésre, kubectl debug, amely lényegében hasonló a kubectl exec: csak ahelyett, hogy egy folyamatot indítana egy konténerben (mint az előző esetben), egy konténert indít egy podban. Például, ez a parancs csatlakoztat egy új konténert a podhoz: execkubectl debug -c debug-shell --image=debian target-pod -- bash
Részletek az efemer konténerekről (és a használatuk példái) megtalálhatók amegfelelő KEP-ben. : Létezik hasonlóság a funkció és a már létező pluginnal,
NB. Azt feltételezzük, hogy az efemer konténerek megjelenésével a külön álló külső plugin fejlődése leáll. szól, amiről nemrégiben Egy másik újdonság —
PodOverhead amely jelentősen eltérhet a használt végrehajtási környezettől (runtime) függően. A példaként megemlített KEP szerzői a Kata Container-eket emelik ki, amelyeknek szükségük van egy vendégkernel, egy kata ügynök, init-rendszer stb. indítására. Amikor a költség ennyire magasra nő, azt nem lehet figyelmen kívül hagyni, ezért szükséges egy módszer, hogy figyelembe vegyük a további kvótázás, tervezés stb. érdekében. Az implementációhoz aPodSpec Overhead *ResourceList (amely az adatokkal van összhangban, ha ilyet használnak). Még egy figyelemre méltó újítás — a csomópont topológiai menedzser RuntimeClass(Node Topology Manager)
csomópont topológiai menedzsere (Node Topology Manager) (Node Topology Manager), amelynek célja a hardverforrások finomhangolt elosztásának egységesítése a Kubernetes különböző komponensei között. E kezdeményezés a modern rendszerek (például távközlés, gépi tanulás, pénzügyi szolgáltatások stb.) egyre növekvő igényéből fakad a nagy teljesítményű párhuzamos számításokra és az operációk végrehajtási késleltetésének minimalizálására, amelyhez kiemelkedő CPU és hardvergyorsítási lehetőségeket használnak. Az ilyen optimalizálások a Kubernetesben eddig különálló komponensek (CPU manager, Device manager, CNI) révén valósultak meg, de most egy egységes belső interfészt adnak a rendszerhez, amely egységesíti a megközelítést és megkönnyíti új, hasonló — úgynevezett topology-aware — komponensek csatlakoztatását a Kubelet oldalán. Részletek — a .
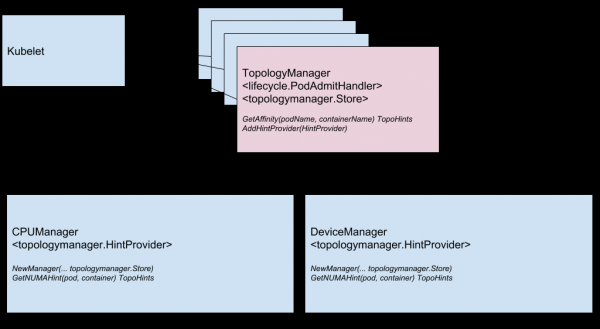
Topology Manager komponensek sémája
A következő funkció — a konténerek indítás alatti ellenőrzése (). Amint az ismert, a hosszú ideig indító konténerek aktuális állapotának megállapítása nehézkes: vagy még a valódi működés megkezdése előtt "megjelennek", vagy hosszan deadlock-ba kerülnek. Az új ellenőrzés (amelyet a StartupProbeEnabled) által megvalósított bármely más ellenőrzés végrehajtását felfüggeszti — pontosabban elhalasztja — addig, amíg a pod befejezte az indítást. Ezért ezt a funkciót kezdetben -nak nevezték. A hosszú indítással rendelkező podok állapotellenőrzése rövidebb időközönként elvégezhető.
Ezen kívül az azonnal béta verzióban bemutatott fejlesztés a RuntimeClass számára támogatást nyújt a "heterogén klaszterek" számára. A most már nem kötelező, hogy minden csomópont támogassa az összes RuntimeClass-t: a podoknál lehetőség van a RuntimeClass kiválasztására a klaszter topológiájának figyelembevétele nélkül. Korábban ennek biztosítása érdekében — hogy a podok a szükséges támogatással rendelkező csomópontokon helyezkedjenek el — megfelelő szabályokat kellett létrehozni a NodeSelector és tolerations számára. A példákat és természetesen a végrehajtás részleteit mutatja be.
Hálózat
Két jelentős hálózati funkció, amely először (alpha verzióban) jelent meg a Kubernetes 1.16-ban — ezek:
- a dupla hálózati verem — IPv4/IPv6 — és a megfelelő „megértése” a podok, csomópontok és szolgáltatások szintjén. Tartalmazza az IPv4-to-IPv4 és IPv6-to-IPv6 közötti interakciót a podok között, a podokból külső szolgáltatásokhoz, referenciaimplementációkat (a Bridge CNI, PTP CNI és Host-Local IPAM pluginek keretein belül), valamint visszafelé kompatibilitást a kizárólag IPv4 vagy IPv6-on működő Kubernetes klaszterekkel. A megvalósítás részletei — .
Kétféle IP-cím (IPv4 és IPv6) kimenetének példája a podok listájában:
kube-master# kubectl get pods -o wide NAME READY STATUS RESTARTS AGE IP NODE nginx-controller 1/1 Running 0 20m fd00:db8:1::2,192.168.1.3 kube-minion-1 kube-master# - Új API az Endpoint számára — . Ez megoldja a meglévő Endpoint API teljesítmény/-skálázhatósági problémáit, amelyek különböző komponenseket érintenek a control-plane (apiserver, etcd, endpoints-controller, kube-proxy) területén. Az új API bekerül a Discovery API-csoportba, és képes lesz több tízezer backend végpontot szolgálni minden szolgáltatás esetében egy olyan klaszterben, amely ezer csomópontból áll. Ehhez minden Szolgáltatás N objektumra tükröződik
EndpointSlice, amely alapértelmezés szerint legfeljebb 100 végponttal rendelkezik (az érték konfigurálható). Az EndpointSlice API jövőbeni fejlesztésekhez is lehetőségeket biztosít: különböző IP-címek támogatása minden pod számára, új állapotok a végpontokhoz (nemcsakKészésNotReady), dinamikus alosztás a végpontokhoz.
A múlt hónapban bemutatott finalizer, amely , néven ismert service.kubernetes.io/load-balancer-cleanup , és minden olyan szolgáltatáshoz hozzá van rendelve, amelynek típusa LoadBalancer. E szolgáltatás törlésekor megakadályozza a forrás tényleges törlését, amíg az összes megfelelő terheléselosztó erőforrás „lemondása” be nem fejeződött.
API Machinery
A Kubernetes API-server és annak interakciója terén „megjelenik” a stabilizálás valódi mérföldköve. Ez nagyrészt az különleges bemutatásra nem szoruló (CRD), amelyek a távoli Kubernetes 1.7 óta (ez 2017 júniusa!) béta státuszban voltak. Hasonló stabilizáció ért el a hozzájuk kapcsolódó funkcióknál is:
- használata
/statusés/scalea CustomResources esetén; - verziók a CRD-hez, amely külső webhookon alapul;
- (a K8s 1.15-ben) alapértelmezett értékek (defaulting) és a mezők automatikus eltávolítása (pruning) a CustomResources esetén;
- az OpenAPI v3 séma alkalmazására, amely az OpenAPI-dokumentáció létrehozásához és közzétételéhez használatos, a CRD-erőforrások érvényesítésére a szerver oldalán.
Egy új mechanizmus, amely a Kubernetes rendszergazdái számára régóta ismerős: — szintén hosszú ideje béta státuszban volt (K8s 1.9-től) és most már stabilnak nyilvánították.
Két másik funkció elérte a béta verziót: és .
A legfontosabb újítás az alfa verzióban a tól SelfLink — egy speciális URI, amely a megadott objektumot képviseli, és része a ObjectMeta és ListMeta (azaz bármely Kubernetes objektum részét képezi). Miért mondanak le róla? Az „egyszerűen” hangzó motiváció hogy nincsenek valódi (leküzdhetetlen) okok arra, hogy ez a mező továbbra is létezzen. A formálisabb okok közé tartozik a teljesítmény optimalizálása (a szükségtelen mező eltávolításával) és a generic-apiserver munkájának egyszerűsítése, amelynek különösen kezelnie kell ezt a mezőt (ez az egyetlen mező, amely közvetlenül a objektum sorosítás előtt kerül beállításra). A valódi „elavulás” (a béta verzió keretein belül) SelfLink a Kubernetes 1.20 verzióra fog megtörténni, a véglegesen pedig 1.21-re.
Adattárolás
A tárolás terén végzett főbb munka, mint a korábbi kiadásokban, a . A legfontosabb változások itt:
- először (az alfa verzióban) a Windows munkacsomópontok számára készült CSI pluginek támogatása: a tárolók kezelésének aktuális módja itt leváltja a Kubernetes magjában lévő in-tree plugineket és a Microsoft FlexVolume plugineit, amelyek PowerShell alapúak;

A CSI pluginek Kubernetes alatti megvalósításának - lehetőség , ami már a K8s 1.12-ben bemutatásra került, béta verzióba került;
- hasonló „emelést” (az alfa- a béta verzióra) elérte a CSI támogatás helyi efemer tárolók létrehozásához ().
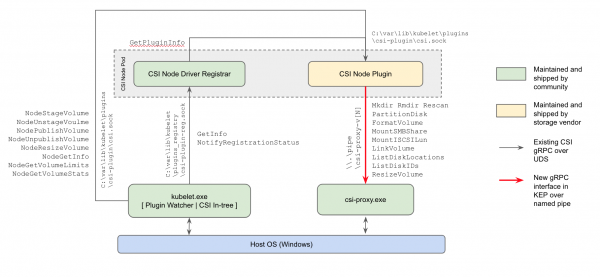
A Kubernetes múltbeli verziójában bevezett (a meglévő PVC-k felhasználása DataSource új PVC-k létrehozásához) most béta státuszt kapott.
Scheduler
Két jelentős változás a tervezés területén (mindkettő alfa verzióban):
- — a lehetőség az „igazságos terheléselosztás” érdekében podok alkalmazása logikai egységek helyett (mint például Deployment és ReplicaSet) és ennek az elosztásnak a szabályozása (mint ’kemény’ követelmény vagy ’lágy’ feltétel, azaz prioritás). Ez a funkció kibővíti a tervezett podok elosztásának meglévő lehetőségeit, amelyek jelenleg az
PodAffinityésPodAntiAffinity, lehetővé téve az adminisztrátorok számára, hogy finomabb kontrollal rendelkezzenek ebben a kérdésben, ami jobb magas rendelkezésre állást és optimalizált erőforrás-felhasználást eredményez. Részletek — . - Használat Legjobb illeszkedés politika be. KértKapacitásArány prioritási funkció a podok tervezése során, ami lehetővé teszi alkalmazni („konténerbe pakolás”) az alapvető erőforrások (CPU, memória) és a kiterjesztettek (például GPU) számára. Bővebb információt talál .

Podok tervezése: a legjobb illeszkedés politika használata előtt (közvetlenül a default ütemezőn keresztül) és annak alkalmazásával (scheduler extenderen keresztül)
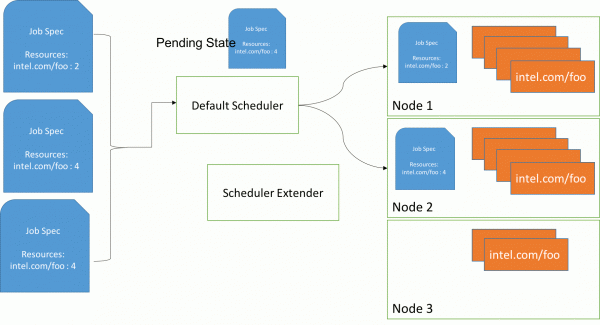
Ezen kívül, lehetőség saját pluginok létrehozására az ütemező számára a Kubernetes fő fejlesztési fáján kívül (out-of-tree).
Egyéb változások
A Kubernetes 1.16-ban említhető kezdeményezés a , pontosabban — azhivatalos előírásokkal Prometheus dokumentációra támaszkodnak. Ezen kívül említhető a következő változások:
A Windows támogatás fejlesztése
- az új a , valamint
RunAsUserName, , mount/attach a vSphere kötetekhez. - adatsűrítési mechanizmus az API válaszokban. Korábban ehhez HTTP-szűrőt használtak, amely számos korlátozást rótt, megakadályozva annak alapértelmezett bekapcsolását. Most működik a „átlátszó kérés tömörítés”: az ügyfelek, akik elküldik
Accept-Encoding: gzipa fejlécben, tömörített GZIP választ kapnak, ha annak mérete meghaladja a 128 KB-ot. A Go nyelvű ügyfelek automatikusan támogatják a tömörítést (elküldik a szükséges fejlécet), így azonnal észlelik a forgalom csökkenését. (Más nyelvek esetén kisebb módosításokra lehet szükség.) - HPA skálázása 0 podra és vissza külső metrikák alapján.. Ha a skálázás objektumok vagy külső metrikák alapján történik, akkor amikor a munkaterhelések inaktívak, automatikusan 0 példányra lehet skálázni, hogy erőforrásokat takarítsunk meg. Ez a funkció különösen hasznos lehet azokban az esetekben, amikor a worker-ek GPU erőforrásokat igényelnek, és a különböző típusú inaktív worker-ek száma meghaladja a rendelkezésre álló GPU-k számát.
- Új ügyfél — — a 'generikus' hozzáféréshez az objektumokhoz. Azért készült, hogy egyszerűen lehessen lekérni a metainformációkat (azaz a részhalmaz
metadata) a klaszter erőforrásaiból és műveleteket végezni velük a hulladékgyűjtés és a kvótázás terén. - Kubernetes gyűjtése elavult ('beépített') felhőszolgáltatók nélkül (alpha verzió).
- A kubeadm segédprogramban kísérleti (alpha verzió) lehetőséget vezettek be, hogy a kustomize javításait a műveletek során alkalmazzák
init,joinésupgrade. Bővebben a--experimental-kustomizeflag használatáról, lásd a . - Új endpoint az apiserverhez — , — lehetővé teszi a készenléti (readiness) információk exportálását. Ezen kívül az API-server új flag-et kapott
--maximum-startup-sequence-duration, amely lehetővé teszi a restartek szabályozását. - Két funkció az Azure számára stabilnak nyilvánítva: a (Availability Zones) és a (RG). Továbbá az Azure-ba bekerült:
- annotáció
-
a terheléselosztón lévő nyilvános IP megadására;LoadBalancerName - beállítások
LoadBalancerResourceGroupésAz AWS-ben megjelent.
- az EBS Windows-ra és optimalizálva lettek DescribeInstances
A Kubeadm most már önállóan. - migrálja A bináris fájlok
- a megfelelő Docker-képben etcd world-executable-ként vannak beállítva, ami lehetővé teszi ennek a képnek a futtatását root jogok nélkül. Emellett az etcd migráló kép támogatja az etcd2 verziót. A Cluster Autoscaler 1.16.0
- A Frissítések a használt/függőségi szoftverekben: Go 1.12.9, etcd 3.3.15, CoreDNS 1.6.2.
- Apró Docker-képek, amelyek hittek magukban*
P.S.
Olvasson további információkat a blogunkban:
- «»;
- «»;
- «»;
- «».
Forrás: habr.com
