

Pavel Selivanov, a solutions architect at Southbridge and a Slurm instructor, gave a presentation at DevOpsConf 2019. This presentation is part of one of the advanced topics in the Kubernetes course 'Slurm Mega'.
Moszkvában zajlik, november 18-20.
— Moszkva, november 22-24.
mindig elérhető.
A folytatásban – a beszámoló feldolgozása.
Jó napot kívánok, kollégák és szimpatizánsaik. Ma a biztonságról fogok mesélni.
Látom, hogy sok biztonsági szakember van a teremben. Előre is elnézést kérek, ha a biztonság világából származó kifejezéseket nem pontosan úgy használom, ahogy az önöknél megszokott.
Úgy alakult, hogy körülbelül fél évvel ezelőtt kezembe került egy nyilvános Kubernetes klaszter. Nyilvános – ez azt jelenti, hogy van benne n számú namespace, és ezekben a namespace-ekben vannak felhasználók, akik a saját namespace-jükbe vannak izolálva. Mindezek a felhasználók különböző cégekhez tartoznak. Na, és azt feltételezték, hogy ezt a klasztert CDN-ként kell használni. Tehát adnak egy klasztert, adnak oda egy felhasználót, te pedig bemész a saját namespace-edbe és telepíted a frontendjeidet.
Korábbi cégem megpróbált egy ilyen szolgáltatást eladni. Kértek, hogy nézzem meg, hogy megfelelő-e a megoldás.
Bementem a klaszterbe. Korlátozott jogosultságokat kaptam, korlátozott namespace-t. Az emberek tudták, mi az a biztonság. Olvasták, mi az a Role-based access control (RBAC) a Kubernetesben – és úgy állították be, hogy nem tudtam podokat indítani deploymentek nélkül. Nem emlékszem, mi volt a feladat, amit megpróbáltam megoldani, amikor podot akartam futtatni deployment nélkül, de nagyon szerettem volna egyszerűen csak egy podot indítani. Gondoltam, megnézem, milyen jogaim vannak a klaszterben, mit tehetek és mit nem, és aztán elmondom, mi van rosszul beállítva az RBAC-ban.
Úgy alakult, hogy két percen belül admin jogosultságot kaptam a klaszterhez, belenéztem az összes szomszédos namespace-be, és láttam, hogy ott a cégek már futó production frontendjei, akik már megvásárolták a szolgáltatást és telepítettek. Alig tudtam megállni, hogy ne kerüljek valakinek a frontend oldalára és ne helyezzek el valami trágár szót a főoldalon.
Példákon keresztül meg fogom mutatni, hogyan csináltam, és hogyan kellene védekezni ellene.
De szeretek bemutatkozni. A nevem Pavel Selivanov. A Southbridge cég építésze vagyok. Értek a Kuberneteshez, a DevOpshoz és egyéb divatos dolgokhoz. A Southbridge mérnökeivel mindezt megvalósítjuk, én pedig tanácsot adok.
Fő tevékenységünk mellett nemrég indítottunk egy projektet, amit Slurmoknak hívunk. Az a célunk, hogy a Kubernetes kezelési képességeinket egy kicsit a köznép elé tárjuk, és más embereket is megtanítsunk dolgozni a K8s-sel.
A mai beszédem témája egyértelmű – a Kubernetes klaszter biztonsága. De azonnal szeretném hangsúlyozni, hogy ez egy nagyon nagy téma — és ezért rögtön szeretném tisztázni, hogy miről biztosan nem fogok beszélni. Nem fogok elavult kifejezésekről beszélni, amik már százszor elhangzottak az interneten. Mindenféle RBAC és tanúsítványok.
Arról fogok beszélni, ami engem és kollégáimat foglalkoztat a Kubernetes klaszter biztonságával kapcsolatban. Ezeket a problémákat látjuk a Kubernetes klasztereket nyújtó szolgáltatóknál és a hozzánk érkező ügyfeleknél is. Sőt, még az olyan ügyfeleknél is, akik más tanácsadó adminisztrátori cégektől érkeznek hozzánk. Tehát a tragédia mértéke igazából nagyon nagy.
Csak három pont, amiről ma beszélni fogok:
- Felhasználói jogosultságok vs pod jogosultságok. A felhasználói jogosultságok és a pod jogosultságok nem ugyanazok.
- Információgyűjtés a klaszterről. Megmutatom, hogy a klaszterből minden információt össze lehet gyűjteni, anélkül, hogy különleges jogosultságokkal rendelkeznénk.
- DoS-támadás a klaszterre. Ha nem tudjuk összegyűjteni az információt, akkor is képesek vagyunk a klasztert leállítani. Beszélni fogok a klaszter vezérlőelemeit érintő DoS-támadásokról.
Egy másik általános dolog, amiről említést teszek — amin mindezt teszteltem, amin biztosan elmondhatom, hogy működik.
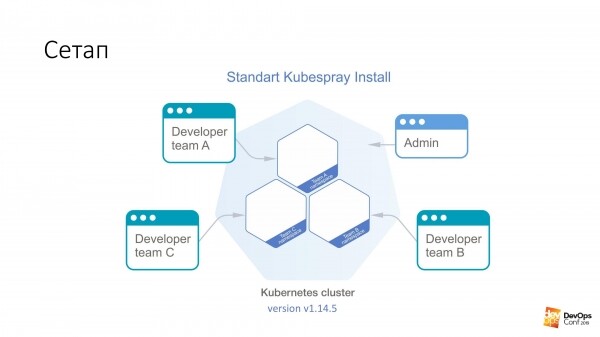
Alapul vesszük a Kubernetes klaszter telepítését Kubespray segítségével. Ha valaki nem tudná, ez gyakorlatilag egy szerepkészlet az Ansible-hoz. Az alkalmazás során folyamatosan használjuk. Előnyös abban, hogy bárhova telepíthető — akár fizikai gépekre, akár felhőbe. Egy telepítési mód alapvetően mindenhez alkalmas.
Ebben a klaszterben nekem Kubernetes v1.14.5 lesz. Az egész Kubernetes klaszter, amelyet megvizsgálunk, névkiterjesztésekre van felosztva, mindegyik névkiterjesztés egy külön csapathoz tartozik, és a csapat tagjainak hozzáférésük van mindegyik névkiterjesztéshez. A különböző névkiterjesztésekhez nem tudnak eljutni, csak a sajátjukhoz. De van egy adminisztratív fiók, amelynek joga van az egész klaszterre.
Megígértem, hogy elsőként az adminisztrátori jogok megszerzése lesz a klaszterhez. Szükségünk van egy különlegesen elkészített podra, amely meg fogja törni a Kubernetes klasztert. Minden, amit tennünk kell, az az, hogy alkalmazzuk a Kubernetes klaszterre.
kubectl apply -f pod.yamlEz a pod egy a Kubernetes klaszter egyik mesterére fog érkezni. A klaszter pedig örömmel visszaküldi nekünk a admin.conf nevű fájlt. A Kubernetes fő fájljában tárolva vannak az összes adminisztrátori tanúsítvány, és a klaszter API-ja is be van állítva. Így egyszerűen lehet adminisztrátori hozzáférést szerezni, gondolom, a Kubernetes klaszterek 98%-ához.
Ismétlem, ezt a podot egy fejlesztő készítette az Ön klaszterében, aki hozzáféréssel rendelkezik saját ajánlásainak telepítésére egy kis névkiterjesztésen belül, mindez RBAC alá van zsúfolva. Nem voltak jogai. De ennek ellenére a tanúsítvány visszakerült.
Most pedig a speciálisan elkészített podról. Indítsuk el bármilyen képen. Például vegyük a debian:jessie-t.
Van nekünk egy ilyen dolog:
tolerations:
-   effect: NoSchedule
    operator: Exists
nodeSelector:
    node-role.kubernetes.io/master: ""
Mi az a toleráció? A Kubernetes klaszterekben a mesterek általában olyan dologgal vannak megjelölve, amit taintnek neveznek (ez angolul "fertőzés"). A "fertőzés" lényege, hogy a mester csomópontokra nem lehet podokat hozzárendelni. De senki sem akadályozza meg, hogy bármely podban jelezzük, hogy tolerálja a "fertőzést". A Toleration szakasz éppen azt mondja, hogy ha valamilyen csomóponton NoSchedule van beállítva, akkor a podunk toleráns a ilyen fertőzésre – és semmi probléma.
Ezenkívül azt mondjuk, hogy podunk nemcsak toleráns, hanem kifejezetten mesterre is akar kerülni. Mivel a mestereknél található a legínycsiklandóbb, amire szükségünk van – minden tanúsítvány. Ezért nodeSelector-t mondunk – és van egy szabványos címke a mestereken, amely lehetővé teszi, hogy a klaszter összes csomópontjából pontosan azokat válasszuk, amelyek mesterek.
Így ezekkel a két szekcióval a pod biztosan eljuthat a mesterhez. És engedni fogják ott lakni.
De csak annyira, hogy a mesterhez eljussunk, nem elég. Ez nem fog semmit adni. Ezért a következő két dolog van:
hostNetwork: true
hostPID: true
Megmondjuk, hogy a pod, amelyet indítunk, a kernel névtérben, a hálózati névtérben és a PID névtérben fog élni. Miután a pod elindul a masteren, láthatja ennek a node-nak az összes valós, élő interfészét, figyelheti az összes forgalmat és láthatja az összes folyamat PID-jét.
A következő lépés a kisebbik. Vegye az etcd-t, és olvassa el, amit szeretne.
A legérdekesebb — ez a Kubernetes képessége, amely alapértelmezés szerint ott van.
volumeMounts:
- mountPath: /host
  name: host
volumes:
- hostPath:
    path: /
    type: Directory
  name: host
A lényege az, hogy a podban, amelyet indítunk, még a clusterhez való jogok nélkül is megmondhatjuk, hogy egy hostPath típusú volume-ot szeretnénk létrehozni. Ez azt jelenti, hogy a hoston található utat, amelyen elindulunk — és ezt volume-ként vesszük. Ezt követően nevezzük el name: host-nak. Az összes hostPath-ot belül a podba szereljük. Ebben a példában a /host mappába.
Még egyszer hangsúlyozom. Megmondtuk a podnak, hogy jöjjön a masterre, kapja meg a hostNetwork és hostPID-t — és az egész master rootját szerelje be ebbe a podba.
Érted, hogy a debianon elindítottuk a bash-t, és ez a bash rootként fut. Tehát éppen megszereztük a root jogokat a masterre, miközben nem rendelkezünk jogokkal a Kubernetes klaszterben.
A következő feladat az, hogy belépjünk a podba a /host /etc/kubernetes/pki mappába, ha nem tévedek, ott elhozzuk az összes master tanúsítványt a klaszterhez, és így adminisztrátorokká válunk a klaszterben.
Ha úgy nézzük, ezek az egyik legveszélyesebb jogok a podokban — függetlenül attól, hogy milyen jogai vannak a felhasználónak:
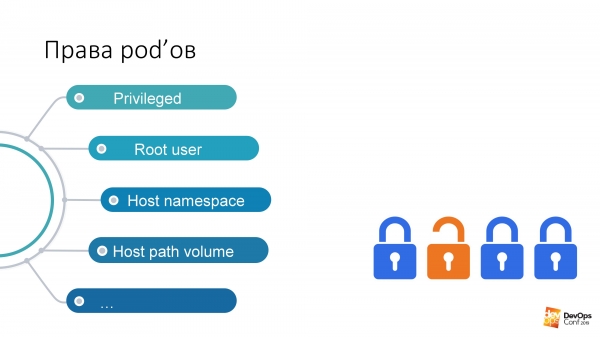
Ha jogom van elindítani egy podot a klaszter valamilyen névtérben, akkor annak a podnak ezek a jogai alapértelmezés szerint megvannak. Lehet, hogy privilegált podokat indíthatok, és ez gyakorlatilag az összes jog, szinte root a node-on.
A kedvencem — Root user. A Kubernetes-nek van egy ilyen opciója: Run As Non-Root. Ez egyfajta védelem a hackerek ellen. Tudja, mi az a 'maldáv vírus'? Ha hacker vagy, és beléptél a Kubernetes klaszterembe, akkor mi, szegény adminisztrátorok, kérjük: 'Kérjük, jelezd a podjaidban, amelyeket használsz, hogy run as non-root. Mert különben úgy fogsz elindítani egy folyamatot a pododban rootként, hogy nagyon könnyen feltörheted a rendszert. Kérjük, védd meg magad!'.
A host path volume — véleményem szerint a leggyorsabb módja a kívánt eredmény elérésének a Kubernetes klaszterből.
De mit kezdjünk mindezzel?
Gondolatok, amelyek bármely normális adminisztrátor fejében meg kell, hogy forduljanak, aki találkozik a Kubernetes-szel: „Aha, mondtam, hogy a Kubernetes nem működik. Tele van hibákkal. Az egész Kubernetes egy rakás hülyeség.” Valójában létezik egy dolog, a dokumentáció, és ha abba belenézünk, találunk egy szakaszt. .
Ez egy yaml-objektum — ezt létrehozhatjuk a Kubernetes klaszterben — amely a podok biztonsági aspektusait szabályozza. Vagyis lényegében ellenőrzi azokat a jogokat, amelyek különböző hostNetwork, hostPID, bizonyos típusú volume-k használatára vonatkoznak, ami a podok indításakor van. A Pod Biztonsági Politika segítségével mindez leírható.
A Pod Biztonsági Politikában a legérdekesebb az, hogy a Kubernetes klaszterben az összes telepítő PSP nincs egyszerűen definiálva, alapértelmezetten ki van kapcsolva. A Pod Biztonsági Politika aktiválása egy admission plugin segítségével történik.
Rendben, telepítsük a Pod Biztonsági Politika-t a klaszterbe, mondjuk, hogy van pár szolgáltatási podunk abban a névtérben, amelyhez csak az adminisztrátorok férhetnek hozzá. Mondjuk, hogy minden más podnak korlátozott jogai vannak. Mert valószínűleg a fejlesztőknek nincsen szükségük arra, hogy privilegizált pod-okat indítsanak a klaszterében.
És úgy tűnik, hogy minden rendben van. A Kubernetes klaszterünket nem lehet két perc alatt feltörni.
Van egy probléma. Valószínűleg, ha van Kubernetes klasztered, akkor abban be van állítva monitorozás. Merem állítani, hogy ha a klaszteredben van monitorozás, az a neve Prometheus.
Amit most fogok mondani, érvényes lesz a Prometheus-operatorra és a tiszta formában telepített Prometheus-ra is. A kérdés az, hogy ha a klaszterhez nem tudok így gyorsan adminisztrátort kapni, akkor többet kell keresnem. A keresést a monitorozásod segítségével végezhetem el.
Valószínűleg mindenki ugyanazokat a cikkeket olvasta a Habr-n, és a monitorozás a monitoring névtérben található. A Helm chartok mind hasonlóan nevezik el ezeket. Feltételezem, hogy ha végrehajtod a helm install stable/prometheus parancsot, akkor körülbelül azonos neveket kapsz. És valószínűleg a DNS-nevet a klaszteredben nem kell kitalálnom. Mert az alapértelmezett.
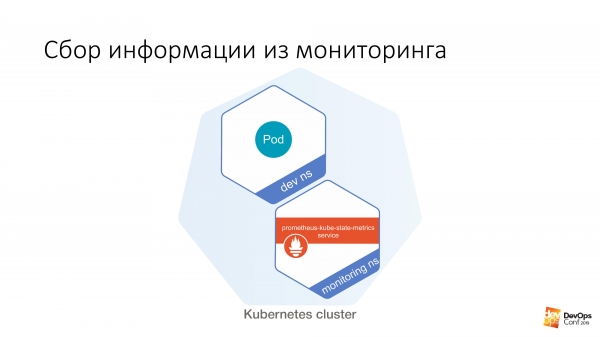
Ezután van egy dev ns, amelyben elindítható egy pod. Ebből a podból nagyon könnyen így lehet továbbmennünk:
$ curl http://prometheus-kube-state-metrics.monitoring A prometheus-kube-state-metrics az egyik prométheusz-exportáló, amely a Kubernetes API-jából gyűjti a metrikákat. Nagyon sok adat van arról, mi fut a klaszteredben, milyen típusú, és milyen problémáid vannak vele.
Példának egyszerűen:
kube_pod_container_info{namespace="kube-system",pod="kube-apiserver-k8s-1",container="kube-apiserver",image=
"gcr.io/google-containers/kube-apiserver:v1.14.5"
,image_id="docker-pullable://gcr.io/google-containers/kube-apiserver@sha256:e29561119a52adad9edc72bfe0e7fcab308501313b09bf99df4a9638ee634989",container_id="docker://7cbe7b1fea33f811fdd8f7e0e079191110268f2853397d7daf08e72c22d3cf8b"} 1
Ha egyszerű curl kérést indítasz egy nem privilegizált podból, akkor ilyen információkat kaphatsz. Ha nem tudod, melyik Kubernetes verzióban futsz, akkor az könnyen elmeséli neked.
A legérdekesebb az, hogy a kube-state-metrics lekérdezése mellett ugyanazzal a sikerrel közvetlenül a Prometheushoz is fordulhatsz. Onnan is gyűjthetsz metrikákat. Sőt, elméletileg olyan lekérdezést is létrehozhatsz a klaszterből a Prometheusban, amely egyszerűen leállítja azt. És akkor a monitoring teljesen leáll a klaszterről.
Itt már felmerül a kérdés, hogy valamilyen külső monitoring figyeli-e a monitoringodat. Épp most szereztem lehetőséget arra, hogy a Kubernetes klaszteren belül következmények nélkül tevékenykedjek. Te még csak nem is fogod tudni, hogy én ott tevékenykedem, mivel már nincs monitoring.
Pontosan úgy, ahogy a PSP-nél, az az érzésem, hogy minden ilyen menő technológia — Kubernetes, Prometheus — egyszerűen nem működik, és tele van lyukakkal. Valójában nem így van.
Van egy dolog — .
Ha normális adminisztrátor vagy, valószínűleg tudod, hogy a Hálózati Szabályzat egy újabb yaml, ami a klaszterben amúgy is bőven van. A Hálózati Szabályzatok pedig bizonyos nem szükségesek. És ha még olvastad is, hogy mi az a Hálózati Szabályzat, hogy ez a Kubernetes yaml tűzfala, amely korlátozza a hozzáférési jogokat a névtér között, podok között, akkor biztosan úgy gondoltad, hogy egy yaml formátumú tűzfal a Kubernetesben egy újabb absztrakció… Nem, ez tényleg nem szükséges.
Még ha a biztonsági szakembereiteknek nem is mondták el, hogy a Kubernetes segítségével nagyon könnyen és egyszerűen lehet tűzfalat építeni, ráadásul nagyon granularisan, ha még nem tudják, és nem kicsinyítik le a dolgot: „Na, adjatok, adjatok…”, akkor is szükségetek van a Network Policy-ra az olyan szolgáltatási helyek hozzáférésének lezárásához, amelyeket a klasztereteken keresztül meg lehet érinteni, anélkül hogy bármilyen hitelesítésetek lenne.
Ahogy az előző példában is említettem, a kube state metrics-et bármelyik névtérből elérhetjük a Kubernetes klaszterben, anélkül hogy bármilyen jogunk lenne rá. A network policy-k lezárták a hozzáférést az összes többi névtérből a monitorozási névtérhez, és ennyi: ha nincs hozzáférés, nincsenek problémák. Az összes chartban, ami elérhető, legyen szó a standard Prometheusról vagy arról, ami az operatorban található, egyszerűen van lehetőség a values fájlban a network policy-k engedélyezésére. Csak be kell kapcsolni, és működni fognak.
Itt van egy probléma. Normál adminisztrátorként valószínűleg úgy döntöttetek, hogy a network policy-k nem szükségesek. És miután olvastatok különféle cikkeket olyan forrásokon, mint a Habr, úgy gondoltátok, hogy a flannel, különösen a host-gateway módban, a legjobb választás, amit megtehettek.
Mit tegyünk?
Megpróbálhatjátok újra telepíteni a hálózati megoldást, ami a Kubernetes klaszteretekben van, és kicserélni valami funkcionálisabbra. Például a Calico-ra. De azonnal felhívom a figyelmeteket arra, hogy a hálózati megoldás megváltoztatásának feladata egy működő Kubernetes klaszterben meglehetősen nem trivialis. Kétszer is megpróbáltam ezt (mindkét alkalommal elméletben), de még a Slurmokon is bemutattuk, hogyan kell ezt csinálni. Az oktatóinknak megmutattuk, hogyan lehet megváltoztatni a hálózati megoldást egy Kubernetes klaszterben. Elvileg megpróbálhatjátok úgy csinálni, hogy a termelési klaszterben ne legyen leállás. De valószínűleg nem fog sikerülni.
A probléma valójában nagyon egyszerűen megoldható. A klaszterben vannak tanúsítványok, és tudjátok, hogy a tanúsítványok egy év múlva lejárnak. Nos, a normális megoldás a klaszterben a tanúsítványokkal az, hogy miért is aggódnánk, emelünk egy új klasztert, a régit hagyjuk lejárni, és minden visszatöltjük. Igaz, amikor lejár, egy napig leáll, de legalább van egy új klaszter.
Amikor új klasztert emeltek, egyúttal a Calicot is tegyétek a flannel helyére.
Mi a teendő, ha a tanúsítványok száz évre szólnak, és nem tervezi a klaszter átdeployálását? Létezik egy Kube-RBAC-Proxy nevű dolog. Ez egy nagyon klassz fejlesztés, amely lehetővé teszi, hogy sidecar konténerré épüljön be bármely podba a Kubernetes klaszterben. Valójában hozzáadja a Kubernetes RBAC-ján keresztüli hitelesítést ehhez a podhoz.
Van egy probléma. Korábban a Prometheus operátorban ez a Kube-RBAC-Proxy megoldás be volt építve. De aztán eltűnt. Jelenleg a modern verziók arra támaszkodnak, hogy van network policy, és ezzel zárják le a dolgokat. Ezért kicsit át kell írni a chartokat. Valójában, ha belép a , ott talál példákat arra, hogyan lehet ezt sidecar-ként használni, és a chartokat minimálisan kell átírni.
Van még egy kisebb probléma. Nem csak a Prometheus adja ki a metrikáit bárkinek. Az összes klaszter komponens, a Kubernetes klaszter is képes kiadni a saját metrikáit.
De ahogy már mondtam, ha nem tud hozzáférni a klaszterhez és információt gyűjteni, akkor legalább kárt tehet.
Szóval gyorsan bemutatok két módot, ahogyan a Kubernetes klaszter egészségét tönkre lehet tenni.
Nevess majd, amikor ezt elmondom, ez két eset a valós életből.
Első módszer. Az erőforrások kimerítése.
Indítunk egy új speciális podot. Ennek a következő szekciója lesz.
resources:
    requests:
        cpu: 4
        memory: 4Gi
Ahogy tudod, a requests az a CPU és memória mennyiség, amely a hoszton rezerválódik a konkrét podok számára, akik kérik. Ha van egy négy magos hoszt a Kubernetes klaszterben, és érkezik egy pod, amely négy CPU-ra kér, akkor tähendab, hogy több pod nem tud érkezni, amelyiknek requests-a van e hosztra.
Ha elindítok egy ilyen podot, majd kiadom a parancsot:
$ kubectl scale special-pod --replicas=...Akkor senki sem tud a Kubernetes klaszterbe deployálni. Mert az összes node-ban elfogynak a requests-ok. Így meg tudom állítani az Ön Kubernetes klaszterét. Ha ezt este csinálom, akkor a deployok elég hosszú ideig állni fognak.
Ha ismét megnézzük a Kubernetes dokumentációját, akkor találkozunk egy olyan dologgal, amit Limit Range-nek hívnak. Ez az erőforrásokat állítja be a klaszter objektumai számára. Írhatsz egy Limit Range YAML objektumot, alkalmazhatod azt adott névterekre - és ezután ebben a névtérben megmondhatod, hogy neked van alapértelmezett, maximális és minimális erőforrásod a podok számára.
Ezzel a dologgal korlátozhatjuk a felhasználókat a speciális terméknévtérben a podjaikban bárminemű felesleges erőforrások megadásában. De sajnos, még ha elmondod a felhasználónak, hogy nem indíthat podokat, amelyek kérnek egy CPU-nál többet, van egy nagyszerű parancs a skálázásra, vagy a dashboardon keresztül is végrehajthatják a skálázást.
Innen ered a második lehetőség. 11 111 111 111 111 pod indítása. Ez tizenegy milliárd. Nem azért mondom ezt a számot, mert kitaláltam, hanem mert én magam is láttam.
Valódi történet. Késő este, már készültem hazaindulni az irodából. Nézem, hogy a sarokban ücsörög egy csoport fejlesztő, és valamit lázasan csinálnak a laptopjaikkal. Odamegyek hozzájuk és megkérdezem: «Mi történt veletek?»
Kicsit korábban, este kilenc körül az egyik fejlesztő haza akart menni. Azt mondta: «Most skálázom az alkalmazásomat egyre». Megnyomta az egyet, de az internet egy kicsit akadozott. Másodszor is rányomott az egyre, nyomta az egyet, rákattintott az Enterre. Nyomkodta mindent, amit tudott. Aztán az internet életre kelt - és minden elkezdett skálázódni erre a számra.
Igaz, ez a történet nem Kubernetes-en zajlott, akkoriban Nomad volt. Az lett a vége, hogy egy óra próbálkozás után a Nomad, hogy megállítsuk a kitartó skálázást, válaszolt, hogy nem fog skálázni és semmi mással nem fog foglalkozni. «Fáradt vagyok, most már megyek». Aztán leállt.
Természetesen megpróbáltam ugyanezt megtenni Kubernetes-en. Tizenegy milliárd pod nem örvendeztette meg a Kubernetes-t, azt mondta: «Nem tudom. Meghaladja a belső korlátokat». De 1 000 000 000 podot sikerült elindítani.
Az egyik milliárd pod nem tűnt el. Valóban elkezdte skálázni a dolgot. Ahogy a folyamat előrehaladt, egyre több idő ment el az új podok létrehozására. De a folyamat továbbra is zajlott. Az egyetlen probléma az, hogy ha a saját névtérben korlátlanul indíthatok podokat, akkor akár kérés és limit nélkül is olyan sok podot tudok létrehozni bizonyos feladatokkal, hogy ezek a feladatok a csomópontok memóriáját és CPU-ját kezdik el elfoglalni. Amikor ennyi podot indítok, az információnak be kell kerülnie a tárolóba, vagyis az etcd-be. Ha túl sok információ érkezik oda, a tároló kezd túl lassan válaszolni — és a Kubernetes akadozni kezd.
De van egy másik probléma... Ahogy tudjátok, a Kubernetes vezérlőelemei nem egy központi dolog, hanem több komponens. Ott van például a controller manager, scheduler és így tovább. Ezek az elemek egyszerre kezdenek el felesleges haszontalan munkát végezni, ami idővel egyre több időt fog igénybe venni. A controller manager új podokat fog létrehozni. A scheduler megpróbál új csomópontot találni számukra. Az új csomópontok valószínűleg hamarosan elfogynak a klaszterben. A Kubernetes klaszter egyre lassabban fog működni.
De úgy döntöttem, hogy még tovább megyek. Ahogy tudjátok, a Kubernetes-ben van egy dolog, amit szolgáltatásnak hívnak. Nos, a legtöbb klaszterben valószínűleg a szolgáltatás IP táblázat (IP tables) segítségével működik.
Ha mondjuk elindítok egy milliárd podot, majd egy kis szkript segítségével rákényszerítem a Kubernetest, hogy új szolgáltatásokat hozzon létre:
for i in {1..1111111}; do
    kubectl expose deployment test --port 80
        --overrides="{"apiVersion": "v1",
           "metadata": {"name": "nginx$i"}}";
done
A klaszter összes csomópontján körülbelül egyszerre újabb és újabb iptables szabályok fognak létrejönni. Minden szolgáltatásra körülbelül egy milliárd iptables szabály fog létrejönni.
Ezt az egészet több ezer, akár tízezer podnál teszteltem. A probléma az, hogy már ezen a szinten az SSH kapcsolatot létrehozni a csomóponthoz meglehetősen nehézzé válik. Mert a csomagok, amikor ennyi láncon haladnak át, nem érzik jól magukat.
És ez is megoldható a Kubernetes segítségével. Van egy olyan objektum, mint a Resource quota. Ez megállapítja a rendelkezésre álló erőforrások és objektumok számát a névterületen a klaszterben. Készíthetünk yaml objektumot a klaszter minden névtérben. Ezzel az objektummal megmondhatjuk, hogy a névtérhez meghatározott számú kérés, limit van kijelölve, és továbbá megmondhatjuk, hogy ebben a névtérben lehet létrehozni 10 szolgáltatást és 10 podot. A fejlesztő még esténként is kedvére dolgozhat. A Kubernetes azt mondja neki: „Nem lehet annyi podot skálázni, mert túllépi az erőforrás kvótát”. Ennyi, a probléma megoldva. .
Egy problémás pont ezzel kapcsolatban merül fel. Érezni lehet, hogy mennyire nehéz lesz létrehozni egy névteret a Kubernetesben. A létrehozásához sok mindent figyelembe kell vennünk.
Resource quota + Limit Range + RBAC
• Létrehozzuk a neveztérét
• Létrehozzuk a limitrange-t belül
• Létrehozzuk a resourcequota-t belül
• Létrehozzuk a serviceaccount-ot a CI számára
• Létrehozzuk a rolebindingot a CI és a felhasználók számára
• Opcionálisan elindítjuk a szükséges szolgáltató podokat
Ezért szeretném megragadni a lehetőséget, hogy megosszam a fejlesztéseimet. Van egy dolog, amit operator SDK-nak hívnak. Ez egy mód arra, hogy operátorokat írjunk a Kubernetes klaszterbe. Operátorokat írhatunk Ansible segítségével.
Eleinte Ansible-n írtuk, majd megnéztem, hogy van operator SDK, és átírtam az Ansible szerepet operátorra. Ez az operátor lehetővé teszi, hogy létrehozzunk egy objektumot a Kubernetes klaszterben, amelyet parancsnak hívnak. A parancs belsejében lehetőség van a yaml környezetének leírására. A parancs környezetében pedig leírhatjuk, hogy mennyi erőforrást biztosítunk.
Kicsi .
És végül. Mit tegyünk mindezzel?
Első. A Pod Security Policy – ez jó. És bár a Kubernetes telepítők egyike sem használja őket a mai napig, a klasztereitekben mégis használni kell őket.
A Network Policy – nem egy újabb felesleges funkció. Valóban szükséges a klaszterben.
LimitRange/ResourceQuota – ideje lenne használni. Régóta használjuk ezeket, és sokáig biztos voltam benne, hogy mindenki ezt alkalmazza. Kiderült, hogy ez ritkaság.
Ami említettem a prezentáció során, vannak nem dokumentált funkciók, amelyek lehetővé teszik a klaszter támadását. Nemrégiben megjelent .
Néhány dolog annyira szomorú és bántó. Például bizonyos körülmények között a klaszterben lévő kubeletek kiadhatják a warlocks könyvtár tartalmát, és ezt nem hitelesített felhasználóknak is.
találhatók az utasítások arról, hogyan lehet reprodukálni mindazt, amit elmondtam. Ott vannak a fájlok, amelyek a termelési példákat tartalmazzák, például, hogy hogyan néz ki a ResourceQuota, Pod Security Policy. És mindez kézzelfogható.
Mindenkinek köszönöm.
Forrás: habr.com
