

A felhők olyanok, mint egy varázslatos doboz - megmondod, mire van szükséged, és az erőforrások hirtelen előbukkannak. Virtuális gépek, adatbázisok, hálózat - mindez csak a tiéd. Vannak más felhőbérlők is, de a saját univerzumban te vagy az egyedüli uralkodó. Biztos vagy benne, hogy mindig megkapod a szükséges erőforrásokat, senkivel nem kell osztoznod, és saját magad határozod meg, milyen lesz a hálózat. Hogyan működik ez a varázslat, ami lehetővé teszi, hogy a felhő rugalmasan ossza ki az erőforrásokat, és teljesen elszigetelje a bérlőket egymástól?
Az AWS felhő egy óriási, szuperkomplex rendszer, amely 2006 óta folyamatosan fejlődik. Ennek a fejlődésnek részese volt Vaszilij Pantuuhin — az Amazon Web Services építészeként. Építészként nemcsak a végeredményt látja, hanem az AWS által leküzdött nehézségeket is. Minél jobban megérted a rendszer működését, annál nagyobb a bizalom. Ezért Vaszilij megosztja velünk az AWS felhőszolgáltatásainak titkait. A cikkben bemutatásra kerülnek az AWS fizikai szervereinek felépítése, az adatbázisok rugalmas skálázása, az egyedi Amazon adatbázis és a virtuális gépek teljesítményének növelésére szolgáló módszerek, miközben csökkentjük árukat. Az Amazon architektúrára vonatkozó ismeretek segítenek hatékonyabban használni az AWS szolgáltatásait, és talán új ötleteket is adnak saját megoldások kidolgozásához.
A szakértőről: Vaszilij Panyukhin () Unix rendszergazdaként kezdett orosz cégeknél, 6 évig nagy gépekkel foglalkozott a Sun Microsystemnél, 11 éven át hirdette az adatközpontú világot az EMC-nél. Természetes úton fejlődött a privát felhők irányába, majd 2017-ben a nyilvános felhők felé fordult. Jelenleg technikai tanácsokkal segíti az AWS felhőben való életet és fejlődést.
Felelősségkizárás: mindaz, ami alább található - Vaszilij személyes véleménye, és nem feltétlenül egyezik meg az Amazon Web Services álláspontjával. az előadás alapján készült cikk, elérhető a YouTube-csatornánkon.
Miért beszélek az Amazon felépítéséről
Az első autóm „manuális váltós” volt - mechanikus sebességváltóval. Nagyon jó érzés volt, hogy kézben tarthatom az autót és teljesen uralhatom azt. Az is tetszett, hogy legalább nagyjából értem, hogyan működik. Természetesen a sebességváltó felépítését meglehetősen primitíven képzeltem el - körülbelül úgy, mint a kerékpár sebességváltóját.
Minden csodás volt, kivéve egy dolgot: a dugókat. Úgy tűnik, ülsz és semmit sem csinálsz, de folyamatosan kapcsolgatod a sebességet, nyomod a kuplungot, a gázt és a féket — ez tényleg fárasztó. A dugók problémája részben megoldódott, amikor a családban megjelent egy automata autó. A volánnál időt nyertem, hogy elgondolkodjak valamin vagy hallgassak egy audiókönyvet.
Az életemben megjelent egy rejtély, mert teljesen megálltam a saját autóm működésének megértésében. A modern autó egy bonyolult eszköz. Az autó egyszerre tucatnyi különböző paraméterhez alkalmazkodik: a gázra lépés, a fékezés, a vezetési stílus, az út minősége. Már nem értem, hogyan működik.
Amikor elkezdtem az Amazon felhővel foglalkozni, ez is rejtély volt számomra. Csak ez a rejtély sokkal nagyobb, mert egy autóban egy sofőr van, míg az AWS-ben milliók. Minden felhasználó egyszerre irányít, nyomja a gázt és a féket. Megdöbbentő, hogy oda mennek, ahová akarnak — ez számomra csoda! A rendszer automatikusan alkalmazkodik, skálázódik és rugalmasan alkalmazkodik minden felhasználóhoz, úgy, hogy úgy tűnik, mintha egyedül lenne ebben a Világegyetemben.
A varázslat kicsit eloszlott, amikor később építészként kezdtem dolgozni az Amazonnál. Láttam, milyen problémákkal szembesülünk, hogyan oldjuk meg őket, hogyan fejlesztjük a szolgáltatásokat. A rendszer működésének megértésével nő a bizalom a szolgáltatás iránt. Ezért szeretném megosztani a képet arról, mi rejlik az AWS felhő motorházteteje alatt.
Miről fogunk beszélni
Egy diverzifikált megközelítést választottam — négy érdekes szolgáltatást választottam ki, amelyekről érdemes beszélni.
Szerverek optimalizálása. Efemer felhők fizikai megvalósítása: fizikai adatközpontok, ahol valós fizikai szerverek állnak, amelyek zúgnak, melegszenek és világítanak.
Szerver nélküli funkciók (Lambda) — valószínűleg a legskálázhatóbb szolgáltatás a felhőben.
Adatbázis skálázása. Mesélek arról, hogyan építjük fel a saját skálázható adatbázisainkat.
Hálózat méretezés. Az utolsó részben felfedem a hálózatunk működését. Ez egy csodálatos dolog — minden felhasználó a felhőben azt hiszi, hogy egyedül van és egyáltalán nem lát más bérlőket.
Megjegyzés. Ebben a cikkben a szerverek optimalizálásáról és az adatbázisok skálázásáról lesz szó. A hálózati skálázást a következő cikkben tárgyaljuk. Hol vannak a szerver nélküli funkciók? Erről külön cikk készült.A cikk több különböző skálázási módszerről mesél, és részletesen bemutatja a Firecracker megoldást – a virtuális gépek és a konténerek legjobb tulajdonságainak szimbiózisát.
Szerverek
A felhő efemer. De ennek az efemeritásnak mégis van fizikai megjelenése – a szerverek. Eredetileg az architektúrájuk klasszikus volt. Szabványos x86 chipset, hálózati kártyák, Linux, Xen hipervizor, amelyen virtuális gépek futottak.
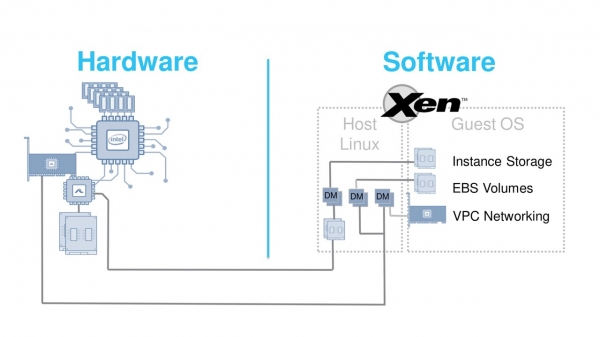
2012-ben ez az architektúra teljes mértékben megfelelt a feladatainak. A Xen egy kiváló hipervizor, de van egy komoly hátránya. Magas a perifériák emulációjának költségei.Amikor új, gyorsabb hálózati kártyák vagy SSD meghajtók jelentek meg, ezeknek a költségei túl magasakká váltak. Hogyan oldhatjuk meg ezt a problémát? Úgy döntöttünk, hogy párhuzamosan mindkét fronton dolgozunk – optimalizáljuk a hardvert és a hipervizort.A feladat nagyon komoly.
A hardver és a hipervizor optimalizálása.
Nem lehet mindent egyszerre és jól megcsinálni. Mi is a "jól", eredetileg ez sem volt világos.
Egy evolúciós megközelítést választottunk – megváltoztatunk egy fontos elemet az architektúrában, és a gyakorlatba helyezzük.
Belevágunk minden nehézségbe, meghallgatjuk a panaszokat és ajánlásokat. Aztán megváltoztatjuk a másik alkatrészt. Így, apró lépésekben, radikálisan megváltoztatjuk az egész architektúrát a felhasználói visszajelzések és a támogatás alapján.
A változtatások 2013-ban kezdődtek a legnehezebb feladattal – a hálózattal. A C3 példányokban a szabványos hálózati kártyához egy speciális Network Accelerator kártyát adtak hozzá. Ez egy rövid loopback kábellel csatlakozott a frontpanelhez. Nem szép, de a felhőben nem látható. Cserébe a hardverrel való közvetlen interakció jelentősen javította a jittert és a hálózati sávszélességet.
A következő lépés az EBS – Elastic Block Storage blokkalapú adattárolás javítása volt. Ez a hálózat és a tároló kombinációja. A nehézség abban rejlik, hogy a Network Accelerator kártyák már léteztek a piacon, de a Storage Accelerator hardver egyszerű megvásárlásának lehetősége nem volt elérhető. Ezért a startuphoz fordultunk, az Annapurna Labs-hoz., amelyet a számunkra készített speciális ASIC chipek tettek lehetővé. Ezek lehetővé tették távvezérlés alatt álló EBS kötetek NVMe eszközként való csatlakoztatását.
Az instance-okon C4 két feladatot oldottunk meg. Az első — egy jövőorientált, de akkoriban új NVMe technológia alapjait leraktuk. A második — jelentősen csökkentettük a központi feldolgozó egység terhelését az EBS-kérések új kártyára történő áthelyezésével. Sikeres volt, ezért most az Annapurna Labs az Amazon része.
2017 novemberére már rájöttünk, hogy eljött az ideje magának a hypervisornak a megváltoztatására is.
Az új hypervisort a KVM kernel testreszabott moduljaira alapozva fejlesztettük ki.
Ez lehetővé tette a készülékek emulációs költségeinek lényeges csökkentését és a közvetlen működést az új ASIC-okkal. Az instance-okon C5 az első virtuális gépek voltak, amelyek alatt az új hypervisor működik. Ezt neveztük el Nitro.
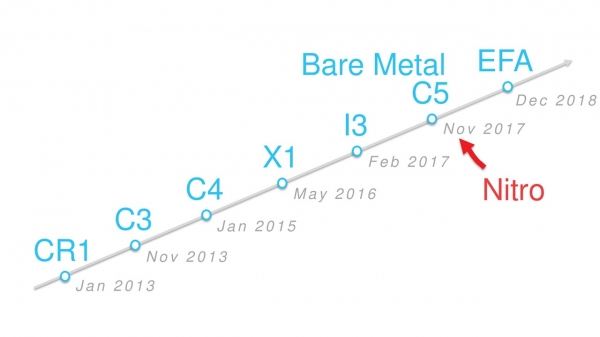 Az instance-ok evolúciója az idővonalon.
A 2017 novemberében megjelent új virtuális gépek mind ezt a hypervisort használják. A bare metal instance-októl hiányzik a hypervisor,, de őket is Nitro-nak hívják, mivel specializált Nitro kártyákat használnak.
A következő két évben a Nitro instance-ok típusainak száma meghaladta a több tucatot: A1, C5, M5, T3 és mások.
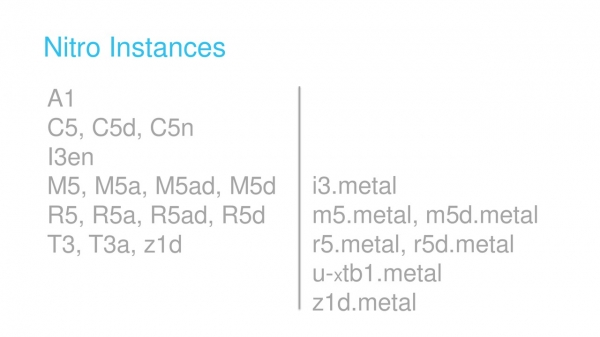
Instance típusok.
Hogyan működnek a modern Nitro gépek
Három alapvető összetevőjük van: Nitro hypervisor (amelyről korábban volt szó), biztonsági chip és Nitro kártyák.
A biztonsági chip közvetlenül az alaplapba van integrálva. Számos fontos funkciót irányít, például a gazda OS betöltésének ellenőrzését.
A Nitro kártyák - négyféle létezik. Mindegyiket az Annapurna Labs készítette, és közös ASICokra épülnek. Egyes firmware-eik is közösek.
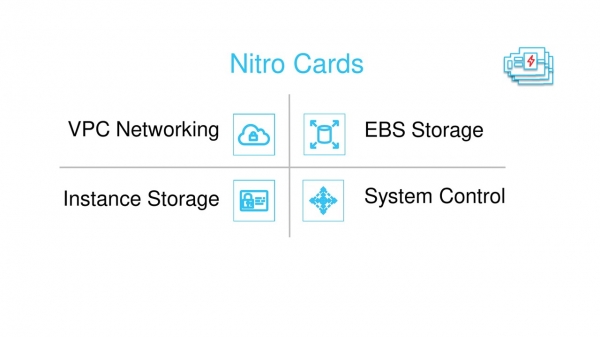
Négy típusú Nitro kártya.
Az egyik kártya a hálózattalVPCdolgozik. Ez látható a virtuális gépekben, mint hálózati kártya ENA — Elastic Network Adaptor. Ez a forgalmat is kapszulázza, amikor azt fizikailag átviszik a hálózaton (erről a cikk második részében beszélünk), ellenőrzi a Security Groups tűzfalat, felelős a forgalomirányításért és egyéb hálózati feladatokért.
Külön kártyák dolgoznak a blokkalapú tárolással EBS és a szerverbe épített lemezekkel. A vendég virtuális gépek számára ezek NVMe-adapterek- ként jelennek meg. Ezek felelnek az adatok titkosításáért és a lemezek figyeléséért.
A Nitro kártyák, hypervisor és biztonsági chip rendszere egy SDN hálózatba van integrálva, vagyis Software Defined Network. E hálózat irányítását (Control Plane) ez a felelős vezérlő kártya.
Természetesen folytatjuk új ASIC-ok fejlesztését. Például 2018 végén kiadtuk az Inferentia chipet, amely hatékonyabban kezeli a gépi tanulási feladatokat.
Inferentia gépi tanulási processzor.
Skálázható adatbázis
A hagyományos adatbázis réteges felépítéssel rendelkezik. Ha nagyon leegyszerűsítjük, a következő szinteket különböztetjük meg.
- SQL — ezen működnek az ügyfelek és a lekérdezések irányítói.
- Biztosítások tranzakciók — itt minden egyértelmű, ACID és hasonlók.
- Gyorsítótárazás, amelyet a pufferpoolok biztosítanak.
- Naplózás — kezeli a redo naplókkal való munkát. A MySQL-ben ezek Bin Logs néven ismertek, míg a PostgreSQL-ben — Write Ahead Logs (WAL).
- Tárolás – közvetlen írás a lemezre.
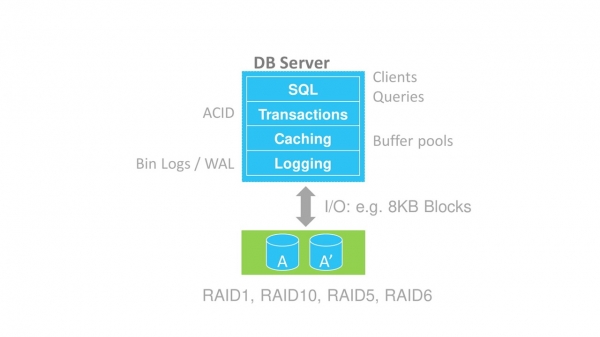
Az adatbázis réteges felépítése.
Különböző módszerek léteznek az adatbázisok skálázására: sharding, Shared Nothing architektúra, közös lemezek.
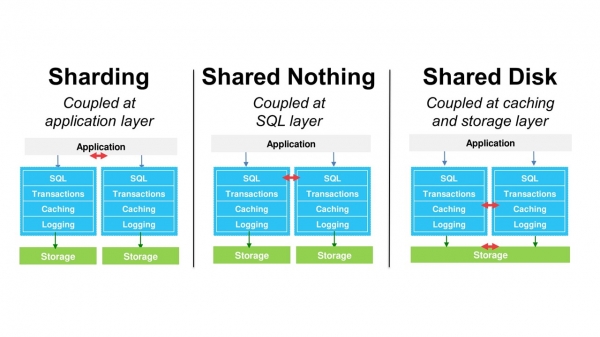
Mindazonáltal mindezek a módszerek megőrzik ugyanazt a monolitikus adatbázis struktúrát. Ez jelentősen korlátozza a skálázást. Ennek megoldására kifejlesztettük saját adatbázisunkat — Amazon Aurora. Ez kompatibilis a MySQL-lel és a PostgreSQL-lel.
Amazon Aurora
A fő architekturális ötlet — elválasztani a tárolási és naplózási szinteket az alap adatbázistól.
Előrehaladva elmondom, hogy a gyorsítótár szintjét is függetlenné tettük. Az architektúra megszűnik monolitikus lenni, és további szabadságot kapunk az egyes blokkok skálázásában.
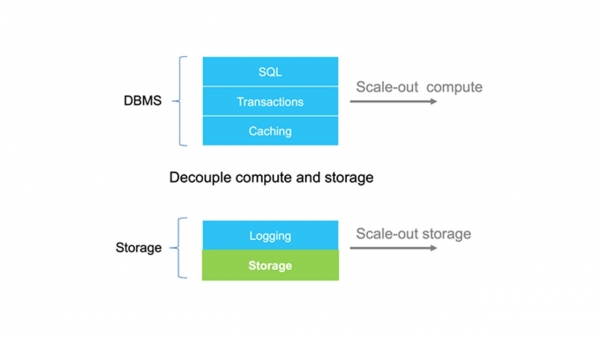
A naplózási és tárolási szintek elválasztva vannak az adatbázistól.
A hagyományos DBMS blokkokban tárolja az adatokat a tárolórendszeren. Az Amazon Aurora-ban "okos" tárolót hoztunk létre, amely képes kommunikálni a redo naplókkal. A tároló belül átalakítja a naplókat adatblokkokká, figyelemmel kíséri azok sértetlenségét és automatikusan biztonsági másolatot készít.
Ez a megközelítés lehetővé teszi olyan érdekes dolgok megvalósítását, mint a klónozás. Ez alapvetően gyorsabban és gazdaságosabban működik, mivel nem igényel teljes másolatot az összes adatból.
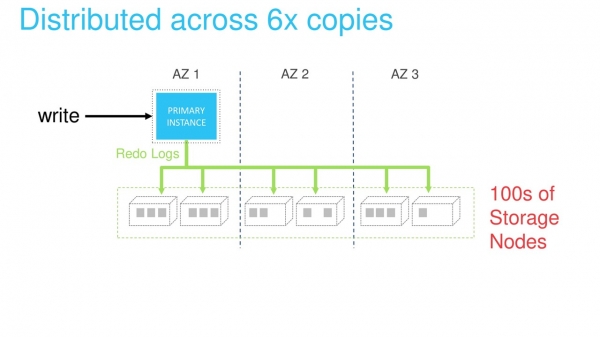
A tárolás szintje egy elosztott rendszerként valósul meg. Nagy számú fizikai szerverből áll. Minden redo napló egyidejűleg hat csomóponton. Ez biztosítja az adatok védelmét és a terhelés elosztását.
Az olvasásra szánt skálázást megfelelő replikák segítségével lehet biztosítani. A megosztott tárolás megszünteti az adatbázis fő példánya, amelyen keresztül az adatokat írjuk, és a többi replikája közötti szinkronizálás szükségességét. A releváns adatok garantáltan elérhetők minden replikán.
Az egyetlen probléma az, hogy a replikákon régi adatok kerülnek gyorsítótárazásra. De ez a feladat megoldható a redo-logok átadásával a replikák felé belső hálózaton. Ha a napló a gyorsítótárban van, akkor hibásnak minősül és felülíródik. Ha a gyorsítótárban nincs, akkor egyszerűen eldobják.
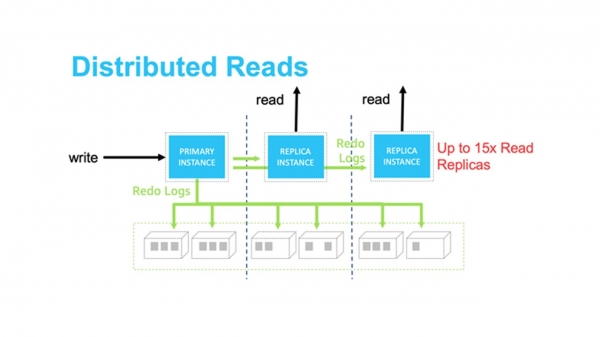
A tárolóval megoldottuk.
Hogyan skálázzuk a DBMS szinteket
Itt a vízszintes skálázás sokkal bonyolultabb. Ezért a bejáratott úton haladunk a klasszikus függőleges skálázás felé.
Tegyük fel, hogy van egy alkalmazásunk, amely a DBMS-sel a fő csomóponton keresztül kommunikál.
Függőleges skálázáskor új csomópontot alakítunk ki, amelynek több processzora és memóriája lesz.
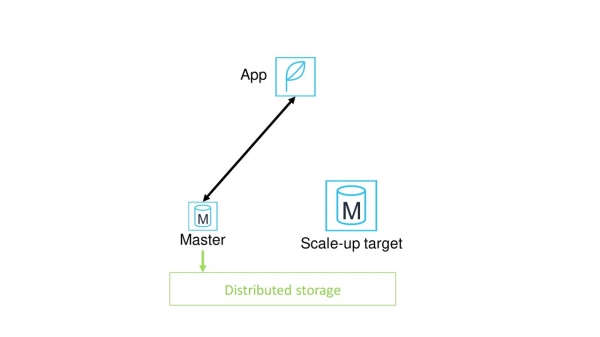
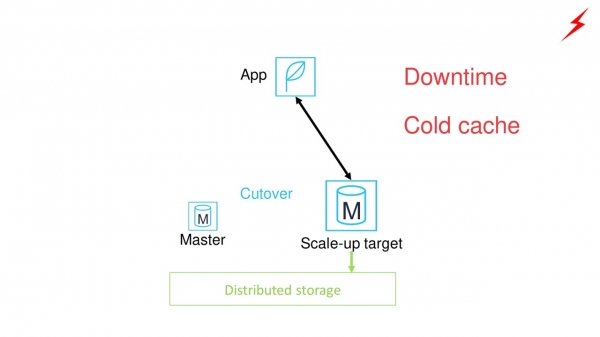
Ezután az alkalmazást a régi fő csomópontból az újra irányítjuk. Problémák merülnek fel.
- Ez jelentős leállást okoz az alkalmazásban.
- Az új fő csomópontnak hideg gyorsítótára lesz. Az adatbázis teljesítménye csak a gyorsítótár felmelegítése után lesz maximális.
Hogyan javíthatjuk a helyzetet? Tegyünk proxy-t az alkalmazás és a fő csomópont közé.
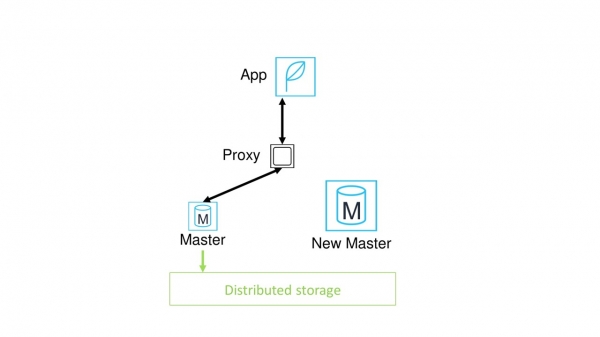
Mit nyújt ez számunkra? Most már nem kell manuálisan átirányítani az összes alkalmazást az új csomópontra. Az átállás gyorsabb és a proxy alatt végezhető el.
Úgy tűnik, hogy a probléma megoldódott. De nem, még mindig szenvedünk a gyorsítótár felmelegítésének szükségességétől. Ráadásul egy új probléma is felmerült – most a proxy potenciális leállási ponttá vált.
Végső megoldás az Amazon Aurora serverless használatával
Hogyan oldottuk meg ezeket a problémákat?
Hagytuk a proxyt. Ez nem egy különálló példány, hanem egy egész megosztott flotta proxy, amelyen keresztül az alkalmazások csatlakoznak az adatbázishoz. Bármelyik csomópontot, ha meghibásodik, szinte azonnal helyettesíthetjük.
Hozzáadtunk egy különféle méretű meleg csomópontokból álló medencét. Ezért, ha nagyobb vagy kisebb méretű új csomópontot kell létrehozni, az azonnal rendelkezésre áll. Nem kell várni, míg betöltődik.
A skálázási folyamatot egy speciális megfigyelőrendszer irányítja. A megfigyelés folyamatosan figyelemmel kíséri a jelenlegi mestercsomópont állapotát. Ha például észleli, hogy a processzor terhelése elérte a kritikus szintet, értesíti a meleg példányok csoportját, hogy szükség van egy új csomópont létrehozására.
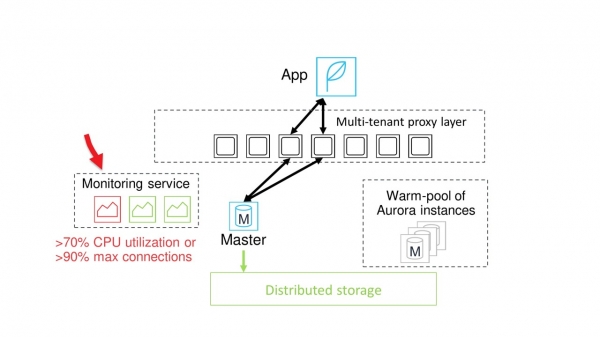
Elosztott proxik, meleg példányok és megfigyelés.
A szükséges teljesítményű csomópont elérhető. A pufferpools másolásra kerülnek erre, és a rendszer várni kezd a biztonságos pillanatra a váltáshoz.
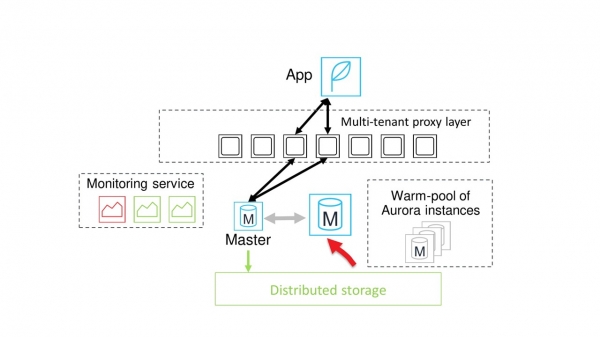
Általában a váltás pillanata elég gyorsan bekövetkezik. Ekkor a kommunikáció a proxy és a régi mestercsomópont között felfüggesztésre kerül, minden session átvált az új csomópontra.
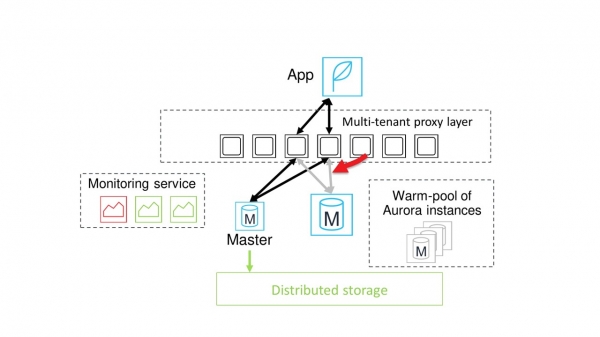
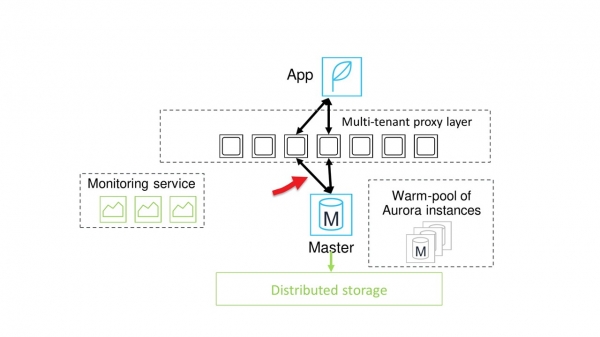
Az adatbázissal való munka folytatódik.
A grafikonon látható, hogy a felfüggesztés valóban nagyon rövid. A kék grafikonon a terhelés, a piros lépcsők pedig a skálázási pillanatok. A kék grafikonon látható rövid időtartamú zuhanások éppen azt a rövid késleltetést jelentik.
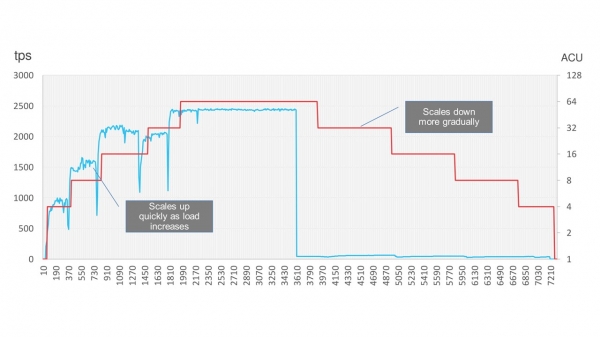
Egyébként az Amazon Aurora lehetővé teszi, hogy jelentősen spóroljunk és kikapcsoljuk az adatbázist, amikor az nem használatos, például hétvégén. A leállítás után az adatbázis terhelése fokozatosan csökkenti a teljesítményét és egy időre kikapcsol.
A következő részben az Amazon rendszereinek skálázásáról fogunk beszélni. Iratkozzon fel és kövesse a frissítéseket, hogy ne maradjon le a cikkről.
Ezen Vaszilij Pántyuhin tart egy előadást „”. Milyen tervezési mintákat használnak az Amazon fejlesztői a elosztott rendszerekhez, mik lehetnek a szolgáltatások leállásának okai, mi az a Cell-based architecture, Constant Work, Shuffle Sharding – érdekes lesz. Kevesebb mint egy hónap van a konferenciáig — . Október 24-én véglegesen emelkednek az árak.
Forrás: habr.com
