

Az Amazon Web Services hálózata világszerte 69 zónát foglal magában 22 régióban: Egyesült Államok, Európa, Ázsia, Afrika és Ausztrália. Minden zónában legfeljebb 8 adatközpont található. Minden adatközpontban több ezer vagy százezer szerver működik. A hálózat úgy van felépítve, hogy minden valószínűtlen leállási forgatókönyvet figyelembe vegyen. Például minden régió elszigetelt egymástól, a rendelkezésre állási zónák több kilométeres távolságra helyezkednek el egymástól. Még ha egy kábelt el is vágnak, a rendszer átáll a tartalék csatornákra, és az információveszteség néhány adatcsomagra korlátozódik. A hálózat felépítéséről és működéséről Vaszilij Pantuuhin mesél.
Vaszilij Pantuuhin Unix-adminisztrátorként kezdte a .ru cégeknél, 6 évig foglalkozott a Sun Microsystems nagy gépeivel, 11 éven át hirdette a világ adatközpontuságát az EMC-nél. Természetes úton fejlődött a magánfelhőkhöz, majd átpártolt a nyilvános felhők felé. Jelenleg az Amazon Web Services építészeként technikai tanácsokkal segíti az AWS felhőben való életet és fejlődést.
A trilógia előző részében az AWS felépítéséről Vaszilij a fizikai szerverek és az adatbázisok méretezésével foglalkozott. Nitro-kártyák, egyedi KVM alapú hipervizor, Amazon Aurora adatbázis — mindezekről a "" cikkben olvashatsz. Olvasd el, hogy mélyebben belemerülj a kontextusba, vagy nézd meg a a beszédéből.
Ebben a részben a hálózat méretezéséről lesz szó - az AWS egyik legbonyolultabb rendszeréről. Az evolúció a síkhálózatról a Virtual Private Cloud-ra és annak felépítése, a Blackfoot és HyperPlane belső szolgáltatások, a zajos szomszéd problémája, és a végén - a hálózat méretei, gerinchálózat és fizikai kábelek. Mindez a cikkben.
Nyilatkozat: minden, ami alatta található - Vaszilij személyes véleménye, és nem feltétlenül egyezik meg az Amazon Web Services álláspontjával.
Hálózat méretezés
Az AWS felhőt 2006-ban indították el. A hálózata eléggé primitív volt - sík struktúrával. A privát címek tartománya közös volt a felhő összes bérlője számára. Új virtuális gép indításakor véletlenszerűen egy elérhető IP-címet kaptál ebből a tartományból.
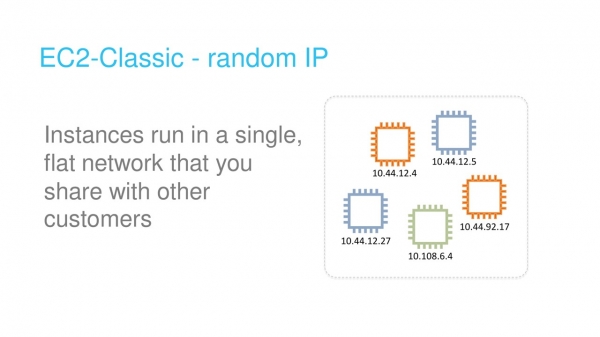
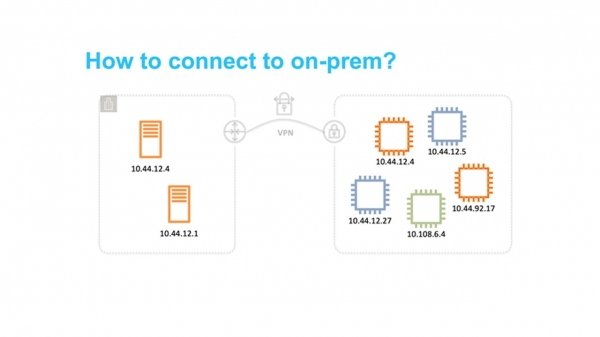
Ez a megközelítés egyszerű volt a megvalósítás szempontjából, de alapvetően korlátozta a felhő használatát. Különösen nehéz volt hibrid megoldások kidolgozása, ahol a helyi magán hálózatokat az AWS-ben ötvözték. A legelterjedtebb probléma az IP-cím tartományok átfedése volt.
Virtuális Magán Felhő
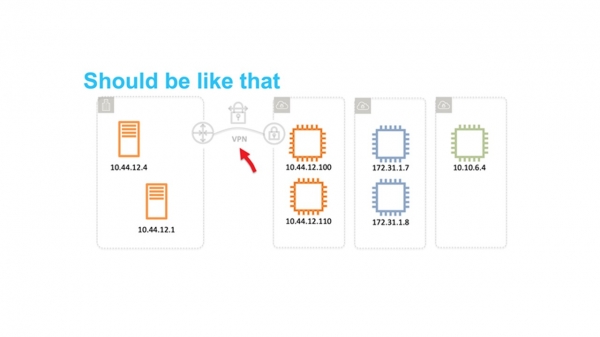
A felhő iránti kereslet megnőtt. Eljött az idő, hogy elgondolkodjunk a skálázhatóságról és a lehetőségről, hogy ezt több tízmillió bérlő terheire használhassuk. A sík hálózat lett a legnagyobb akadály. Ezért arra gondoltunk, hogyan lehet elkülöníteni a felhasználókat egymástól a hálózati szinten, úgy, hogy önállóan választhassák meg az IP tartományokat.
Mi jut először eszébe, amikor a hálózati elkülönítésre gondol? Természetesen VLAN és VRF – Virtuális Routing és Forwarding.
Sajnos, ez nem működött. A VLAN ID csupán 12 bit, ami mindössze 4096 izolált szegmentumot biztosít számunkra. Még a legnagyobb switch-ek esetén is maximálisan 1-2 ezer VRF használható. A VRF és a VLAN együttes használata mindössze néhány millió alhálót ad számunkra. Ez biztosan nem elegendő több tízmillió bérlő számára, akik mind szeretnének több alhálózatot használni.
Emellett egyszerűen nem engedhetjük meg magunknak, hogy megvásároljuk a szükséges számú nagy dobozt, például a Cisco-tól vagy Junipertől. Két ok van: ez dögivel drága, és nem szeretnénk függővé válni a fejlesztési és javítási politikájukról.
Az egyetlen következtetés – saját megoldást kell főznünk.
2009-ben bejelentettük VPC — Virtuális Magán Felhő. A név megragadt, és most már sok felhőszolgáltató is használja azt.
A VPC egy virtuális hálózat SDN (Szoftveresen Meghatározott Hálózat). Úgy döntöttünk, hogy nem találunk ki speciális protokollokat az L2 és L3 szinteken. A hálózat a szabványos Etherneten és IP-n működik. A virtuális gépek forgalmát a saját protokollunk burkolatába ágyazzuk. Ebben szerepel a VPC bérlőhöz tartozó azonosító.
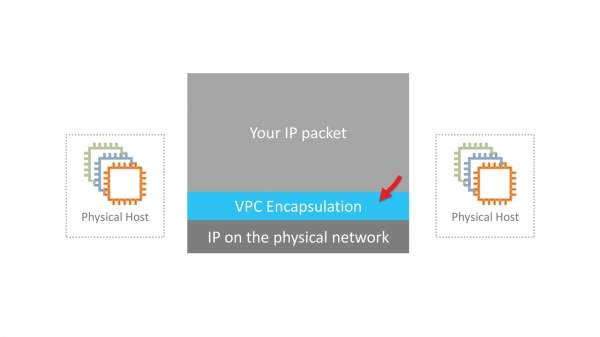
Jónak tűnik. Ugyanakkor több komoly műszaki feladatot kell megoldani. Például hol és hogyan tároljuk a virtuális MAC/IP címek, VPC ID és a megfelelő fizikai MAC/IP térképezésének adatait. Az AWS méreteivel ez egy hatalmas táblázat, amely minimális késleltetéssel kell, hogy működjön. Erről a térképező szolgáltatás, amely vékony rétegben van elosztva az egész hálózaton.
Az új generációs gépekben a Nitro kártyák szintjén valósul meg az encapsuláció. A régi példányoknál az encapsuláció és a decapsuláció szoftveres megoldás.
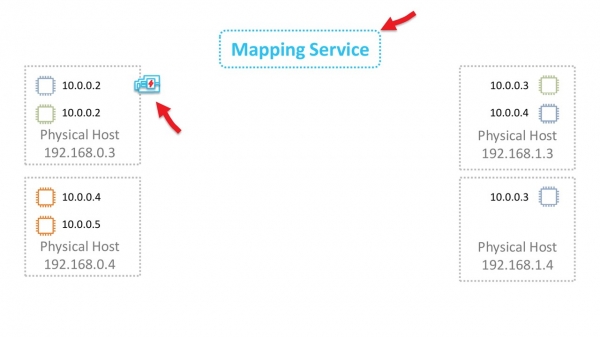
Nézzük meg, hogyan működik ez általános értelemben. Kezdjük az L2 szinttel. Tegyük fel, hogy van egy virtuális gépünk 10.0.0.2 IP címmel a 192.168.0.3 fizikai szerveren. Ez adatokat küld a 10.0.0.3 virtuális gépnek, amely a 192.168.1.4-en található. ARP kérés keletkezik, amely eljut a Nitro hálózati kártyához. Egyszerűség kedvéért tételezzük fel, hogy mindkét virtuális gép egy „kék” VPC-n belül található.
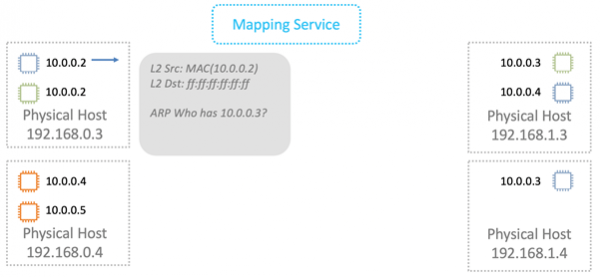
A kártya helyettesíti a forrás címet a sajátjával, és továbbítja az ARP keretet a leképező szolgáltatásnak.
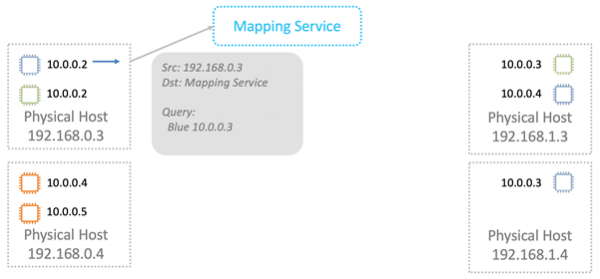
A leképező szolgáltatás visszaadja a szükséges információt az L2 fizikai hálózaton való továbbításhoz.
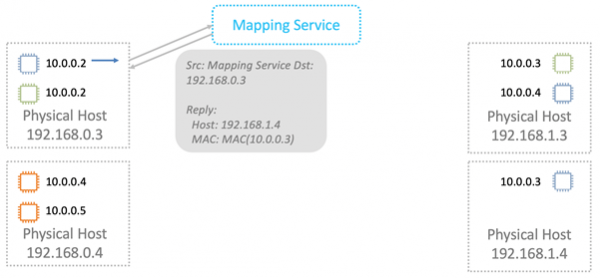
A Nitro kártya az ARP válaszban a fizikai hálózaton levő MAC címet lecseréli a VPC-beli címre.
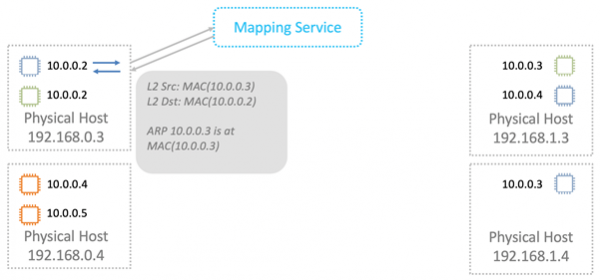
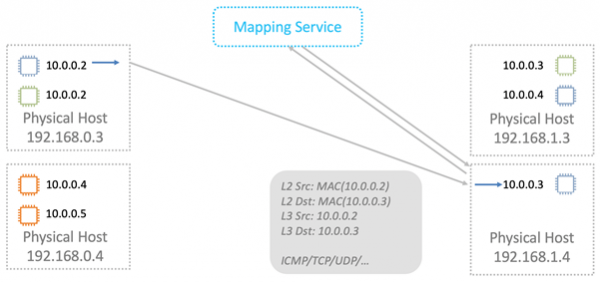
Adatok továbbítása során a logikai MAC és IP címeket a VPC burkolatába csomagoljuk. Mindezt a megfelelő IP Nitro kártyák segítségével továbbítjuk a fizikai hálózaton.
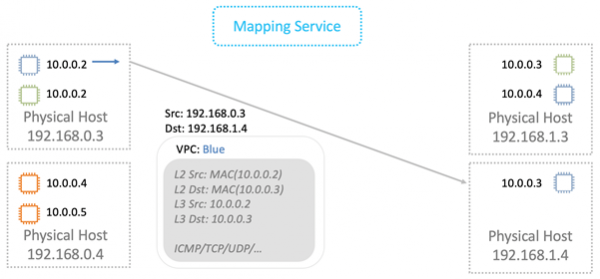
A fizikai gép, amelynek a csomag a címe, ellenőrzi azt. Ez szükséges az címek hamisításának megelőzése érdekében. A gép egy különleges kérdést küld a leképező szolgáltatásnak, és megkérdezi: "A 192.168.0.3 fizikai gépről kaptam egy csomagot, amely a 10.0.0.3 számára készült a "kék" VPC-n. Ez jogos?"
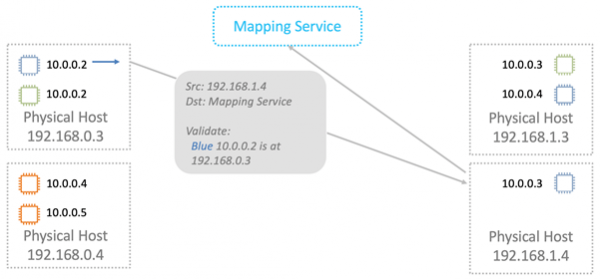
A leképező szolgáltatás összeveti a saját erőforrás-mapping táblájával, és lehetővé teszi vagy megakadályozza a csomag áthaladását. Minden új példányban további érvényesítést építettek be a Nitro kártyákba. Ezt elméletileg sem lehet megkerülni. Ezért a spoofing a másik VPC erőforrásaira nem működik.
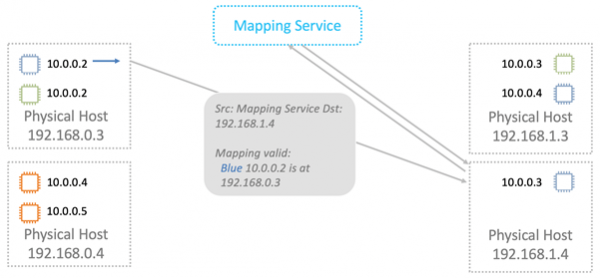
Ezután az adatokat a megfelelő virtuális géphez küldik.
A leképező szolgáltatás logikai routerként is működik az adatokat a különböző alhálózatokban lévő virtuális gépek között történő továbbításához. Itt elméletben minden egyszerű, nem részletezném.
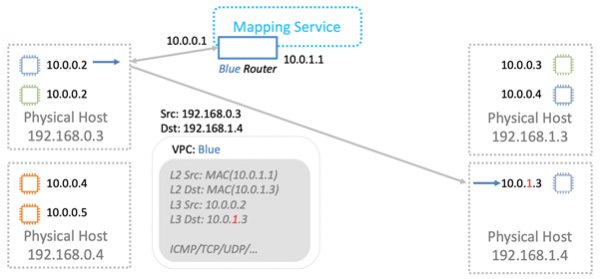
Ezért minden egyes csomag továbbításakor a szerverek a leképező szolgáltatáshoz fordulnak. Hogyan kezeljük az elkerülhetetlen késéseket? Gyorsítással., természetesen.
Az egész dolog szépsége abban rejlik, hogy nem szükséges a hatalmas táblázatot gyorsítótárazni. A fizikai szerveren viszonylag kis számú VPC-ből élnek a virtuális gépek. Csak ezekről a VPC-kről szükséges az információt gyorsítótárazni. Az adatok más VPC-k felé történő továbbítása „alapértelmezett” konfigurációban egyébként sem legális. Ha olyan funkcionalitást használunk, mint a VPC-peering, akkor a gyorsítótárba kiegészítő információt töltünk be a megfelelő VPC-kről.
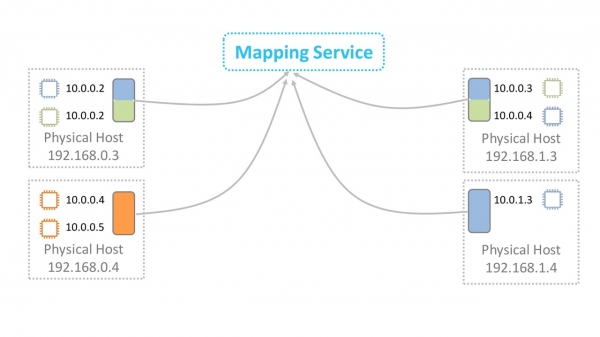
Már eltudtuk rendezni az adatok VPC-hez való továbbítását.
Blackfoot
Mi a teendő olyan esetekben, amikor a forgalmat ki kell irányítani, például az Internetbe vagy VPN-en keresztül a földre? Itt segít nekünk Blackfoot — az AWS belső szolgáltatása. Ezt a dél-afrikai csapatunk fejlesztette ki. Ezért a szolgáltatás nevét egy Dél-Afrikában élő pingvinről kapta.
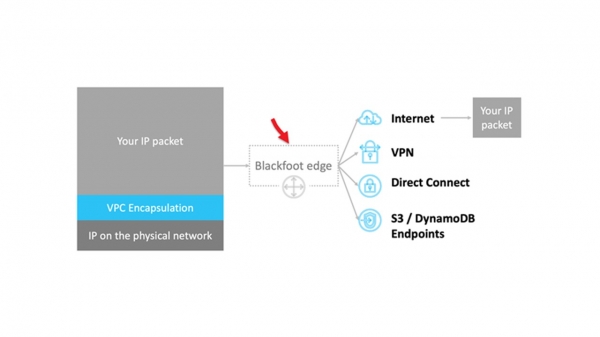
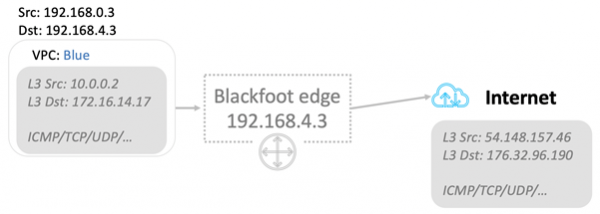
A Blackfoot dekapszulázza a forgalmat és megteszi vele, amit kell. Az Internetre az adatok változatlan formában kerülnek továbbításra.
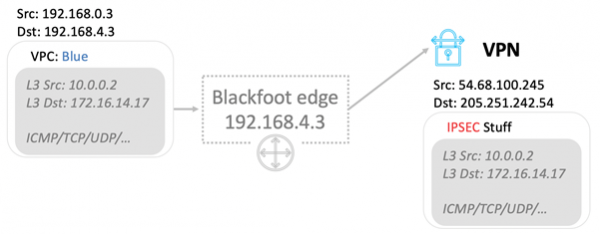
Az adatok dekapszulázódnak és ismét IPsec burkolatba kerülnek VPN használatakor.
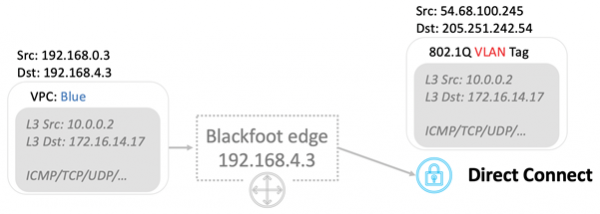
A Direct Connect használatakor a forgalom címkézve van és a megfelelő VLAN-ba került továbbításra.
HyperPlane
Ez egy belső forgalomkezelő szolgáltatás. Sok hálózati szolgáltatás megköveteli a forgalom állapotának ellenőrzését. Például NAT használatakor a forgalomkezelésnek garantálnia kell, hogy minden „IP: célport” párhoz egyedi kimenő port tartozik. A terheléselosztónál NLB — Hálózati Terheléselosztó, az adatforgalomnak mindig ugyanazon cél virtuális gépre kell irányulnia. A Security Groups egy állapotmegőrző tűzfalszolgáltatás. Figyelemmel kíséri a bejövő forgalmat, és implicit módon megnyitja a portokat az kimenő csomagáramlás számára.
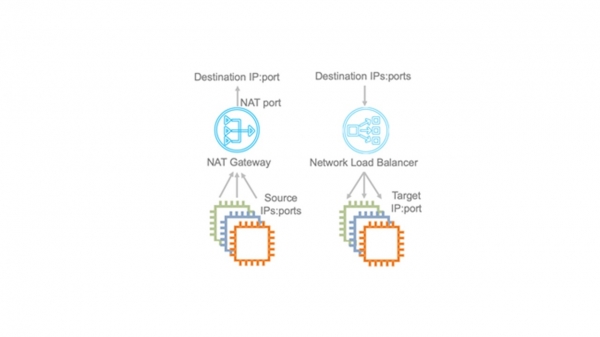
Az AWS felhőben a késleltetési követelmények rendkívül magasak. Ezért HyperPlane kritikus a teljes hálózat működőképessége szempontjából.
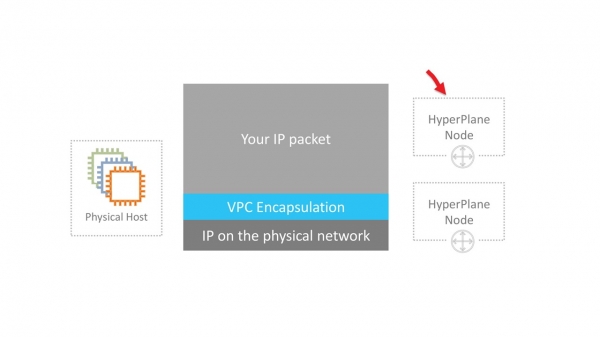
A Hyperplane EC2 virtuális gépeken épül. Itt semmiféle varázslat nincsen, csak ügyesség. Az ügyesség abban rejlik, hogy ezek virtuális gépek nagy RAM-mal rendelkeznek. A tranzakciós műveletek kizárólag a memóriában zajlanak. Ez lehetővé teszi, hogy a késleltetés mindössze néhány mikrosecond legyen. A lemezműveletek teljesen megölhetnék a teljesítményt.
A Hyperplane egy elosztott rendszer, amely hatalmas számú ilyen EC2 gépből áll. Minden virtuális gép 5 GB/s sávszélességgel rendelkezik. A teljes regionális hálózaton ez őrületes terabites sávszélességet biztosít és lehetővé teszi, hogy millió kapcsolatot kezeljünk másodpercenként.
A HyperPlane csak folyamokkal működik. A VPC csomagok kapszulázása számára teljesen átlátható. Az ebben a belső szolgáltatásban lévő potenciális sebezhetőség nem engedi meg a VPC elszigeteltségének áttörését. A biztonságért az alacsonyabb szintek felelnek.
Zajos szomszéd
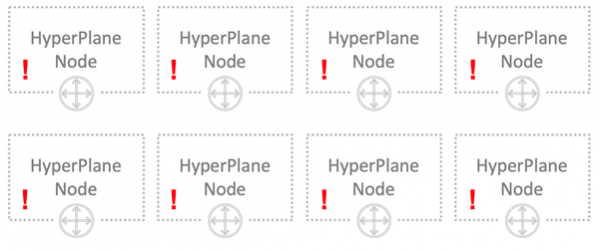
Van egy másik probléma zajos szomszéd — noisy neighbor. Tegyük fel, hogy 8 csomópontunk van. Ezek a csomópontok a felhő összes felhasználójának folyamatait kezelik. Úgy tűnik, minden rendben van, és a terhelés egyenletesen oszlik el az összes csomóponton. A csomópontok nagyon erősek, és nehéz őket túlterhelni.
De mi a legvalószínűtlenebb forgatókönyvekből is építjük az architektúránkat.
Alacsony valószínűség nem jelenti a lehetetlenséget.
Képzeljünk el egy olyan helyzetet, ahol egy vagy több felhasználó túl nagy terhelést generál. Ennek a terhelésnek a feldolgozásában részt vesznek a HyperPlane összes csomópontja, és más felhasználók esetleg érezhetnek némi teljesítménycsökkenést. Ez megbontja a felhő koncepcióját, ahol a bérlők nem befolyásolják egymást.
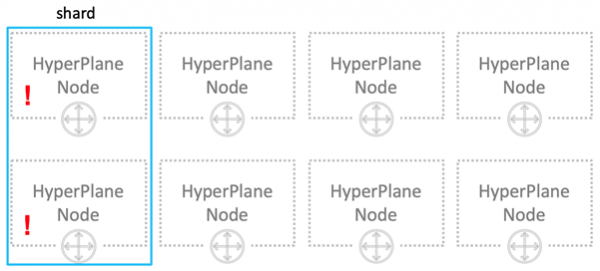
Hogyan oldható meg a zajos szomszéd problémája? Az első dolog, ami eszébe jut, a shardolás. A nyolc csomópontunk logikailag négy shardra oszlik, kettő csomóponttal minden shardban. Most a zajos szomszéd csak a felhasználók negyedét zavarja, de nagyon erősen.
Csináljunk valami mást. Minden felhasználónak csak három csomópontot adunk.
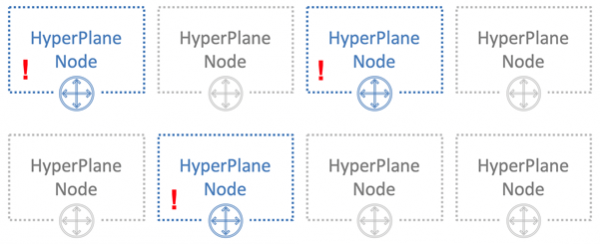
A trükk az, hogy a csomópontokat véletlenszerűen rendeljük különböző felhasználókhoz. Az alábbi képen a kék felhasználó egyik csomóponton átnyúlik a két másik felhasználóval — a zölddel és a narancssárgával.
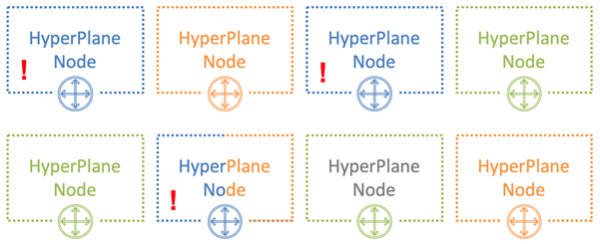
Nyolc csomópont és három felhasználó esetén a zajos szomszéd átfedésének valószínűsége az egyik felhasználóval 54%. A kék felhasználó ennyire hat a többi bérlőre. Ebben az esetben csak a terhelésének egy részével. Példánkban ez a hatás nem mindenki számára lesz észlelhető, csak a felhasználók egyharmadának. Ez már nem rossz eredmény.
Az átfedésben lévő felhasználók száma
Valószínűség százalékban
0
18%
1
54%
2
26%
3
2%
Hozzuk a helyzetet közelebb a valósághoz — vegyünk 100 csomópontot és 5 felhasználót 5 csomóponton. Ebben az esetben egyetlen csomópont sem ütközik, 77% valószínűséggel.
Az átfedésben lévő felhasználók száma
Valószínűség százalékban
0
77%
1
21%
2
1,8%
3
0,06%
4
0,0006%
5
0,00000013%
Valós helyzetben óriási számú HyperPlane csomópont és felhasználó mellett a zajos szomszéd potenciális hatása a többi felhasználóra minimális. Ezt a módszert hívják shardolásos keverés — shuffle sharding. Minimálisra csökkenti a csomópontok meghibásodásának negatív hatását.
A HyperPlane alapján számos szolgáltatás épült: Hálózati Terheléselosztó, NAT Gateway, Amazon EFS, AWS PrivateLink, AWS Transit Gateway.
A hálózat mérete
Most beszéljünk a hálózat méreteiről. 2019 októbere óta az AWS a következő szolgáltatásokat kínálja 22 régióban, és még 9 van tervezés alatt.
- Minden régió több elérhetőségi zónát tartalmaz - Availability Zone. Összesen 69 van világszerte.
- Minden AZ adatközpontokból áll. Ezek száma legfeljebb 8 lehet.
- Az adatközpontban óriási számú szerver található, egyesekben akár 300 000 is.
Most mindezt átlagoljuk, megszorozzuk, és kapunk egy imponáló számot, amely tükrözi az Amazon felhő méretét.
Az elérhetőségi zónák és az adatközpontok között sok optikai csatorna van kiépítve. Egyik legnagyobb régiónkban 388 csatorna van csak az AZ-k közötti kapcsolatra és a más régiókkal való kapcsolatra (Transit Centers). Ez összesen hihetetlen 5000 Tbit.
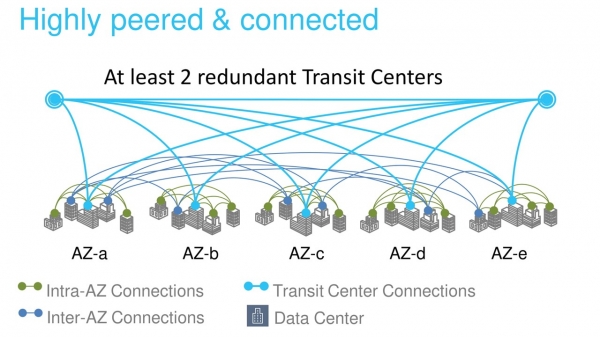
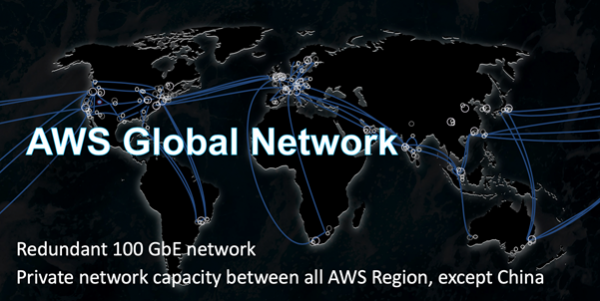
Az AWS gerinchálózata kifejezetten a felhő számára készült, és arra optimalizálták. A csatornáinkat 100 Gbit/s. Ezeket teljes mértékben ellenőrizzük, kivéve a kínai régiókat. A forgalom nem oszlik meg más cégek terhelésével.
Természetesen nem mi vagyunk az egyetlen felhőszolgáltató, aki magán gerinc hálózattal rendelkezik. Egyre több nagyvállalat követi ezt az utat. Ezt független kutatók megerősítik, mint például a .
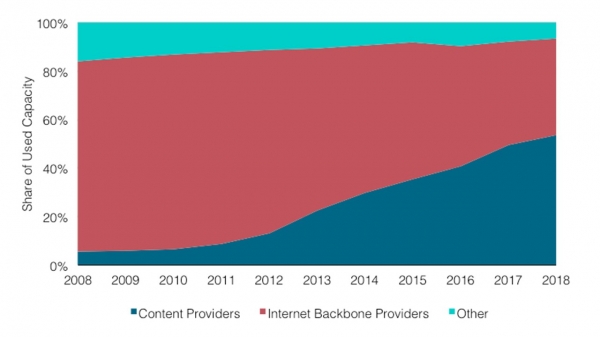
A grafikonon látható, hogy a tartalomszolgáltatók és felhőszolgáltatók részesedése növekszik. Ennek következtében a gerinchálózati szolgáltatók részesedése folyamatosan csökken.
Megmagyarázom, miért történik ez. Korábban a legtöbb webszolgáltatás közvetlenül az Internetről volt elérhető és használt. Most egyre több szerver található a felhőben, és elérhetők a -szolgáltató). Ők figyelik a — Content Distribution Network. A felhasználó az erőforráshoz az Interneten keresztül csak a legközelebbi CDN PoP-ig megy - Point of Presence. Leggyakrabban ez valahol közel van. Ezt követően elhagyja a nyilvános Internetet és egy privát gerincen keresztül repül az Atlanti-óceánon, például, és közvetlenül eljut az erőforráshoz.
Érdekes, hogyan változik az Internet 10 év múlva, ha ez a tendencia megmarad?
Fizikai csatornák
A tudósok még nem találták ki, hogyan lehetne növelni a fény sebességét az univerzumban, de jelentős előrelépést tettek a fény száloptikai átvitelének módszereiben. Jelenleg 6912 szálas kábeleket használunk. Ez jelentősen segít optimalizálni a telepítés költségeit.
Néhány régióban különleges kábeleket kell használnunk. Például Sydney térségében kifejezetten termoszfúrók ellen védett kábeleket alkalmazunk.
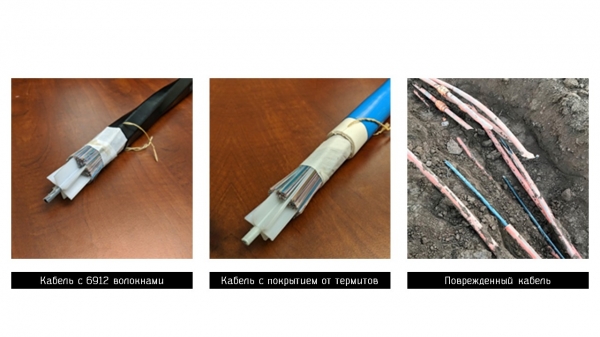
Senki sem biztosítja, hogy elkerülje a bajokat, és néha a csatornáink megsérülnek. A jobb oldali képen egy amerikai régió optikai kábelei láthatók, amelyeket építők vágtak át. Az incidens következtében mindössze 13 adatcsomag veszett el, ami elképesztő. Még egyszer – mindössze 13! A rendszer gyakorlatilag azonnal átkapcsolt a tartalék csatornákra — ez a méretezés működik.
Gyorsan áttekintettük az Amazon felhős szolgáltatásait és technológiáit. Remélem, hogy legalább egy kis áttekintést nyertetek arról a mértékű feladatokról, amelyeket mérnökeinknek meg kell oldaniuk. Személy szerint engem ez nagyon lelkesít.
Ez Vaszilij Pantyuhin trilógiájának végső része az AWS felépítéséről. Az részben a szerverek optimalizálása és az adatbázis méretezése, míg a második részben a szerver nélküli funkciók és a Firecracker szerepelnek.
Ezen Novemberben Vaszilij Pantyuhin megoszt új részleteket az Amazon felépítéséről. Ő az Amazon rendszereiben tapasztalható leállások okairól és a elosztott rendszerek tervezéséről. Október 24-ig még lehet jegyet jó áron vásárolni, és később fizetni. Várunk titeket a HighLoad++-on, gyertek — beszélgessünk!
Forrás: habr.com
