

Kezdjük egy kis elmélettel. Mi az ?
Egyszerű szavakkal, ez egy dokumentum, amely célja a SaaS alkalmazások fejlesztésének megkönnyítése, segítve a fejlesztőket és DevOps mérnököket azokon a problémákon és gyakorlatokon keresztül, amelyek a modern alkalmazások fejlesztése során a leggyakrabban előfordulnak.
A dokumentumot a Heroku platform fejlesztői alakították ki.
A tizenkét faktor módszertan (The Twelve-Factor App) alkalmazható bármilyen programozási nyelven írt alkalmazásokra, és bármilyen harmadik féltől származó szolgáltatásokkal (backing services) együtt (adatbázisok, üzenetküldő sorok, gyorsítótárak stb.).
Röviden azokról a faktorról, amelyekre ez a módszertan épül:
- Kódalap – Egy kódalap, amelyet verziókezelő rendszerben követnek – több telepítés
- Függőségek – Különítse el világosan a függőségeket
- Konfiguráció – Tartsa fenn a konfigurációt a futási környezetben
- Harmadik féltől származó szolgáltatások (Backing Services) – Tekintse a harmadik féltől származó szolgáltatásokat (backing services) csatolható erőforrásoknak
- Összeállítás, kiadás, végrehajtás – Szigorúan válassza el az összeállítási és a végrehajtási lépéseket
- Folyamatok – Indítson el egy alkalmazást egy vagy több állapot nélküli (stateless) folyamatban
- Port bindelés (Port binding) – Exportálja a szolgáltatásokat port bindeléssel
- Párhuzamosság – Skálázza az alkalmazást folyamatok segítségével
- Elérhetőség (Disposability) – Maximalizálja a megbízhatóságot gyors indítással és helyes leállítással
- Fejlesztési/termelési környezet paritás – Tartsa a fejlesztési, staging és production környezeteket a lehető legjobban hasonlón
- Naplózás (Logs) – Tekintse a naplót események áramlásának
- Adminisztrációs feladatok – Végezze el az adminisztrációs/működtetési feladatokat egyszeri folyamatokkal
További információkat a 12 faktorról az alábbi forrásokból szerezhet:
- — kötelező olvasmány
- — hivatalos fordítás
- — friss nézőpont a 12 faktorra a tökéletesítés céljából.
Mi az a Blue-Green deployment?
A Blue-Green deployment egy módszer az alkalmazás szállítására. production így, hogy a végfelhasználó semmilyen változást nem észlel. Más szavakkal, a nulla downtime-os alkalmazás telepítése leállás.
A klasszikus BG Deploy schéma az alábbi ábrán látható.

- Kezdéskor két fizikai szerver van, abszolút azonos kóddal, alkalmazással, projekttel, és van egy router (terheléselosztó).
- A router eredetileg minden kérést az egyik szerverre irányít (alpha).
- Amikor újra el kell végezni a kiadást, az egész projekt frissül egy másik szerveren (kék), amely éppen nem dolgozik fel semmilyen kérést.
- Miután a kód a kék szerveren teljesen frissült, a router utasítást kap arra, hogy váltson zöld Gyorsan emlékezzünk vissza, hogyan működik a moduláris aritmetika. Az óra már egy ismert koncepció. Az órák használata kék szerver figyel.
- Most minden ügyfél látja a kód működésének eredményét a kék szervereket.
- Egy ideig a alpha szerver tartaléként szolgál egy rossz telepítés esetére a kék szerverre, és ha hiba merül fel, a router visszakapcsolja a felhasználói forgalmat a alpha régi stabil verzióval rendelkező szerverre, a új kódot pedig javításra és tesztelésre küldjük.
- A folyamat végén a alpha szerver is hasonlóan frissül. És miután ez frissült, a router visszakapcsolja a kérések árát a alpha szerver figyel.
Ez nagyon jól néz ki, és első pillantásra nem kellene, hogy legyen vele probléma.
De mivel a modern világban élünk, a klasszikus sémában említett fizikai váltás nem megfelelő számunkra. Az információt addig őrizzük meg, később visszatérünk rá.
Rosszul és jól megfogalmazott tanácsok
Megjegyzés: Az alábbi példákban azokat az eszközöket/módszereket sorolom fel, amelyeket én használok, Ön pedig bármilyen hasonló funkcióval rendelkező alternatívát használhat.
A legtöbb példa valamilyen módon a webfejlesztéssel (micsoda meglepetés), PHP-val és Dockerrel fog foglalkozni.
Az alábbi pontokban egyszerű gyakorlati leírás található bizonyos példák felhasználásával, ha Ön többlet elméletet szeretne erről a témáról, forduljon a fenti hivatkozásokhoz az eredeti forráshoz.
1. Kódalap
Használjon FTP-t és FileZillát, fájlokat feltöltve a szerverre egyesével, ne tároljon kódot sehol, csak a production szerveren.
A projektben mindig egységes kódalapnak kell lennie, azaz az összes kód egy forrásból származik. Konténerizálás A tároló. A szerverek (production, staging, test1, test2 …) egy közös tároló ágainak kódját használják. Így biztosítjuk a kód konzisztenciáját.
2. Függőségek
Töltsd le az összes könyvtárat közvetlenül a projekt gyökérkönyvtárába. A frissítéseket egyszerűen új kód átmozgatásával végezd a könyvtár aktuális verziójába. Az összes szükséges segédprogramot telepítsd közvetlenül arra a hosztszerverre, ahol már 20 szolgáltatás fut.
A projektnek mindig érthető függőségi listával kell rendelkeznie (a függőségek alatt a környezetet is értem). Minden függőséget világosan kell definiálni és elkülöníteni.
Példaként vegyük Composer és Docker.
Composer — egy csomagkezelőt, amely lehetővé teszi PHP könyvtárak telepítését. A Composer lehetővé teszi a verziók szigorú vagy nem szigorú meghatározását, és azok egyértelmű definiálását. A szerveren 20 különböző projekt lehet, mindegyik saját csomag- és könyvtárlistával, amely nem függ a többiektől.
Docker — egy segédprogram, amely lehetővé teszi a környezet meghatározását és izolálását, ahol az alkalmazás fog működni. Így, akárcsak a composer esetében, de már alaposabban, meghatározhatjuk, hogy mivel dolgozik az alkalmazás. Kiválaszthatjuk a megfelelő PHP verziót, telepíthetjük csak a projekt működéséhez szükséges csomagokat, anélkül, hogy bármi felesleges kerüljön be. A legfontosabb, hogy ne érintkezzünk a hosztszerver és más projektek csomagjaival és környezetével. Tehát az összes Docker-en futó projekt a szerveren bármilyen csomagkészletet és teljesen eltérő környezetet használhat.
3. Konfiguráció
A konfigurációkat tárolja konstansokként közvetlenül a kódban. Külön konstansok a tesztszerver számára, külön a produkcióhoz. Kösse össze az alkalmazás működését a környezettől függően közvetlenül a projekt üzleti logikájában, if else konstrukciót használva.
Konfigurációk — ez az egyetlen dolog, amivel a projekt telepítései (deployment) különböznek. Ideálisan a konfigurációknak környezeti változókon (env vars) keresztül kellene érkezniük.
Tehát még ha több konfigurációs fájlt is tárol, mint például .config.prod, .config.local, és ezeket átnevezi a telepítés pillanatában .config-ra (aminek alapértelmezett konfiguráció, amelyből az alkalmazás olvassa az adatokat) - ez nem lesz helyes megközelítés, mert ebben az esetben a konfigurációs információk minden fejlesztő számára hozzáférhetők lesznek, és a produkciós szerver adatai veszélybe kerülnek. Minden konfigurációnak közvetlenül a telepítési rendszerben (CI/CD) kell tárolódnia, és a telepítés pillanatában, az adott környezethez szükséges különböző értékekkel kell generálni.
4. Harmadik féltől származó szolgáltatások (Backing Services)
Szorosan kössön az környezethez, használjon különböző kapcsolatokat ugyanazon szolgáltatásokhoz különböző környezetekben.
Valójában ez a pont erősen átfedi az előző ponttal a konfigurációkról, mivel enélkül nem lehet megfelelő konfigurációs adatokat létrehozni, és az egész konfigurálási lehetőség meghiúsul.
Minden kapcsolat a külső szolgáltatásokkal, mint például a sorok szerverei, adatbázisok, gyorsítótár-szolgáltatások, ugyanazok legyenek mind a helyi, mind a külső / produkciós környezetben. Más szavakkal, bármikor megváltoztathatom a kapcsolat sztringet, hogy az #1 adatbázis helyett a #2 adatbázisra hivatkozzon, anélkül, hogy az alkalmazás kódját meg kellene változtatni. Vagy előreugorva, például ha a szolgáltatást skálázza, nem kell különleges módon megadnia a csatlakozást egy extra gyorsítótár-szerverhez.
5. Összeállítás, kiadás, végrehajtás
Csak a kész kód végleges verzióját tárolja a szerveren, anélkül, hogy vissza lehetne állítani a kiadást. Ne töltse ki a lemezterületet. Aki azt gondolja, hogy hibás kódot vihet a produkcióba, az rossz programozó!
Minden telepítési szakasznak külön kell lennie.
Legyen lehetősége visszalépni. Készítsen kiadásokat úgy, hogy gyorsan hozzáférhető régi másolatai legyenek az alkalmazásnak (már összeszerelt és harcra kész), hogy hiba esetén vissza tudja állítani a régi verziót. Tehát van egy mappája, releases és egy mappa, – áram, és a sikeres telepítés és összeállítás után a mappa – áram szimbolikus hivatkozással kapcsolódik az új kiadáshoz, amely belül található. releases egy feltételezett kiadási szám.
Itt jön szóba a Blue-Green deploy, amely nemcsak a kódok közötti váltást, hanem az összes erőforrás és környezet közötti váltást is lehetővé teszi, lehetőséget adva arra, hogy mindent visszafordítsunk.
6. Folyamatok
Tartsa az alkalmazás állapotainak adatait magában az alkalmazásban. Használja a memória alapú munkameneteket. Használjon minél több, harmadik felek által megosztott erőforrást. Legyenek az alkalmazásnak csak egyszeri folyamatai, és ne engedje meg a skálázást.
A munkamenetekhez tárolja az adatokat csak a harmadik felek által ellenőrzött gyorsítótárban (memcached, redis), így még ha 20 alkalmazásfolyamat is működik, bármelyik képes a gyorsítótár elérésével folytatni a munkát az ügyféllel abban az állapotban, amelyben a felhasználó a másik folyamatban dolgozott. Ilyen megközelítéssel, bármennyi harmadik féltől származó szolgáltatást is használjon, minden simán és problémamentesen fog működni az adatok elérésével.
7. Portkötés (Port binding)
Csak a webszervernek kell tudnia, hogyan működjön együtt a harmadik felekkel. A legjobb, ha a harmadik felek szolgáltatásait közvetlenül a webszerveren belül indítja el. Például PHP modul formájában az Apache-ban.
Minden szolgáltatásnak elérhetőnek kell lennie egymás számára valamilyen cím és port elérésén keresztül (localgost:5432, localhost:3000, nginx:80, php-fpm:9000), azaz az nginx-ből elérhetem a php-fpm-t és a postgres-t is, a php-fpm-ből a postgres-t és az nginx-et, és tulajdonképpen minden szolgáltatásból elérhetem a másikat. Így a szolgáltatás életerejének nem kell más szolgáltatás életerejéhez kötődnie.
8. Párhuzamosság
Dolgozzon egyetlen folyamattal, mert ha több folyamat együtt nem tud együttműködni!
Hagyjon lehetőséget a skálázásra. Erre tökéletes megoldás a Docker Swarm.
A Docker Swarm egy eszköz a konténer klaszterek létrehozására és kezelésére, akár különböző gépek között, akár sok konténer egy gépen.
A swarm allows me to determine how many resources I will allocate to each process and how many instances of the same service I will run. The internal load balancer, receiving data on a designated port, will automatically proxy it to the processes. Thus, seeing that the server load has increased, I can add more processes, thereby reducing the load on specific processes.
9. Eldobhatóság (Disposability)
Ne használj sorokat a folyamatokkal és adatokkal való munkához. Egy folyamat megölésének hatással kell lennie az egész alkalmazás működésére. Ha egy szolgáltatás leállt, minden leáll.
Minden folyamat és szolgáltatás bármikor leállítható, és ez nem befolyásolhatja a többi szolgáltatást (itt nem arról van szó, hogy egy szolgáltatás nem lesz elérhető egy másik számára, hanem arról, hogy a másik szolgáltatás nem áll le ennek következtében). Minden folyamatnak simán kell befejeződnie, úgy, hogy a befejezésük során az adatok ne sérüljenek, és a következő indításkor a rendszer helyesen működjön. Tehát még vészhelyzeti leállás esetén is, az adatoknak nem szabad sérülniük (ehhez tranzakciós mechanizmusok, a DB-hez küldött lekérdezések csoportokban működnek, és ha egy csoport bármelyik lekérdezése nem teljesült vagy hibával zárult, akkor a csoport többi lekérdezése sem fog végül végbemenni).
10. Fejlesztési/alkalmazási paritás
A termelési, staging és helyi alkalmazásverzióknak különbözőnek kell lenniük. A termelésben mi a Yii Lite keretrendszert használjuk, helyben pedig a Yii-t, hogy a termelési rendszer gyorsabban működjön!
Valójában minden alkalmazás kódjának telepítése és kezelése legalábbis azonos környezetben kell, hogy történjen (itt nem a fizikai hardverről van szó). A kódot a termelésben bármely fejlesztőnek képesnek kell lennie telepíteni, nem pedig valamilyen különösen képzett devops csapatnak, amely csak a különleges erő által képes elindítani az alkalmazást a termelési környezetben.
Ebben is segít a Docker. Az összes korábbi pont betartása mellett a Docker használata a telepítési folyamatot a production és a helyi gép között egy-két parancs beírására redukálja.
11. Naplózás (Logs)
A naplókat fájlokba és adatbázisokba írjuk! A naplókat nem tisztítjuk a fájlokból és az adatbázisokból. Csak vásárolunk egy 9000 petabájt kapacitású merevlemezt, és kész.
Minden naplót eseményfolyamként kell kezelni. Magának az alkalmazásnak nem szabad naplók feldolgozásával foglalkoznia. A naplókat vagy stdout-ra kell kiadni, vagy olyan protokollon, mint az udp, hogy az alkalmazás számára a naplókkal való munka ne okozzon problémát. Erre a graylog jól megfelel. A graylog, amely fogadja az összes naplót udp-n (ez a protokoll nem igényel válasz várakozást a csomag sikeres átvételéről), semmilyen módon nem zavarja az alkalmazást, és csak a naplók strukturálásával és feldolgozásával foglalkozik. Az alkalmazás logikája nem változik az ilyen megközelítések esetén.
12. Adminisztrációs feladatok
Az adatok, adatbázis stb. frissítéséhez használjon külön készített végpontot az API-ban, amelynek végrehajtása kétszer egymás után azt eredményezi, hogy mindent megdupláz. De ti nem vagytok hülyék, nem kattintotok rá kétszer, és a migrációk nekünk nem kellenek.
Minden adminisztrációs feladatot ugyanabban a környezetben kell végrehajtani, mint az összes kód, a kiadási szinten. Tehát, ha az adatbázis szerkezetét meg kell változtatnunk, akkor nem fogjuk ezt kézzel elvégezni az oszlopnevek megváltoztatásával és új oszlopok hozzáadásával valamilyen vizuális adatbázis-kezelő eszközzel. Az ilyen dolgokra külön szkripteket — migrációkat — hozunk létre, amelyek mindenhol és minden környezetben azonos és áttekinthető eredményt adnak. Minden egyéb feladat, például a projekt adatainak feltöltése, hasonló módszereket kell alkalmazni.
Példa megvalósítás PHP, Laravel, Laradock, Docker-Compose használatával
P.S Minden példa MacOS-en készült. A legtöbb Linux alatt is működik. Windows felhasználóknak elnézést, de régóta nem használtam Windows-t.
Képzeljük el, hogy a PC-n semmilyen PHP verzió nincs telepítve, és valójában semmi sincs.
Telepítjük a legújabb docker-t és docker-compose-t. (ezt az interneten meg lehet találni)
docker -v &&
docker-compose -v
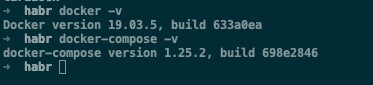
1. Telepítjük
git clone https://github.com/Laradock/laradock.git &&
ls
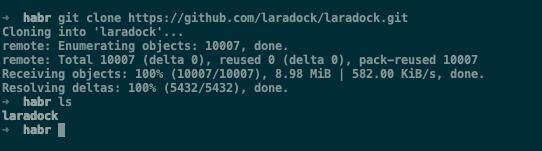
A Laradockról azt mondhatom, hogy ez egy nagyon klassz dolog, amelyben nagyon sok konténer és segédprogram található. De a Laradockot úgy használni, ahogy van, production környezetben — nem ajánlanám a túlzott mivolta miatt. Jobb saját konténereket létrehozni a Laradock példái alapján, így többet lehet optimalizálni, mert senkinek sem szükséges egyszerre mindaz, ami ott található.
2. Konfiguráljuk a Laradockot az alkalmazásunk működéséhez.
cd laradock &&
cp env-example .env
2.1. Nyissuk meg a habr könyvtárat (a szülőmappa, ahová a laradock klónozva lett) bármilyen szerkesztőben. (Az én esetemben PHPStorm)
Ebben a lépésben csak a projekt nevét adjuk meg.
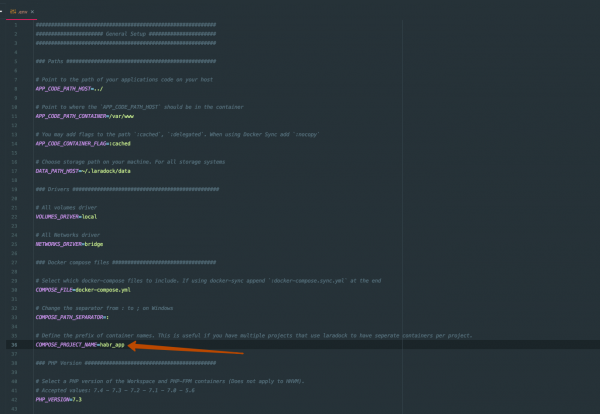
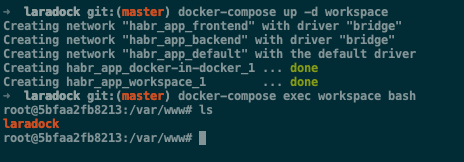
2.2. Indítsuk el a workspace képet. (Az Ön esetében a képek egy ideig épülnek majd)
A workspace - ez egy különlegesen előkészített kép a keretrendszer fejlesztői nevében történő használatra.
Lépjünk be a konténerbe a következő paranccsal:
docker-compose up -d workspace &&
docker-compose exec workspace bash
2.3. Telepítsük a Laravel-t
composer create-project --prefer-dist laravel/laravel application 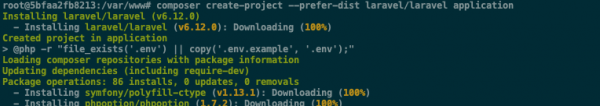
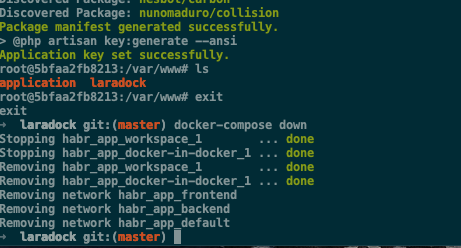
2.4. Telepítés után ellenőrizzük, hogy létrejött-e a projekt könyvtár, majd leállítjuk a compose-t.
ls
exit
docker-compose down
2.5. Térjünk vissza a PHPStorm-ba, és állítsuk be a megfelelő utat a laravel alkalmazásunkhoz a .env fájlban.
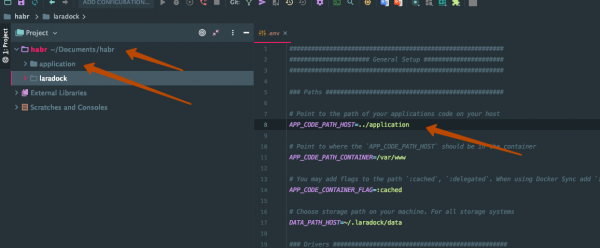
3. Adjunk hozzá valamennyi kódot a Git-hez.
Ehhez hozzunk létre egy tárolót a Github-on (vagy máshol). Navigáljunk a habr könyvtárba a terminálban, és futtassuk a következő parancsot.
echo "# habr-12factor" >> README.md
git init
git add README.md
git commit -m "első elkötelezés"
git remote add origin git@github.com:nzulfigarov/habr-12factor.git # itt lesz a repónk linkje
git push -u origin master
git status
Ellenőrizzük, hogy minden rendben van-e.
Kérem, hogy az egyszerűség kedvéért használjon valamilyen vizuális Git interfészt, az én esetemben ez . (itt található egy ajánló link)
4. Indítsuk el!
Indítás előtt győződjön meg arról, hogy a 80-as és 443-as portokon nincs semmi.
docker-compose up -d nginx php-fpm 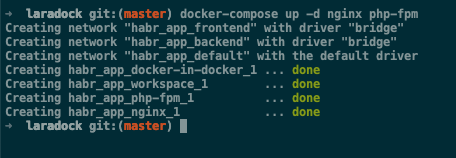
Így a projektünk 3 külön szolgáltatásból áll:
- nginx - web szerver
- php-fpm - php a web szerverrel való kérések megválaszolására
- workspace - php a fejlesztő számára
Jelenleg elértük, hogy létrehoztunk egy alkalmazást, amely már 4 pontnak felel meg a 12 közül, nevezetesen:
1. Kódalap — az összes kód egy tárolóban található (kicsi megjegyzés: lehet, hogy helyesebb lenne a dockert a laravel projektbe helyezni, de ez nem alapvető kérdés).
2. Függőségek — Minden függőségünk világosan fel van tüntetve az application/composer.json fájlban és minden konténer Dockerfile-jában.
3. Harmadik féltől származó szolgáltatások (Backing Services) — Minden szolgáltatás (php-fpm, nginx, workspace) a saját életét éli, és kívülről csatlakozik, és ha az egyik szolgáltatással dolgozunk, a másik nincs hatással.
4. Folyamatok — minden szolgáltatás egy folyamatot jelent. Minden szolgáltatás nem őriz belső állapotot.
5. Port bindelés (Port binding)
docker ps
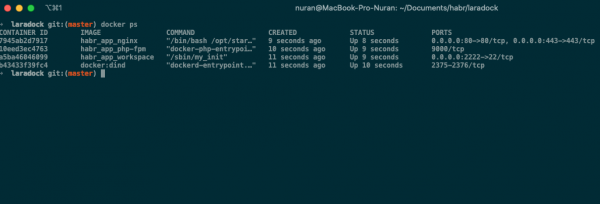
Ahogy látjuk, minden szolgáltatás a saját portján fut, és elérhető a többi szolgáltatás számára.
6. Párhuzamosság
A Docker lehetővé teszi, hogy több azonos szolgáltatás folyamatát indítsuk el automatikusan terheléselosztással közöttük.
Állítsuk le a konténereket, és indítsuk el őket a zászló használatával —scale
docker-compose down &&
docker-compose up -d --scale php-fpm=3 nginx php-fpm
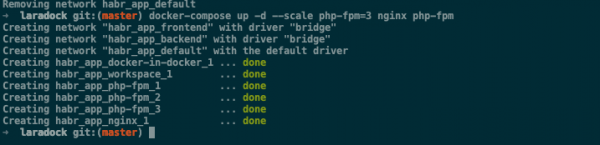
Ahogy látjuk, a php-fpm konténer példányai jöttek létre. Ezen a konténeren a munkánk során semmit sem kell megváltoztatnunk. Továbbra is a 9000-es porton hivatkozunk rá, és a Docker kezeli velünk a terhelést a konténerek között.
7. Elérhetőség (Disposability) — minden konténert külön-külön le lehet állítani anélkül, hogy a másikra káros hatással lenne. A konténer leállítása vagy újraindítása semmilyen hatással nincs az alkalmazásra a következő indítások során. Minden konténer bármikor újraindítható.
8. Fejlesztési/termelési környezet paritás — minden környezetünk azonos. Ha a rendszert a szerveren élesben futtatod, nem lesz szükséged semmire az utasításaidban. Minden pontosan úgy fog működni, ahogy a Docker alapjául szolgál.
9. Naplózás (Logs) — minden napló a konténerekben folyamatban van, és látható a Docker konzolban. (ebben az esetben, valójában, más házi készítésű konténerekkel lehet, hogy ez nem így van, ha nem gondoskodsz erről)
docker-compose logs -f 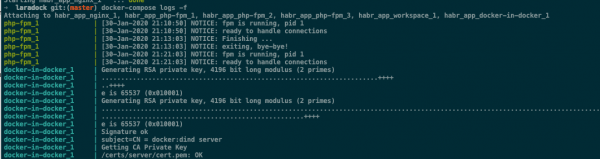
De itt van a bökkenő, hogy az alapértelmezett értékek a PHP-ban és az Nginxben is naplókat írnak fájlba. A 12 elvnek megfelelően szükséges kikapcsolni a naplókat külön fájlokba irányítani minden egyes konténer konfigurációjában.
A Docker lehetőséget ad arra is, hogy a naplókat ne csak stdoutra küldjük, hanem olyan dolgokba is, mint a graylog, amiről már beszéltem. A graylogon belül a naplókkal szabadon manipulálhatunk, és az alkalmazásunk ezt észre sem veszi.
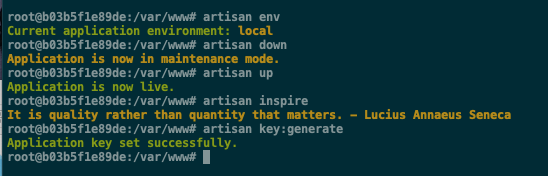
10. Adminisztrációs feladatok — minden adminisztrációs feladatot a laravel megold az artisan eszköz segítségével, éppen úgy, ahogy a 12 elvű alkalmazás készítői szerették volna.
Példaként bemutatom, hogyan hajthatók végre egyes parancsok.
Lépjünk be a konténerbe.
docker-compose exec workspace bash
php artisan list

Most bármilyen parancsot használhatunk. (Vegyétek figyelembe, hogy nem állítottuk be az adatbázist és a gyorsítótárat, így sok parancs nem fog megfelelően működni, mivel azok a gyorsítótárral és az adatbázissal való munkára készültek.)
11. Konfigurációk és 12. Összeállítás, kiadás, végrehajtás
Ezt a részt a Blue-Green Deploymentnek szenteltem volna, de ez túl kiterjedtnek bizonyult ehhez a cikkhez. Erről külön írok majd egy cikket.
Röviden, a koncepció CI/CD rendszereken alapul, mint például Jenkins és Felhőplatformok. Mindkettőben lehet környezeti változókat megadni, amelyek egy adott környezettel kapcsolatosak. Ennek megfelelően ezen a környezeti felosztás alapján kerül végrehajtásra a Konfigurációk.
A rész, ami Összeállítás, kiadás, végrehajtás megoldásokat a két eszközbe beépített funkciókkal is kezel. Pipeline.
Pipeline lehetővé teszi, hogy a telepítési folyamatot sok lépésre bontsuk, kiemelve az építési, kiadási és végrehajtási szakaszokat. A Pipelines-ben biztonsági mentéseket is készíthet, sőt, szinte bármit létrehozhat. Ez az eszköz korlátlan potenciállal rendelkezik.
Az alkalmazás kódja ezen a helyen található .
Ne feledje inicializálni a submodule-t a repozitórium klónozása során.
P.S.: Ezek a megközelítések bármilyen más eszközzel és programozási nyelvvel használhatók. A lényeg, hogy a tartalom ne változzon.
Forrás: habr.com
