

Ez a cikk azért készült, hogy segítsen kiválasztani a megfelelő megoldást, és megérteni a különbségeket a Gluster, Ceph és Vstorage (Virtuozzo) SDS-ek között.
A szöveg olyan linkeket tartalmaz, amelyek részletesebben tárgyalják a felmerülő problémákat, ezért a leírások a lehető legrövidebbek lesznek, a lényeges pontok kiemelésével, felesleges víz nélkül, és azokat az információkat, amelyeket szükséges, önállóan is megszerezheti az interneten.
Valójában a tárgyalt témák megkövetelik a szöveg tónusát, de a modern világban egyre többen nem szeretnek sokat olvasni))), ezért gyorsan átfutva meghozhatja a döntést, és ha valami nem világos, átnézheti a linkeket, vagy rákereshet a nem érthető szavakra))), ez a cikk pedig átlátszó burkoként szolgál ezekhez a mélyebb témákhoz, bemutatva a főbb kulcspontokat.
Gluster
Kezdjük a Glusterrel, amelyet aktívan használnak a hiperkonvergens platformok gyártói open source alapú SDS-sel virtuális környezetekhez, és a RedHat tárolós részlegén található, ahol két SDS lehetőség közül lehet választani: Gluster vagy Ceph.
A Gluster egy átjárók stackjéből áll - szolgáltatás, amely végez minden feladatot a fájlok elosztásával stb. A Brick - egy szolgáltatás, amely egy merevlemezt szolgál ki, Volume - a kötet (tó) - amely ezeket a brickeket egyesíti. Ezt követi a fájlok csoportok közötti elosztásáért felelő szolgáltatás a DHT (distributed hash table) funkcióval. A Sharding szolgáltatást nem fogjuk leírni, mivel az alább található linkekben a kapcsolódó problémákról lesz szó.
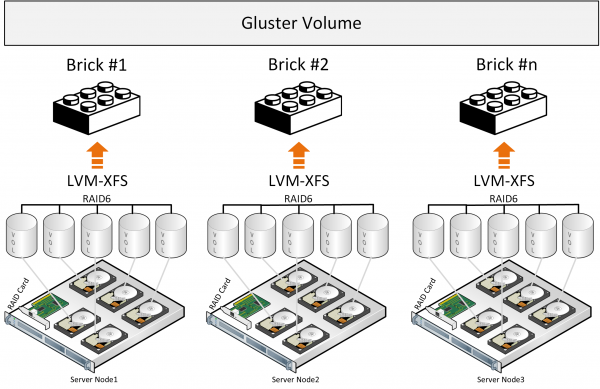
Íráskor a fájl teljes egészében a brickre kerül, és másolata párhuzamosan a második szerver brickjére is íródik. Ezután a második fájl már egy második csoportba kerül a két brick (vagy több) egyikén különböző szervereken.
Ha a fájlok körülbelül azonos méretűek, és a kötet csak egy csoportból áll, akkor minden rendben van, de más körülmények esetén a leírások alatt következő problémák merülnek fel:
- a csoportokban a hely egyenlőtlenül hasznosul, ez a fájlok méretétől függ, és ha a csoportban nincs elegendő hely a fájl írásához — hibaüzenetet kap, a fájl nem kerül írásra, és nem lesz áthelyezve egy másik csoportba;
- egy fájl írásakor az IO csak egy csoportba megy, a többi inaktív marad;
- nem lehet megszerezni a kötet összes IO-ját, ha egy fájlt írunk;
- és az általános koncepció a blokkokba történő adatelosztás hiányában kevésbé teljesítményorientáltnak tűnik, ahol könnyebb a terheléselosztás és a kiegyenlített elosztás problémájának megoldása, nem pedig úgy, ahogy most a fájl teljes mértékben egy brick-re helyezkedik.
Hivatalos leírás továbbá felmerül a felismerés, hogy a Gluster klasszikus hardver RAID felett működő fájltárolóként működik. Voltak kísérletek a fájlok blokkokra vágására (Sharding), de ez mind olyan kiegészítés, amely teljesítményveszteséget okoz a már meglévő architekturális megközelítéshez, nem beszélve arról, hogy olyan ingyenesen terjeszthető komponenseket használ, mint a Fuse, amelynek teljesítménye korlátozott. Nincsenek metaadat-szolgáltatások, ami korlátozza a tároló teljesítményének és hibatűrésének lehetőségeit a fájlok blokkokra való elosztásakor. Jobb teljesítménymutatók figyelhetők meg az „Elosztott Replikált” konfigurációban, és a csomópontok száma legalább 6 kell, hogy legyen a megbízható 3-as replikák létrehozásához optimális terheléselosztással.
Ezek a következtetések szorosan összefüggnek a használati tapasztalat leírásával , valamint a tapasztalatok leírásával, amelyek segítenek megérteni ennek a teljesítményorientáltabb és megbízhatóbb konfigurációnak a létrehozását
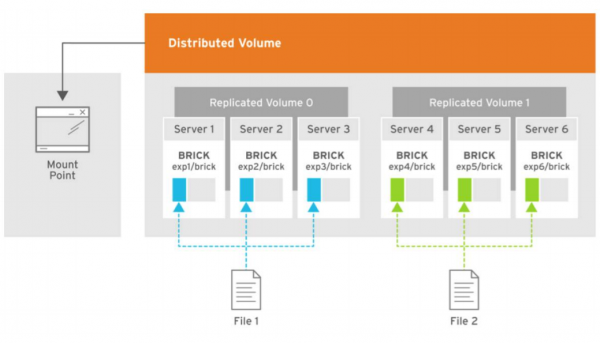
A képen a terheléselosztás látható két fájl írása során, ahol az első fájl másolatai három első szerverre oszlanak, amelyek a volume 0 csoportba tartoznak, míg a második fájl három másolatát a második volume1 csoport három szerverére helyezik. Minden szerver egy lemezt tartalmaz.
A végső következtetés az, hogy a Gluster használható, de tisztában kell lenni azzal, hogy a teljesítményben és a hibatűrésben korlátok lesznek, amelyek nehézségeket okoznak bizonyos körülmények között a hiperkonvergens megoldások esetében, ahol az erőforrásokra a virtuális környezetek számítási terheléseihez is szükség van.
Vannak bizonyos teljesítménymutatók a Glusternél, amelyeket bizonyos feltételek mellett lehet elérni, visszafogva
Ceph
Most vizsgáljuk meg a Ceph-t a rendelkezésre álló architektúrák leírása alapján, amelyeket sikerült Van egy összehasonlítás is , ahol azonnal megérthető, hogy a Ceph-et célszerű külön szervereken telepíteni, mivel a szolgáltatásai minden erőforrást igényelnek a terhelések mellett.
Architektúra Bonyolultabb, mint a Gluster, és vannak olyan szolgáltatások, mint a metainformációs szolgáltatások, de az összes komponensréteg meglehetősen összetett és nem túl rugalmas a virtualizációs megoldásokhoz. Az adatok blokkokba rendeződnek, ami teljesítmény szempontjából előnyösnek tűnik, de a rendszer minden komponens-shell teljesítményveszteséget és késleltetést tapasztalhat bizonyos terhelés és vészhelyzeti körülmények között, példa gyanánt a következő.
Az architektúra leírásából a szív a CRUSH, amely meghatározza az adatok elhelyezésének helyét. Ezután jön a PG — ez a legkomplexebb absztrakció (logikai csoport) a megértéshez. A PG-k szükségesek ahhoz, hogy a CRUSH hatékonyabb legyen. A PG fő célja az objektumok csoportosítása az erőforrás-felhasználás csökkentése, a teljesítmény növelése és a skálázhatóság javítása érdekében. Az objektumok közvetlen, egyesével történő címzése PG-k nélkül nagyon költséges lenne. Az OSD pedig minden egyes lemez számára szolgáltatás.
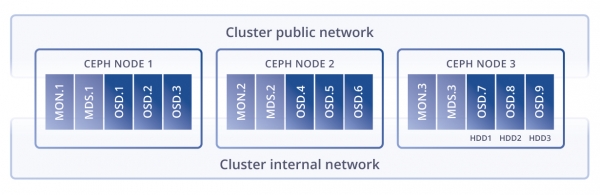
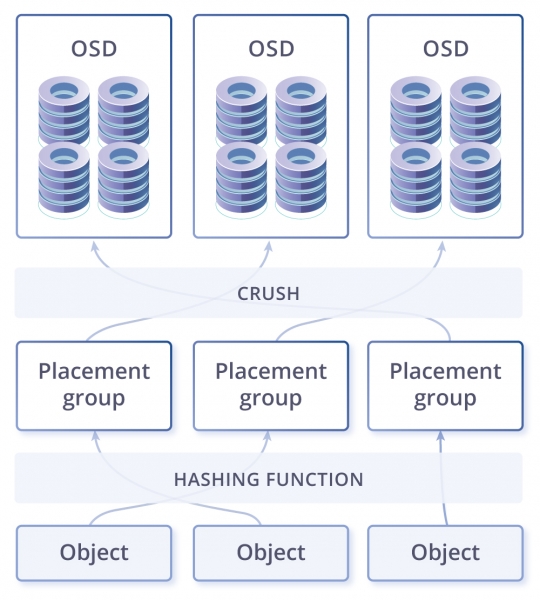
A klaszternek lehet egy vagy több, különböző célú és beállítású adatpula. A medencék elosztási csoportokra bonthatók. Az elosztási csoportokban olyan objektumok tárolódnak, amelyekhez a kliens hozzáfér. Ebből a logikai szint végéhez érkezünk, és megkezdődik a fizikai szint, mivel minden elosztási csoporthoz egy főlemez és több replikáló lemez tartozik (hogy pontosan mennyi, az a medence replikációs tényezőjétől függ). Más szavakkal, logikai szinten az objektum egy konkrét elosztási csoportban tárolódik, míg fizikai szinten a mögötte álló lemezeken. Ezek a lemezek fizikailag különböző csomópontokon vagy akár különböző adatközpontokban is találkozhatnak.
A csoportok elhelyezése ebben a sémában szükséges szintet képez a megoldás rugalmasságához, de egyben felesleges láncszemet is jelenthet, ami aggasztóan felveti a teljesítményveszteség lehetőségét. Például amikor az adatok rögzítése történik, a rendszernek ezeket a csoportokra kell felosztania, majd a fizikai szinten a fő lemezre és a replikákhoz szükséges lemezekre kell irányítania. Ezért a hash függvény működik az objektum keresése és beillesztése során, de van egy mellékhatása – ez a nagyon nagy költségek és korlátozások a hash újjáépítésénél (lemezek hozzáadása, eltávolítása során). Egy másik probléma a hash-nél, hogy az adatok elhelyezkedése nagyon rigid, ami nem változtatható. Ezért ha egy lemez túlterhelt, a rendszer nem tud más lemezre írni, a hash függvény kötelezi az adatokat a szabály alapján történő elhelyezésükre, függetlenül attól, hogy a lemez milyen állapotban van. Ezért a Ceph sok memóriát használ a PG újjáépítésekor self-healing vagy a tároló bővítése esetén. A következtetés az, hogy a Ceph jól működik (bár lassan), de csak akkor, ha nincsenek skálázási igények, vészhelyzetek és frissítések.
Természetesen vannak módszerek a teljesítmény növelésére a cache-elés és cache-tiering révén, de ehhez jó hardver szükséges, és így is veszteségek lesznek. De összességében a Ceph vonzóbbnak tűnik, mint a Gluster a produktív környezetben. Ezen termékek használatánál figyelembe kell venni egy fontos tényezőt – a magas szintű kompetenciát, tapasztalatot és szakértelmet, különös hangsúlyt fektetve a Linux-ra, mivel rendkívül fontos mindent helyesen telepíteni, konfigurálni és karbantartani, ami még nagyobb felelősséget és terhet ró az adminisztrátorra.
Vstorage
Még érdekesebbnek tűnik az architektúra a , amely együtt használható a hypervisorral ugyanazon a csomóponton, ugyanazon a , de nagyon fontos, hogy mindent helyesen konfiguráljunk a jó teljesítmény elérése érdekében. Azaz, ha egy ilyen terméket a dobozból bármilyen konfiguráción telepítünk, figyelembe véve az architektúra ajánlásait, akkor ez nagyon könnyen megvalósítható, de nem lesz hatékony.
Mi is lehet párhuzamosan a kvm-qemu hipervizor szolgáltatásai mellett, és ez csupán néhány olyan szolgáltatás, ahol egy kompakt és optimális komponens hierarchia található: ügyfélszolgáltatás FUSE-on keresztül csatlakozva (módosított, nem nyílt forráskódú), MDS (Metaadat Szolgáltatás), Chunk szolgáltatás, amely fizikailag egyetlen lemeznek felel meg, és ennél többre nincs is szükség. Sebesség tekintetében optimális a redundáns rendszer használata két replikával, de ha SSD-n történik a cache-elés és a naplózás, akkor a hibabiztos kódolás (erase coding vagy raid6) megfelelően gyorsítható hibrid rendszerben, vagy még jobban all flash környezetben. Az EC (erase coding) egyik hátránya: egy adatblokk módosítása esetén újra kell számolni a paritás összegét. Az ilyen műveletek veszteségeinek elkerülésére a Ceph az EC-t késleltetett írásban végzi, és teljesítményproblémák léphetnek fel bizonyos lekérdezések esetén, amikor például az összes blokk kiszámítása szükséges, míg a Virtuozzo Storage esetén a módosított blokkok írása a “log-structured file system” megközelítéssel történik, ami minimalizálja a paritás számítási költségeit. Az EC használatával vagy anélkül történő munka felgyorsításának lehetőségeit körülbelül megbecsülni... – a számok körülbelüliek lehetnek, az eszközgyártó pontossági tényezőjétől függően, de a számítási eredmények jól segítenek a konfiguráció megtervezésében.
Az egyszerű tárolási komponens séma nem jelenti azt, hogy ezek a komponensek ne igényeljenek de ha előre kiszámoljuk az összes költséget, akkor a hipervizorral párhuzamosan működésre lehet számítani.
Van egy összehasonlító séma a Ceph és a Virtuozzo Storage erőforrás-felhasználásáról.
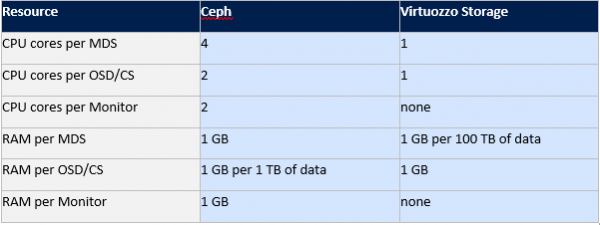
Ha korábban a Gluster és a Ceph összehasonlítása régi cikkek alapján történt a legfontosabb sorok felhasználásával, akkor a Virtuozzo esetében ez nehezebb. Ebből a termékből nem sok cikk található, és az információk csupán a dokumentációkból meríthetők, vagy oroszul, ha a Vstorage-t a néhány hiper-konvergens megoldás által használt tárolóként tekintjük olyan cégeknél, mint és Acronis.
Megpróbálok segíteni a rendszer felépítésének leírásában, ezért a szöveg valamivel hosszabb lesz. A dokumentáció megértéséhez sok idő szükséges, és a meglévő dokumentációt csak útmutatóként lehet használni a tartalomjegyzék átnézésével vagy kulcsszavas kereséssel.
Vizsgáljuk meg a hibrid hardverkonfigurációban a felvételi folyamatot a fent leírt összetevőkkel: a felvétel azon a csomóponton kezdődik, amelyről az ügyfél (FUSE beépülő szolgáltatás) kezdeményezte, de a metadátumszolgáltatás (MDS) természetesen közvetlenül a megfelelő chunk szolgáltatáshoz (blokk tároló CS szolgáltatás) irányítja az ügyfelet, tehát az MDS nem vesz részt a felvételi folyamatban, hanem egyszerűen a szükséges chunk szolgáltatáshoz irányít. Általában a felvételi folyamatot a hordókra öntés analógiájával lehet szemléltetni. Minden egyes hordó egy 256 MB-os adatblokk.
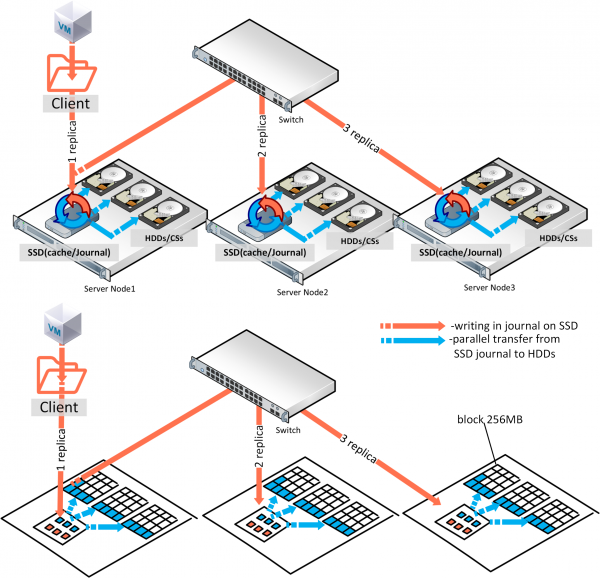
Tehát egy lemez egy bizonyos számú ilyen hordót jelent, a lemez kapacitását elosztva 256 MB-tal. Minden másolat egy csomóponton ömlik, a második párhuzamosan már egy másik csomóponton, stb… Ha három replikánk van és SSD lemezek a cache számára (olvasási és írási naplókhoz), akkor az írási megerősítés a napló SSD-re való írása után történik, míg a párhuzamos kiírás az SSD-ről HDD-re folytatódik, mintegy háttérben. Három replikánál az írási elköteleződés az SSD harmadik csomóponttól való megerősítés után történik. Úgy tűnhet, hogy a három SSD írási sebességeket össze lehet osztani hárommal, és így az egy repika írási sebességét kapjuk, de a másolatok írása párhuzamosan történik, és a hálózati késleltetés általában magasabb, mint az SSD-ék, így valójában az írási teljesítmény a hálózattól függ. Ennek következtében a valós IOPS megtekintéséhez helyesen kell terhelni az egész Vstorage-t a , vagyis a valós terhelést kell tesztelni, nem a memóriát és a cache-t, ahol figyelembe kell venni a megfelelő adatblokk méretét, a szálak számát stb.
A fenti SSD naplózási folyamat úgy működik, hogy amint adatot kap, azt azonnal beolvassa a szolgáltatás, és átcseréli a HDD-re. A metaadat-szolgáltatások (MDS) száma klaszterenként változó, amelyet a Paxos algoritmus alapján működő kvórum határoz meg. Az ügyfél szempontjából a FUSE csatolási pont egy klaszteres tároló mappa, amely egyszerre látható minden klaszternod számára, minden csomópont olyan eljárással rendelkezik, amely lehetővé teszi számukra, hogy hozzáférjenek ehhez a tárolóhoz.
Bármelyik fent említett megközelítés teljesítménye érdekében rendkívül fontos, hogy a tervezés és telepítés során a hálózatot megfelelően konfigurálják, ahol a terheléselosztás aggregációval történik, és a hálózati sávszélesség is megfelelően van megválasztva. Az aggregáción belül fontos a hash-elési mód és a keretek méretének megfelelő megválasztása. Ezen kívül van egy nagyon jelentős eltérés a fent említett SDS-től, ez a FUSE, amely a Virtuozzo Storage gyorsított úttal rendelkezik. Ez, az összes többi nyílt forráskódú megoldás mellett, jelentősen növeli az IOPS-ok számát, és lehetővé teszi a horizontális vagy vertikális skálázás korlátainak túllépését. Összességében ez az architektúra a fent említettekhez képest erősebbnek tűnik, de ezt a kényelmet licenc vásárlásához kötik, ellentétben a Ceph és Gluster esetében.
Összefoglalva elmondható, hogy a teljesítmény és megbízhatóság szempontjából az architektúrák közül az első helyet a Virtuozzo Storage, a másodikat a Ceph, és a harmadikat a Gluster foglalja el.
A Virtuozzo Storage kiválasztásának kritériumai: az architektúra optimális alkotóelemeinek készlete, a fenti megközelítéshez modernizált FUSE gyorsított úttal, rugalmas hardverkonfigurációs lehetőségek, alacsonyabb erőforrás-fogyasztás és a számítási kapacitások (virtualizáció) közös használatának lehetősége, tehát teljes mértékben alkalmas a hiperkonvergens megoldásokra, amelyek része. A második helyet a Ceph kapja, mert az blokkokkal való művelete révén, valamint rugalmasabb forgatókönyveivel és a nagyobb klaszterekben való működés lehetőségével a Gluster-nél teljesítményileg hatékonyabb architektúra.
A terveink között szerepel egy összehasonlító írás megírása a vSAN, Space Direct Storage, Vstorage és Nutanix Storage között, a Vstorage tesztelése HPE és Huawei eszközökön, valamint a Vstorage integrálása külső hardveres tárolókkal. Ha tetszett a cikk, örömmel venném az észrevételeiket, amelyek új írások motivációját erősíthetik figyelembe véve a megjegyzéseiket és kéréseiket.
Forrás: habr.com
