

Röviden: a JSONB jelentősen megkönnyítheti az adatbázis séma fejlesztését anélkül, hogy a lekérdezések teljesítménye csökkenne.
Bevezetés
Vegyünk egy klasszikus példát, valószínűleg az egyik legrégebbi felhasználási módért a relációs adatbázisok világában: van egy entitásunk, és meg kell őriznünk ennek az entitásnak bizonyos jellemzőit (attribútumait). De nem minden példány rendelkezik ugyanazzal a jellemzőkészlettel, ráadásul a jövőben új jellemzők hozzáadása is lehetséges.
A probléma leg egyszerűbb megoldása egy oszlop létrehozása az adatbázis táblájában minden egyes jellemzőért, és egyszerűen a szükséges jellemzőket kitölteni az adott entitás példányához. Szuper! A probléma megoldva… egészen addig, amíg a táblázatban nem milliárdnyi bejegyzés található, és nem merül fel az új bejegyzés hozzáadása.
Nézzük meg az EAV mintát (), amely meglehetősen gyakori. Az egyik tábla az entitásokat (bejegyzéseket) tartalmazza, a másik tábla a jellemzők (attribútumok) neveit, a harmadik tábla pedig összekapcsolja az entitásokat a jellemzőikkel, és tárolja e jellemzők értékeit az aktuális entitás számára. Ez lehetővé teszi, hogy különböző jellemzők készletei legyenek különböző objektumok számára, és új jellemzőket adhassunk hozzá „szalagszerűen”, anélkül, hogy megváltoztatnánk az adatbázis struktúráját.
Ennek ellenére nem írnám ezt a megjegyzést, ha nem lennének hátrányai az EVA megközelítésnek. Például, ha egy vagy több entitást szeretnénk lekérni, amelyeknek 1 attribútumuk van, akkor 2 egyesítést (JOIN) igényel a lekérdezés: az első – egyesítés a jellemzők táblájával, a második – egyesítés az értékek táblájával. Ha az entitásnak 2 attribútuma van, akkor már 4 egyesítés szükséges! Ezenkívül minden jellemzőt általában szövegként tárolnak, ami típusképzést eredményez a kimenet és a WHERE feltétel számára is. Ha sok lekérdezést írsz, ez meglehetősen pazarló, erőforrások szempontjából.
Ezek nyilvánvaló hátrányok ellenére az EAV régóta használják az ilyen típusú problémák megoldására. Ezek elkerülhetetlen hátrányok voltak, és egyszerűen nem volt jobb alternatíva.
De ezután a PostgreSQL-ben megjelent egy új „technológia”...
A PostgreSQL 9.4-től a JSONB adat típus került bevezetésre a JSON bináris adatainak tárolására. Bár a JSON ezen formátumban történő tárolása általában valamivel több helyet és időt igényel, mint az egyszerű szöveges JSON, az ezzel kapcsolatos műveletek végrehajtása sokkal gyorsabb. A JSONB emellett támogatja az indexelést, ami még gyorsabbá teszi a lekérdezéseket.
A JSONB adat típus lehetővé teszi számunkra, hogy a terjedelmes EAV mintázatot egyetlen JSONB oszlop hozzáadásával egyszerűbben helyettesítsük az entitásaink táblájában, ami jelentősen leegyszerűsíti az adatbázis tervezését. De sokan állítják, hogy ez teljesítménycsökkenéssel járhat… Ez az ok vezetett ehhez a cikkhez.
Tesztadatbázis beállítása
Ehhez az összehasonlításhoz egy adatbázist hoztam létre egy új PostgreSQL 9.5-ös telepítésen egy 80 dolláros konfiguráción. Ubuntu 14.04. Néhány paraméter beállítása után a postgresql.conf-ban elindítottam a scriptet a psql segítségével. Az EAV forma megjelenítése érdekében a következő táblákat hoztuk létre:
CREATE TABLE entity (
  id           SERIAL PRIMARY KEY,
  name         TEXT,
  description  TEXT
);
CREATE TABLE entity_attribute (
  id          SERIAL PRIMARY KEY,
  name        TEXT
);
CREATE TABLE entity_attribute_value (
  id                  SERIAL PRIMARY KEY,
  entity_id           INT    REFERENCES entity(id),
  entity_attribute_id INT    REFERENCES entity_attribute(id),
  value               TEXT
);
Az alábbi táblázat tartalmazza majd ugyanazokat az adatokat, de a JSONB típusú oszlopban lévő attribútumokkal – itt szükséges ahhoz, hogy az adminisztrátor értesítést kapjon a build és tesztelési eredményekről, mint a folyamat tulajdonosa..
CREATE TABLE entity_jsonb (
  id          SERIAL PRIMARY KEY,
  name        TEXT,
  description TEXT,
  properties  JSONB
);
Ez sokkal egyszerűbben néz ki, nemde? Ezután 10 millió rekord került be a több entitás táblába (entity & entity_jsonb) és megfelelően kitöltöttük ugyanazokkal az adatokkal az EAV mintázatot és a JSONB oszlopot használó táblákat – entity_jsonb.properties. Így néhány különböző adattípust kaptunk az összes tulajdonságkészlet között. Példa az adatokra:
{
  id:          1
  name:        "Entity1"
  description: "Teszt entitás 1. száma"
  properties:  {
    color:        "piros"
    length:       120
    width:        3.1882420
    hassomething: true
    country:      "Belgium"
  }
}
Így most ugyanazok az adatok állnak rendelkezésünkre a két változathoz. Kezdjük el összehasonlítani az implementációk működését!
A dizájn egyszerűsítése
Korábban már említettem, hogy az adatbázis dizájnja jelentősen leegyszerűsödött: egy táblázat, az EAV három táblája helyett a JSONB oszlop használatával a tulajdonságokhoz. De hogyan hat ez a lekérdezésekre? Egy entitás egy tulajdonságának frissítése így néz ki:
-- EAV
UPDATE entity_attribute_value
SET value = 'kék'
WHERE entity_attribute_id = 1
  AND entity_id = 120;

-- JSONB
UPDATE entity_jsonb
SET properties = jsonb_set(properties, '{"szín"}', '"kék"')
WHERE id = 120;
Ahogy látjuk, az utolsó lekérdezés nem tűnik egyszerűbbnek. Az érték frissítéséhez a JSONB objektumban használnunk kell a funkciót , és az új értéket JSONB objektumként kell átadnunk. Mindazonáltal nem kell előre tudnunk semmilyen azonosítót. Az EAV példájára nézve tudnunk kell mind az entity_id-t, mind az entity_attribute_id-t a frissítési művelet végrehajtásához. Ha olyan tulajdonságot szeretnénk frissíteni a JSONB oszlopban, amelynek neve ismert, azt egy egyszerű sorban elvégezhetjük.
Most válasszuk ki azt az entitást, amelyet éppen frissítettünk, az új színe alapján:
-- EAV
SELECT e.name
FROM entity e
  INNER JOIN entity_attribute_value eav ON e.id = eav.entity_id
  INNER JOIN entity_attribute ea ON eav.entity_attribute_id = ea.id
WHERE ea.name = 'szín' AND eav.value = 'kék';

-- JSONB
SELECT name
FROM entity_jsonb
WHERE properties ->> 'szín' = 'kék';
Azt hiszem, egyetérthetünk abban, hogy a második megoldás rövidebb (nincs join!), és így olvashatóbb is. Itt a JSONB győz! Az JSON operátort használjuk ->> a szín szöveges értékének lekérésére a JSONB objektumból. Van egy második módszer is, amellyel ugyanazt az eredményt érhetjük el a JSONB modellel a @> operátor használatával:
-- JSONB
SELECT name
FROM entity_jsonb
WHERE properties @> '{"szín": "kék"}';
Ez egy kicsit bonyolultabb: ellenőrizzük, hogy a JSON objektum a properties oszlopban tartalmazza-e az objektumot, amely a @> operátor jobb oldalán található. Kevésbé olvasható, de hatékonyabb (lásd lentebb).
Még tovább egyszerűsíthetjük a JSONB használatát, amikor egyszerre több tulajdonságot kell kiválasztanunk. Itt valóban jól működik a JSONB megközelítés: egyszerűen választjuk ki a tulajdonságokat további oszlopokként az eredményhalmazban anélkül, hogy csatlakozásokra lenne szükség:
-- JSONB
SELECT name
  , properties ->> 'szín'
  , properties ->> 'ország'
FROM entity_jsonb
WHERE id = 120;
EAV-nál 2 csatlakozásra van szüksége minden egyes tulajdonsághoz, amelyet le szeretne kérdezni. Véleményem szerint a fenti lekérdezések jelentős egyszerűsítést mutatnak a adatbázis tervezésében. További példákat találhat a JSONB lekérdezések írására a bejegyzésben.
Most itt az idő, hogy a teljesítményről beszéljünk.
Teljesítmény
A teljesítmény összehasonlítására használtam A lekérdezések során, a végrehajtási idő számítása érdekében. Minden lekérdezés legalább háromszor végrehajtódott, mert az első alkalommal a lekérdezés-ütemezőnek több időre van szüksége. Először indexek nélkül hajtottam végre a lekérdezéseket. Nyilvánvaló, hogy ez előnyös volt a JSONB számára, mivel a EAV-hoz szükséges joinok nem tudták használni az indexeket (a külső kulcs mezők nem voltak indexelve). Ezt követően létrehoztam egy indexet a két külső kulcs mezőről az EAV értéktáblában, valamint indexet a JSONB mezőhöz.
Az adatok frissítése a következő időeredményeket mutatta (ms-ben). Vegye figyelembe, hogy a skála logaritmikus:
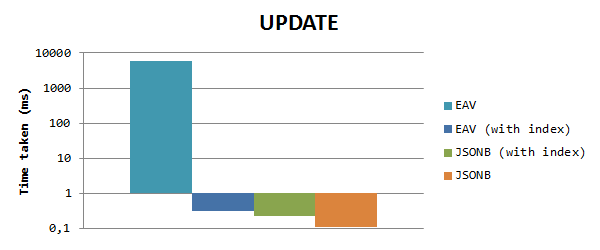
Látható, hogy a JSONB sokkal (> 50000-szer) gyorsabb, mint az EAV, ha nem használunk indexeket, a fent említett ok miatt. Amikor az elsődleges kulcsokkal indexeljük a mezőket, a különbség majdnem eltűnik, de a JSONB még mindig 1,3-szor gyorsabb, mint az EAV. Észrevették, hogy a JSONB mező indexe itt nem gyakorol semmilyen hatást, mivel nem használjuk a tulajdonság mezőt az értékelési kritériumok között.
A tulajdonságérték alapján történő adatlekérdezésünk a következő eredményeket adta (normál skálán):
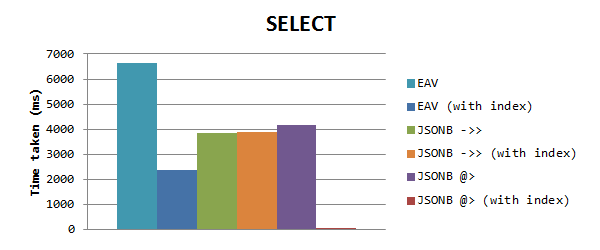
Meg lehetett figyelni, hogy a JSONB ismét gyorsabban működik, mint az EAV indexek nélkül, de amikor az EAV-nak indexei vannak – akkor az még mindig gyorsabban működik, mint a JSONB. De később észrevettem, hogy a JSONB lekérdezések ideje azonos volt, ami arra késztetett, hogy a GIN-indexek nem működnek. Úgy tűnik, hogy amikor GIN indexet használunk a kitöltött tulajdonságok mezőjéhez, az csak a @> operátor használata esetén működik. Ezt használtam egy új tesztben, ami hatalmas hatással volt az időre: csupán 0,153 ms! Ez 15000-szer gyorsabb, mint az EAV, és 25000-szer gyorsabb, mint a ->> operátor.
Azt hiszem, ez elég gyors volt!
Az adatbázis táblák mérete
Nézzük meg a táblák méreteit mindkét megközelítés esetén. A psql-ben meg tudjuk mutatni az összes tábla és index méretét a következő parancs segítségével dti+
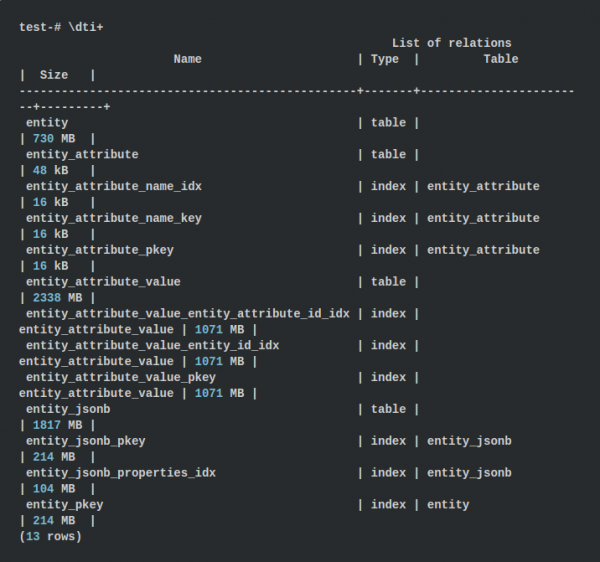
Az EAV megközelítés esetén a táblák mérete körülbelül 3068 MB, míg az indexek 3427 MB-ig terjednek, ami összesen 6,43 GB. A JSONB megközelítés alkalmazásakor a tábla mérete 1817 MB, míg az indexeké 318 MB, ami 2,08 GB-t jelent. Ez háromszor kevesebb! Ez a tény kissé meglepett, mert a tulajdonságneveket minden JSONB objektumban tároljuk.
De a számok magukért beszélnek: az EAV-ban 2 egész számú külső kulcsot tárolunk a tulajdonság értékére, ennek eredményeként 8 bájt extra adatot kapunk. Ezen kívül az EAV-ban az összes tulajdonság értéke szöveg formájában van tárolva, míg a JSONB számjegyeket és logikai értékeket használ, ahol csak lehetséges, ami kisebb terjedelmet eredményez.
Összegzés
Összességében úgy gondolom, hogy az entitások tulajdonságainak JSONB formátumban való tárolása jelentősen leegyszerűsítheti az adatbázisának tervezését és karbantartását. Ha sok lekérdezést végez, akkor minden, ami egy táblázatban tárolódik az entitással, valóban hatékonyabban működik. Mivel ez megkönnyíti az adatok közötti interakciót, már ez is előny, de a végső adatbázis 3-szor kisebb térfogatú.
A végzett tesztek alapján megállapítható, hogy a teljesítményveszteség rendkívül csekély. Egyes esetekben a JSONB még gyorsabb is az EAV-nál, ami még vonzóbbá teszi. Ez a referencia teszt azonban természetesen nem fedi le az összes szempontot (például az entitások nagyon nagy számú tulajdonságait, a meglévő adatok jelentős tulajdonságnövekedését...), ezért ha bármilyen javaslata van a javításra, ne habozzon megosztani a megjegyzésekben!
Forrás: habr.com
