

Ebben a cikkben a funkcionális függőségekről beszélünk az adatbázisokban — mi ez, hol alkalmazzák és milyen algoritmusok léteznek a keresésükre.
A funkcionális függőségeket a relációs adatbázisok kontextusában fogjuk megvizsgálni. Egészen durván szólva, az ilyen adatbázisokban az információ táblázatok formájában tárolódik. Továbbá közelítő fogalmakat használunk, amelyek a szigorú relációs elméletben nem helyettesíthetők: magát a táblázatot relációnak nevezzük, az oszlopokat attribútumoknak (sokaságuk az relációs séma), a sorok egy adott attribútumhalmazának értékhalmazát pedig tuple-nek.
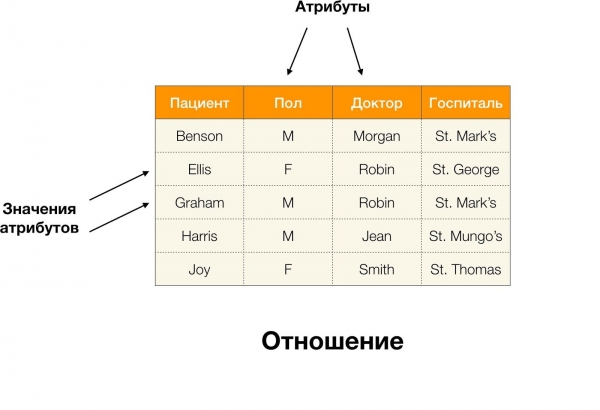
Például a fenti táblázatban, (Benson, M, M szerv) az attribútumok szerinti tuple. (Betegek, Neme, Orvos).
Formálisan ezt a következő formában írjuk le:  [Betegek, Neme, Orvos] = (Benson, M, M szerv).
Most bevezethetjük a funkcionális függőség fogalmát (FF):
Definíció 1. A reláció R teljesíti az FF X → Y (ahol X, Y ⊆ R) akkor és csak akkor, ha bármely tuple  ,
 ∈ R esetén teljesül: ha
 [X] =
 [X], akkor
 [Y] =
 [Y]. Ilyen esetben azt mondjuk, hogy X (determinenáns, vagy meghatározó attribútumhalmaz) funkcionálisan meghatározza Y-t (függő halmaz).
Más szóval, a funkcionális függőség megléte X → Y azt jelenti, hogy ha van két tuple-ünk a R és ezek egyeznek az attribútumokban X, akkor azok az attribútumokban is egyezni fognak. Y.
Most pedig sorban. Vizsgáljuk meg az attribútumokat Betegek és Női nem melyek esetében szeretnénk tudni, hogy van-e közöttük függőség vagy sem. Az ilyen attribútumhalmazok esetében a következő függőségek létezhetnek:
- Betegek → Neme
- Neme → Betegek
A fent említett definíció szerint ahhoz, hogy az első függőség fennmaradjon, minden egyedi oszlopszámhoz csak egy oszlopszámnak kellene megfelelnie. Betegek És az példa táblázat esetében ez valóban így van. Azonban visszafelé ez nem működik, tehát a második függőség nem teljesül, s az attribútum Női nemnem determináns a Női nem Betegek számára. Hasonlóképpen, ha figyelembe vesszük aOrvos → Betegek függőséget, észrevehetjük, hogy ez megsértődik, mivel az értékRobin ezen attribútum esetében több különböző értékkel rendelkezik — Ellis és Graham. Ellis és Graham.
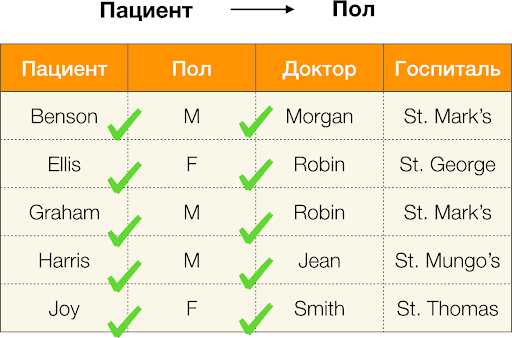
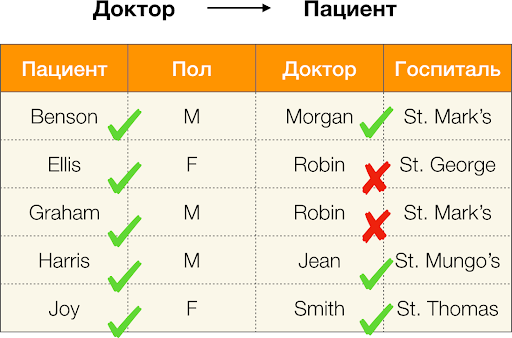
Ezért a funkcionális függőségek lehetővé teszik a táblázat attribútumhalmazai közötti kapcsolatok meghatározását. Ettől kezdve a legérdekesebb kapcsolatokkal fogunk foglalkozni, pontosabban úgy, X → Y, hogy azok:
- nem triviálisak, azaz a függőség jobb oldala nem az a bal oldal részhalmaza (Y ̸⊆ X);
- minimalisták, azaz nincs olyan függőség, Z → Y, hogy Z ⊂ X.
A mostanáig tárgyalt függőségek szigorúak voltak, azaz nem engedtek meg semmilyen megsértést a táblázatban, de vannak olyanok is, amelyek bizonyos fokú inkonzisztenciát engednek meg a tuple-ök értékei között. Ezeket külön osztályba sorolják, megközelítő függőségeknek nevezik őket, és megengedik, hogy egy meghatározott számú tuple-t megsértsenek. Ez a szám a maximális hibahatár emax értékével szabályozható. Például, a hiba aránya  = 0.01 azt jelentheti, hogy a függőség 1%-kal sérülhet a vizsgált attribútumhalmazokban található tuple-ök között. Azaz 1000 bejegyzés esetén legfeljebb 10 tuple sértheti meg a funkcionális függőséget. Mi viszont egy kicsit eltérő metrikával fogunk foglalkozni, amely a összehasonlított tuple-ök páronként eltérő értékein alapul. A könyv X → Y akkor úgy számítják, r hogy:

Számítsuk ki a hibát a függőséget, észrevehetjük, hogy ez megsértődik, mivel az érték fenti példából. Két tuple-t kapunk, amelyek értékei eltérnek az Betegek, de megegyeznek a Doktor:  [Doktor, Beteg] = (Robin, Ellis, ennek eredményeként a lekérdezések olyan formát öltenek, mint a fent említett.
 [Doktor, Beteg] = (Robin, Graham). A hiba meghatározása szerint figyelembe kell vennünk az összes konfliktáló párt, tehát ilyenből kettő lesz: (
 ,
 ) és annak inverziója (
 ,
 ). Helyettesítjük a képletbe, és megkapjuk:

Most pedig próbáljunk választ adni arra a kérdésre: «De miért van szükség minderre?». Valójában a funkcionális függőségek különbözőek. Az első típus — ezek olyan függőségek, amelyeket az adminisztrátor a adatbázis tervezése során határoz meg. Általában csak kevés van belőlük, szigorúak, és fő alkalmazásuk az adatok normalizálása és a relációs séma tervezése.
A második típus - a függőségek, amelyek „rejtett” adatokat és korábban ismeretlen kapcsolatokat képviselnek az attribútumok között. Vagyis ezekről a függőségekről nem gondoltak a tervezés során, és már egy meglévő adathalmazon belül találják őket, hogy aztán a sok felfedezett funkcionális záradék alapján bármilyen következtetést levonjanak a tárolt információról. Pontosan ezzel a fajtájú függőséggel foglalkozunk. Ezt egy külön terület, az adatmórál foglalkozik különböző keresési technikákkal és az alapján kidolgozott algoritmusokkal. Nézzük meg, mivel lehetnek hasznosak az felfedezett funkcionális függőségek (pontosan vagy megközelítőleg) bizonyos adatokban.
Ma a függőségek fő alkalmazási területei közé tartozik az adatok tisztítása. Ez magában foglalja a „piszkos adatok” azonosításának folyamatainak kidolgozását, amelyek után helyesbítik őket. A „piszkos adatok” világos példái a duplikátumok, a hibák az adatokban vagy elgépelések, az elmaradt értékek, elavult adatok, felesleges szóközök és hasonlók.
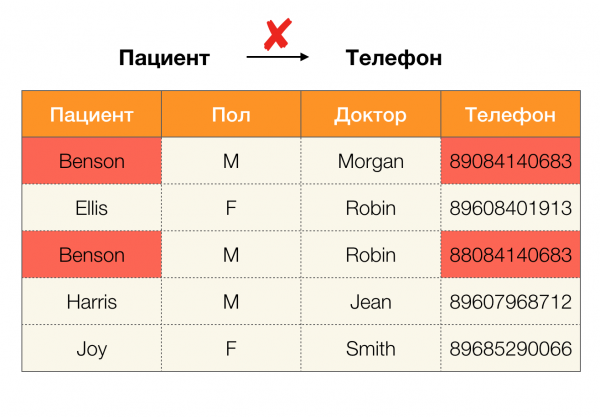
Példa hiba az adatokban:
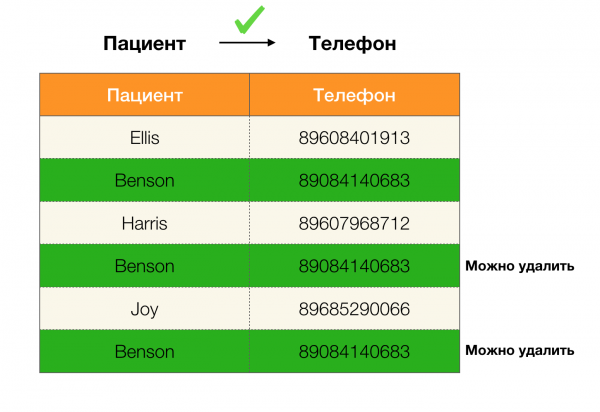
Példa duplikátumokra az adatokban:
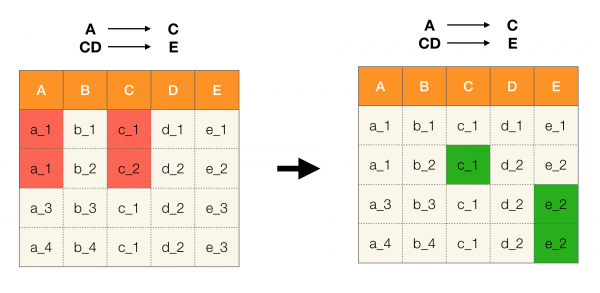
Például van egy táblázatunk és egy sor funkcionális záradékunk, amelyeknek teljesülniük kell. Az adatok tisztítása ebben az esetben azt jelenti, hogy a számadatokat úgy módosítjuk, hogy a funkcionális záradékok igazak legyenek. Ezen belül a módosítások száma a lehető legkisebb legyen (ehhez a folyamathoz saját algoritmusok léteznek, amelyekre ebben a cikkben nem fogunk összpontosítani). Az alábbiakban bemutatunk egy példát az adatok ilyen átalakítására. Bal oldalon az eredeti összefüggés látható, amelyben nyilvánvalóan nem teljesülnek a szükséges funkcionális záradékok (a piros színnel kiemelt példája egy funkcionális záradék megszegésének). Jobb oldalon a frissített összefüggés található, ahol a zöld cellák a módosított értékeket mutatják. Az ilyen eljárás lefolytatása után a szükséges függőségek kezdtek életbe lépni.
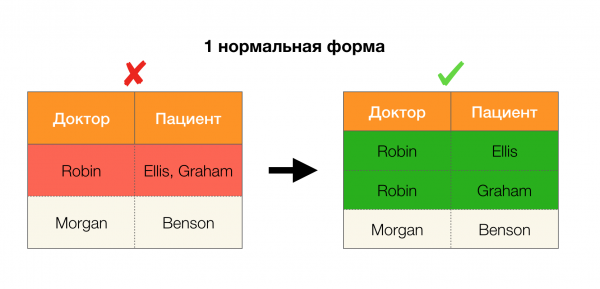
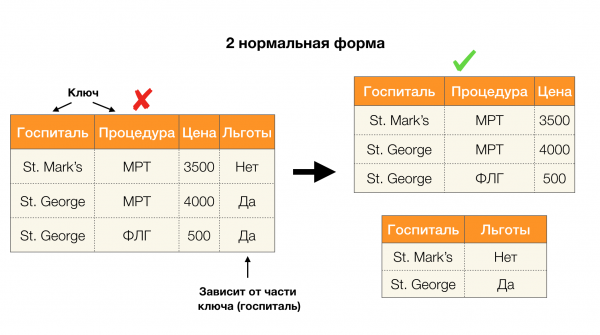
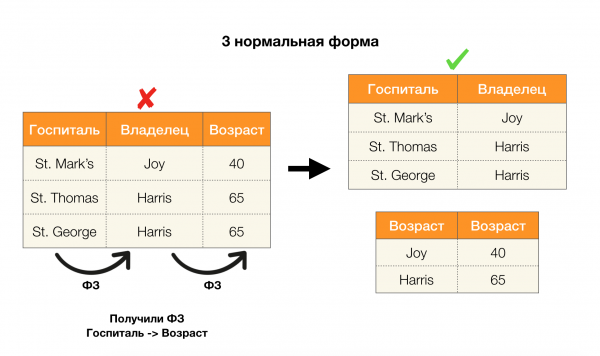
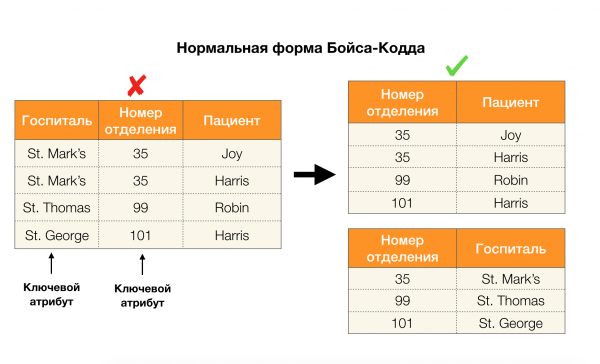
Egy másik népszerű alkalmazási terület az adatbázis-tervezés. Itt érdemes megemlíteni a normálformákat és a normalizálást. A normalizálás egy olyan folyamat, amelynek során a relációt egy meghatározott követelményhalmaznak megfelelően alakítják ki, ahol minden egyes követelményt a normálforma saját módján definiál. A különböző normálformák követelményeit nem fogjuk részletezni (ez bármilyen kezdő adatbázis-könyvben megtalálható), csupán annyit jegyzünk meg, hogy mindegyik saját módján használja a funkcionális függőségek fogalmát. Hiszen a funkcionális függőségek lényegében az integritás korlátai, amelyeket az adatbázis tervezésekor figyelembe kell venni (ebben a kontextusban a funkcionális függőségeket néha szuperkulcsoknak is nevezik).
Nézzük meg alkalmazásukat a négy normálforma szempontjából az alábbi ábrán. Emlékezzünk rá, hogy a Boyce-Codd normálforma szigorúbb, mint a harmadik forma, de kevésbé szigorú, mint a negyedik. Az utóbbival egyelőre nem foglalkozunk, mivel ennek a megértéséhez többértékű függőségek ismerete szükséges, amelyek nem érdekelnek ezen a cikkben.
Egy másik terület, ahol a függőségek alkalmazást nyernek, a jellemzők térdimenziójának csökkentése olyan feladatoknál, mint a naiv Bayes-osztályozó felépítése, jelentős jellemzők kiemelése és a regressziós modell újra paraméterezése. Az eredeti cikkekben ezt a feladatot a fölösleges jellemzők (feature redundancy) és a releváns jellemzők (feature relevancy) meghatározásának nevezik, és aktívan használják az adatbázisok koncepcióit. Az ilyen munkák megjelenésével ma már beszélhetünk olyan megoldások iránti igényről, amelyek adatbázisokat, elemzéseket és az említett optimalizálási problémák megoldását egy eszközben egyesítik.
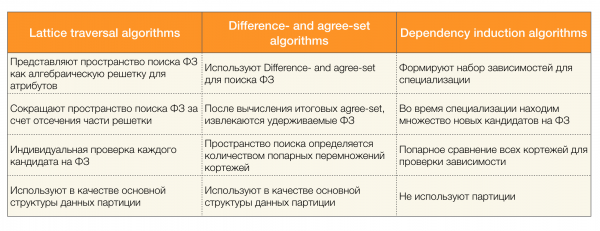
A funkcionális függőségek keresésére számos algoritmus létezik (modern és kevésbé modern). Ezeket az algoritmusokat három csoportra lehet osztani:
- Algebrikus rácsok bejárásán alapuló algoritmusok (Lattice traversal algorithms)
- Konzisztens értékek keresésén alapuló algoritmusok (Difference- and agree-set algorithms)
- Páros összehasonlításokon alapuló algoritmusok (Dependency induction algorithms)
Minden algoritmustípus rövid leírása az alábbi táblázatban található:
További információkat erről a kategóriáról itt olvashat [4]. Az alábbiakban példák találhatók minden típusú algoritmusra:
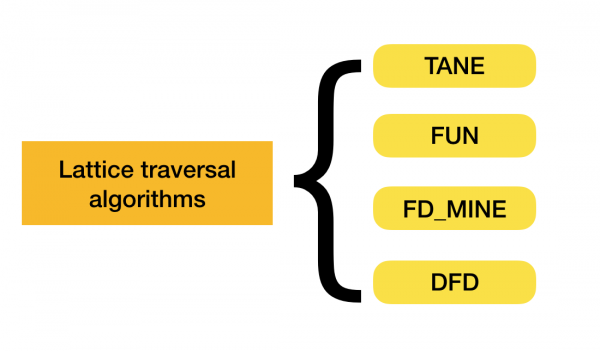
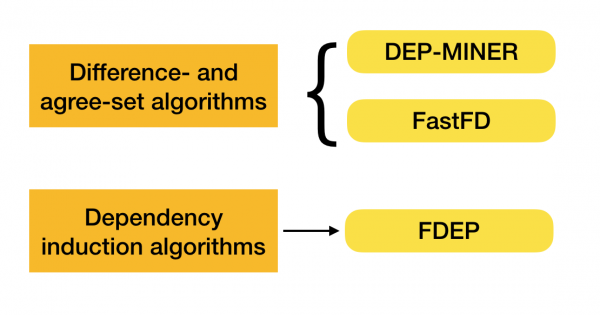
Jelenleg új algoritmusok jelennek meg, amelyek több megközelítést ötvöznek a funkcionális függőségek keresésében. Ilyen algoritmusok például a Pyro [2] és a HyFD [3]. Működésük elemzésére a cikk sorozat következő részeiben kerül sor. Részletekbe most csak az alapvető fogalmakat és azokat a tételeket vesszük át, amelyek szükségesek a függőségek azonosításának technikáinak megértéséhez.
Kezdjük az egyszerűbbekkel — a difference- és agree-settel, amelyeket a második típusú algoritmusok használnak. A difference-set olyan többszörös halmaz, ahol a tuple-ök nem egyeznek meg az értékekben, míg az agree-set éppen ellenkezőleg — az egyező értékű tuple-ök csoportja. Fontos megjegyezni, hogy ebben az esetben csak a függőség bal oldalát vizsgáljuk.
Egy másik fontos fogalom, amely már korábban is előkerült, az algebrai rács. Mivel sok modern algoritmus e fogalmat használja, fontos tudnunk, hogy mi ez.
A rács fogalmának bevezetéséhez szükség van a részlegesen rendezett halmaz (vagy partially ordered set, rövidítve poset) definíciójára.
Definíció 2. Azt mondjuk, hogy az S halmaz részlegesen rendezett a ⩽ relációval, ha minden a, b, c ∈ S elemre teljesülnek a következő tulajdonságok:
- Reflexivitás, azaz a ⩽ a.
- Antiszimmetria, azaz ha a ⩽ b és b ⩽ a, akkor a = b.
- Tranzitivitás, azaz ha a ⩽ b és b ⩽ c, akkor a ⩽ c.
Ez a reláció a (nem szigorú) részleges sorrend relációjára vonatkozik, maga a halmaz pedig részlegesen rendezett halmaz. Formális jelölés: ⟨S, ⩽⟩.
Mint legegyszerűbb példa, tekintsük az összes természetes szám N halmazát a szokásos rendezési relációval ⩽. Nem nehéz ellenőrizni, hogy minden szükséges axióma teljesül.
Egy tartalmasabb példa. Tekintsük az {1, 2, 3} halmaz összes részhalmazát, rendezve a ⊆ relációval. Valóban, ez a reláció minden részleges sorrenddel kapcsolatos feltételnek megfelel, így ⟨P({1, 2, 3}), ⊆⟩ — részlegesen rendezett halmaz. Az alábbi ábrán látható ennek a halmaznak a struktúrája: ha egy elemhez nyilakkal el lehet jutni egy másik elemhez, akkor azok rendezési relációban állnak.
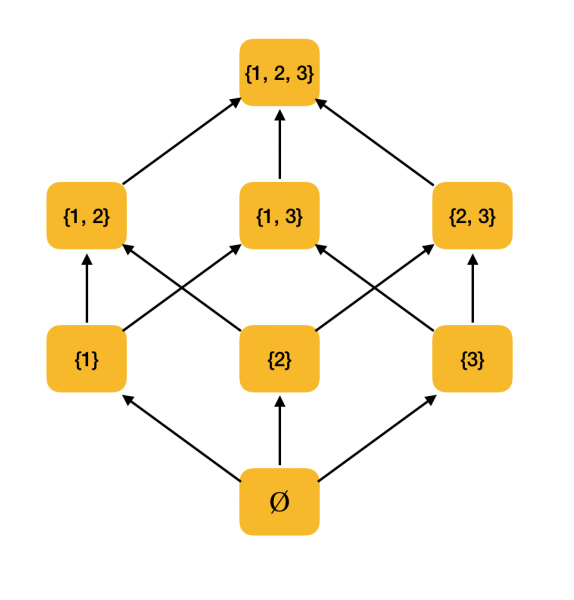
Két egyszerű matematikai fogalomra van szükségünk — a supremumra és az infimumra.
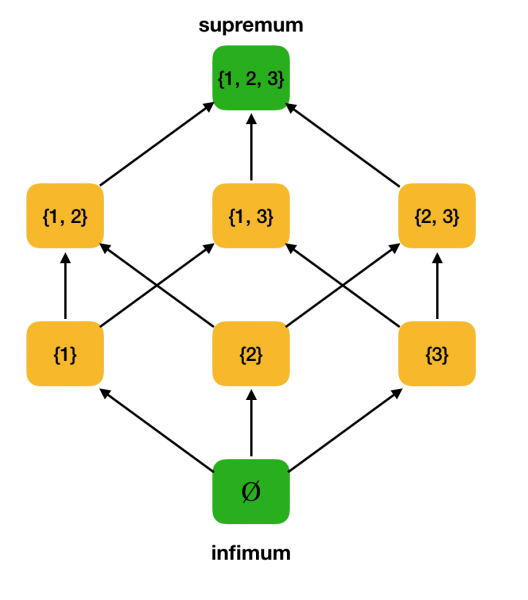
3. meghatározás. Legyen ⟨S, ⩽⟩ — részlegesen rendezett halmaz, A ⊆ S. Az A felső határa egy olyan elem u ∈ S, amelyre ∀x ∈ S: x ⩽ u. Legyen U a S összes felső határának halmaza. Ha az U-ban van legkisebb elem, akkor azt supremumnak nevezzük, és sup A-ként jelöljük.
Hasonlóképpen határozzuk meg a pontos alsó határt.
4. meghatározás. Legyen ⟨S, ⩽⟩ — részlegesen rendezett halmaz, A ⊆ S. Az A alsó határa egy olyan elem l ∈ S, amelyre ∀x ∈ S: l ⩽ x. Legyen L a S összes alsó határának halmaza. Ha az L-ben van legnagyobb elem, akkor azt infimumának nevezzük, és inf A-ként jelöljük.
Vegyük példának a fenn említett részlegesen rendezett halmazt ⟨P ({1, 2, 3}), ⊆⟩, és találjuk meg benne a supremumot és az infimumot:
Most megfogalmazhatjuk az algebrai rács definícióját.
5. meghatározás. Legyen ⟨P, ⩽⟩ — részlegesen rendezett halmaz, amelyben minden két elemű részhalmaznak pontos felső és alsó határa van. Ekkor a P-t algebrai rácsnak nevezzük. Ezenkívül sup{x, y} -t x ∨ y-ként, míg inf{x, y} -t x ∧ y-ként írják.
Ellenőrizzük, hogy a munkapéldánk ⟨P ({1, 2, 3}), ⊆⟩ rács-e. Valóban, bármely a, b ∈ P ({1, 2, 3}) esetén a ∨ b = a ∪ b, míg a ∧ b = a ∩ b. Például vizsgáljuk meg a {1, 2} és {1, 3} halmazokat, és találjuk meg az infimumot és supremumot. Ha a kettőt metszjük, {1} halmazt kapunk, amely az infimum lesz. A supremum pedig az egyesítésükkel nyerhető: {1, 2, 3}.
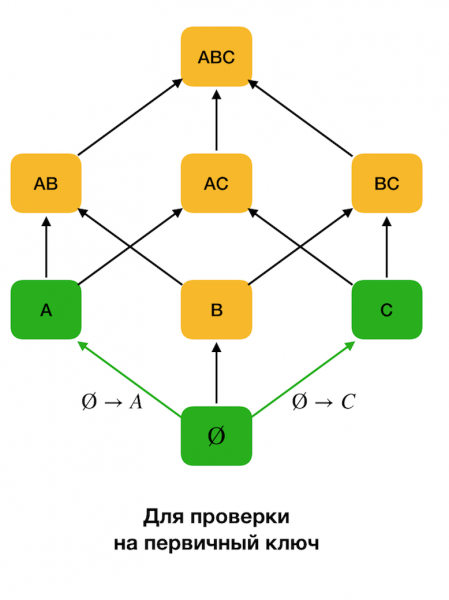
A szuperzsírtalálási algoritmusokban a keresési tér gyakran rácsként jelenik meg, ahol az egyelemű halmazok (nevezd el az első szintű keresési rácsot, ahol a baloldali függőségek egy attribútumból állnak) minden attribútumot képviselnek az eredeti relációban.
Kezdetben a ∅ → típusú függőségeket vizsgáljuk. Egyetlen attribútum. Ez a lépés lehetővé teszi annak meghatározását, hogy mely attribútumok képezik a primer kulcsokat (ezekhez az attribútumokhoz nincsenek determinánsok, ezért a baloldal üres). Ezt követően az algoritmusok a rácson felfelé haladnak. Meg kell jegyezni, hogy a rácsot nem feltétlenül kell teljesen bejárni, tehát ha megadunk egy kívánt maximális méretet a bal oldalon, akkor az algoritmus nem halad tovább egy ilyen méretű szinten.
Az alábbi ábrán látható, hogyan lehet felhasználni az algebrai rácsot a FZ keresési feladatában. Itt minden él (X, XY) egy függőséget képvisel X → Y. Például áthaladtunk az első szinten, és tudjuk, hogy a függőség A → B zöld kapcsolódásként jelenik meg a csúcsok között A és B). Ezért, amikor a rácson felfelé haladunk, nem kell ellenőriznünk a függőséget A, C → B, mert az már nem lesz minimális. Hasonlóképpen nem ellenőriznénk, ha a függőség C → B.
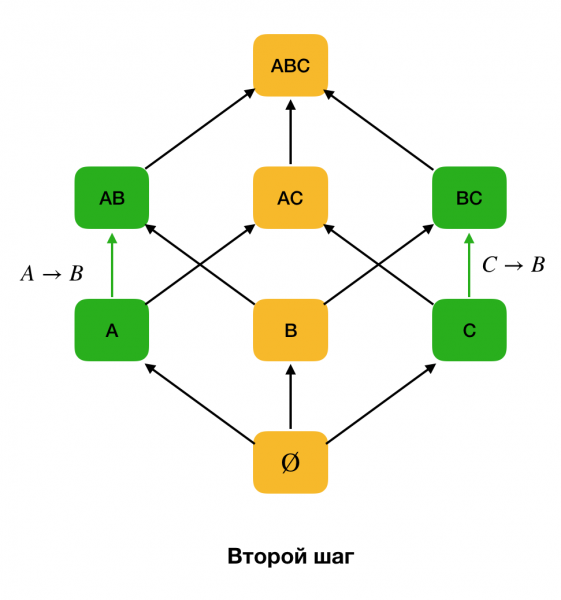
tartva lenne. Továbbá, általában minden modern FZ keresési algoritmus ilyen adatstruktúrát használ, mint a partíció (az eredetiben – stripped partition [1]). A partíció formális meghatározása a következőképpen néz ki:
Definíció 6. Legyen X ⊆ R – az r reláció attribútumainak halmaza. A klaszter az r tuple-ök indexeinek halmaza, amelyeknek az X-re azonos értékük van, azaz c(t) = {i|ti[X] = t[X]}. A partíció az egység hosszú klasztereket kizáró halmazt alkot:

Egyszerű szavakkal, a partíció egy attribútumra X egy olyan listákból álló halmazt jelent, ahol minden lista az azonos értékű Xsorok számát tartalmazza. A modern irodalomban a partíciókat reprezentáló struktúrát position list indexnek (PLI) nevezik. Az egység hosszú klasztereket a PLI tömörítése érdekében zárják ki, mert ezek olyan klaszterek, amelyek csak egy egyedi értékű bejegyzés számát tartalmazzák, amelyet mindig könnyen meghatározhatunk.
Nézzük meg a példát. Térjünk vissza az ugyanarra betegadatok táblájára, és készítsünk partíciókat az oszlopok számára Betegek és Női nem (balra egy új oszlop jelent meg, amelyben a táblázat sorainak számait jelöljük):
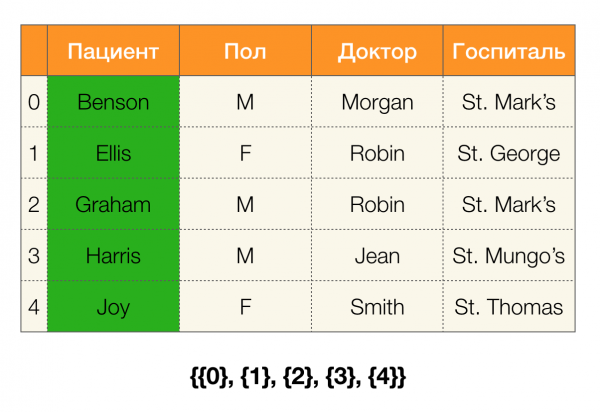
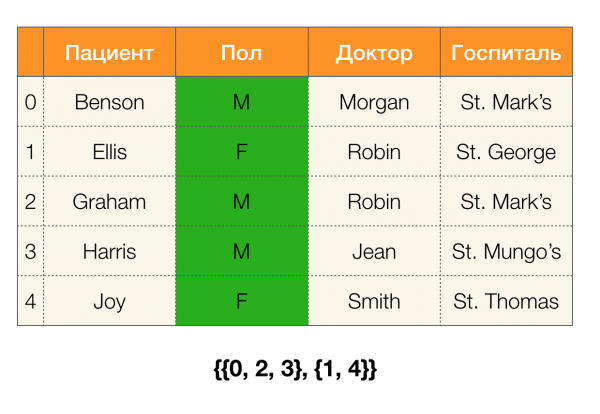
Itt az definíció szerint a partíció az oszlopra Betegek valójában üres lesz, mivel az egység klaszterek ki vannak zárva a partícióból.
A partíciókat több attribútum alapján is lehet készíteni. Erre két lehetőség van: végigjárni a táblázatot és az összes szükséges attribútum alapján azonnal létrehozni a partíciót, vagy pedig a partíciók metszésével egy részhalmaz alapján létrehozni. A FZ keresési algoritmusok a második lehetőséget használják.
Egyszerű szavakkal, például ha partíciót szeretnénk készíteni az oszlopokra ABC, akkor a AC és B (vagy bármely más, nem átfedő részhalmazok) és keresztezzük őket. Két partíció metszetének művelete a leghosszabb, mindkét partícióra közös klasztereket jelöli ki.
Nézzünk egy példát:
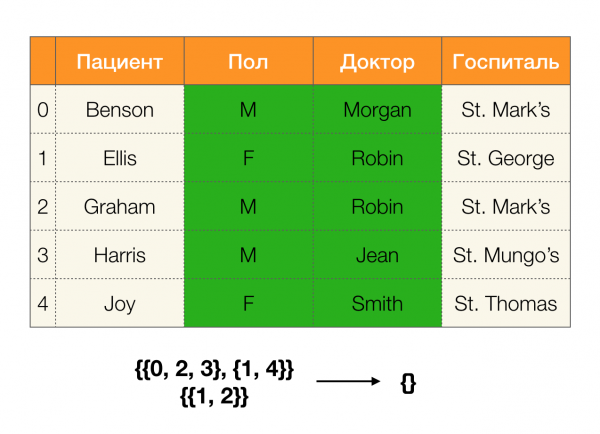
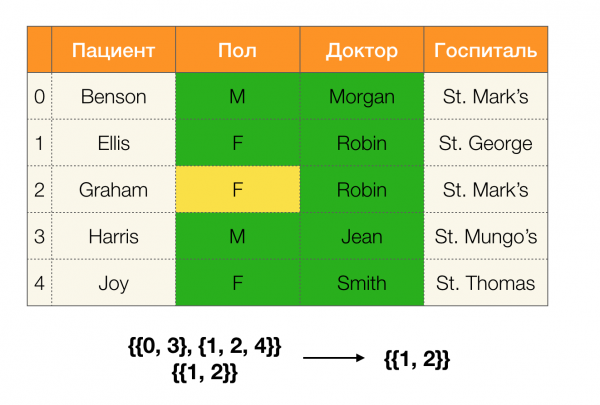
Az első esetben üres partíciót kaptunk. Ha megnézzük a táblázatot, valóban nincsenek azonos értékek a két attribútumon. Ha azonban kissé módosítjuk a táblázatot (a jobb oldali eset), már kapunk egy nem üres metszetet. Ezenkívül az 1. és 2. sor valóban azonos értékeket tartalmaz az attribútumok szerint. Női nem és Doktor.
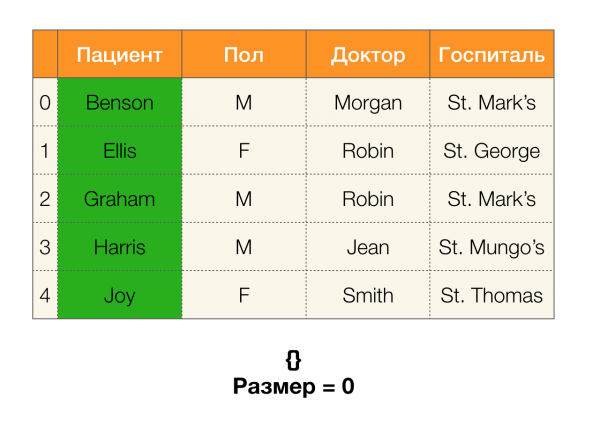
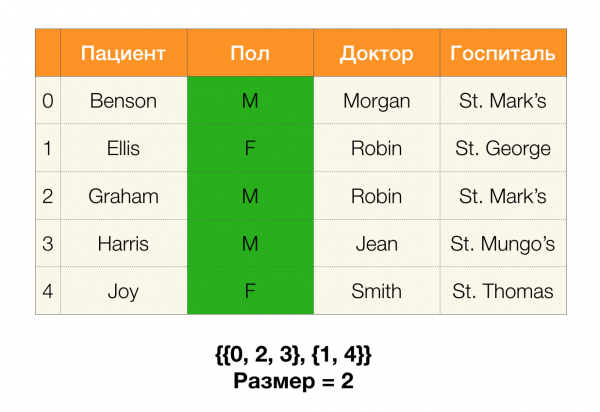
Most szükségünk lesz a partíció méretének fogalmára. Formálisan:

Egyszerűbben fogalmazva, a partíció mérete a partícióba tartozó klaszterek számát jelenti (ne feledd, hogy az egyes klaszterek nem tartoznak a partícióba!):
Most meghatározhatjuk az egyik kulcslemmát, amely a megadott partíciók esetén lehetővé teszi a függőség fennállásának megállapítását:
Lema 1. A függőség A, B → C fennáll, ha és csak ha

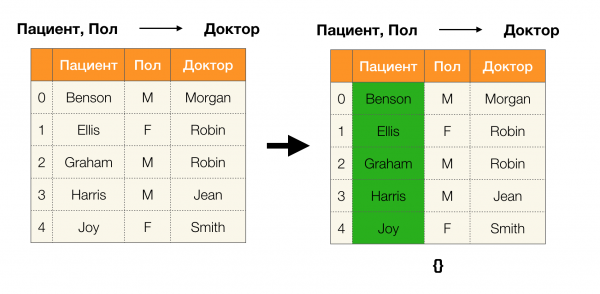
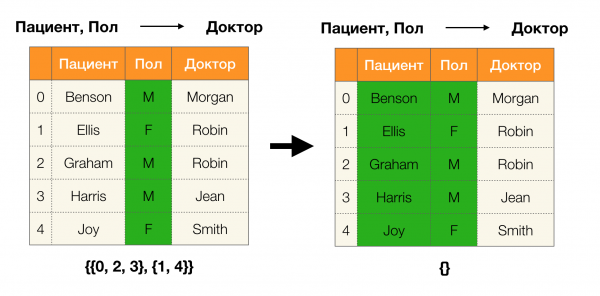
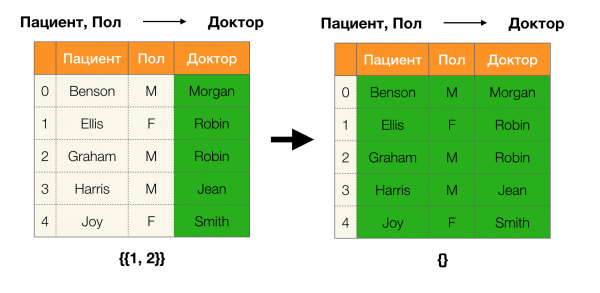
A lema szerint a függőség fennállásának meghatározásához négy lépést kell végrehajtani:
- Kiszámítani a partíciót a függőség bal oldalához
- Kiszámítani a partíciót a függőség jobb oldalához
- Kiszámítani az első és második lépés szorzataként
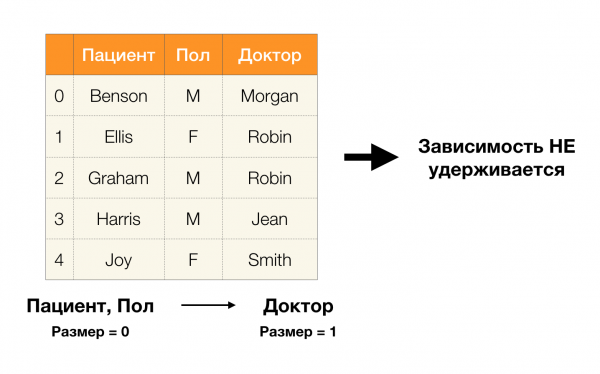
- Összehasonlítani az első és harmadik lépés során kapott partíciók méreteit
Alább bemutatunk egy példát arra, hogy a lema szerint fennáll-e a függőség:
A cikkben olyan fogalmakat vizsgáltunk, mint a funkcionális függőség, a közelítő funkcionális függőség, tárgyaltuk, hol használják őket, és milyen algoritmusok léteznek a függőségek keresésére. Emellett részletesen megvitatott alapvető, de fontos fogalmakat, amelyek aktívan használatosak a modern függőségkereső algoritmusokban.
Irodalomjegyzék:
- Huhtala Y. et al. TANE: An efficient algorithm for discovering functional and approximate dependencies //The computer journal. – 1999. – Vol. 42. – No. 2. – pp. 100-111.
- Kruse S., Naumann F. Efficient discovery of approximate dependencies //Proceedings of the VLDB Endowment. – 2018. – Vol. 11. – No. 7. – pp. 759-772.
- Papenbrock T., Naumann F. A hybrid approach to functional dependency discovery //Proceedings of the 2016 International Conference on Management of Data. – ACM, 2016. – pp. 821-833.
- Papenbrock T. et al. Functional dependency discovery: An experimental evaluation of seven algorithms //Proceedings of the VLDB Endowment. – 2015. – Vol. 8. – No. 10. – pp. 1082-1093.
- Kumar A. et al. To join or not to join?: Thinking twice about joins before feature selection //Proceedings of the 2016 International Conference on Management of Data. – ACM, 2016. – pp. 19-34.
- Abo Khamis M. et al. A tömörített tensorokkal végzett adatbázison belüli tanulás. // Proceedings of the 37th ACM SIGMOD-SIGACT-SIGAI Symposium on Principles of Database Systems. – ACM, 2018. – 325-340. o.
- Hellerstein J. M. et al. A MADlib analitikai könyvtár: avagy MAD képességek, a SQL // Proceedings of the VLDB Endowment. – 2012. – 5. kötet. – 12. szám. – 1700-1711. o.
- Qin C., Rusu F. Spekulatív közelítések terabites elosztott gradiens csökkenés optimalizálására // Proceedings of the Fourth Workshop on Data analytics in the Cloud. – ACM, 2015. – 1. o.
- Meng X. et al. Mllib: Gépi tanulás az Apache Sparkban // The Journal of Machine Learning Research. – 2016. – 17. kötet. – 1. szám. – 1235-1241. o.
A cikk szerzői: , kutató a , és , kutató a
Forrás: habr.com
