

Az Apache Cassandra adatbázissal és annak Kubernetes-alapú infrastruktúrában történő működtetésével kapcsolatosan rendszeresen szembesülünk. Ebben a cikkben megosztjuk saját látásmódunkat az elengedhetetlen lépésekről, kritériumokról és a létező megoldásokról (beleértve az operátorok áttekintését) a Cassandra K8s-be történő migrálásával kapcsolatban.
„Aki egy nőt tud irányítani, az államot is tudja.”
Ki is az a Cassandra? Ez egy elosztott tárolórendszer, amelyet nagy adatmennyiségek kezelésére terveztek, és biztosítja a magas elérhetőséget anélkül, hogy egyetlen hiba pont lenne. A projekt valószínűleg nem kíván hosszú bemutatkozást, ezért csak a Cassandra főbb jellemzőit említem meg, amelyek relevánsak az adott cikk szempontjából:
- A Cassandra Java nyelven íródott.
- A Cassandra topológiája több szintből áll:
- Node — egy telepített Cassandra példány;
- Rack — Cassandra példányok csoportja, amelyeket valamilyen jellemző mentén egyesítenek, és egy adatközpontban található;
- Datacenter — az összes Cassandra példány csoportja, amely egy adatközpontban található;
- Cluster — az összes adatközpont összessége.
- A Cassandra azonosításához IP-címet használ.
- A gyors írási és olvasási műveletek érdekében a Cassandra egy részét az adatainak a RAM-ban tárolja.
Most térjünk át magára a Kubernetesbe történő potenciális költözésre.
Check-list a migrációhoz
A Cassandra Kubernetesbe történő migrációjáról beszélve, reméljük, hogy a költözéssel kezelése kényelmesebbé válik. Mire van szükség ehhez, és mi segíti ebben?
1. Adattároló
Ahogy már említettük, a Cassandra az adatainak egy részét a RAM-ban tárolja — a Memtable. De van egy másik adat rész is, amelyet a lemezen tárolnak — mint SSTable. Ezekhez az adatokhoz hozzáadódik a Commit Log — az összes tranzakcióról szóló feljegyzések, amelyek szintén lemezen kerülnek tárolásra.
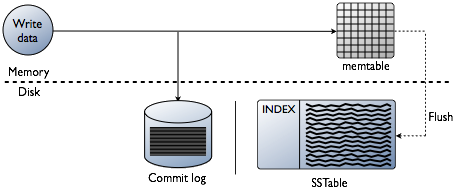
A Cassandra írási tranzakciós séma
A Kubernetesben az adatok tárolásához PersistentVolume-t használhatunk. A megfelelően kidolgozott mechanizmusoknak köszönhetően az adatok kezelése Kubernetesben évről évre egyre egyszerűbbé válik.
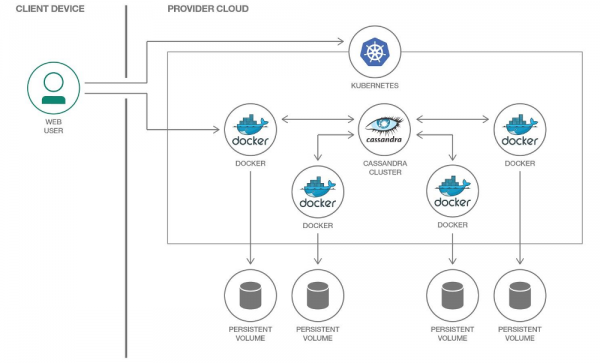
Minden Cassandra podhoz saját PersistentVolume-ot rendelünk.
Fontos megjegyezni, hogy a Cassandra alapértelmezetten adatreplikációt biztosít, saját beépített mechanizmusokkal. Ezért, ha egy nagy számú node-ból álló Cassandra klasztert épít, nincs szükség elosztott rendszerek, mint a Ceph vagy a GlusterFS alkalmazására az adatok tárolásához. Ebben az esetben logikus, hogy az adatokat a node lemezén tároljuk a vagy partíciózással hostPath.
Másik kérdés, ha minden feature-ág számára külön környezetet szeretne létrehozni a fejlesztőknek. Ebben az esetben a helyes megközelítés egy Cassandra node életre hívása, míg az adatokat elosztott tárolóban tárolják, tehát a már említett Ceph és GlusterFS lehetőséggé válnak. Így a fejlesztő biztos lehet benne, hogy nem veszít el tesztadatokat még akkor sem, ha a Kubernetes klaszter egyik node-ja elvész.
2. Monitorozás
Szinte alternatívátlan választás a Kubernetes monitorozásának megvalósítására a Prometheus (erről részletesen beszéltünk a ). Milyen kapcsolatban áll a Cassandra a Prometheus metrikakibővítőkkel? És ami talán még fontosabb, a Grafana számára megfelelő dashboardokkal?
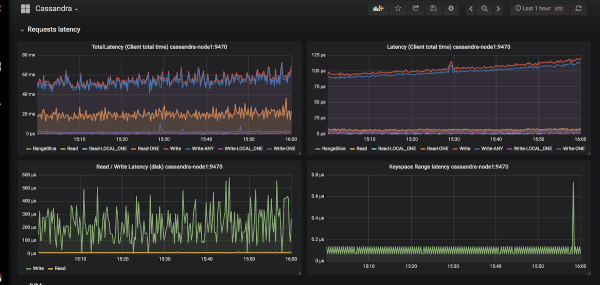
A Cassandra számára a Grafanában látható grafikonok példája
Két exportőr van összesen: és .
Mi az elsőt választottuk, mert:
- A JMX Exporter növekszik és fejlődik, míg a Cassandra Exporter nem kapta meg a közösség megfelelő támogatását. A Cassandra Exporter még mindig nem támogatja a Cassandra legtöbb verzióját.
- Egy javaagentként indítható, ha a következő flag-et hozzáadja:
-javaagent:<plugin-dir-name>\/cassandra-exporter.jar=--listen=:9180. - Ehhez létezik egy , amely nem kompatibilis a Cassandra Exporter-rel.
3. Kubernetes primitívák kiválasztása
A fenti Cassandra klaszterstruktúra szerint próbáljuk meg mindazt, ami ott le van írva, a Kubernetes terminológiába átültetni:
- Cassandra Node → Pod
- Cassandra Rack → StatefulSet
- Cassandra Datacenter → StatefulSets csoportja
- Cassandra Cluster → ???
Így úgy tűnik, hiányzik egy további entitás, amely lehetővé tenné, hogy az egész Cassandra klasztert egyszerre kezeljük. De ha valami hiányzik, létrehozhatjuk! A Kubernetes számára erre szolgál a saját erőforrások meghatározásának mechanizmusa — .
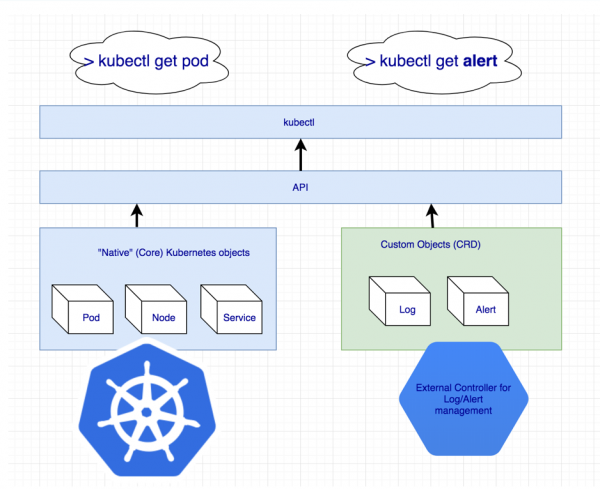
További erőforrások bejelentése naplózásra és értesítésekre
De a Custom Resource önmagában nem jelent semmit: hiszen szükség van egy vezérlőre. Lehet, hogy szükség lesz a …
4. pod-ok azonosítása
A fenti pontban megállapodtunk, hogy egy Cassandra-nód egy pod-nak felel meg a Kubernetes-ben. Az IP-címek a pod-okon viszont minden alkalommal mások lesznek. A Cassandra-nódban való azonosítás pontosan az IP-cím alapján történik... Ezért a pod törlése után a Cassandra klaszter új csomópontot fog hozzáadni magához.
Van megoldás, és nem is egy:
- Nyilvántarthatjuk a hosztok azonosítóit (UUID-kat, amelyek egyértelműen azonosítják a Cassandra példányokat) vagy az IP-címeket, és mindezt tárolhatjuk valamilyen struktúrákban/táblákban. A módszernek két fő hátránya van:
- Versenyhelyzet keletkezésének kockázata, ha egyszerre két nód meghibásodik. A visszaállítás után a Cassandra nódok egyszerre fognak IP-címet kérni a táblából, és versenyezni fognak ugyanazért az erőforrásért.
- Ha a Cassandra nód elveszti az adatait, már nem tudjuk azonosítani.
- A második megoldás kis trükknek tűnik, de ennek ellenére: létrehozhatunk ClusterIP-szolgáltatást minden Cassandra nód számára. Ennek a megvalósításnak a problémái:
- Ha a Cassandra klaszterben nagyon sok nód van, rengeteg szolgáltatást kell létrehoznunk.
- A ClusterIP lehetősége iptables-en keresztül valósul meg. Ez problémát okozhat, ha a Cassandra klaszterben sok (1000… vagy akár 100?) nód van. Bár megoldhatja ezt a problémát.
- A harmadik megoldás a Cassandra nódok számára, hogy nódhálózatot használjunk a podok külön hálózata helyett az
hostNetwork: truebeállításának engedélyezésével. Ez a módszer bizonyos korlátozásokat imposztál:- A nódok cseréjére. Új nódnak azt a régi IP-címet kell viselnie, mint az előzőnek (felhőszolgáltatók, mint az AWS, GCP esetén ez gyakorlatilag lehetetlen);
- A klaszter nódhálózatának használatával elkezdünk versenyezni a hálózati erőforrásokért. Ennek következtében problematikus lehet több mint egy pod-ot kitenni a klaszter egy nódjára Cassandra-val.
5. Biztonsági mentések
Szeretnénk ütemezett időközönként teljes verziót készíteni egy Cassandra nód adataiból. A Kubernetes kényelmes lehetőséget kínál a használatával, de itt a Cassandra maga állít akadályt.
Emlékeztetnék arra, hogy a Cassandra adatai egy része a memóriában tárolódik. Ahhoz, hogy teljes biztonsági mentést készíthessünk, az adatokat a memóriából (Memtables) át kell vinni a lemezekre (SSTables). Ekkor a Cassandra nód leállítja a kapcsolatok fogadását, teljesen kiesik a klaszter munkájából.
Ezután készül el a biztonsági mentés (snapshot) és mentésre kerül a séma (keyspace). Itt kiderül, hogy a sima mentés nem segít: meg kell őrizni az adatidentitásokat, amelyekért a Cassandra csomópont felelős - ezek speciális tokenek.
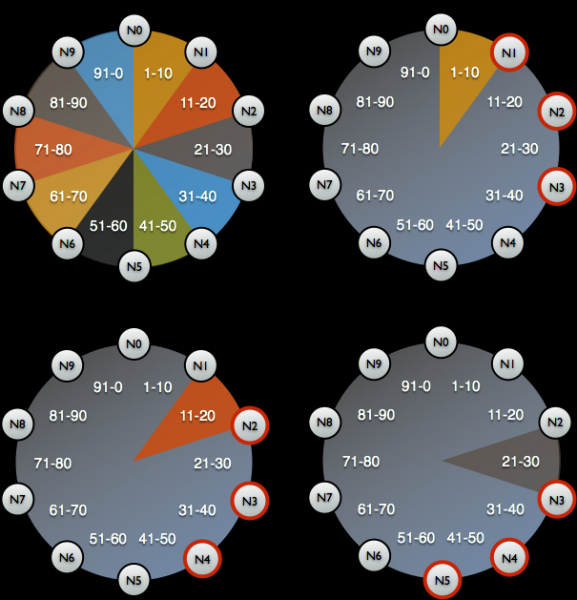
A tokenek elosztása a Cassandra csomópontok által felelt adat azonosításához.
A Google-tól származó Cassandra mentési példaskript Kubernetes alatt itt található: . Az egyetlen dolog, amit a szkript nem vesz figyelembe, az az adatok törlése a csomópontból a snapshot készítése előtt. Vagyis a mentés nem a jelenlegi állapotot, hanem az azt megelőzőt hajtja végre. De így nem kell leállítani a csomópontot, ami teljesen logikusnak tűnik.
set -eu

if [[ -z "$1" ]]; then
  info "Kérjük, adjon meg egy keyspace-t"
  exit 1
fi

KEYSPACE="$1"

result=$(nodetool snapshot "${KEYSPACE}")

if [[ $? -ne 0 ]]; then
  echo "Hiba a snapshot készítésekor"
  exit 1
fi

timestamp=$(echo "$result" | awk '/Snapshot directory: / { print $3 }')

mkdir -p /tmp/backup

for path in $(find "/var/lib/cassandra/data/${KEYSPACE}" -name $timestamp); do
  table=$(echo "${path}" | awk -F "[/-]" '{print $7}')
  mkdir /tmp/backup/$table
  mv $path /tmp/backup/$table
done


tar -zcf /tmp/backup.tar.gz -C /tmp/backup .

nodetool clearsnapshot "${KEYSPACE}"
Bash-skript példa egy Cassandra csomópont mentésére
Kész megoldások Cassandra számára Kubernetes alatt
Mit használnak most a Cassandra Kubernetes telepítésére, és melyik a legjobban megfelel az adott követelményeknek?
1. StatefulSet vagy Helm chart alapú megoldások
A StatefulSets alapvető funkcióinak használata a Cassandra klaszter indításához jó választás. Helm chart és Go sablonok segítségével a felhasználónak rugalmas felületet lehet biztosítani a Cassandra telepítéséhez.
Általában ez jól működik… amíg valami váratlan nem történik - például egy csomópont meghibásodása. A Kubernetes alapértelmezett eszközei egyszerűen nem tudják figyelembe venni a fent leírt tulajdonságokat. Ezen kívül ez a megközelítés nagyon korlátozott abban, hogy mennyire bővíthető összetett használat során: csomópontok cseréje, mentés, helyreállítás, monitorozás stb.
Képviselők:
- ;
- .
Mindkét chart egyaránt jó, de a fent leírt problémáknak ki van téve.
2. Kubernetes Operator alapú megoldások
Ezek az opciók sokkal érdekesebbek, mivel széleskörű lehetőségeket kínálnak a klaszter kezelésére. A Cassandra operátor, mint bármely más adatbázis esetében, egy jó minta a Sidecar Controller CRD:
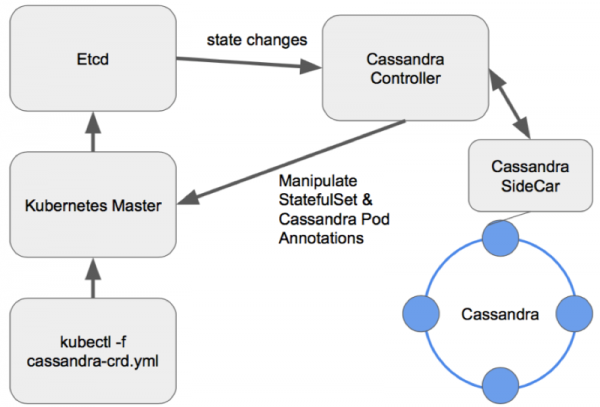
A Cassandra jól megtervezett operátorában a csomópontok kezelési sémája
Nézzük meg a meglévő operátorokat.
1. Cassandra-operator az instaclustr-tól
- Készültség: Alpha
- Licenc: Apache 2.0
- Megvalósítva: Java
Ez igazán ígéretes és aktívan fejlődő projekt egy olyan cégtől, amely menedzselt Cassandra telepítéseket kínál. Mint már említve lett, egy sidecar konténert használ, amely HTTP-n keresztül fogad parancsokat. Java nyelven íródott, ezért néha hiányzik neki a client-go könyvtár fejlettebb funkcionalitása. Az operátor egy adatközpontra (Datacenter) belső Rackek támogatását sem kínálja.
Ennek ellenére az operátor rendelkezik olyan előnyökkel, mint a monitorozás támogatása, a CRD segítségével történő magas szintű klaszter irányítás, és még a biztonsági mentések készítéséről szóló dokumentáció is.
2. Navigator a Jetstack-től
- Készültség: Alpha
- Licenc: Apache 2.0
- Megvalósítva: Golang
Ez az operátor a DB-as-a-Service telepítésére lett kifejlesztve. Jelenleg két adatbázist támogat: Elasticsearch-t és Cassandra-t. Olyan érdekes megoldásokat tartalmaz, mint az adatbázis hozzáférésének ellenőrzése RBAC által (ehhez saját, külön navigator-apiserver-t indítanak el). Érdekes projekt, amit érdemes lenne megfontolni, azonban az utolsó commit másfél éve történt, ami nyilvánvalóan csökkenti a potenciálját.
3. Cassandra-operator a vgkowski-tól
- Készültség: Alpha
- Licenc: Apache 2.0
- Megvalósítva: Golang
Nem vették őt "komolyan", mivel az utolsó commit a tárolóba több mint egy éve történt. Az operátor fejlesztése elhagyatott: az utolsó támogatott Kubernetes verzió a 1.9.
4. Cassandra-operator a Rook-tól
- Készültség: Alpha
- Licenc: Apache 2.0
- Megvalósítva: Golang
Ez az operátor nem fejlődik olyan gyorsan, ahogy szeretnénk. Jól átgondolt CRD struktúrával rendelkezik a klaszter irányítására, megoldja a csomópontok azonosításának problémáját a ClusterIP-vel ellátott szolgáltatáson keresztül (ez a bizonyos "hack")... de jelenleg ennyi. Jelenleg nincs beépített monitorozás és biztonsági mentés (egyébként a monitorozással mi ). Érdekes dolog, hogy ezzel az operátorral a ScyllaDB-t is telepíthetjük.
NB: Ezt az operátort néhány apró módosítással használtuk az egyik projektünkben. Az operátor működése során (~4 hónapnyi működés alatt) nem tapasztaltunk problémát.
5. CassKop az Orange-tól
- Készültség: Alpha
- Licenc: Apache 2.0
- Megvalósítva: Golang
A legfiatalabb operátor a listában: az első commit 2019. május 23-án történt. Már most számos funkcióval rendelkezik a listánkból, amelyek részleteit a projekt tárolójában találhatók. Az operátor a népszerű operator-sdk alapjaira épül. Beépített monitorozást támogat. A más operátoroktól való fő eltérése, hogy , amely Pythonban készült és a Cassandra csomópontok közötti kommunikációra használják.
Következtetések
A Cassandra Kubernetesbe történő áttelepítésének megközelítései és lehetséges variációi önmagukért beszélnek: a téma keresett.
Ebben a szakaszban a fent leírt bármely dolgot a saját felelősségére próbálhatja ki: egy fejlesztő sem garantálja a megoldásaik 100%-os működését a produkciós környezetben. De már most sok termék ígéretesen néz ki, hogy kipróbálható legyen fejlesztési standokon.
Azt hiszem, a jövőben ez a nő a hajón hasznos lesz!
P.S.
Olvasson további információkat a blogunkban:
- «»;
- «»;
- «»;
- «».
Forrás: habr.com
