

A Highload++ és a DataFest Minsk 2019-es előadásaim alapján.
Manapság a levelezés sokak számára elengedhetetlen része az online életnek. Ezen keresztül üzleti levelezést folytatunk, fontos pénzügyi információkat tárolunk, szállásfoglalásokat bonyolítunk, rendeléseket intézünk és még sok mást. 2018 közepén kidolgoztuk a levelezés fejlesztési termékstratégiáját. Milyennek kellene lennie a modern e-mailnek?
Az e-mailnek olyan intelligensnek, vagyis segítenie kell a felhasználókat az egyre növekvő információtengerben való tájékozódásban: szűrni, strukturálni és a legkényelmesebb módon bemutatni az információt. Emellett hasznosnak, lehetővé téve különböző feladatok megoldását közvetlenül a levelező fiókban, például bírságok kifizetését (amely funkciót sajnos én is használok). És természetesen a levélnek információvédelmet is kell biztosítania, kiszűrve a spamet és védve a hackelésektől, tehát biztonságosnak kell lennie. biztonságosnak.
Ezek a megközelítések számos kulcsfontosságú feladatot határoznak meg, amelyek közül sok hatékonyan megoldható gépi tanulás segítségével. Íme néhány példa a már működő funkciókra, amelyek stratégiai keretén belül készültek – egy minden irányra.
- Intelligens válasz. A levelezésben található egy intelligens válasz funkció. A neurális hálózat elemzi a levél szövegét, megérti a jelentését és célját, és ennek eredményeként három legmegfelelőbb válaszváltozatot javasol: pozitív, negatív és semleges. Ez jelentősen segít megtakarítani az időt a válaszok megfogalmazásakor, és gyakran lehetővé teszi a nem szokványos és szórakoztató válaszokat.
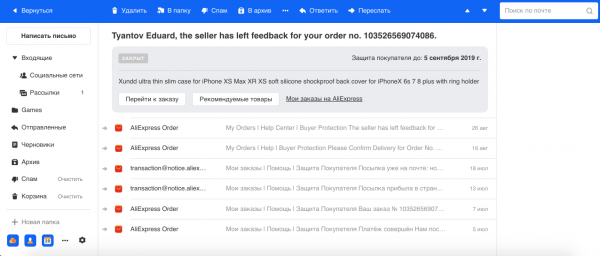
- A levelek csoportosítása, amelyek az internetes boltokkal kapcsolatosak. Gyakran vásárolunk az interneten, és általában a boltok minden megrendeléshez több levelet is küldenek. Például az Aliexpress, a legnagyobb szolgáltatás, sok e-mailt küld egy rendelésről, és mértékadó esetben a számuk elérheti a 29-et. Ezért a Named Entity Recognition modell segítségével kiemeljük a rendelési számot és egyéb információkat a szövegből, és csoportosítjuk az összes levelet egy szálba. Továbbá az áttekinthető információt a rendelésről külön szalagon mutatjuk be, ami megkönnyíti ennek a levélfajta kezelését.

- Adathalászat ellen. A phishing attack is a particularly dangerous type of fraudulent email used by criminals to acquire sensitive financial information (including user credit card information) and login credentials. Such emails mimic legitimate ones sent by services, even visually. Therefore, using Computer Vision, we recognize logos and the design style of emails from major companies (like Mail.ru, Sber, Alfa) and take this into account alongside text and other signs in our spam and phishing classifiers.
Gépi tanulás
A bit about machine learning in email systems in general. Email is a high-load system: on average, around 1.5 billion emails pass through our servers daily for 30 million daily active users. About 30 machine learning systems support all necessary functions and features.
Each email goes through a comprehensive classification pipeline. First, we filter out spam and retain good emails. Users often do not notice the anti-spam system at work, as 95—99% of spam does not even reach the respective folder. Spam detection is a very important part of our system and the most challenging, as the field of anti-spam requires constant adaptation between protection systems and attacks, posing a continuous engineering challenge for our team.
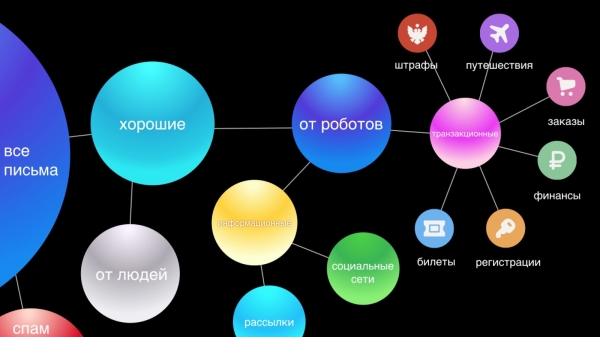
Next, we differentiate emails from people and robots. Emails from people are the most important, so we provide functions like Smart Reply for them. Emails from robots are divided into two categories: transactional—these are important emails from services, such as purchase or hotel reservation confirmations, finances; and informational—these include business ads and discounts.
We believe that transactional emails are as significant as personal correspondence. They need to be readily accessible, as it is often necessary to quickly find information about an order or a flight reservation, and we waste time searching for these emails. Therefore, for convenience, we automatically categorize them into six main categories: travel, orders, finances, tickets, registrations, and finally, fines.
Az információs levelek a legszámszerűbb, és valószínűleg a legkevésbé fontos csoport, amely nem igényel azonnali reagálást, mivel a felhasználó életében nem történik lényeges változás, ha nem olvassa el ezeket a leveleket. Az új felületünkben ezeket két szálba rendezzük: közösségi média és hírlevelek, így vizuálisan rendezettebbé téve a beérkező leveleket, és csak a fontos leveleket hagyva szem előtt.
Működtetés
A sok rendszer üzemeltetése számos nehézséget okoz. A modellek idővel romlanak, akárcsak bármely szoftver: megjelennek hibák, a gépek leállnak, és a kódok elavulnak. Emellett az adatok folyamatosan változnak: új információk kerülnek hozzáadásra, a felhasználói viselkedés mintái átalakulnak stb., ezért egy modell kellő támogatás hiányában fokozatosan egyre rosszabbul fog működni.
Azt sem szabad elfelejteni, hogy minél mélyebben hatol be a gépi tanulás a felhasználók életébe, annál nagyobb befolyással bír a környezetére, és ennek következményeként annál nagyobb pénzügyi veszteségeket vagy nyereségeket érhetnek el a piaci szereplők. Ezért egyre több területen alkalmazkodnak a szereplők a gépi tanulási algoritmusokhoz (klasszikus példák – reklám, keresés és már említett spam elleni védelem).
A gépi tanulási feladatoknak egy másik jellemzője is van: bármilyen, legyen az apró, változtatás a rendszerben sok munkát generálhat a modellel: adatkezelés, újratanulás, telepítés, ami hetekbe vagy hónapokba is telhet. Ezért minél gyorsabban változik a környezet, amelyben a modellek működnek, annál több erőfeszítést igényel a fenntartásuk. A csapat sok rendszert létrehozhat, és örülhet neki, de szinte minden erőforrást a fenntartásukra használhat, anélkül, hogy új dolgokat tudna létrehozni. Ezzel a helyzettel egyszer találkoztunk a spam elleni csapatban. Nyilvánvaló következtetést vontunk le, hogy a karbantartást automatizálni kell.
Automatizálás
Mit lehet automatizálni? Valójában szinte mindent. Kiemeltem négy irányt, amelyek meghatározzák a gépi tanulás infrastruktúráját:
- adatgyűjtés;
- továbbképzés;
- telepítés;
- tesztelés & monitoring.
Ha a környezet instabil és folyamatosan változik, akkor az összes infrastruktúra a modell körül sokkal fontosabb, mint maga a modell. Ez lehet egy régi, jó öreg lineáris klasszifikáló, de ha a jeleket megfelelően adják meg benne, és jó visszajelzést alakítanak ki a felhasználóktól, akkor sokkal jobban fog működni, mint a legújabb technológiájú modellek mindenféle sallanggal.
Visszajelzési ciklus
Ez a ciklus magában foglalja az adatok gyűjtését, a modell továbbképzését és telepítését — lényegében a modell frissítésének teljes ciklusát. Miért fontos ez? Nézd meg a regisztrációs grafikonokat:
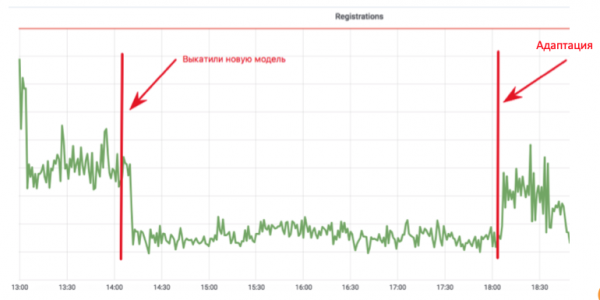
A gépi tanulás fejlesztője bevezette a botellenes modellt, amely megakadályozza a botok e-mail-registrációját. A grafikon a valós felhasználókra korlátozódik. Minden csodálatos! De négy óra múlva a botgyártók módosítják a szkripteiket, és minden visszatér a régi kerékvágásba. Ebben a bevezetésben a fejlesztő egy hónapot töltött jelek hozzáadásával és a modell továbbképzésével, de a spammer négy óra alatt képes volt alkalmazkodni.
Annak érdekében, hogy a dolog ne legyen annyira fájdalmas, és ne kelljen mindent újra csinálni, eleve azon kell gondolkodni, hogy milyen lesz a visszajelzési ciklus, és mit fogunk tenni, ha a környezet változik. Kezdjük az adatok gyűjtésével — ez az üzemanyag algoritmusaink számára.
Adatgyűjtés
Nyilvánvaló, hogy a modern neurális hálózatoknál minél több adat, annál jobb, és ezeket alapvetően a termék felhasználói generálják. Segíthetnek nekünk a felhasználók az adatok címkézésével, de ezzel nem szabad visszaélni, mert a felhasználóknak egy idő után elegük lesz az Ön modelljeinek továbbképzéséből, és áttérnek egy másik termékre.
Az egyik leggyakoribb hiba (itt Andrew Ng-re utalok) az, hogy túlzottan a tesztadatok metrikáira összpontosítunk, ahelyett, hogy a felhasználói visszajelzéseket figyelembe vennénk, ami valójában a minőség fő mércéje, hiszen terméket a felhasználó számára készítünk. Ha a felhasználónak nem világos vagy nem tetszik a modell működése, akkor az mind hiábavalóság.
Ezért a felhasználónak mindig lehetősége kell, hogy legyen szavazni, eszközt kell adnunk neki a visszajelzéshez. Ha azt hisszük, hogy egy e-mail a pénzügyekkel kapcsolatos, azt fel kell címkéznünk „pénzügyek” témában, és egy gombot kell rajzolnunk, amelyre a felhasználó rákattinthat, és megmondhatja, hogy ez nem pénzügyek.
A visszajelzés minősége
Beszéljünk a felhasználói visszajelzés minőségéről. Először is, Ön és a felhasználó eltérő jelentéseket tulajdoníthat ugyanannak a fogalomnak. Például ön és a termékmenedzserek úgy gondolják, hogy a „pénzügyek” a banktól érkező levelek, míg a felhasználó úgy véli, hogy a nagymamától érkező levelet a nyugdíjáról szintén a pénzügyek közé sorolhatjuk. Másodszor, vannak felhasználók, akik logika nélkül nyomkodják a gombokat. Harmadszor, a felhasználó mélyen tévedhet a következtetéseiben. Egy élénk példa a gyakorlatunkból — a klasszifikáló bevezetése , ami egy meglehetősen szórakoztató spam típus, amikor a felhasználónak azt javasolják, hogy szerezzen meg néhány millió dollárt egy hirtelen felfedezett távoli rokonától Afrikában. A klasszifikáló bevezetése után ellenőriztük a „Nem spam” kattintásokat ezekre a levelekre, és kiderült, hogy ezek 80% -a zamatos nigériai spam, ami azt mutatja, hogy a felhasználók rendkívül naivak lehetnek.
Ne feledjük, hogy nemcsak emberek nyomkodnak gombokat, hanem különféle botok is, amelyek böngészőnek álcázva magukat. Tehát a nyers visszajelzés nem alkalmas a tanulásra. Mit tehetünk ezzel az információval?
Két megközelítést alkalmazunk:
- Kapcsolódó ML visszajelzés. Például van egy online botellenes rendszerünk, amely, amint már említettem, gyors döntést hoz korlátozott számú jellemző alapján. És van egy második, lassú rendszer, amely utólag működik. Ennek több adata van a felhasználóról, a viselkedéséről stb. Ennek következtében a legmegalapozottabb döntést hozzák meg, így nagyobb pontossággal és teljességgel bír. Az e rendszerek közötti munkaeltérést az elsőnek adatokként irányíthatjuk a tanuláshoz. Így az egyszerűbb rendszer mindig megpróbál közelíteni a bonyolultabb teljesítményéhez.
- Kattintások klasszifikálásaEgyszerűen osztályozhatjuk a felhasználók minden kattintását, értékelve annak érvényességét és felhasználhatóságát. Így járunk el az e-mailes spam szűrés során, felhasználva a felhasználó jegyeit, történelmét, a feladó jellemzőit, a szöveget és a klasszifikátorok teljesítményét. Végül egy automatikus rendszert kapunk, amely érvényesíti a felhasználói visszajelzéseket. Mivel ennek az újratanítása lényegesen ritkábban szükséges, a működése alapvetővé válhat minden más rendszer számára. Az alapvető prioritás ebben a modellben a precizitás, mivel a modell rohamosan növekvő mennyiségű pontatlan adaton történő betanítása következményekkel járhat.
Miközben tisztítjuk az adatokat és újratanítjuk a ML-rendszereinket, nem szabad elfelejteni a felhasználókat, mert számunkra a grafikonon megjelenő ezer- és milliók hiba statisztika, de a felhasználónak minden egyes hiba tragédia. A felhasználónak valahogy együtt kell élnie a termékben található hibával, de a visszajelzés után elvárja, hogy a jövőben hasonló helyzetek ne forduljanak elő. Ezért fontos, hogy a felhasználóknak ne csak szavazási lehetőséget adjunk, hanem lehetőséget is arra, hogy javítsák a ML rendszerek viselkedését, például személyes heuristikák létrehozásával minden egyes visszajelzési kattintásra; az e-mailek esetében ez lehetőséget jelent arra, hogy az adott felhasználó számára szűrni lehessen az ilyen leveleket a feladó és a téma alapján.
Emellett valamilyen jelentés vagy támogatási kérelem alapján félautomatikus vagy manuális módszerrel kell finomítani a modellt, hogy más felhasználók is elkerüljék a hasonló problémákat.
Heuristikák az oktatáshoz
A következő észlelési és javító modellekkel kapcsolatban két probléma merül fel. Az első az, hogy a folyamatosan növekvő számú javító eszköz fenntartása nehéz, nem is beszélve a minőségükről és a hosszú távú működésükről. A második probléma az, hogy a hiba nem feltétlenül gyakori, és néhány kattintás nem elegendő a modell újratanításához. Úgy tűnik, hogy ezt a két látszólagosan független hatást jelentősen csökkenteni lehet, ha a következő megközelítést alkalmazzuk.
- Ideiglenes javítást hozunk létre.
- Az adatokat erről a modellre irányítjuk, amely rendszeresen újratanul, beleértve az összegyűjtött adatokat is. Itt természetesen fontos, hogy a heurisztika magas precizitással bírjon, hogy ne csökkentse a tréningkészlet adatait.
- Ezután monitorozzuk a hibaüzenetek megjelenését, és ha egy idő elteltével a hibaüzenet már nem jelentkezik, és a modell teljesen átvette a szerepét, akkor nyugodtan eltávolíthatjuk. E probléma valószínűleg nem fog újból felmerülni.
Ezért a hibaüzeneteknek nagy jelentősége van. A legfontosabb, hogy a használatuk sürgős legyen, ne pedig állandó.
Újraképzés
Az újraképzés egy olyan folyamat, amely során új adatokat adunk hozzá, amelyek a felhasználóktól vagy más rendszerektől származó visszajelzésből származnak, és a meglévő modellt ezek alapján tanítjuk. Az újraképzésnek több problémája is lehet:
- A modell egyszerűen nem támogathatja az újraképzést, és csak nulláról tanulhat.
- A természet könyvében sehol sem található, hogy az újraképzés feltétlenül javítaná a termelési teljesítményt. Gyakran éppen ellenkezőleg, a minőség romlásához vezethet.
- A változások kiszámíthatatlanok lehetnek. Ez egy igencsak finom pont, amelyet mi magunk is felfedeztünk. Még ha az új modell az A/B tesztben hasonló eredményeket mutat a meglévőhöz képest, az egyáltalán nem jelenti, hogy az működése azonos lesz. Működésük eltérhet egy bizonyos százalékban, ami új hibákat hozhat létre, vagy visszahozhatja a már javított régi hibákat. A jelenlegi hibákkal kapcsolatban mi és a felhasználók már tudunk együtt élni, de ha sok új hiba merül fel, a felhasználók is zavarba jöhetnek, mivel elvárják a kiszámítható viselkedést.
Ezért a legfontosabb az újraképzés során, hogy garantáltan javítsuk a modellt, vagy legalábbis ne rontsuk el.
Amikor az újraképzésről beszélünk, az első dolog, ami eszünkbe jut, az az Aktív Tanulás megközelítése. Mit is jelent ez? Például a klasszifikáló meghatározza, hogy egy levél a pénzügyekhez tartozik-e, és a döntési határvonal köré mintákat adunk hozzá a megjelölt példákból. Ez jól működik például a hirdetések terén, ahol nagyon sok a visszajelzés, és online üzemmódban is tudjuk tanítani a modellt. Ha viszont kevés a visszajelzés, akkor egy erősen elfogult mintát kapunk, amely nem tükrözi a termelési adatok eloszlását, és ez alapján nem tudjuk értékelni a modell viselkedését a használat során.
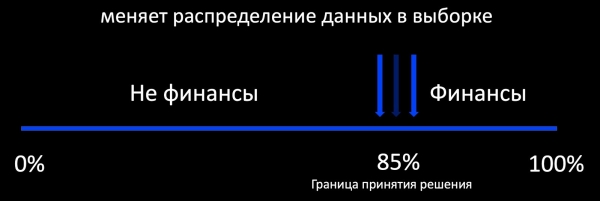
Valójában a célunk, hogy megőrizzük a régi mintákat, már ismert modelleket, és újakat szerezzünk be. Itt fontos a folytonosság. A modell, amelyet gyakran nagy nehézségekkel indítottunk el, már működik, ezért támaszkodhatunk a teljesítményére.
A levelezésben különböző modellek alkalmazhatók: fák, lineáris modellek, neurális hálók. Mindegyikhez saját finomító algoritmust készítünk. A finomítás során nemcsak új adatok keletkeznek, hanem gyakran új jellemzők is, amelyeket figyelembe fogunk venni az alábbi algoritmusokban.
Lineáris modellek
Tegyük fel, hogy van egy logisztikus regressziónk. A modell veszteségét a következő komponensekből állítjuk össze:
- LogLoss új adatokon;
- új jellemzők súlyait regularizáljuk (a régieket nem érintjük);
- tanulunk a régi adatokon is, hogy megőrizzük a régi mintákat;
- és talán a legfontosabb: alkalmazzuk a Harmonic Regularization-t, amely garantálja, hogy a súlyok nem változnak drasztikusan a régi modellel szemben a norma szerint.
Mivel minden Loss komponensnek vannak együtthatói, optimális értékeket találhatunk a feladatunkhoz a keresztvalidálás során vagy a termékkövetelmények alapján.
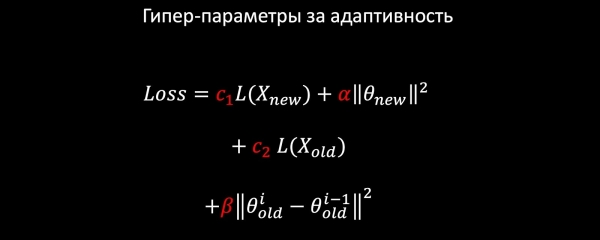
Fák
Térjünk át a döntési fákról. Kifejlesztettük a következő algoritmust a fák finomításához:
- A termelésben 100–300 fa alkotta erdő működik, amelyet a régi adathalmazon képeztek.
- A végén M = 5 fát eltávolítunk, és 2M = 10 új fát adunk hozzá, amelyeket az összes adathalmazon képeztünk, de a magas súlyú új adatokkal, ami természetesen garantálja a modell fokozatos változását.
Nyilvánvaló, hogy idővel a fák száma jelentősen megnő, és ezeket időszakonként csökkenteni kell, hogy megfeleljünk a határidőknek. Ehhez az átfogóan használt Knowledge Distillation (KD) módszert alkalmazzuk. Röviden a működési elvéről.
- Van egy jelenlegi »bonyolult« modelünk. Kivisszük a tréning adathalmazon, és megkapjuk a kimeneten a klasszifikációs valószínűségek eloszlását.
- Ezután a tanuló modellt (ebben az esetben egy kevesebb fát tartalmazó modellt) tanítjuk arra, hogy a modell eredményeit megismételje, az osztályok eloszlását célváltozóként használva.
- Fontos megjegyezni, hogy nem használunk semmiféle adatmodell formázást, így szabadon használhatunk tetszőleges adatokat. Természetesen a tanító mintánk a valós adatfolyamból származik, amit a tanuló modell oktatásához használunk. Így a tanító halmaz lehetővé teszi számunkra a modell pontosságának biztosítását, míg az adatfolyam minta garantálja a hasonló teljesítményt a termelési környezetben, kompenzálva a tanító minta eltolódását.
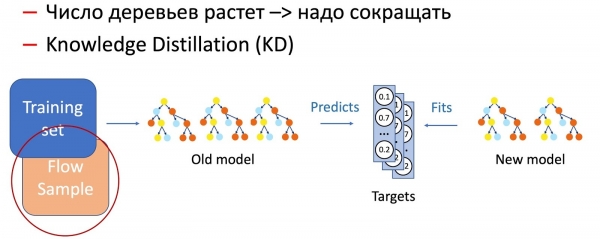
E két módszer (fák hozzáadása és a számuk időszakos csökkentése Knowledge Distillation segítségével) kombinációja új mintázatok bevezetését és a folytonosság teljes biztosítását kínálja.
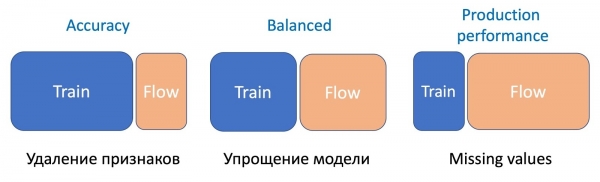
A KD segítségével a modell jellemzőivel végzett műveletek megkülönböztetésére is képesek vagyunk, például a jellemzők eltávolítására és a hiányok kezelésére. Az esetünkben több fontos statisztikai jellemző (küldőkről, szöveges hash-ekről, URL-ekről stb.) található egy adatbázisban, amely hajlamos a hibára. Az ilyen eseményekre a modell természetesen nincs felkészülve, mivel a tanító halmazban nem fordulnak elő hibás helyzetek. Ilyen esetekben a KD és az augmentáció technikáit kombináljuk: az adatok egy részénél eltávolítjuk vagy nullázzuk a szükséges jellemzőket, míg a címkék (a jelenlegi modell kimenetei) az eredetiek, a tanuló modell megtanulja ezt az eloszlást ismételni.
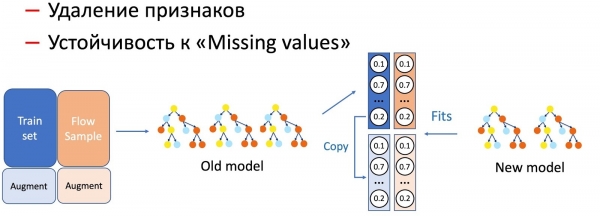
Megfigyeltük, hogy minél komolyabb manipulációt végeznek a modelleken, annál nagyobb arányban szükséges az adatfolyam.
A jellemzők eltávolítása, a legkevésbé bonyolult művelet, csupán egy kis részfolyamot igényel, mivel csak néhány jellemző változik, és a jelenlegi modell ugyanazon az adathalmazon tanult — a különbség minimális. A modell egyszerűsítése (a fák számának radikális csökkentése) már 50%-os arányt igényel. A fontos statisztikai jellemzők hiányainak kezeléséhez, amelyek komolyan befolyásolják a modell teljesítményét, még több adatfolyam szükséges, hogy a hiányokra ellenálló új modell mindenféle e-mail típusnál kiegyensúlyozottan működjön.
FastText
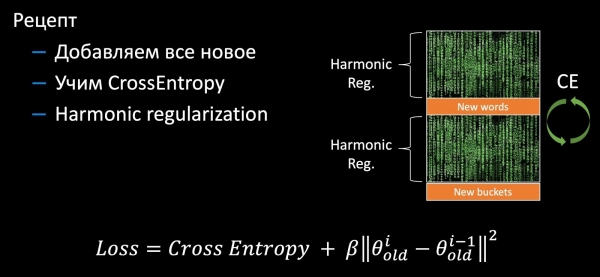
Térjünk át a FastText-ra. Emlékezzünk, hogy a szó reprezentációja (Embedding) a szó embedding-jének és annak minden betűbeli N-gram-jának, általában trigramek összegéből áll. Mivel sok trigram lehet, ezért Bucket Hashing, vagyis az egész tér átalakítása egy rögzített hash-mappá történik. Ennek eredményeképpen a súlyok mátrixa a belső réteg mérete és a szavak száma + a buktatók méretével rendelkezik.
Finomhangolás során új jellemzők keletkeznek: szavak és trigramek. A Facebook szabványos finomhangolásakor nem történik jelentős változás. Csak a régi súlyok finomhangolódnak kereszthibával az új adatokon. Így az új jellemzők nem használhatók, és ez a megközelítés az említett hátrányokkal jár, amelyek a modell előrejelzéseinek kiszámíthatatlanságával kapcsolatosak a termelés során. Ezért kicsit továbbfejlesztettük a FastText-ot. Minden új súlyt (szavakat és trigrameket) hozzáadunk, az egész mátrixot finomhangoljuk kereszthibával, és a lineáris modellhez hasonlóan harmonikus regularizálást adunk hozzá, amely garantálja a régi súlyok elhanyagolható változását.
CNN
A konvolúciós hálózatokkal kicsit bonyolultabb a helyzet. Ha a CNN utolsó rétegei finomhangolásra kerülnek, természetesen alkalmazható harmonikus regularizálás és garantálható az öröklődés. De abban az esetben, ha az egész hálózat finomhangolása szükséges, akkor ezt a regularizálást már nem lehet alkalmazni minden rétegre. Azonban van egy lehetőség a kiegészítő embeddingek tanulmányozására Triplet Loss segítségével ().
Triplet Loss
Az anti-fishing feladat példáján áttekintjük a Triplet Loss lényegét. Elvesszük a logónkat, valamint más cégek logóinak pozitív és negatív példáit. Minimalizáljuk a távolságot az elsődlegesek között, és maximalizáljuk a távolságot a másodlagosak között, ezt egy kis résekkel tesszük, hogy biztosítsuk a kategóriák nagyobb kompaktitását.
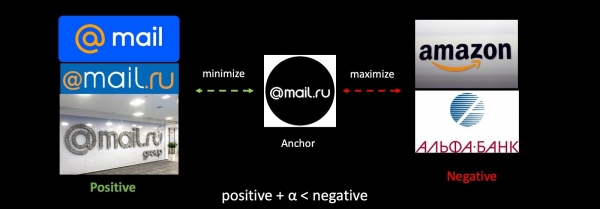
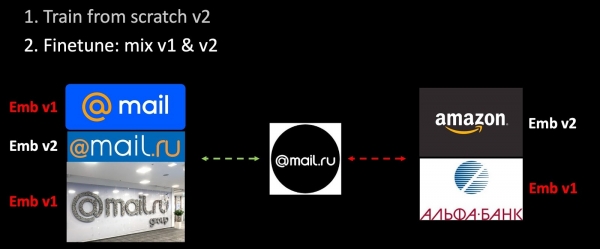
Ha finomhangoljuk a hálózatot, akkor a metrikus tér teljesen megváltozik, és teljesen inkompatibilissé válik a korábbival. Ez komoly probléma a vektorokat használó feladatokban. E probléma körüli elkerülés érdekében be fogjuk keverni a régi embeddingeket a tanulás során.
Új adatokat adtunk hozzá a tréningkészlethez, és nulláról tanítjuk a modell második változatát. A második fázisban a hálónkat finomhangoljuk: először az utolsó réteget képezzük tovább, majd a teljes hálót feloldjuk. A tripletek összeállítása során csak a beágyazások egy részét számítjuk ki az újonnan tanított modellel, a többit a régi modellel. Így a finomhangolás során biztosítjuk a v1 és v2 metrikai terek kompatibilitását. Ez egyfajta harmonikus regularizáció.
Az architektúra egészében
Ha az egész rendszert nézzük, például a spam szűrés esetében, a modellek nem izoláltak, hanem egymásba ágyazottak. Képeket, szövegeket és egyéb jellemzőket veszünk, a CNN és a Fast Text segítségével beágyazásokat kapunk. Ezt követően a beágyazásokra klasszifikálókat alkalmazunk, amelyek különböző osztályokhoz (levéltípusok, spam, logó jelenléte) pontszámokat adnak. A pontszámok és jellemzők már bekerülnek a döntési fák erdejébe a végső döntés meghozatalához. Az egyes klasszifikálók ebben a rendszerben lehetővé teszik a rendszer munkájának jobb értelmezését és a komponensek célzottabb finomhangolását, ha problémák merülnek fel, mintsem nyers formában minden adatot a döntési fákba beadni.
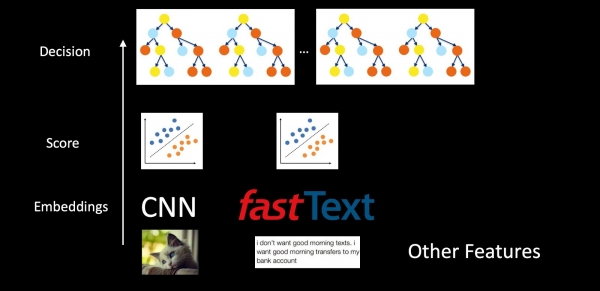
Ennek eredményeként garantáljuk a folytonosságot minden szinten. Az alsó szinten a CNN és a Fast Text esetében harmonikus regularizációt alkalmazunk, a középső klasszifikálók számára szintén harmonikus regularizációt és a pontszámok kalibrálását a valószínűségi eloszlás kompatibilitása érdekében. A döntési fák boostolása pedig inkrementálisan vagy Knowledge Distillation-nal történik.
Általánosságban a mélyen beágyazott gépi tanulási rendszer támogatása gyakran nehézségeket okoz, mivel bármely alsó szintű komponens frissítése az egész felettel jár. De mivel a mi beállításunkban minden komponens minimálisan változik és kompatibilis a korábbiakkal, az egész rendszer darabonként frissíthető anélkül, hogy újra kellene tanítani az egész struktúrát, ami lehetővé teszi a tartós fenntartását jelentős overhead nélkül.
Deploy
Már átbeszéltük az adatok gyűjtését és a különböző típusú modellek finomhangolását, ezért átérünk az éles környezetbe való telepítésükre.
A/B-tesztelés
Mint az korábban említettem, az adatok gyűjtése során általában torzított mintát kapunk, amely alapján lehetetlen értékelni a modell termelési teljesítményét. Ezért a modell telepítésekor kötelező összehasonlítani a korábbi verzióval, hogy valóban megértsük, hogyan mennek a dolgok, azaz A/B-teszteket kell végezni. Valójában a kiadás folyamata és a grafikonok elemzése viszonylag rutin feladat, és jól automatizálható. Fokozatosan 5 %, 30 %, 50 % és 100 % felhasználóra telepítjük a modelljeinket, miközben összegyűjtjük az összes rendelkezésre álló metrikát a modell válaszai és a felhasználói visszajelzések alapján. Súlyos kiugrások esetén automatikusan visszagurítjuk a modellt, míg más esetekben, elegendő számú felhasználói kattintás után, döntünk a százalék növeléséről. Végül új modellt ilyen módon 50 % -ra emeljük automatikusan, a teljes közönségre való kiadást pedig ember hagyja jóvá, bár ezt a lépést is lehet automatizálni.
Azonban az A/B-tesztelési folyamat lehetőséget ad az optimalizációra. Az a helyzet, hogy bármely A/B-teszt meglehetősen hosszú (az esetünkben 6-24 órát vesz igénybe a visszajelzések mennyiségétől függően), ami meglehetősen költségessé és korlátozott erőforrásokkal rendelkezővé teszi. Ezenkívül szükség van egy elég magas áramlási százalékra a teszthez, hogy lényegében felgyorsítsuk az A/B-teszt általános idejét (statisztikailag jelentős minta megszerzése alacsony százalékon nagyon hosszú időt vehet igénybe), ami rendkívül korlátozott A/B-slotokat eredményez. Nyilvánvaló, hogy csak a legígéretesebb modelleket kell tesztelni, amelyekből a finomhangolás során meglehetősen sokat kapunk.
E probléma megoldása érdekében külön klasszifikátort tanítottunk, amely az A/B-teszt sikerességét jósolja. Ehhez jellemzőkként a döntéshozatali statisztikát, a Precíziót, az Emlékezetet és egyéb metrikákat veszünk figyelembe a tanuló halmazban, a tartalékban és a folyó mintában. A modellt a gyártásban lévő aktuális modellel, a heurisztikákkal hasonlítjuk össze, és figyelembe vesszük a modell bonyolultságát (Complexity). Mindezeket a jellemzőket felhasználva a tesztelő történet alapján betanított klasszifikátor pontozza a jelölteket, amelyek az esetünkben fákból álló erdőket jelentenek, és döntést hoz arról, hogy melyiket engedjük az A/B-tesztbe.
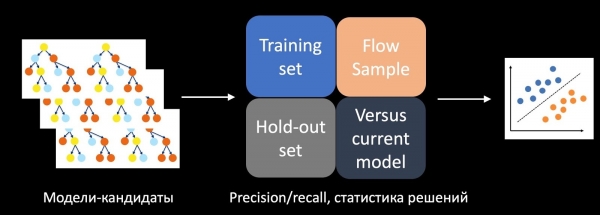
A megvalósítás pillanatában ez a megközelítés többszörösére növelte a sikeres A/B testek számát.
Tesztelés & monitorozás
A tesztelés és a monitorozás, meglepő módon, nem árt az egészségünknek, sőt, éppen ellenkezőleg, javítja azt és megszabadít a felesleges stressztől. A tesztelés megakadályozza a hibákat, míg a monitorozás lehetővé teszi, hogy időben észrevesszük azokat, csökkentve ezzel a felhasználókra gyakorolt hatást.
Fontos megérteni, hogy előbb-utóbb a rendszered mindig hibázni fog — ez a szoftverfejlesztés ciklusával kapcsolatos. A rendszer fejlesztésének elején sok a hiba, amíg minden nem stabilizálódik és a fő újítási szakasz le nem zárul. De idővel a kaotikus tényezők újra bonyodalmakat okoznak, és ismét hibák lépnek fel — a környező komponensek elöregedése és az adatok megváltozása következtében, ahogyan azt az elején említettem.
Itt szeretném hangsúlyozni, hogy bármely gépi tanulási rendszert a teljes életciklusa folyamán hozott haszna szempontjából kell megvizsgálni. Az alábbi grafikonon a ritka spam típus nyomkövető rendszerének működését szemléltetjük (a grafikonon a vonal a nulla körüli tartományban található). Egyszer egy helytelenül gyorsítótárazott jellemző miatt megzavarodott. Fura módon nem volt monitorozás az anomális működésre, ennek következtében a rendszer elkezdte a leveleket a spam mappába helyezni a döntéshozatal határvonalán, nagyszámban. A következmények kijavítása ellenére a rendszer annyiszor hibázott, hogy az öt év alatt sem térül meg. A modell életciklusa szempontjából ez teljes kudarc.
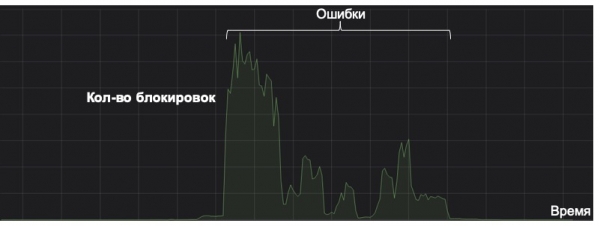
Ezért a monitorozás, mint olyan egyszerű dolog, kulcsfontosságú szerepet játszhat a modell életében. A standard és nyilvánvaló metrikák mellett figyelembe vesszük a válaszok eloszlását és a modell pontszámait, valamint a kulcsfontosságú jellemzők értékeinek eloszlását. A KL-divergencia segítségével összehasonlíthatjuk a jelenlegi eloszlást a történetivel vagy az A/B teszt során észlelt értékeket a többi folyamattal, így észlelve a modell anomáliáit és időben visszavonva a módosításokat.
A legtöbb esetben az első rendszerváltozatainkat egyszerű heurisztikákkal vagy modellekkel indítjuk, amelyeket később monitoringra használunk. Például figyeljük a NER-modellt az adott online boltokkal összehasonlítva a reguláris kifejezésekkel, és ha a klasszifikáló lefedettsége csökken velük szemben, akkor megvizsgáljuk az okokat. Ez egy újabb hasznos alkalmazása a heurisztikáknak!
Összegzés
Nézzük át még egyszer a cikk kulcsfontosságú gondolatait.
- Fibdék. Mindig a felhasználóra gondolunk: hogyan fog élni a hibáinkkal, hogyan tudja azokat jelenteni. Ne feledjük, hogy a felhasználók nem a modellképzéshez szükséges tiszta visszajelzés forrásai, és ezt kiegészítő ML-rendszerekkel kell tisztítani. Ha nincs lehetőségünk felhasználói jeleket gyűjteni, alternatív visszajelzési forrásokat keresünk, például kapcsolódó rendszereket.
- Újraképzés. Itt a legfőbb a folytonosság, ezért támaszkodunk a jelenlegi éles modellre. Az új modelleket úgy tanítjuk, hogy ne térjenek el jelentősen az előzőtől harmonikus regularizálás és hasonló trükkök révén.
- Deploy. Az automatikus telepítés a metrikák alapján jelentősen csökkenti a modellek bevezetésére fordított időt. Statisztikák és a döntéshozatali eloszlás monitorozása, valamint a felhasználói hamis pozitívok száma kötelező a nyugodt alváshoz és a produktív hétvégékhez.
Remélem, hogy amit olvastak, segít gyorsabban fejleszteni ML rendszereiket, felgyorsítani a piacra lépést és megbízhatóbbá tenni őket, csökkentve a munka miatti stressz szintjét.
Forrás: habr.com
