

Szeretném megosztani veletek az első sikeres tapasztalatomat a Postgres adatbázis teljes működőképességének helyreállításáról. Hat hónappal ezelőtt ismerkedtem meg a Postgres DBMS-szel, előtte nem volt tapasztalatom adatbázisok adminisztrálásában.
Fél-devops mérnökként dolgozom egy nagy IT cégnél. Cégünk alkalmazásokat fejleszt nagy terhelésű szolgáltatásokhoz, én pedig a működésért, karbantartásért és telepítésért felelek. Az előttem álló feladat egy alkalmazás frissítése volt egy szerveren. Az alkalmazást Django nyelven írták, a frissítés során migrációk (az adatbázis struktúrájának megváltoztatása) zajlanak, és a folyamat előtt teljes adatbázis-dumpot készítünk a pg_dump standard programmal.
A dump készítése során váratlan hiba merült fel (Postgres verzió – 9.5):
pg_dump: a «ws_log_smevlog» tábla tartalmának dumpolása meghiúsult: PQgetResult() nem sikerült. pg_dump: a szerver üzenete: HIBA: érvénytelen oldal a 4123007-es blokkjában a relatton base/16490/21396989. pg_dump: A parancs a következő volt: COPY public.ws_log_smevlog [...]. pg_dump: [párhuzamos archívum] egy munkafolyamat váratlanul leállt. Hiba „érvénytelen oldal a blokkban” fájl rendszer szintű problémákra utal, ami nem túl jó. Különböző fórumokon azt javasolták, hogy végezzünk el FULL VACUUM függvény segítségével, zero_damaged_pages e problémának a megoldására. Nos, próbálkozzunk…
Fel készülés a helyreállításra
FIGYELEM! Mindenképpen készítsen biztonsági másolatot a Postgres adatbázisról bármilyen helyreállítási kísérlet előtt. Ha virtuális gépet használ, állítsa le az adatbázist, és készítsen pillanatfelvételt. Ha nincs lehetőség pillanatfelvétel készítésére, állítsa le az adatbázist, és másolja a Postgres könyvtár tartalmát (beleértve a wal fájlokat) egy megbízható helyre. A legfontosabb dolog, ami a mi ügyünkben van – hogy ne rontsunk a helyzeten. Olvassa el .
Mivel az adatbázisom alapvetően működött, egy hagyományos adatbázis dumpra korlátoztam a dolgot, de kizártam a sérült adatokat tartalmazó táblát (opció -T, —exclude-table=TABLE a pg_dump-ban.
A szerver fizikai volt, pillanatfelvételt készíteni nem volt lehetséges. A biztonsági mentés elkészült, folytassuk tovább.
Fájl rendszer ellenőrzése
A helyreállítási kísérlet előtt meg kell bizonyosodni arról, hogy a fájlrendszerünk rendben van. és ha hibák vannak, azokat ki kell javítani, mert különben csak rosszabbá tehetjük a helyzetet.
Az én esetemben a fájlrendszer, ahol az adatbázis volt, itt volt csatlakoztatva „/srv” és a típusa ext4 volt.
Az adatbázis leállítása: systemctl stop postgresql@9.5-main.service és ellenőrizzük, hogy a fájlrendszert senki sem használja, és azt a parancs segítségével lehet eltávolítani lsof:
lsof +D /srv
Még a redis adatbázist is le kellett állítanom, mivel az is használó volt „/srv”. Ezután eltávolítottam /srv (umount).
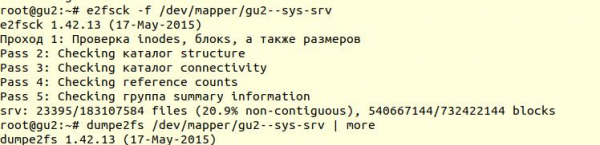
A fájlrendszer ellenőrzését a következő utilitás segítségével végeztük e2fsck a -f kapcsolóval (Kényszerített ellenőrzés, még akkor is, ha a fájlrendszer tisztának van megjelölve):
Ezután a dumpe2fs (sudo dumpe2fs /dev/mapper/gu2—sys-srv | grep checked) segítségével megbizonyosodhatunk arról, hogy az ellenőrzés valóban megtörtént:
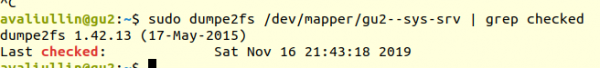
e2fsck mondja, hogy az ext4 fájlrendszer szintjén nem található probléma, ami azt jelenti, hogy folytathatjuk az adatbázis helyreállításának kísérletét, vagyis visszatérhetünk a vacuum full (természetesen a fájlrendszert vissza kell szerelni és az adatbázist el kell indítani).
Ha fizikai szervered van, mindenképpen ellenőrizd a lemezek állapotát (keresztül smartctl -a /dev/XXX) vagy a RAID vezérlőt, hogy megbizonyosodj arról, hogy a probléma nem hardveres szinten van. Az én esetemben a RAID „vas” volt, ezért megkértem a helyi adminisztrátort, hogy ellenőrizze a RAID állapotát (a szerver több száz kilométerre volt tőlem). Azt mondta, hogy nincsenek hibák, ami azt jelenti, hogy biztosan elkezdhetjük a helyreállítást.
1. kísérlet: zero_damaged_pages
Csatlakozunk az adatbázishoz a psql fiókkal, amely rendelkezik rendszergazda jogokkal. Nekünk pontosan rendszergazdára van szükségünk, mivel az opciót zero_damaged_pages csak ő tudja módosítani. Az én esetemben ez postgres:
psql -h 127.0.0.1 -U postgres -s [database_name]
Opció zero_damaged_pages szükséges, hogy figyelmen kívül hagyja az olvasási hibákat (a postgrespro webhelyéről):
Ha sérült oldalcímet észlel, a Postgres Pro általában hibát jelent és leállítja a jelenlegi tranzakciót. Ha a zero_damaged_pages kapcsoló be van kapcsolva, a rendszer figyelmeztetést ad, törli a memóriában lévő sérült oldalt és folytatja a feldolgozást. Ez a viselkedés tönkreteszi az adatokat, nevezetesen minden sort a sérült oldalon.
Kapcsoljuk be az opciót, és próbáljuk meg a tábla teljes vákuumozását végezni:
VACUUM FULL VERBOSE 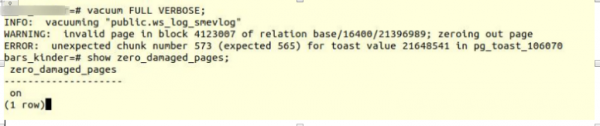
Sajnos kudarcot vallottunk.
Hasonló hibával találkoztunk:
INFO: vákuumozás "public.ws_log_smevlog"
FIGYELMEZTETÉS: érvénytelen oldal a 4123007-es blokkban a base/16400/21396989 relációban; az oldal nullázása
HIBÁZAT: váratlan darabszám 573 (várt 565) a 21648541-es tost értékhez a pg_toast_106070-ben– a hosszú adatok tárolásának mechanizmusa a PostgreSQL-ben, ha azok nem férnek el egy oldalon (alapértelmezett 8kB).
2. kísérlet: reindexelés
Az első javaslat a Google-tól nem segített. Néhány perc keresés után találtam egy második javaslatot – végezzük el a reindexálást a sérült táblázat. Ezt a tanácsot sok helyen láttam, de nem volt meggyőző. Indítsuk újra az indexelést:
reindex table ws_log_smevlog 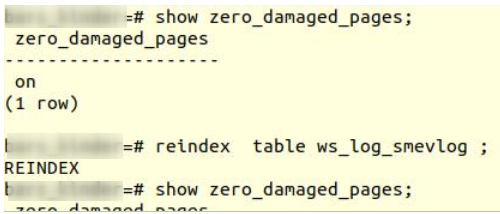
reindexálást problémák nélkül befejeződött.
Ez azonban nem segített, VACUUM FULL a program váratlanul leállt hasonló hibával. Mivel hozzászoktam a kudarcokhoz, tovább kerestem tanácsokat az interneten, és rátaláltam egy meglehetősen érdekes .
3. kísérlet: SELECT, LIMIT, OFFSET
A fenti cikkben azt javasolták, hogy nézzem át a táblázatot soronként és távolítsam el a problémás adatokat. Először meg kellett néznem az összes sort:
for ((i=0; i/dev/null || echo $i; doneAz én esetemben a táblázat tartalmazott 1 628 991 sorokat! Tényleg foglalkoznom kellett volna a de ez egy külön téma. Szombat volt, elindítottam ezt a parancsot a tmux-ban, és elmentem aludni:
for ((i=0; i/dev/null || echo $i; doneReggel úgy döntöttem, hogy ellenőrzöm a dolgok állását. Meglepődtem, amikor felfedeztem, hogy 20 óra alatt csak az adatok 2%-át sikerült átvizsgálni! 50 napot várni nem akartam. Megint egy teljes kudarc.
De nem adtam fel. Kíváncsi lettem, miért tartott ilyen sokáig a vizsgálat. A dokumentációból (újra csak postgrespro) megtudtam:
Az OFFSET megadja, hogy hány sort kell kihagyni, mielőtt elkezdené kiadni a sorokat.
Ha OFFSET és LIMIT is meg van adva, a rendszer először kihagyja az OFFSET sorokat, majd elkezdi számolni a sorokat a LIMIT korlátozására.A LIMIT alkalmazásakor fontos, hogy az ORDER BY záradékot is használjuk, hogy az eredmény sorai meghatározott sorrendben kerüljenek kiadásra. Különben kiszámíthatatlan részhalmazok jelenhetnek meg.
Nyilvánvaló, hogy a fent említett parancs hibás volt: egyrészt nem volt order by,ezért az eredmény téves lehetett. Másrészt a Postgresnek először át kellett vizsgálnia és kihagynia az OFFSET sorokat, és a növekedéssel OFFSET a teljesítmény tovább csökkent volna.
4. kísérlet: dump készítése szöveges formátumban
Ezután egy látszólag zseniális ötlet jutott eszembe: készítsek dumpot szöveges formátumban, és elemezzem az utolsó rögzített sort.
De először nézzük meg a táblázat struktúráját ws_log_smevlog.:
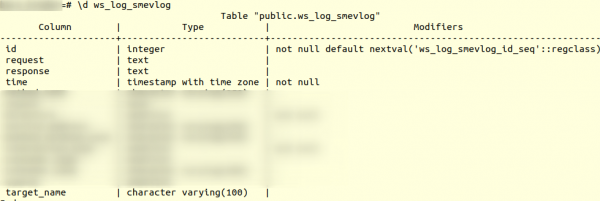
A mi esetünkben van egy oszlopunk, amely tartalmazta a sor egyedi azonosítóját (számláló). A terv a következő volt:Kezdjük el megcsinálni a dumpot szöveges formátumban (sql-parancsok formájában).
- Kezdjük el a dump készítését szöveges formátumban (SQL-parancsok formájában)
- Egy adott ponton a dump készítése megszakadt egy hiba miatt, de a szöveges fájl így is megmaradt a lemezen.
- Megnéztük a szöveges fájl végét, így megtaláltuk az utolsó sikeresen elkészült sor azonosítóját (id).
Szöveges formátumban kezdtem el készíteni a dumpot:
pg_dump -U my_user -d my_database -F p -t ws_log_smevlog -f ./my_dump.dumpA dump készítése, ahogy várható volt, a megszakadt ugyanazzal a hibával:
pg_dump: Hibaüzenet a szervertől: ERROR: invalid page in block 4123007 of relation base/16490/21396989 Ezután (erről később). megnéztem a dump végét (tail -5 ./my_dump.dump) és kiderült, hogy a dump az id-val rendelkező soron megszakadt 186 525. "Akkor a probléma a 186 526 azonosítójú sorban van, az rossz, ezt kell eltávolítani!" - gondoltam. De amikor az adatbázisban lekérdeztem:
«select * from ws_log_smevlog where id=186529"kiderült, hogy ezzel a sorral minden rendben van... A 186 530 - 186 540 közötti sorok is problémamentesen működtek. Egy újabb „zseniális ötlet” megbukott. Később rájöttem, hogy miért történt ez: amikor az adatok törlődnek vagy módosulnak a táblázatból, nem törlődnek fizikailag, hanem „halott tuple-ként” vannak megjelölve, utána jön a autovacuum és jelöli ezeket a sorokat töröltként, és lehetővé teszi a régi sorok újrafelhasználását. Az érthetőség kedvéért, ha az adatok a táblázatban változnak és az autovacuum be van kapcsolva, akkor ezek nem tárolódnak soronként.
5. kísérlet: SELECT, FROM, WHERE id=
A kudarcok erősebbé tesznek minket. Soha nem szabad feladni, végig kell menni az úton, és hinni magunkban és a lehetőségeinkben. Ezért úgy döntöttem, hogy megpróbálok még egy lehetőséget: egyszerűen megnézni az összes rekordot az adatbázisban egyesével. Tudva a táblázatom struktúráját (lásd fent), van egy id mezőnk, amely egyedi (elsődleges kulcs). A táblázatban 1 628 991 sor van és id rendben van, ami azt jelenti, hogy egyszerűen átvizsgálhatjuk őket egyesével:
for ((i=1; i/dev/null || echo $i; doneHa valaki nem érti, a parancs úgy működik, hogy soronként átnézi a táblázatot, és az stdout-ot küldi a /dev/null, de ha a SELECT parancs megbukik, akkor a hiba szövege lesz kinyomtatva (stderr a konzolra kerül) és kiír egy sor, amely tartalmazza a hibát (köszönhetően a ||, amely azt jelenti, hogy a select-nak problémái adódtak (a parancs visszatérési kódja nem 0)).
Szerencsém volt, volt létrehozva index az id mezőn. id:
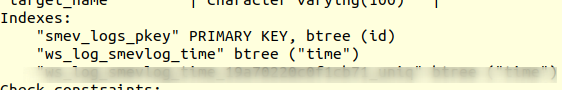
Ez azt jelenti, hogy a kívánt id-jú sor megtalálásának nem kell sok időt igénybe vennie. Elméletileg működnie kell. Nos, indítsuk el a parancsot. tmux és megyünk aludni.
Reggel azt tapasztaltam, hogy körülbelül 90 000 bejegyzést néztem át, ami valamivel több mint 5%. Nagyszerű eredmény, ha összehasonlítjuk az előző módszerrel (2%)! De nem akartam 20 napot várni...
6. kísérlet: SELECT, FROM, WHERE id >= és id <
Az ügyfél számára a DB-hez egy remek szervert kijelöltek: kétprocesszoros Intel Xeon E5-2697 v2, a mi elhelyezésünkben összesen 48 szál volt! A szerver terhelése átlagos volt, különösebb problémák nélkül körülbelül 20 szálat tudtunk kezelni. Az operatív memória is elegendő volt: összesen 384 gigabájt!
Ezért a csapatot párhuzamosítani kellett:
for ((i=1; i/dev/null || echo $i; doneItt szépen és elegánsan írhattam volna egy szkriptet, de a leggyorsabb párhuzamosítási módszert választottam: a 0-1628991 tartományt manuálisan 100 000 bejegyzésre bontani és külön-külön 16 parancsot indítani, mint például:
for ((i=N; i/dev/null || echo $i; doneDe ez még nem minden. Elvileg az adatbázisra való csatlakozás is elmond időt és rendszererőforrásokat. 1 628 991-et csatlakoztatni nem volt túl ésszerű, ugye? Ezért egy kapcsolódással 1000 sort kellene kinyernünk az egy helyett. Ennek eredményeként a parancs így alakult:
for ((i=N; i=$i and id/dev/null || echo $i; done16 ablakot nyitunk a tmux sessionben és elindítjuk a parancsokat:
1) for ((i=0; i=$i and id/dev/null || echo $i; done
2) for ((i=100000; i=$i and id/dev/null || echo $i; done
…
15) for ((i=1400000; i=$i and id/dev/null || echo $i; done
16) for ((i=1500000; i=$i and id/dev/null || echo $i; done
Másnap megkaptam az első eredményeket! Nevezetesen (az XXX és ZZZ értékek már nem maradtak meg):
HIBA: hiányzik a darab száma 0 a toast értékhez 37837571 a pg_toast_106070-ben
829000
HIBA: hiányzik a darab száma 0 a toast értékhez XXX a pg_toast_106070-ben
829000
HIBA: hiányzik a darab száma 0 a toast értékhez ZZZ a pg_toast_106070-ben
146000
Ez azt jelenti, hogy három sor hibát tartalmaz. Az első és második problémás bejegyzés id-je 829 000 és 830 000 között volt, a harmadiké pedig 146 000 és 147 000 között. Ezután csak az volt a dolgunk, hogy megtaláljuk a problémás bejegyzések pontos id-jét. Ehhez az érintett bejegyzések tartományát 1-es léptékkel átvizsgálva az id-t azonosítjuk:
for ((i=829000; i/dev/null || echo $i; done
829417
ERROR:  unexpected chunk number 2 (expected 0) for toast value 37837843 in pg_toast_106070
829449
for ((i=146000; i/dev/null || echo $i; done
829417
ERROR:  unexpected chunk number ZZZ (expected 0) for toast value XXX in pg_toast_106070
146911
Boldog végkifejlet
Megtaláltuk a problémás sorokat. Belépünk az adatbázisba a psql-en keresztül, és megpróbáljuk azokat törölni:
my_database=# delete from ws_log_smevlog where id=829417;
DELETE 1
my_database=# delete from ws_log_smevlog where id=829449;
DELETE 1
my_database=# delete from ws_log_smevlog where id=146911;
DELETE 1
Meglepetésemre a rekordok minden probléma nélkül törlődtek, még opció nélkül is, zero_damaged_pages.
Ezután csatlakoztam az adatbázishoz, készítettem egy VACUUM FULL (szerintem nem kellett volna), és végül sikeresen készítettem biztonsági mentést a pg_dump. A dump minden hiba nélkül megtörtént! Ezzel a legbutább módszerrel sikerült megoldani a problémát. A boldogság határtalan volt, miután annyi kudarc után végre rátaláltam a megoldásra!
Hála és következtetés
Ez a tapasztalat volt az első igazi Postgres adatbázis helyreállításom. Ezt a tapasztalatot sokáig meg fogom jegyezni.
Végül szeretném megköszönni a PostgresPro-nak a orosz nyelvű dokumentáció fordítását és a , amelyek nagyon sokat segítettek a probléma elemzése során.
Forrás: habr.com
