

Ipari szoftverrendszerek fejlesztése nagy figyelmet igényel a végtermék megbízhatóságára, valamint a hibákra és leállásokra való gyors reagálásra, ha mégis bekövetkeznek. A monitoring természetesen segít hatékonyabban és gyorsabban reagálni a hibákra és leállásokra, de ez nem elegendő. Először is, nagyon nehéz követni a sok szervert – ehhez sok ember szükséges. Másodszor, jól kell érteni, hogyan működik az alkalmazás, hogy előre jelezhessük annak állapotát. Következésképpen sok emberre van szükség, akik jól értik az általunk fejlesztett rendszereket, azok mutatóit és sajátosságait. Tegyük fel, hogy még ha találunk is elegendő számú embert, akit érdekel ez a munka, rengeteg idő szükséges a betanításukhoz.
Mit tegyünk? Itt jön segítségünkre a mesterséges intelligencia. A cikkben szó lesz (prediktív karbantartás). Ez a megközelítés egyre népszerűbbé válik. Számos cikk született erről, többek között a Habr-on is. Nagy vállalatok széles körben alkalmazzák ezt a megközelítést a szervereik működésének fenntartására. Miután sok cikket tanulmányoztunk, úgy döntöttünk, hogy kipróbáljuk ezt a megközelítést. Mi lett az eredménye?
Bevezetés
A kifejlesztett szoftverrendszerek előbb-utóbb üzembe kerülnek. A felhasználónak fontos, hogy a rendszer zökkenőmentesen működjön. Ha azonban mégis rendellenes helyzet lép fel, azt a lehető legkisebb késedelemmel kell orvosolni.
A szoftverrendszer technikai támogatásának egyszerűsítése érdekében, különösen ha sok szerver van, általában monitoringprogramokat használnak, amelyek a működő szoftverrendszer metrikáit mérik, lehetőséget adnak az állapot diagnosztizálására és segítenek meghatározni, mi okozta a hibát. Ezt a folyamatot szoftverrendszer monitoringnak nevezzük.
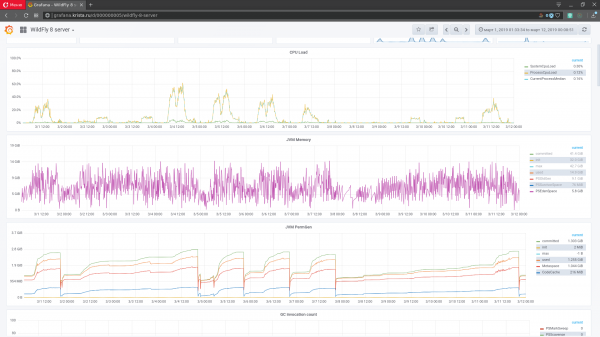
1. ábra: a grafana monitoring interfésze
A metrikák különböző mutatók, amelyek egy szoftverrendszer, a végrehajtási környezete vagy a fizikai számítási gép állapotát jelzik, amely alatt a rendszer működik, a metrikák rögzítésének időpontjában. Statikus elemzés során a metrikák adatait időbeli sorozatoknak nevezik. A szoftverrendszer állapotának megfigyeléséhez a metrikákat grafikonokon ábrázolják: az X tengely az időt, míg az Y tengely az értékeket mutatja (1. ábra). Egy működő szoftverrendszerről több ezer metrika is rögzíthető (minden csomópontból). Ezek a metrikák térbeli metrikákat (többdimenziós időbeli sorozatokat) alkotnak.
Mivel bonyolult szoftverrendszerek esetében a metrikák száma rendkívül nagy, a manuális megfigyelés komplex feladattá válik. Az adminisztrátor által elemezhető adatok mennyiségének csökkentése érdekében a megfigyelési eszközök tartalmaznak automatizált problémák felfedezésére szolgáló eszközöket. Például beállítható egy riasztás, amely aktiválódik, ha a szabad lemezterület egy megadott küszöb alá csökken. Továbbá automatikusan diagnosztizálható a szerver leállása vagy a szolgáltatás kritikus sebességcsökkenése. A gyakorlatban a megfigyelési eszközök viszonylag jól működnek a már bekövetkezett hibák észlelésében, valamint a jövőbeli hibák egyszerű tüneteinek azonosításában, de összességében a lehetséges hibák előrejelzése továbbra is nehéz feladat számukra. A metrikák manuális elemzésével történő előrejelzés szakképzett szakemberek bevonását igényli. Ez nem hatékony. A potenciális hibák többsége észrevétlen maradhat.
Az utóbbi időben a nagy szoftverfejlesztő IT cégek körében egyre népszerűbbé válik a programrendszerek úgynevezett prediktív karbantartási megközelítése. Ennek a megközelítésnek a lényege, hogy mesterséges intelligencia segítségével a hibák korai szakaszban, a rendszer leállása előtt észlelhetők, amelyek a rendszer degradálódásához vezetnek. Ez a megközelítés nem zárja ki teljesen a manuális rendszerfigyelést; inkább kiegészítője a megfigyelési folyamatnak.
A prediktív karbantartás megvalósításának fő eszköze az anomáliák keresésének feladata az időbeli sorozatokban, mivel ha anomália lép fel a adatokban nagy a valószínűsége annak, hogy egy idő után hiberálás vagy hiba léphet fel. Az anomália egy adott szoftverrendszer mutatóinak eltérése, mint például egy típusú lekérdezés végrehajtási sebességének romlása vagy a folyamatos ügyfélsessziók mellett kezelt kérések átlagos számának csökkenése.
Az anomáliák keresésének feladata szoftverrendszerek esetében sajátos jellemzőkkel bír. Elvileg minden szoftverrendszerhez szükséges a meglévő módszerek kidolgozása vagy módosítása, mivel az anomáliák keresése nagyon függ azoktól az adatoktól, amelyekben végrehajtják, és a szoftverrendszerek adatai nagyon eltérőek lehetnek a megvalósítási eszközöktől kezdve egészen addig, hogy milyen számítógépen fut a rendszer.
Az anomáliák keresésének módszerei a szoftverrendszerek leállásának előrejelzésében
Először is meg kell említeni, hogy a leállások előrejelzésének ötlete a . Az automatikus anomáliakeresési megközelítés hatékonyságának ellenőrzésére a „Web-Konszolidáció” szoftverrendszert választották, amely a NPO „Krysta” egyik projektje. Korábban kézi monitorozást végeztek a kapott mutatók alapján. Mivel a rendszer meglehetősen összetett, sok mutatót méregy: JVM mutatók (a szemétgyűjtő terhelése), ennek a kódot futtató operációs rendszer mutatói (virtuális memória, CPU terhelés %), hálózati mutatók (hálózati terhelés), a szerver saját mutatói (CPU, memória terhelés), wildfly mutatók és a kritikus alrendszerek összes alkalmazásának saját mutatói.
Minden mutatót a graphite segítségével mérnek a rendszeren. Kezdetben a whisper adatbázist használták, mint a grafana standard megoldását, de a kliensbázis növekedésével a graphite már nem tudott megbirkózni, kimerítve a DC lemezrendszerének áteresztőképességét. Ezt követően döntés született a hatékonyabb megoldás kereséséről. Végül a , választása mellett döntöttek, ami lehetővé tette a lemezrendszer terhelésének nagyságrenddel történő csökkentését és öt-hat alkalommal csökkentette a megszált lemezterületet. Az alábbiakban bemutatjuk a graphite+clickhouse használatával végzett mutatószerzés mechanizmusának sémáját (2. ábra).
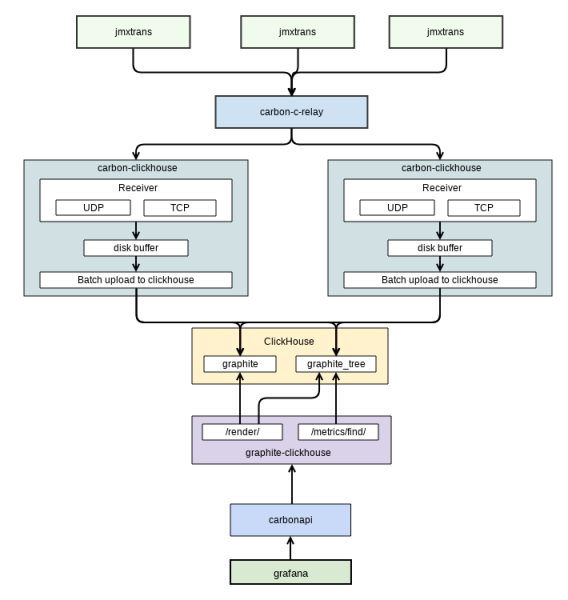
2. ábra. A mutatók levétele
A diagram taken from internal documentation. It shows the data exchange between Grafana (the user interface for monitoring that we use) and Graphite. The extraction of metrics from the application is performed by separate software – . It also stores them in Graphite.
The 'Web Consolidation' system has several features that create challenges for predicting failures:
- trends often change. Different versions of this software system are released. Each of them carries changes in the system's software component. Consequently, developers directly influence the metrics of this system and can trigger trend changes;
- implementation peculiarities, as well as the goals of clients using this system, often invoke anomalies without prior degradation;
- the percentage of anomalies relative to the entire dataset is low (< 5%);
- there may be gaps in obtaining metrics from the system. For short periods, the monitoring system fails to retrieve metrics. For example, if the server is overloaded. This is critical for training the neural network. There arises a need to synthetically fill gaps;
- Anomalies are often relevant only for a specific number/month/time (seasonality). This system has a clear usage regulation for its users. Accordingly, metrics are only relevant for specific times. The system may not be in use constantly, but only in certain months: selectively depending on the year. There are situations where the same metric behavior in one case may lead to the failure of the software system, while in another it may not.
Initially, methods for detecting anomalies in monitoring data of software systems were analyzed. In articles on this topic, when the percentage of anomalies relative to the total dataset is low, it's often suggested to use neural networks.
The main logic for anomaly detection using neural network data is illustrated in Figure 3:
Figure 3. Anomaly detection using a neural network
A becslés vagy a jelenlegi metrikafolym folyamat helyreállításának eredménye alapján a munkához szükséges programrendszerből származó metrikák eltérését számítják ki. Ha a programrendszerből és a neurális hálóból származó metrikák között jelentős különbség van, akkor az aktuális adatblokknak anomáliásnak tekinthető. Ez egy sor problémát vet fel a neurális hálók használatával kapcsolatban:
- a modellek neurális hálókkal való helyes működéséhez a tanulmányhoz felhasznált adatoknak kizárólag a 'normális' adatokat kell tartalmazniuk;
- aktualizált modellre van szükség a pontos észleléshez. A metrikák trendjének és szezonális mintáinak megváltozása sok hamis riasztást okozhat a modellben. Az aktualizálásához pontosan meg kell határozni az időpontot, amikor a modell elavult. Ha a modellt túl korán vagy túl későn frissítik, valószínűleg nagy mennyiségű hamis riasztással kell számolni.
Ne feledkezzünk meg a hamis riasztások gyakoriságának kereséséről és megelőzéséről sem. Feltehetően ezek a nem szokványos helyzetekben fordulnak elő a leggyakrabban. Azonban a neurális háló hibái miatt is kialakulhatnak, ha nem volt elég kiképzésük. Minimalizálni kell a modell hamis riasztásainak számát. Ellenkező esetben a hamis előrejelzések sok időt fognak felemészteni az adminisztrátor részéről, amelyet a rendszer ellenőrzésére szánnak. Előbb vagy utóbb az adminisztrátor egyszerűen le fog állni a 'paranoiai' monitorozó rendszerre való reagálással.
Rekurzív neurális háló
Anomáliák időbeli sorozatokban történő észlelésére alkalmazható LSTM memóriaegységekkel. A probléma csupán annyi, hogy csak előrejelezhető időbeli sorozatokra alkalmazható. Az esetünkben nem minden metrika előrejelezhető. Az RNN LSTM alkalmazásának kísérlete egy időbeli sorozatra a 4. ábrán látható.
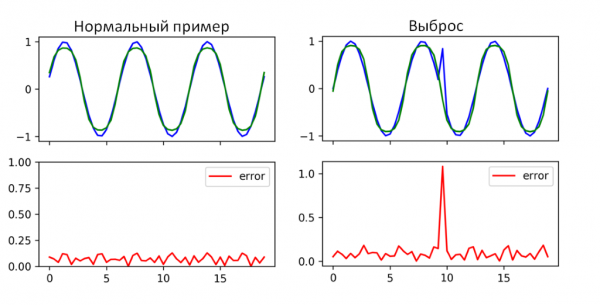
4. ábra. Példa a rekurzív neurális háló működésére LSTM memóriaegységekkel
Ahogy az 4. ábrán látható, az RNN LSTM sikeresen azonosította az anomáliát ezen az időszakon. Ott, ahol a prognózis hibája magas (átlagos hiba), valóban anomália történt a mutatók terén. Csak az RNN LSTM használata nyilvánvalóan nem elegendő, mivel csak néhány metrikához alkalmazható. Alternatív módszerként szolgálhat az anomáliák kereséséhez.
Hibafelismerő autoenkóder
– lényegében egy mesterséges neurális háló. A bemeneti réteg – encoder, a kimeneti réteg – decoder. Az ilyen típusú neurális hálók hátránya, hogy rosszul lokalizálják az anomáliákat. Egy szinkron autoenkóder architektúráját választották ki.
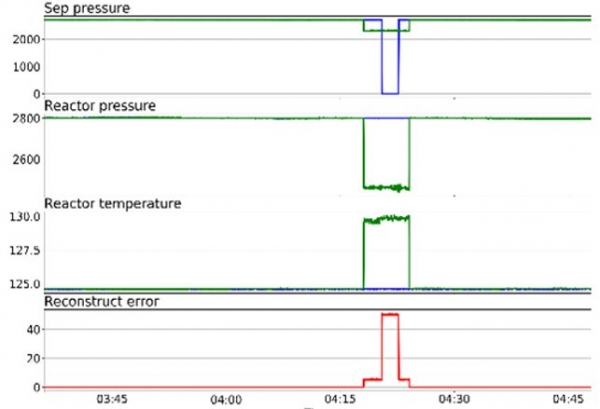
5. ábra. Az autoenkóder működésének példája
Az autoenkóderek normál adatokon tanulnak, majd az anomáliák azonosítását végzik a modellbe beadott adatokban. Pontosan ilyen megoldás szükséges a feladathoz. Csak az a kérdés, hogy melyik autoenkóder lenne megfelelő erre a feladatra. Az architekturálisan legegyszerűbb autoenkóder formája egy közvetlen, nem visszatérő neurális háló, amely nagyon hasonlít a (multilayer perceptron, MLP), bemeneti, kimeneti réteggel és egy vagy több rejtett réteggel, amelyek összekapcsolják őket.
Azonban a különbségek az autoenkóderek és az MLP között abban rejlenek, hogy az autoenkóder kimeneti rétege ugyanolyan számú csomóponttal rendelkezik, mint a bemeneti, és hogy ahelyett, hogy a megadott X bemenet alapján az Y célt értékelnék, az autoenkóder önmagának a X reconstructálására tanul. Ezért az autoenkóderek nem felügyelt tanulási modellek.
Az autoenkóder feladata a r0 … rn időbeli indexek meghatározása, amelyek az anomális elemeket reprezentálják a bemeneti X vektorban. Ezt a hatást a négyzetes hiba keresésével érjük el.
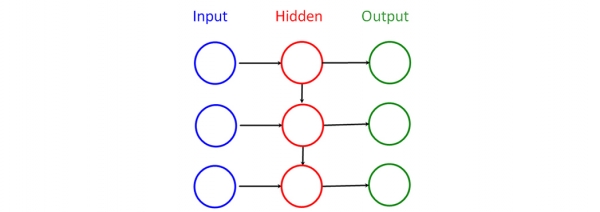
6. ábra. Szinkron autoenkóder
Az autoenkóderhez a választották. Előnyei: a stream feldolgozási mód használatának lehetősége és viszonylag kevesebb neurális háló paraméter más architektúrákhoz képest.
A hamis riasztások minimalizálásának mechanizmusa
A különböző rendellenes helyzetek előfordulása, valamint a neurális hálózat esetleges elégtelen képzésének lehetősége miatt a fejlesztett anomáliaészlelési modell esetében szükségessé vált egy mechanizmus kidolgozása a hamis riasztások minimalizálására. Ez a mechanizmus egy mintázatokból álló alapra épül, amelyet az adminisztrátor osztályoz.
(DTW-algoritmus, az angol dynamic time warping-ból) lehetővé teszi az optimális megfelelés megtalálását az időbeli sorozatok között. Először a beszédfelismerés során alkalmazták: a kettő beszédjel közötti hasonlóság meghatározására használták, amely ugyanazt az eredeti kiejtett szót jelenti. Később más területeken is megtalálták a felhasználását.
A hamis riasztások minimalizálásának alapelve a referenciaadatok kiszolgálása az operátor által, aki osztályozza a neurális hálózatok által észlelt gyanús eseteket. Ezt követően a klasszifikált referenciát összehasonlítják azzal az esettel, amelyet a rendszer észlelt, és következtetéseket vonnak le az esettartományok hamisságáról vagy a hibára vonatkozóan. A két időbeli sorozat összehasonlítására a DTW algoritmust használják. A minimalizálás legfőbb eszköze mégis a klasszifikálás. Azt feltételezik, hogy a nagy mennyiségű referenciális eset összegyűjtése után a rendszer kevesebb alkalommal fog kérdezni az operátort, mivel a legtöbb eset hasonlósággal rendelkezik.
A fent említett neurális hálózati módszerek alapján egy kísérleti programot fejlesztettek ki a "Web-Konszolidáció" rendszer leállási előrejelzésére. A program célja az volt, hogy a meglévő megfigyelési adatok archívussza és a már bekövetkezett leállások információi segítségével értékelje ezen megközelítés alkalmasságát a szoftveres rendszereink számára. A program munkájának vázlata az alábbiakban, a 7. ábrán látható.
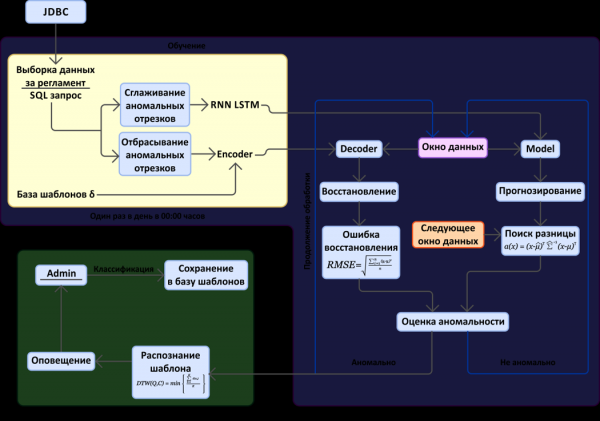
7. ábra. A leállások előrejelzésének vázlata a metrikák térének elemzésén alapulva
A vázlatban két fő blokk különíthető el: az anomális időintervallumok keresése a megfigyelési adatok (metrikák) folyamában és a hamis riasztások minimalizálásának mechanizmusa. Megjegyzés: kísérleti célokra az adatokat JDBC-kapcsolaton keresztül nyerjük ki az adatbázisból, ahová a graphite mentette őket.
Az alábbiakban bemutatjuk a rendszer monitoring fejlesztésének eredményeként létrejött felületet (8. ábra).
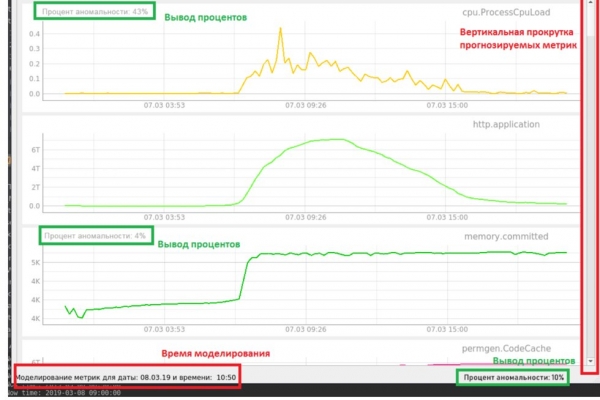
8. ábra. A kísérleti monitoring rendszer felülete
A felületen a kapott metrikák alapján megjelenik az anomália százaléka. Jelen esetben a megfigyelés modellezése történik. Már van néhány hétnyi adatunk, amelyet fokozatosan töltünk fel, hogy ellenőrizzük az eltérést, amely meghibásodáshoz vezetett. Az alsó státuszsávban a jelenlegi anomália százaléka látható, amelyet az autoenkóder segítségével határozunk meg. Emellett a jövőbeli metrikák külön százalékát is megjelenítjük, amelyet az RNN LSTM számít ki.
Példa az RNN LSTM ideghálózattal észlelt CPU-anomáliákra (9. ábra).
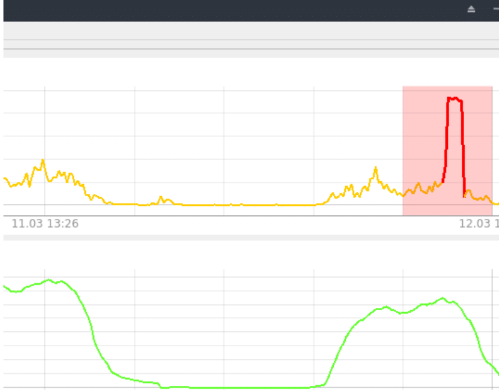
9. ábra. RNN LSTM észlelés
Ez egy viszonylag egyszerű eset, lényegében egy normális kiugrás, amely azonban a rendszer meghibásodásához vezetett, sikeresen észlelve az RNN LSTM által. Az anomália mértéke ezen az időintervallumon 85 és 95% között van; minden, ami 80% felett van (a küszöbérték kísérletileg lett meghatározva), anomáliának számít.
Példa anomáliára, amikor a rendszer nem tudott elindulni a frissítés után. Ezt a helyzetet az autoenkóder észleli (10. ábra).
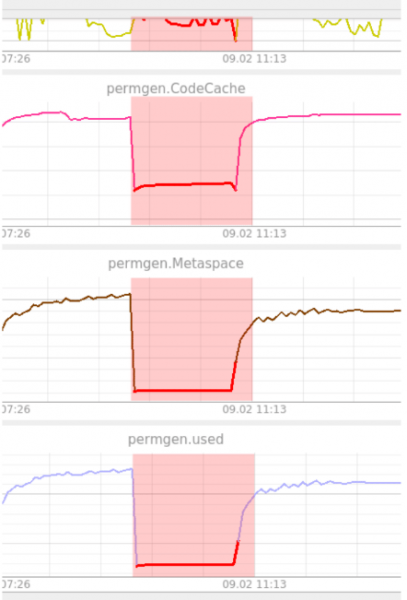
10. ábra. Példa az autoenkóder észlelésére
Ahogy a képen is látható, a PermGen egy szinten akadt. Az autoenkóder ezt furcsának találta, mivel korábban ilyet még nem látott. Az anomália 100%-on tartósan megmarad, amíg a rendszer vissza nem áll működőképes állapotba. Az anomália minden metrikán látható. Ahogy korábban említettük, az autoenkóder nem képes lokalizálni az anomáliákat. Az operátor feladata ezen helyzetekben ellátni ezt a funkciót.
Zárás
A "Web-Konszolidáció" projekt nem tegnap óta fejlesztés alatt áll. A rendszer meglehetősen stabil állapotban van, és a regisztrált események száma csekély. Ennek ellenére sikerült anomáliákat találni, amelyek 5-10 perccel a meghibásodás előtt jelentkeztek. Számos esetben a meghibásodásról szóló értesítés előre segíthetett volna a karbantartási idő megtakarításában, amely a "javítási" munkálatok elvégzésére van kijelölve.
A végső következtetések levonásához még korai a kísérletek alapján. Jelenleg az eredmények ellentmondásosak. Egyrészt látható, hogy a neurális hálózaton alapuló algoritmusok képesek hasznos anomáliák azonosítására. Másrészt még mindig nagy a hamis riasztások aránya, és nem minden anomáliát, amelyet egy szakértő azonosít, a neurális hálózat is észlel. Hátrányként említhető, hogy a neurális hálózat jelenleg felügyelt tanulást igényel a megfelelő működéshez.
A leállások előrejelző rendszerének további fejlesztéséhez és annak megfelelő állapotba juttatásához több utat is lehetne megfontolni. Ez magában foglalja az anomáliák eseteinek részletesebb elemzését, amelyek leálláshoz vezetnek, a kritikus metrikák listájának kibővítése érdekében, amelyek jelentősen befolyásolják a rendszer állapotát, és a lényegtelentől való elválasztást. Ezen az úton haladva a specifikus algoritmusok specializálására is lehetne kísérletet tenni, kifejezetten a leállásokkal járó anomáliák kezelésére. Egy másik lehetőség a neurális hálózatok architektúrájának tökéletesítése, amely a felfedezés pontosságának növelését és a tanulási idő csökkentését célozza.
Köszönetet mondok azoknak a kollégáimnak, akik segítettek a cikk megírásában és aktualizálásában: és Szergej Finogyenovnak.
Forrás: habr.com
