

Üdvözlöm, habr.
Ha valaki kihasználja a rendszert és teljesítményproblémába ütközött a tárolóval (IO, felhasznált lemezterület), akkor a ClickHouse-ra való tekintés mint alternatíva valószínűsége közelíti a egyet. Ez az állítás azt sugallja, hogy már egy harmadik fél megoldása, például vagy .
a ClickHouse jól megoldja az említett problémákat. Például, miután 2TiB adatot átkonvertáltunk whisper-ből, 300GiB-ra tudtuk zsugorítani őket. A részletes összehasonlításon nem állok meg, a témában elegendő cikk áll rendelkezésre. Ráadásul, a közelmúltig a ClickHouse tárolónk sem volt tökéletes.
Problémák a felhasznált hellyel
Első ránézésre minden jól működik. Követve , létrehozzuk a metrikák tárolási séma konfigurációját (továbbiakban retention), majd létrehozzuk a táblázatot a választott backend ajánlása szerint a graphite-web-hez: + vagy , attól függően, hogy melyik stacket használják. És... elindul egy időzített bomba.
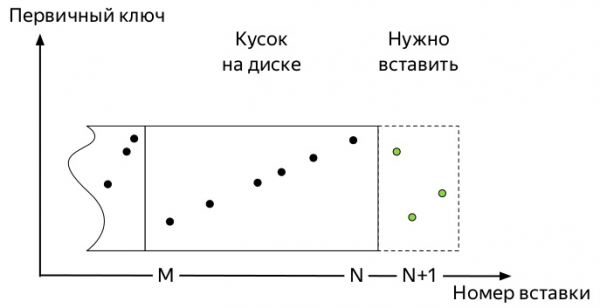
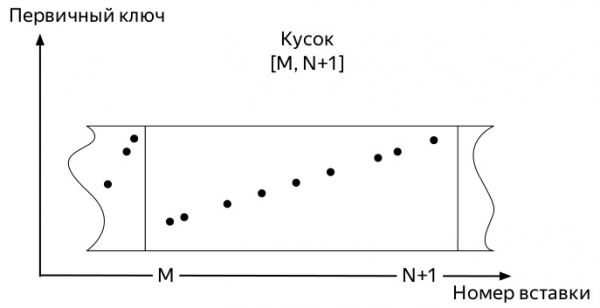
Ahhoz, hogy megértsük, mi az, tudnunk kell, hogyan működnek a beszúrások és az adatok további sorsa a *MergeTree ClickHouse (a diagramok Alekszey Zatelepintől származnak): Blockot
- dátumokkal. A mi esetünkben ezek a metrikák érkeztek.
Minden ilyen blokk írás előtt a lemezre aORDER BY

- , az asztal létrehozásakor megadott kulcs szerint rendeződik.
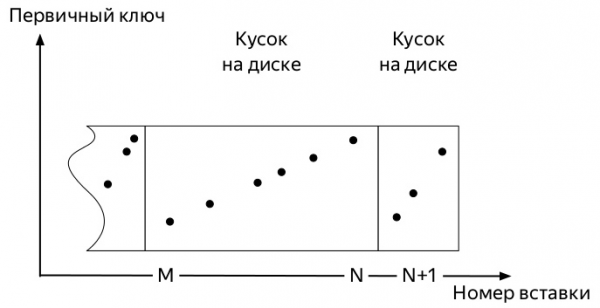
Rendezés után,darab - ) adat felkerül a lemezre.
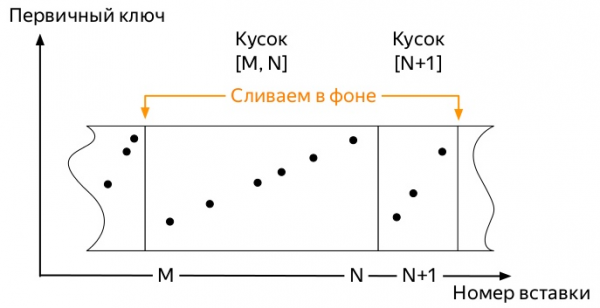
A szerver a háttérben figyel arra, hogy ne legyen sok ilyen darab, és elindítja a háttér(partösszevonásokat
- , további mergen keresztül.
A szerver már nem indítja el automatikusan a merge-t, amint az adatok aktívan leállnak(mergepartition
- ), de a folyamatot kézzel elindíthatjuk a
OPTIMIZE(Ha a partícióban csak egy darab maradt, akkor a merge-t a szokásos parancs szerint nem lehet elindítani, használni kellOPTIMIZE ... FINALÍgy érkeznek az első metrikák. És ezek bizonyos helyet foglalnak el. A következő események változhatnak számos tényezőtől függően:. - A partíció kulcsa lehet nagyon kicsi (nap), de nagyon nagy is (több hónap).
A retention konfiguráció több jelentős adategyesítési küszöböt tud tartalmazni a aktív partícióban (ahova a metrikák kerülnek), de lehet, hogy nem.
A retention konfiguráció tartalmazhat több jelentős aggregációs küszöböt az aktív partícióban (ahova a metrikák íródnak), de ez nem biztos.
- A retention konfiguráció tartalmazhat több jelentős aggregációs küszöböt az aktív partícióban (ahova a metrikák íródnak), de ez nem biztos.
- A retention konfiguráció tartalmazhat több jelentős aggregációs küszöböt az aktív partícióban (ahova a metrikák íródnak), de ez nem biztos.
- Ha nagyon sok adat van, akkor a legkorábbi darabok, amelyek háttérmargek miatt már hatalmasak lehetnek (nem optimális partíciós kulcs választás esetén), nem fognak egyesülni az újabb, kis darabokkal.
És mindig ugyanazzal végződik. A ClickHouse-ban a metrikák által elfoglalt hely csak nő, ha:
- nem alkalmazzuk
A retention konfiguráció több jelentős adategyesítési küszöböt tud tartalmazni a aktív partícióban (ahova a metrikák kerülnek), de lehet, hogy nem.kézzel, vagy - nem helyezzük el az adatokat az összes partícióba folyamatosan, hogy előbb-utóbb elinduljon a háttérmerg.
A második módszer a legkönnyebben megvalósíthatónak tűnik, ezért helytelen, és ezt próbáltuk ki először.
Írtam egy elég egyszerű Python szkriptet, amely hamis metrikákat küldött minden egyes napra az előző 4 évben, és óránként futott a cron.
Mivel a ClickHouse DBMS teljes munkája azon alapul, hogy ez a rendszer előbb-utóbb elvégzi a háttérmunkát, de nem tudni mikor, ezért nem tudtam megvárni, hogy a régi hatalmas darabok végre elkezdjenek egyesülni az új kis darabokkal. Nyilvánvalóvá vált, hogy automatizálnom kell a kötelező optimalizálásokat.
Információ a ClickHouse rendszertábláiban
Nézzük meg a táblázat szerkezetét . Ez a ClickHouse szerveren található összes táblázat minden darabjáról teljes körű információt nyújt. Tartalmazza többek között a következő oszlopokat:
- adatbázis neve (
database); - tábla neve (
table); - partíció neve és ID (
Ha a partícióban csak egy darab maradt, akkor a merge-t a szokásos parancs szerint nem lehet elindítani, használni kell&partition_id); - mikor készült a darab (
modification_time); - minimum és maximum dátum a darabban (a partíciózás napokra történik) (
min_date&max_date);
Van egy másik tábla is , a következő érdekes mezőkkel:
- adatbázis neve (
Tables.database); - tábla neve (
Tables.table); - a metrikák életkora, amikor a következő aggregációs szabályt alkalmazni kell (
age);
Tehát:
- Van egy darabok táblánk és egy aggregációs szabályok táblánk.
- Összevonjuk őket és megkapjuk az összes *GraphiteMergeTree táblát.
- Megkeressük az összes partíciót, amelyek:
- több mint egy darab
- vagy elérkezett az idő, hogy alkalmazzuk a következő aggregációs szabályt, és
modification_timeidősebb ennél a pillanatnál.
Megvalósítás
Ez a lekérdezés
VÁLASSZ
    concat(p.database, '.', p.table) AS táblázat,
    p.partition_id AS partíció_id,
    p.partition AS partíció,
    -- A "legöregebb" szabály, amely alkalmazható a
    -- partícióra, de nem a jövőben, lásd (*)
    max(g.age) AS életkor,
    -- A partícióban lévő darabok száma
    countDistinct(p.name) AS részek,
    -- A legidősebb metrika a partícióban a következő nap 00:00:00
    toDateTime(max(p.max_date + 1)) AS max_idő,
    -- Amikor a partíció optimalizálásra kerül
    max_idő + életkor AS rollup_idő,
    -- Amikor a legöregebb darabot a partícióban frissítették
    min(p.modification_time) AS módosítva
FROM system.parts AS p
INNER JOIN
(
    -- Minden szabály minden táblához a *GraphiteMergeTree
    VÁLASSZ
        Tables.database AS adatbázis,
        Tables.table AS tábla,
        életkor
    FROM system.graphite_retentions
    ARRAY JOIN Tables
    Csoportosítás alapján
        adatbázis,
        tábla,
        életkor
) AS g ON
    (p.table = g.table)
    AND (p.database = g.database)
HOL
    -- Csak aktív darabok
    p.active
    -- (*) És csak azok a sorok, ahol az aggregációs szabályok már alkalmazandók
    ÉS ((toDateTime(p.max_date + 1) + g.age) < now())
Csoportosítás alapján
    táblázat,
    partíció
HAVING
    -- Csak azok a partíciók, amelyek fiatalabbak az optimalizálási időpontnál
    (módosítva  1)
RENDEZÉS
    táblázat ASC,
    partíció ASC,
    életkor ASC
visszaadja a *GraphiteMergeTree táblák minden partícióját, melyek egyesítése szabad disk térhez vezet. Csak annyi marad, hogy végigmenjünk rajtuk egy lekérdezéssel A retention konfiguráció több jelentős adategyesítési küszöböt tud tartalmazni a aktív partícióban (ahova a metrikák kerülnek), de lehet, hogy nem.. A végső megvalósítás során figyelembe lett véve az a tény, hogy a partíciókat aktív írás esetén nem szükséges megérinteni.
Pontosan ezt teszi a projekt . A volt kollégák a Yandex.Market-ból kipróbálták a termelésben, az eredmények az alábbiakban láthatók.
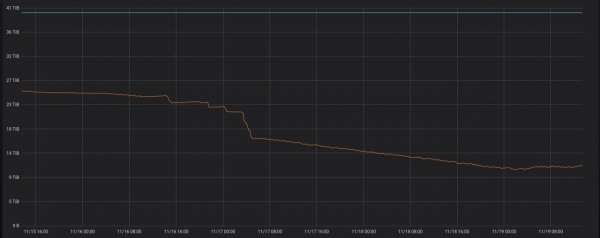
Ha a programot egy ClickHouse szerveren futtatják, akkor egyszerűen elkezd működni démon üzemmódban. Minden órában végrehajt egy lekérdezést, ellenőrizve, hogy jelentek-e meg új partíciók, amelyek három napnál idősebbek és optimalizálhatók.
A közeljövő tervei között szerepel, hogy legalább deb csomagokat biztosítunk, és lehetőség szerint rpm-t is.
Összegzésként
A közelmúlt 9 hónapjában a cégemen belül sok időt töltöttem a ClickHouse és a graphite-web határán. Ez egy jó tapasztalat volt, amelynek eredményeként gyors átállás válik lehetővé a whisper-ről ClickHouse-ra mint metrikákkal kapcsolatos tárolóra. Remélem, hogy ez a cikk valami olyasmi, mint egy ciklus kezdete a különböző részeinkben végrehajtott fejlesztésekről, és arról, hogy mi fog még történni a jövőben.
A kérdés kidolgozására néhány liter sört és adminisztrátori napokat költöttem, közösen , ezért szeretném megköszönni neki. Továbbá, hogy átnézte ezt a cikket.
Forrás: habr.com
