

A Splunk naplózási és elemzési rendszer Oroszországban történt értékesítésének megszűnése miatt felmerült a kérdés, hogy mivel lehet ezt a megoldást helyettesíteni? Miután eltöltöttem egy kis időt különböző megoldások megismerésével, egy igazi férfias megoldásra esett a választásom — „ELK stack”. Ez a rendszer beállítása időt igényel, de végül egy rendkívül hatékony rendszer állítható elő az információbiztonsági incidensek állapotának elemzésére és a gyors reagálásra a szervezetekben. Ebben a cikksorozatban megvizsgáljuk az ELK stack alapvető (vagy talán nem is annyira alapvető) képességeit, azt, hogyan lehet naplókat elemezni, grafikonokat és irányítópultokat készíteni, valamint hogy milyen érdekes funkciókat lehet megvalósítani a Check Point tűzfal vagy az OpenVas biztonsági szkenner naplóinak példáján keresztül. Kezdjük azzal, hogy mi is az ELK stack és milyen komponensekből áll.
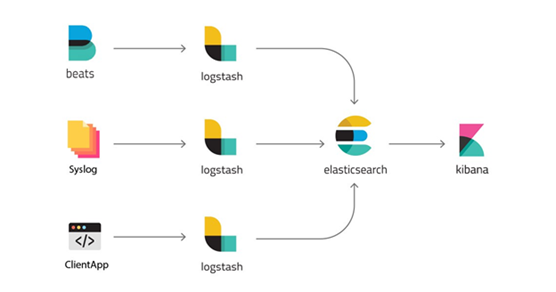
„ELK stack” — három, nyílt forráskódú projekt rövidítése: Elasticsearch, Logstash és Kibana. Az Elastic cég fejlesztette ki, a többi kapcsolódó projekttel együtt. Az Elasticsearch a rendszer központi eleme, amely ötvözi az adatbázis, a kereső- és elemző rendszer funkcióit. A Logstash egy adatfeldolgozó munkafolyamat a szerveroldalon, amely egyszerre kap adatokat több forrásból, elemzi a naplót, majd az Elasticsearch adatbázisba küldi. A Kibana lehetővé teszi a felhasználók számára, hogy vizualizálják az Elasticsearch adatait diagramok és grafikonok segítségével. A Kibana-n keresztül az adatbázis is adminisztrálható. Később részletesebben áttekintjük mindegyik rendszert külön-külön.
Logstash
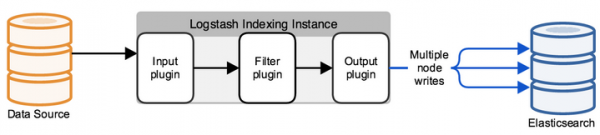
A Logstash egy olyan szerszám, amely különböző forrásokból származó eseménynaplók feldolgozására szolgál, lehetővé téve a mezők és az értékek kiemelését az üzenetekben, emellett beállítható a szűrés és az adatok szerkesztése is. Mindezek után a Logstash átirányítja az eseményeket a végső adathordozóra. Az eszközt kizárólag konfigurációs fájlokon keresztül lehet beállítani.
A tipikus logstash konfiguráció egy vagy több fájl, amely több bemeneti adatfolyamból (input), számos szűrőből (filter) és több kimeneti adatfolyamból (output) áll. Ez egy vagy több konfigurációs fájlként jelenik meg, amely a legegyszerűbb változatában (ami egyáltalán nem csinál semmit) így néz ki:
input {
}

filter {
}

output {
}
Az INPUT-ben beállítjuk, hogy melyik porton érkezzenek a naplók és milyen protokollon, vagy melyik mappából olvassuk az új vagy folyamatosan bővülő fájlokat. A FILTER-ben a naplóelemzőt állítjuk be: a mezők elemzése, a változók szerkesztése, új paraméterek hozzáadása vagy eltávolítása. A FILTER olyan mező, amely kezeli a Logstash-be érkező üzeneteket, számos szerkesztési lehetőséggel. Az output-ban beállítjuk, hogy hová küldjük az elemzett naplót; ha ez Elasticsearch, akkor egy JSON kérést küldünk, amely tartalmazza a mezőket értékekkel, vagy a hibaelhárítás keretében a stdout-ra is kivihetjük, vagy fájlba rögzíthetjük.
ElasticSearch
Eredetileg az Elasticsearch egy teljes szöveg keresési megoldás, de további kényelmi funkciókkal, mint például a könnyű skálázhatóság, replikáció és egyebek, amelyek kényelmessé és jó megoldássá tették a magas terhelésű projektekhez nagy adatmennyiségek kezelésére. Az Elasticsearch nem relációs (NoSQL) dokumentumtároló JSON formátumban, és egy teljes szöveg kereső rendszer a Lucene alapján. Hardverplatformja a Java Virtual Machine, így a rendszernek jelentős mennyiségű processzor- és memóriakapacitásra van szüksége a működéshez.
Minden beérkező üzenet, akár Logstash-on keresztül, akár API kérésen keresztül érkezik, 'dokumentumként' indexelődik, ami egyenértékű egy relációs SQL táblával. Minden dokumentum egy indexben tárolódik, ami SQL-ben az adatbázisnak felel meg.
Példa egy dokumentumra az adatbázisban:
{
  "_index": "checkpoint-2019.10.10",
  "_type": "_doc",
  "_id": "yvNZcWwBygXz5W1aycBy",
  "_version": 1,
  "_score": null,
  "_source": {
	"layer_uuid": [
      "dae7f01c-4c98-4c3a-a643-bfbb8fcf40f0",
      "dbee3718-cf2f-4de0-8681-529cb75be9a6"
	],
	"outzone": "External",
	"layer_name": [
  	"TSS-Standard Security",
  	"TSS-Standard Application"
	],
	"time": "1565269565",
	"dst": "103.5.198.210",
	"parent_rule": "0",
	"host": "10.10.10.250",
	"ifname": "eth6",
    ]
}
Az adatbázissal való munka JSON kéréseknél REST API-n keresztül történik, amelyek vagy dokumentumokat szolgáltatnak az index alapján, vagy statisztikát adnak a következő formátumban: kérdés – válasz. Annak érdekében, hogy az összes válasz vizualizálható legyen, a Kibana webszolgáltatást fejlesztették ki, amely egy webszolgáltatásként működik.
Kibana
A Kibana lehetővé teszi, hogy adatokat keressünk és statisztikákat kérjünk le az Elasticsearch adatbázisból, amely alapján számos szép grafikon és irányítópult építhető. A rendszer emellett rendelkezik az Elasticsearch adatbázis adminisztrációs funkcióival is, amelyeket későbbi cikkekben részletesebben megvizsgálunk. Most pedig bemutatunk egy példát a Check Point tűzfal és az OpenVas sebezhetőség-elemző irányítópultjaira, amelyeket létre lehet hozni.
Példa Check Point irányítópultra, a kép kattintható:
Példa OpenVas irányítópultra, a kép kattintható:
Zárás
Megvizsgáltuk, hogy miből áll ELK stack, kicsit megismertük az alapvető termékeket, később a kurzus során külön foglalkozunk a Logstash konfigurációs fájl írásával, a Kibana irányítópultok beállításával, megismerkedünk az API lekérésekkel, az automatizálással és még sok mással!
Úgyhogy kövessétek az frissítéseket (, , , ), .
Forrás: habr.com
