

Második rész:
Bármilyen raszteres kép képviselhető kétdimenziós mátrixként. Amikor a színekről beszélünk, a fogalom fejleszthető, ha a képet háromdimenziós mátrixkéntviszonyítjuk, ahol a további dimenziókat minden szín adatainak tárolására használjuk.
Ha a végső színt a nevezett alapszínek (piros, zöld és kék) kombinációjaként tekintjük, akkor a háromdimenziós mátrixunkban három síkot határozunk meg: az első a piros színhez, a második a zöldhöz, a harmadik pedig a kékhez.
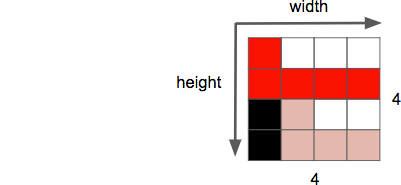
Ezt a mátrix minden egyes pontját pixeleknek (a kép elemeinek) nevezzük. Minden pixel az egyes színek intenzitásáról tartalmaz információt (általában numerikus érték formájában). Például, a piros pixel jelenti, hogy benne 0 zöld, 0 kék és maximális piros található. A rózsaszín pixel három szín kombinációjával alakítható ki. Az 0-tól 255-ig terjedő numerikus tartományt használva a rózsaszín pixel így van meghatározva: Piros = 255, Zöld = 192 és Kék = 203.
A cikket az EDISON támogatásával tették közzé.Videomegfigyelő, streamelő , valamint .
Alternatív módszerek színes képek kódolására
A kép színeinek reprezentálására számos egyéb modell is létezik. Például, használhatunk indexelt palettát, ahol egy pixel reprezentációjához csak egy bájt szükséges, ahelyett, hogy a RGB modellben háromra lenne szükség. Ilyen modellben 2D mátrixot is használhatunk, a 3D mátrix helyett, amely minden színt képvisel. Ez megtakarítja a memóriát, de kevesebb színskálát ad.
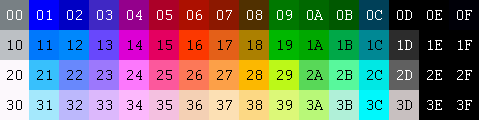
RGB
Például, nézd meg az alábbi képet. Az első arc teljesen ki van színezve. A többi a vörös, zöld és kék síkok (a megfelelő színek intenzitása szürke árnyalatban látható).
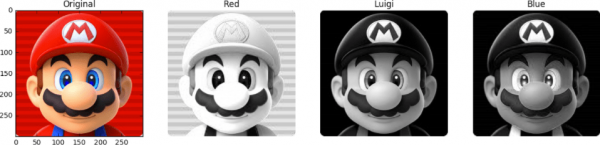
Látható, hogy a vörös árnyalatok az eredetiben ugyanott lesznek, ahol a második arc legélénkebb részei találhatók. Míg a kék szín hozzájárulása főleg Mario szemében (az utolsó arcon) és ruházatának elemeiben látható. Figyelje meg, hogy hol van a három színfelületnek a legkisebb hozzájárulása (a képek legsötétebb részei) — ez Mario bajuszában van.
A színek intenzitásának tárolásához bizonyos számú bit szükséges — ezt a mennyiséget bitmélységneknevezzük. Tegyük fel, hogy egy színfelületre 8 bit (0-tól 255-ig terjedően) megy el. Ekkor 24 bit színmélységünk van (8 bit * 3 R/G/B felület).
A kép másik jellemzője a felbontás, amely egy dimenzióban a pixel számát jelenti. Gyakran jelölik mint szélesség × magasság, mint az alábbi 4x4 képen.
Egy másik jellemző, amellyel képek/videók feldolgozása során találkozunk — ez a képarány, amely a kép vagy pixel szélessége és magassága közötti arányos kapcsolatot írja le.
Amikor azt mondják, hogy egy film vagy kép 16:9-es, általában a képernyő arányát (DAR jelenti — a Display Aspect Ratio). Azonban néha a különböző pixelek formái is eltérhetnek — ebben az esetben a pixel arány (PAR jelenti — a Pixel Aspect Ratio).
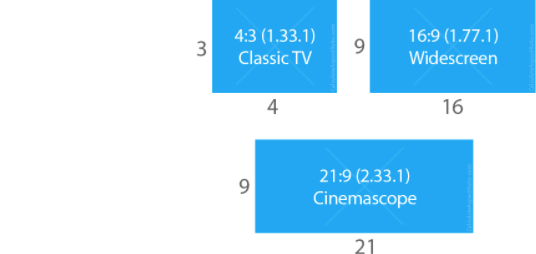
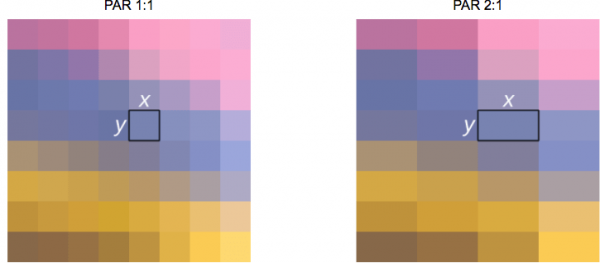
Hasznos megjegyzés a háziasszonynak: DVD megfelel DAR 4:3
Bár a DVD valódi felbontása 704×480, mégis megtartja a 4:3 képarányt, mivel a PAR értéke 10:11 (704×10 / 480×11).
Nos, végül meghatározhatjuk videón mint egy n képkockák sorozataként egy időszakban, amely egy további dimenziónak tekinthető. A n ezután a képkockák gyakoriságát vagy a másodpercenkénti képkockák számát jelenti (FPS jelenti — a Frames per Second).
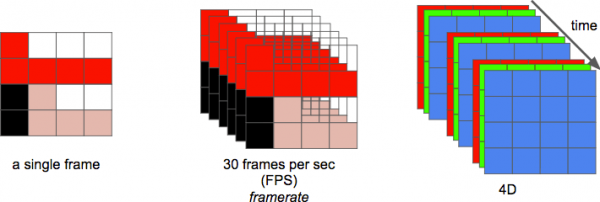
A videó megjelenítéséhez szükséges bitek száma a átviteli sebessége — bitráta.
bitráta = szélesség * magasság * bitmélység * képkockák másodpercenként
Például, egy 30 képkockás másodperccel, 24 bit pixelenként, 480×240 felbontással rendelkező videóhoz 82,944,000 bit másodpercenként vagy 82,944 Mbps (30x480x240x24) szükséges — de ez, ha nem használnak valamilyen tömörítési módszert.
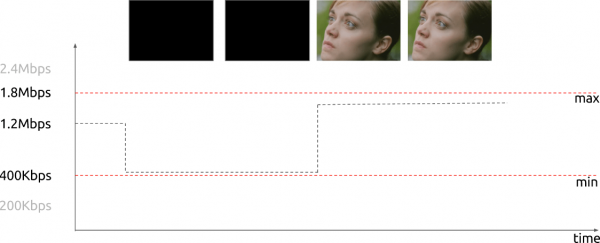
Ha az átviteli sebesség majdnem állandó, azt állandó átvitelsebességnek (CBR jelenti — a constant bit rate). De ez változhat is, ebben az esetben úgy hívják, változó bitsebesség (VBR jelenti — a változó bitráta).
Ez a grafikon a korlátozott VBR-t mutatja, amikor nem költenek túl sok bitet egy teljesen sötét képkocka esetében.
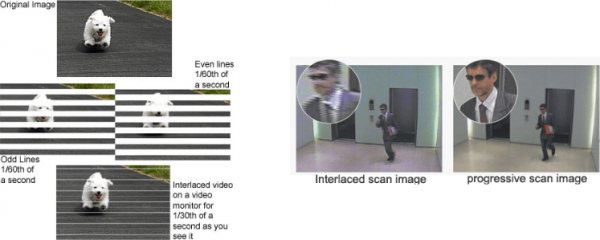
Eredetileg a mérnökök egy olyan módszert fejlesztettek ki, amely megduplázza a videokijelző észlelt képkockasebességét anélkül, hogy plusz sávszélességre lenne szükség. Ezt a módszert úgy hívják, hogy félidős videó; alapvetően az első "képkockában" a képernyő felét, a következő "képkockában" pedig a másik felét küldi.
Jelenleg a jelenetek vizualizálása főként progreszív beolvasási technológia. Ez egy módszer a mozgóképek megjelenítésére, tárolására vagy átadására, amelyben minden vonal minden képkockában sorban van megrajzolva.
Nos! Most már tudjuk, hogy a képet hogyan ábrázolják digitális formában, hogyan működnek a színei, és mennyi bitet használunk másodpercenként a videó megjelenítésére, ha az átviteli sebesség állandó (CBR) vagy változó (VBR). Ismerjük a megadott felbontást megadott képkockasebességgel, és megismertük sok más kifejezést, mint például a félidős videó, PAR és néhány más.
a redundancia eltávolítása
Ismert, hogy a tömörítetlen videó normálisan nem használható. Egy óra 720p felbontású és 30 képkockás másodpercenkénti videó 278 GB helyet foglalna. Ezt az értéket a következő szorzattal kapjuk meg: 1280 x 720 x 24 x 30 x 3600 (szélesség, magasság, bit per pixel, FPS és idő másodpercekben).
Használat veszteségmentes tömörítési algoritmusok, mint például a DEFLATE (amelyet a PKZIP, Gzip és PNG használ), nem ad elegendő csökkentést a szükséges sávszélességben. Más videótömörítési módszereket kell keresni.
Ehhez kihasználhatjuk a látásunk sajátosságait. Jobban megkülönböztetjük a fényerőt, mint a színeket. Ezt saját szemünkkel is ellenőrizheti, ha megnézi ezt a képet.
Szín, fényerő és szemeink
A szemeink érzékenyebbek a fényerőre, mint a színekre. Erről megbizonyosodhat, ha megnézi ezt a képet.
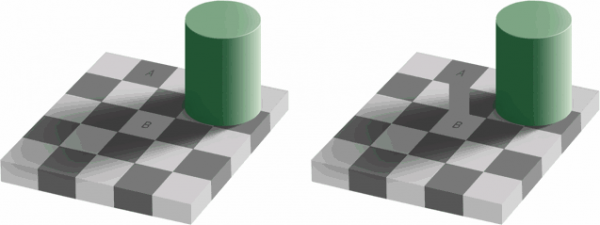
Ha nem látja, hogy a kép bal felén a négyzetek színei A és B ha valójában ugyanazok, akkor ez normális. Az agyunk arra késztet minket, hogy több figyelmet szenteljünk a fény-árnyék viszonyoknak, nem pedig a színnek. A kijelölt négyzetek jobb oldalán van egy ujjaszínű kötélszerű rész — ezért (azaz az agyunk) könnyen észleljük, hogy valójában ott ugyanaz a szín található.
Nézzük meg (egyszerűsítve), hogyan működik a szemünk. A szem — összetett szerv, amely számos részből áll. Ám minket legjobban a pálcikák és a csapok érdekelnek. A szem körülbelül 120 millió pálcikát és 6 millió csapot tartalmaz.
Vizsgáljuk meg a szín és a világosság észlelését, mint a szem egyes részeinek külön funkcióit (valójában, a helyzet bonyolultabb, de leegyszerűsítünk). A pálcikák főként a világosságért felelősek, míg a csapok a színért. A csapok három típusra oszthatók, a bennük található pigment típusa alapján: S-csapok (kék szín), M-csapok (zöld szín) és L-csapok (piros szín).
Mivel sokkal több pálcikánk van (világosság), mint csapon (szín), arra a következtetésre juthatunk, hogy jobban képesek vagyunk a sötétség és fény közötti átmenetek észlelésére, mint a színekére.
A kontrasztérzékenység funkciói
A kísérleti pszichológia és sok más terület kutatói számos elméletet dolgoztak ki az emberi látásról. Az egyik elmélet az kontrasztérzékenység funkciói. Ezek a térbeli és időbeli világítással kapcsolatosak. Röviden, arról van szó, hogy mennyi változás szükséges, mielőtt a megfigyelő észreveszi azokat. Figyeljen a "funkció" szó többes számára. Ez azért van, mert a kontrasztérzékenységet nemcsak fekete-fehér képeken, hanem színes képeken is mérhetjük. Ezeknek a kísérleteknek az eredményei azt mutatják, hogy a legtöbb esetben a szemeink érzékenyebbek a világosságra, mint a színre.
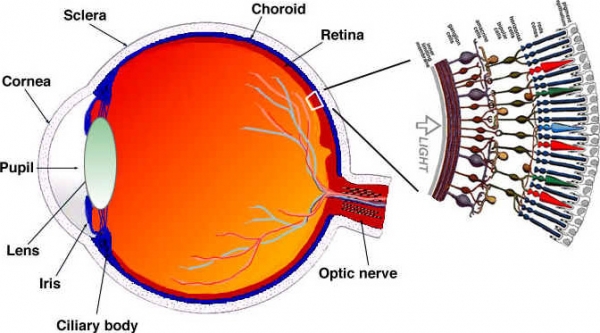
Mivel ismert, hogy érzékenyebbek vagyunk a kép világosságára, megpróbálhatunk e tényt kihasználni.
Színmodell
Egy kicsit megértettük, hogyan működnek a színes képek az RGB-schema használatával. Léteznek más modellek is. Van egy modell, amely a világosságot elválasztja a színtől, és ezt hívják YCbCr. Egyébként léteznek más modellek is, amelyek hasonló elválasztást végeznek, de mi csak ezt fogjuk megvizsgálni.
Ebben a színmodellben Y — a fényerősség bemutatása történik, emellett két színcsatorna is használatos: Cb (telített kék) és Cr (telített piros). A YCbCr RGB-ből nyerhető, ahogyan a visszafelé történő átalakítás is lehetséges. E modell segítségével teljes színű képeket hozhatunk létre, ahogyan az alább látható:
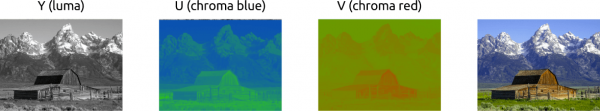
Átalakítás a YCbCr és RGB között
Valaki talán azt kérdezheti: hogykaphatunk meg minden színt, ha a zöld nem használatos?
A kérdés megválaszolására az RGB-t YCbCr-re alakítjuk át. Az MSZ által meghatározott koefficienseket fogjuk használni BT.601, amelyet az ITU-Rrészlege ajánlott. Ez a részleg határozza meg a digitális videó szabványait. Például: Mi az a 4K? Milyen legyen a képkockasebesség, felbontás, színmodell?
Először számoljuk ki a fényerőt. Használjuk az ITU által javasolt állandókat, és cseréljük ki az RGB értékeit.
Y = 0.299R + 0.587G + 0.114B
Miután megkaptuk a fényerőt, elválasztjuk a kék és piros színt:
Cb = 0.564(B — Y)
Cr = 0.713(R — Y)
És vissza is alakíthatjuk, sőt a zöld színt is megkaphatjuk YCbCr segítségével:
R = Y + 1.402Cr
B = Y + 1.772Cb
G = Y — 0.344Cb — 0.714Cr
Általában a kijelzők (monitorok, televíziók, képernyők stb.) csak az RGB modellt használják. De ez a modell különböző módon is szervezhető:
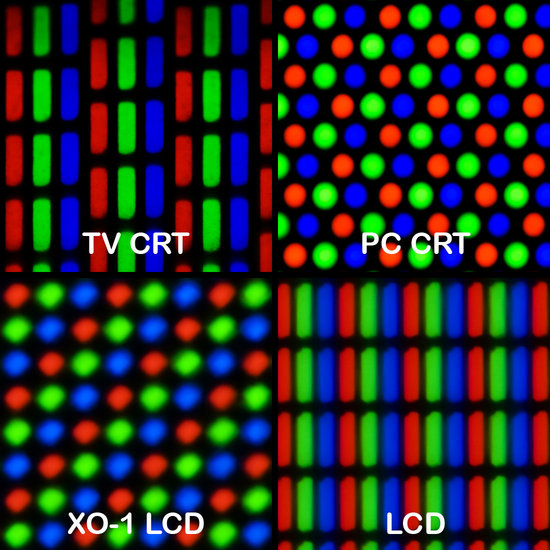
Szín alindítás
A képet a fényerő és színtartalom kombinációjaként bemutatva a humán látórendszer nagyobb érzékenységét használhatjuk ki a fényerősség iránt, mint a szín iránt, ha szelektíven eltávolítjuk az információt. A színtartalom alacsonyabb felbontáson történő kódolása a fényerő magasabb felbontásán használható, amelyet színtartalom alállításának hívnak.
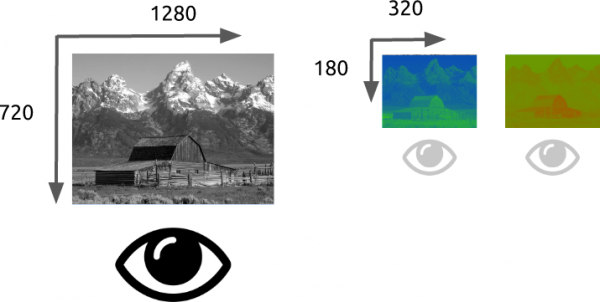
Mennyire megengedett a színtartalom felbontásának csökkentése?! Kiderül, hogy már léteznek bizonyos sémák, amelyek leírják, hogyan kell kezelni a felbontást és az összevonást (Befejezett szín = Y + Cb + Cr).
Ezek a sémák alállítási rendszereknek nevezik, és 3:1 arányban fejeződnek ki — a:x:y, amely meghatározza a fényerő és a színkülönbség jelek számlálását.
a — a referencia horizontális mintavétel (általában 4-nek felel meg)
x — a színtartalmi minták száma az első pixel sorban (horizontális felbontás a a)
y — a színtartalom mintáknak a két pixel sor között történő változása.
Az egyetlen kivétel 4:1:0, amely biztosít egy színtartalom mintát e 4x4 fényerő blokkokban.
A modern kodekben használt általános séma:
- 4:4:4 (al-subszampling nélkül)
- 4:2:2
- 4:1:1
- 4:2:0
- 4:1:0
- 3:1:1
YCbCr 4:2:0 — példa egyesített formátumra
Íme egy egyesített képrészlet YCbCr 4:2:0 felhasználásával. Vegye figyelembe, hogy csak 12 bitet használunk pixelenként.
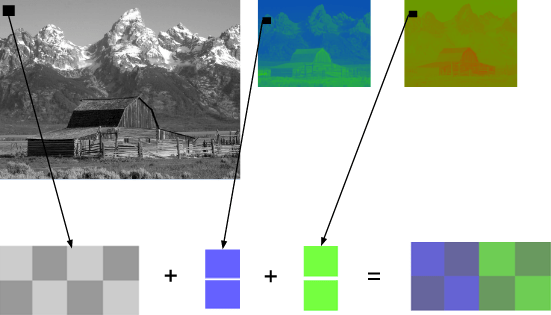
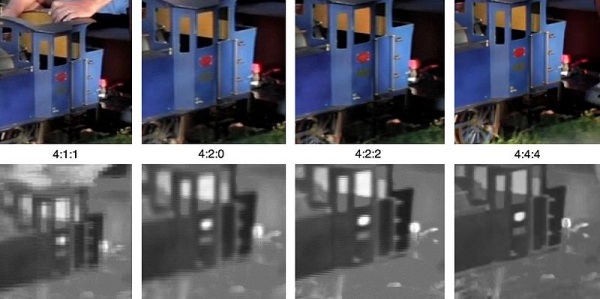
Így néz ki ugyanaz a kép a legelterjedtebb szín al-szubsampling típusokkal kódolva. Az első sor a végső YCbCr, az alsó sor a szín felbontását mutatja. Nagyon tiszteletreméltó eredmények, figyelembe véve a kis minőségbeli veszteségeket.
Emlékszik, hogy 278 GB lemeztárra volt szükség egy 720p felbontású és 30 képkockás másodperces videofájl tárolásához? Ha YCbCr 4:2:0-t használunk, akkor ez a méret a felére csökken — 139 GB. Még mindig messze vagyunk a megfelelő eredménytől.
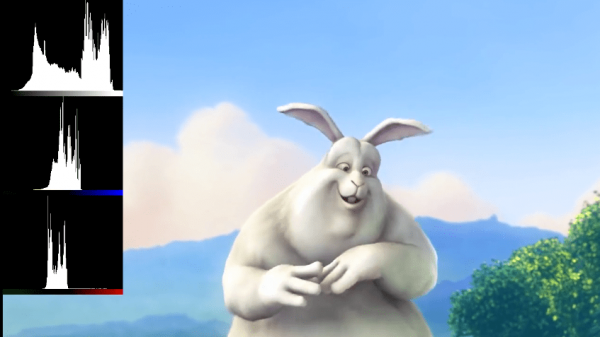
A saját YCbCr hisztogramját az FFmpeg segítségével kaphatja meg. Ebben a képen a kék dominál a piros fölött, ami jól látszik a hisztogramon.
Színesség, fényerő, színskála — videó áttekintés
Ajánljuk ezt a fantasztikus videót megtekintésre. Itt magyarázzák el, mi a fényerő, és egyáltalán mindent tisztáznak a fényerőről és a színről. Képtípusok
Tovább lépünk. Próbáljuk meg csökkenteni az időbeli redundanciát. De először határozzunk meg néhány alapvető terminológiát. Tegyük fel, hogy van egy filmünk 30 képkocka másodpercenként, itt vannak az első 4 képkockája:
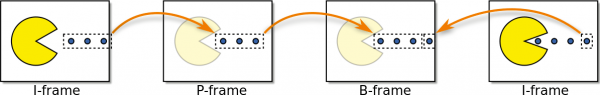
Láthatunk sok ismétlődést a képkockákban: például a kék háttér, ami nem változik képkockáról képkockára. E probléma megoldására absztrakt módon három képtípust osztályozhatunk.


I-kép (
Intro Frame)IAz I-kép (hivatkozási kép, kulcskép, belső kép) önálló. Attól függetlenül, hogy mit kell megjeleníteni, az I-kép alapvetően statikus fénykép. Az első kép általában I-kép, de gyakran találkozni fogunk I-képekkel a nem első képkockák között is.
P-kép (

Predicted Frame)PA P-kép (előrejelzett kép) kihasználja azt a tényt, hogy szinte mindig az aktuális kép a korábbi képből rekonstruálható. Például a második képen az egyetlen változás a mozgó labda. A 2-es képkockát úgy kaphatjuk, hogy a 1-es képkockát kissé módosítjuk, csak a különbséget használjuk e két kép között. A 2-es képkockához az azt megelőző 1-es képkockára hivatkozunk.
←
 ←

B-kép (Bi-predictive Frame)
De mi a helyzet a jövőbeli képek hivatkozásaival, nemcsak a múltbeli képekkel, hogy még jobb tömörítést biztosítsunk?! Ez tulajdonképpen a B-kép (kétirányú kép).
 ←
 →

Közbenső kimenet
Ezek a képtípusok a legjobb tömörítés biztosítására szolgálnak. A következő részben megvizsgáljuk, hogyan történik ez. De eddig annyit jegyezzünk meg, hogy a legköltségesebb memóriát igénylő az I-kép, a P-kép viszonylag olcsóbb, míg a videó számára a legelőnyösebb a B-kép.
Időbeli redundancia (képközi előrejelzés)
Nézzük meg, milyen lehetőségeink vannak az időbeli ismétlődések minimalizálására. Ezt a típusú redundanciát kölcsönös előrejelzési módszerekkel oldjuk meg.
Törekedjünk arra, hogy a 0 és 1 képkockák kódolásához a lehető legkevesebb bitet használjunk.
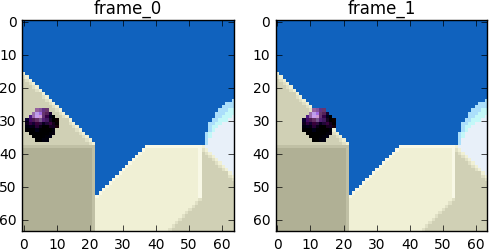
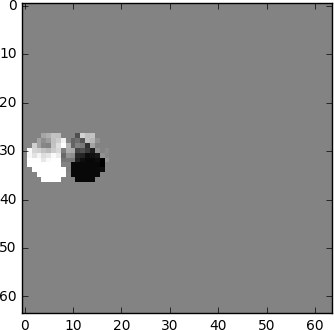
Készíthetünk kivonatot, egyszerűen kivonva az 1. képkockát a 0. képkockából. Így csak a különbséget kódoljuk az előző képkocka és az új képkocka között.
De mi lenne, ha azt mondanám, hogy van egy még jobb módszer, amely kevesebb bitet használ?! Először is osszuk fel a 0. képkockát egy világos rácsra, amely blokkokból áll. Aztán próbáljuk meg összepárosítani a 0. képkocka blokkjait az 1. képkockával. Más szavakkal, értékeljük a mozgást a képkockák között.
A Wikipédiából — blokk alapú mozgáskompenzáció
A blokk alapú mozgáskompenzáció a jelenlegi képkockát nem átfedő blokkokra osztja, és a mozgáskompenzáló vektorok megmondják, honnan származnak a blokkok (az elterjedt tévhit az, hogy az előző képkocka nem átfedő blokkokra oszlik, és a mozgáskompenzáló vektorok azt mutatják meg, hová kerülnek ezek a blokkok. Valójában fordítva van — nem az előző képkockát elemzik, hanem a következőt, és nem azt nézik, hová mozognak a blokkok, hanem azt, hogy honnan érkeztek). Az alap blokk általában átfedésekkel rendelkezik az alap képkockában. Egyes videótömörítési algoritmusok a jelenlegi képkockát nem egy, hanem több korábban átadott képkockából rakják össze.
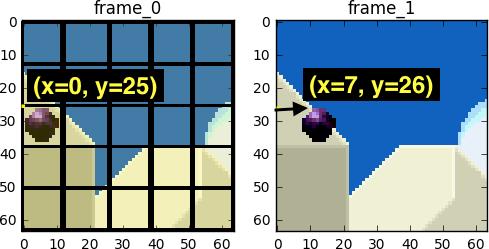
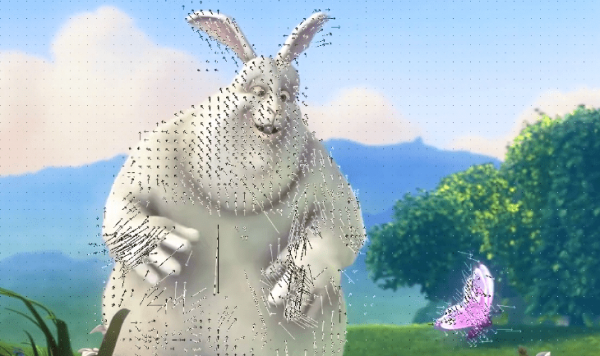
A becslési folyamat során látjuk, hogy a golyó a(z) (x=0, y=25) helyről áthelyeződött a(z) (x=6, y=26) helyre, az értékek x és y meghatározza a mozgás vektorát. Még egy lépés, amit megtehetünk a bitek megőrzéséhez, az az, hogy csak a blokknak az utolsó pozíciója és a prognosztizált helyzete közötti mozgás vektor különbségét kódoljuk, így a végső mozgás vektor (x=6-0=6, y=26-25=1) lesz.
A valós helyzetben ez a golyó részekre lenne osztva n blokkokra, de a lényegen ez nem változtat.
A keretben lévő objektumok három dimenzióban mozognak, ezért amikor a golyó mozog, vizuálisan kisebbé (vagy nagyobbá, ha a néző felé mozog) válhat. Normális, hogy nem lesz tökéletes egyezés a blokkok között. Íme a becslésünk összesített nézete és a valós kép.
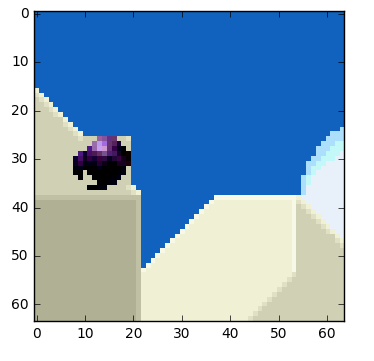
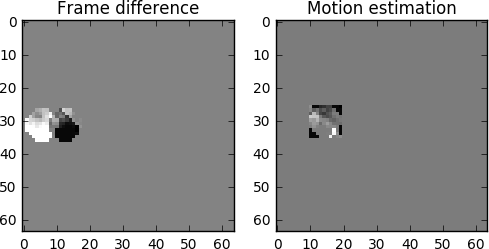
De látjuk, hogy amikor alkalmazzuk a mozgás becslését, a kódoláshoz szükséges adatok jelentősen kevesebbek, mint egy egyszerűbb módszer alkalmazásakor, amely a különbséget számolja a keretek között.
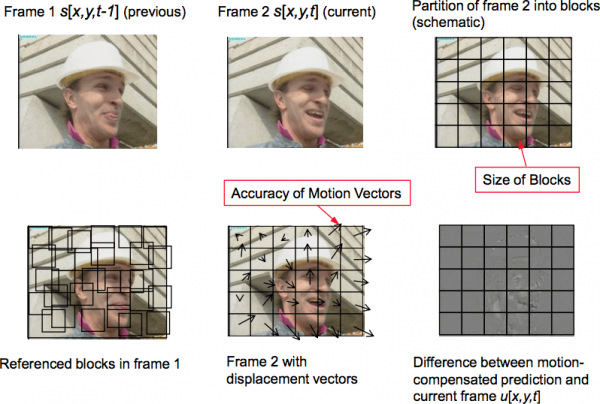
Hogyan fog kinézni a valós mozgáskompenzáció
Ez a módszer az összes blokkra egyszerre alkalmazandó. Gyakran a feltételezett mozgó golyónk több blokkra is fel lesz osztva.
Ezeket a koncepciókat saját kezével is megérintheti, ha .
A mozgásvektorok megtekintéséhez készíthet egy videót külső előrejelzéssel a .
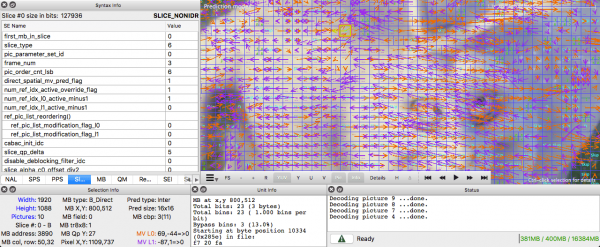
Ezen kívül használhatja a (ez fizetős, de van egy ingyenes próbaidőszaka, amely csak az első tíz keretre korlátozódik).
Térbeli redundancia (belső előrejelzés)
Ha minden egyes keretet elemezünk a videóban, számos összefüggő területet találunk.
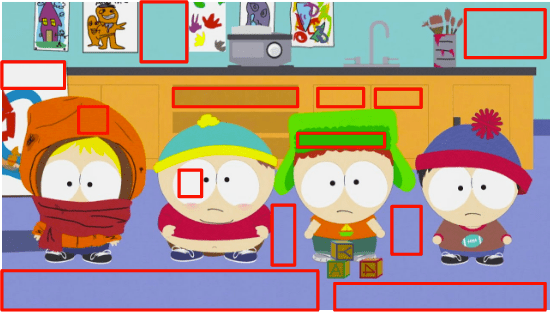
Nézzük meg ezt a példát. Ez a jelenet főként kék és fehér színekből áll.
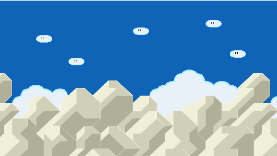
Ez egy I-kép. Az előző képeket nem tudjuk előrejelzésként használni, de így is sikerül tömöríteni. Kódoljuk a piros blokk kiemelését. Ha megnézzük a szomszédait, észrevesszük, hogy körülötte van néhány színbeli tendencia.
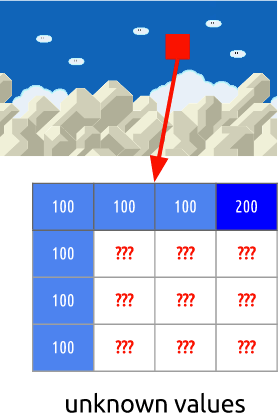
Feltételezzük, hogy a keretben a színek függőlegesen terjednek. Ez azt jelenti, hogy az ismeretlen pixelek színei a szomszédai értékeit fogják tartalmazni.
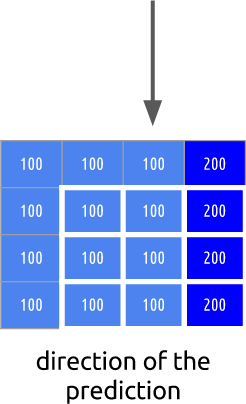
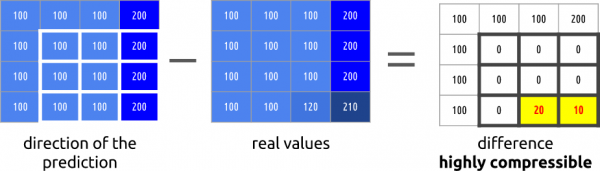
Ez a prognózis téves is lehet. Éppen ezért ezt a módszert (belső prognózis) kell alkalmazni, és utána ki kell vonni a valós értékeket. Ez ad nekünk egy maradék blokkot, ami összehasonlítva az eredetivel, sokkal tömörebb mátrixot eredményez.
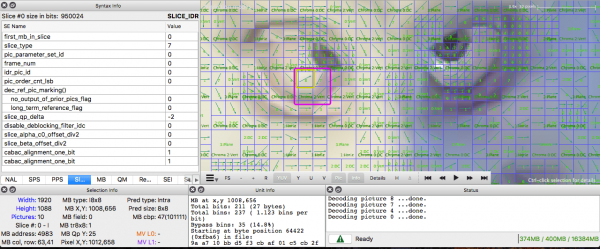
Ha szeretné gyakorolni a belső előrejelzéseket, videót készíthet a makroblokkokról és azok előrejelzéseiről az ffmpeg segítségével. A blokkok színének jelentésének megértéséhez meg kell ismerkednie az ffmpeg dokumentációjával.
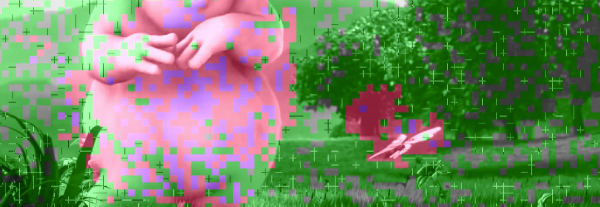
Vagy használhatja az Intel Video Pro Analyzer-t (ahogy már fent említettem, a próbaverzióban az első 10 képkockára korlátozás van, de ez kezdetben elegendő lesz az Ön számára).
Második rész:
Forrás: habr.com
