

Minél bonyolultabb egy rendszer, annál több figyelmeztetéssel terhelik. Felmerül a szükség, hogy reagáljunk ezekre a figyelmeztetésekre, aggregáljuk őket és vizualizáljuk. Azt hiszem, ez a helyzet sokak számára ismerős lehet a idegesítő rángásokig.
A megoldás, amiről szó lesz, nem a legmeglepőbb, de teljes cikket a témában nem található.
Ezért úgy döntöttem, hogy megosztom a FunCorp tapasztalatait, és elmesélem, hogyan épül fel a ügyeleti folyamat, ki hív, miért, és hogyan lehet mindezt követni.
Mi az a PagerDuty?
Tehát, hogy megoldjuk ezeket a feladatokat, elkezdtük keresni egy kényelmes eszközt. Rövid keresgélés után a PagerDuty-ra esett a választásunk. A PD teljes és tömör megoldásnak tűnt, sok integrációval és beállítással. Miről van szó?
Röviden, a PagerDuty egy incidentszolgáltató platform, amely képes kezelni a bejövő eseményeket különböző integrációkon keresztül, beállítani az ügyelet rendjét, és az esemény szintje szerint figyelmeztetni az ügyeletes mérnököt (magas szintű esemény esetén hívás, alacsony szintű esetén push értesítés/applikációs SMS).
Ki az ügyeletes?
Valószínűleg ezt kellene az első lépésként beállítani a PD-nél.
A FunCorp-nál, akárcsak más cégeknél, van egy tisztség, az ügyeletes. Ez a tisztség naponta átadódik egy mérnökről a másikra. Van egy úgynevezett első és második vonal, mely reagál a PagerDuty figyelmeztetéseire. Tegyük fel, hogy egy magas prioritású figyelmeztetés érkezik, és ha 10 percen belül az első vonal ügyeletes mérnökre nem reagálnak (tehát nem került az állapota bringás vagy megoldott státuszba), a hívás átkerül a második ügyeletes mérnökhöz. Ez a PagerDuty-n belül az Escalation Policies-en keresztül van beállítva.
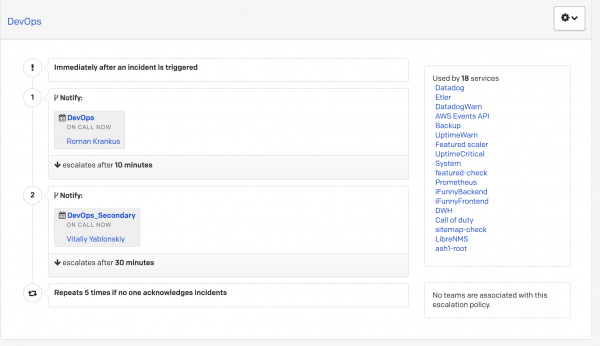
Ha a második ügyeletes sem válaszol, akkor az értesítés visszatér a fő ügyeleteshez.
Így tehát egyetlen bejövő magas prioritású figyelmeztetés sem maradhat feldolgozatlanul.
Most nézzük meg, honnan érkezhetnek az incidensek.
Milyen integrációkat használunk?
A PD-re sokféle esemény érkezik különböző szolgáltatásoktól. Jelenleg körülbelül 25 ilyen szolgáltatásunk van, és ezek feldolgozásához néhány kész integrációt használunk.
- Prometheus
A fő metrikagyűjtő rendszer a Prometheus. Erről már sokat írtak a Habr-on, csak annyit mondanék, hogy nekünk több válfaja van, különböző környezetekhez: az egyik a virtuális gépekről és konténerekről gyűjt metrikákat, a másik az Amazontól érkező szolgáltatásokból, a harmadik pedig a „termális gépekből”. Főként környezeti metrikák exportálására a Telegraf-ot használjuk.
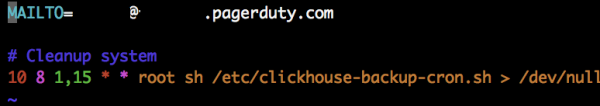
Itt is, gondolom, minden világos a névből. Ez az integráció a bizonyos, cron segítségével végrehajtott szkriptekből érkező értesítések küldésére szolgál. A PD ad neked egy címet, ahová küldheted az e-maileket. A szolgáltatás létrehozásakor ilyen integrációval beállíthatod a prioritásokat, milyen sorrendben dolgozzák fel a beérkező incidenseket, és hogy pontosan hogyan létrehozni az értesítéseket (minden beérkező e-mailre, egy beérkező e-mail + egy bizonyos szabály stb.).
- Slack
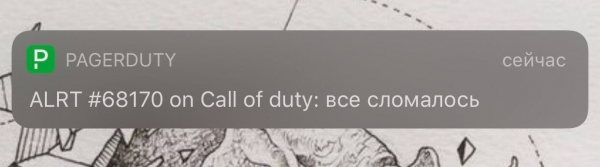
Szerintem ez egy nagyon érdekes integráció. Vannak olyan esetek, amikor valami történik, de nem éri el az incidenst. Ezért adtunk hozzá integrációt a Slack-ből incidens létrehozására. Vagyis a vállalati Slack-ben lehet írni /callofduty все тормозит и скоро сломается és a PD feldolgozza ezt, és küld egy incidenst a járőr mérnöknek.
A következőket csináljuk:
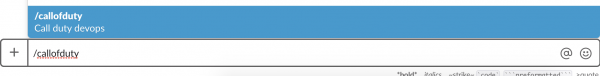
Látjuk:
- API
HTTP integráció. Itt valójában nincs igazán érdekes dolog, csak egy POST-kérés JSON-formátumú törzs tartalommal. Például az érdekes: mi ezt használjuk külső monitorozásra a . Ez a szolgáltatás ellenőrzi weboldalaink elérhetőségét a világ különböző pontjairól. Amikor elfogadhatatlan válaszkódot kapunk (például 502), incidens keletkezik, és minden a fent leírt láncolat szerint történik. A StatusCake-ben lehetőség van belső URL-ek, SSL-tanúsítványok vagy domain lejárati idejének monitorozására is.
- LibreNMS
Ez egy másik monitorozási rendszer, amelyről részletesebben olvashatsz a honlapjukon . Ezzel nyomon követjük a hálózati interfészeket és az iDRAC-ot a szerverekből.
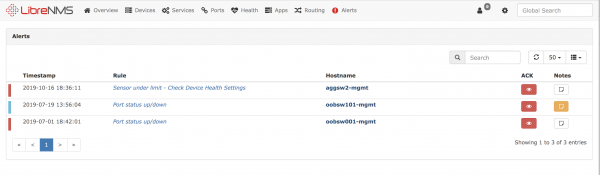
Voltak még olyan integrációk, mint a Datadog, CloudWatch. Részletesebben arról, hogy mi lett velük, itt nézhetsz utána .
Vizualizáció.
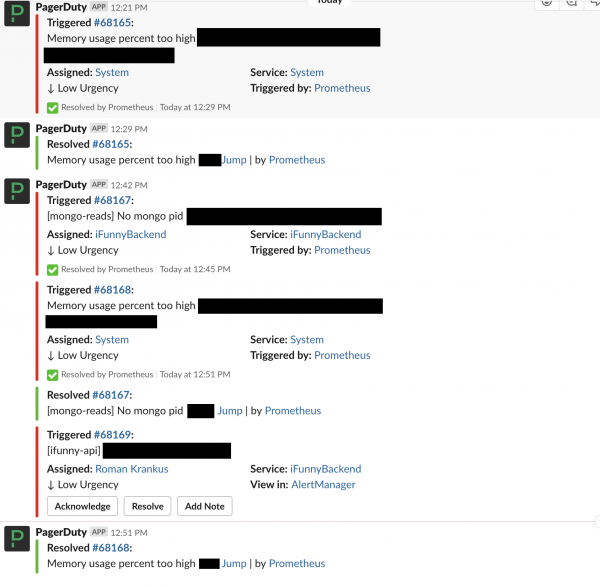
A fő incidensértesítési rendszer a Slack. Egy külön csoportba írják az összes beérkező PD-incidens, és ha a státuszuk megváltozik, ez is megjelenik a csoportban.
Amikor lehetőség nyílt hasznos adatokat megjeleníteni a plafonra függesztett monitorokon, hirtelen rájöttünk, hogy nekünk (a devops részlegnek) nincs mit kivetítenünk. Van egy nagyszerű Grafana, de az nem fed le mindent, ráadásul a kollégák az értesítésekre reagálnak, nem pedig a grafikonokra.
Miután alapos, de eredménytelen keresést végeztünk GitHub-on egy tömör és informatív PD tábláért, úgy döntöttünk, hogy írunk egy sajátot — csak ami nekünk szükséges. Bár először az ötlet volt, hogy a PD felületét jelenítsük meg, de ez még kényelmetlenebbnek tűnt.
Ehhez elegendő csak a PD-től egy read-only kulcsot beszerezni.
És ezt sikerült létrehoznunk:
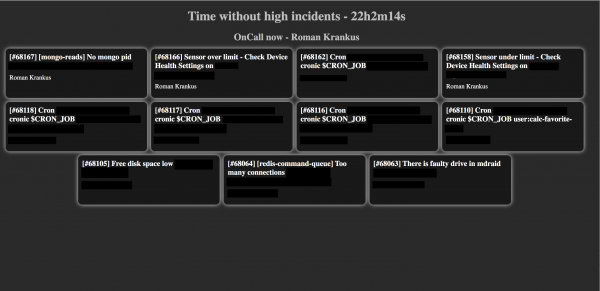
A képernyőn aktuális nyitott incidensek, a kiválasztott ütemezésből származó aktuális ügyeletes mérnök neve és a magas prioritású incidens nélküli idő jelenik meg (a magas prioritású incidens panel pirossal lesz kiemelve).
.
Végül egy kényelmes műszerfalat kaptunk, amellyel az összes incidensünket átnézhetjük. Örülnék, ha valakinek a tapasztalatunk hasznos lenne.
Forrás: habr.com
