

2019-et írunk, és még mindig nincs standard megoldásunk a Kubernetes logok aggregálására. Ebben a cikkben szeretnénk valós példákon keresztül megosztani kereséseinket, az út során felmerült problémákat és azok megoldásait.
Azonban először azt szeretném tisztázni, hogy a különböző megrendelők nagyon eltérően értelmezik a logok gyűjtését:
- valaki a biztonsági és audit logokat szeretné látni;
- valaki – a teljes infrastruktúra központosított naplózását;
- másoknak pedig elegendő, ha csak az alkalmazás logjait gyűjtik, például a terheléselosztókat kizárva.
Arról, hogyan valósítottuk meg a különböző "kívánságokat" és milyen nehézségekkel szembesültünk, a következő részben olvashat.
Elmélet: a logok eszközei
A naplózási rendszer összetevőiről szóló előzmények
A naplózás hosszú utat járt be, amelynek eredményeként kidolgozódott a logok gyűjtésének és elemzésének metodológiája, amit manapság is alkalmazunk. Még az 1950-es években a Fortran-ban megjelentek a standard input-output folyamok analógjai, amelyek segítették a programozókat a programjaik hibakeresésében. Ezek voltak az első számítógépes logok, amelyek megkönnyítették a korabeli programozók életét. Ma ezekben látjuk a naplózási rendszer első összetevőjét – a logok forrását vagy "termelőt" (producer).
A számítástudomány nem állt meg: megjelentek a számítógépes hálózatok, az első klaszterek... Bonyolult rendszerek kezdtek működni, amelyek több számítógépből álltak. Most a rendszergazdák kénytelenek voltak logokat gyűjteni több gépről, és különleges esetekben a rendszerösszeomlás kivizsgálása érdekében a kernel üzeneteket is hozzáadhatták. A központosított loggyűjtő rendszerek leírására a 2000-es évek elején megjelent , amely a remote_syslog-ot standardizálta. Így született egy újabb fontos összetevő: a loggyűjtő (collector) és azok tárolója.
A logok mennyiségének növekedésével és a webtechnológiák széles körű elterjedésével felmerült a kérdés, hogy a logokat kényelmesen kell bemutatni a felhasználóknak. Az egyszerű parancssori eszközöket (awk/sed/grep) fejlettebb, logmegtekintő eszközök váltották fel – a harmadik összetevő.
A naplózás terjedésével világossá vált, hogy szükség van naplókra, de nem mindegyikre. Ráadásul a különböző naplók eltérő megőrzési szintet igényelnek: egyeseket egy nap elteltével el lehet veszíteni, míg másokat öt évig kell tárolni. Így a naplózási rendszerhez hozzáadódott egy adatfolyam szűrő és irányító komponens – nevezzük szűrőnek.
A tárhelyek is komoly fejlődésen mentek keresztül: a hagyományos fájlokról áttértek relációs adatbázisokra, majd dokumentum-centrikus tárolókra (például Elasticsearch). Így a gyűjtő különvált a tárolótól.
Végső soron, a napló fogalma kiterjedt egyfajta absztrakt eseménysorra, amelyet meg szeretnénk őrizni a történelem számára. Pontosabban, arra az esetre, ha nyomozásra vagy analitikai jelentés készítésére lenne szükség…
Ennek eredményeként, viszonylag rövid idő alatt, a naplók gyűjtése fontos alrendszerré fejlődött, amely joggal nevezhető a Big Data egyik részének.
Ha egykor a hagyományos print-ek elegendőek voltak a "naplózási rendszer" számára, most a helyzet nagymértékben megváltozott.
Kubernetes és naplók
Amikor a Kubernetes megjelent az infrastruktúrában, a már meglévő naplógyűjtési probléma nem kerülte el. Felérve a helyzet még kiélezettebbé vált: az infrastruktúra-platform kezelése egyszerre könnyűbbé és bonyolultabbá vált. Számos régi szolgáltatás elkezdett átállni a mikroszolgáltatás-alapú architektúrákra. A naplók összefüggésében ez megnyilvánult a naplóforrások számának növekedésében, saját életciklusukban, és az összes rendszerkomponens közötti kapcsolatok nyomon követésének szükségességében…
Előrehaladva megállapíthatom, hogy sajnos jelenleg nincs standardizált naplózási lehetőség a Kubernetes számára, amely jelentősen megkülönböztetné magát az összes többitől. A legnépszerűbb közösségi sémák a következőkre redukálódtak:
- valaki egy EFK (Elasticsearch, Fluentd, Kibana) rendszert telepít; valaki – a nemrégiben kiadott
- vagy használja a naplózási operátort minket ;
- sok esetben saját fejlesztésüket preferálják – Általában, ezek a kombinációk találhatóak a K8s klaszterekben (self-hosted megoldásokhoz): Fluentd + Elasticsearch + Kibana …
Fluentd + ClickHouse + loghouse
- ;
- .
Nem állok meg a telepítési és konfigurálási utasításoknál. Ehelyett a hiányosságokra és a logokkal kapcsolatos általános következtetésekre fogok összpontosítani.
Logok kezelése K8s-ben
Mindennapi logok, hányan is vagytok?..
A központosított loggyűjtés egy elég nagy infrastruktúrából nem csekély erőforrást igényel, amelyeket a logok gyűjtésére, tárolására és feldolgozására fordítunk. Különböző projektekkel kapcsolatos tapasztalataink során különféle követelményekkel és ezekből kifolyó problémákkal találkoztunk.
Próbáljuk ki a ClickHouse-t
Nézzük meg a központosított tárolást egy olyan projekten, amely eléggé aktívan generál logokat: több mint 5000 sor másodpercenként. Kezdjük el a logjaival való munkát, és gyűjtsük őket a ClickHouse-ba.
Amint maximális realtime-ra van szükség, a 4 magos szerver ClickHouse-szal már túlterhelt lesz a lemezalrendszerén:
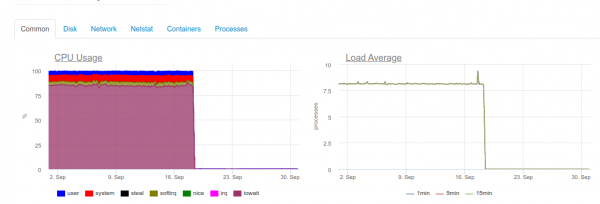
Ez a terheléstípus azért van, mert megpróbálunk minél gyorsabban írni a ClickHouse-ba. És erre az adatbázis fokozott lemezterheléssel reagál, ami ilyen hibákat eredményezhet:
DB::Exception: Túl sok partíció (300). A fúziók jelentősen lassabban feldolgozhatók, mint a beszúrások
A dolog az, hogy a ClickHouse-ban (ahol a logok adatai vannak) írási műveletek során saját nehézségekkel bírnak. A beszúrt adatok ideiglenes partíciót generálnak, amely később összeolvad a fő táblázattal. Ennek következtében az írás nagyon igényli a lemezt, és az előbb említett korlátozás is vonatkozik rá: másodpercenként nem lehet több mint 300 alegység (gyakorlatilag ez 300 INSERT másodpercenként).
A hasonló viselkedés elkerülése érdekében minél nagyobb adagokban, és ne gyakrabban, mint 2 másodpercenként írjunk. Azonban a nagyobb adagokban való írás azt feltételezi, hogy ritkábban kell írni a ClickHouse-ba. Ez viszont a pufferek túlcsordulásához és logok elvesztéséhez vezethet. A megoldás a Fluentd pufferméretének növelése, de ezzel együtt a memóriafogyasztás is növekszik.
Megjegyzés: A ClickHouse megoldásunk másik problémás oldala az volt, hogy a particionálás az esetünkben (loghouse) külső táblákon keresztül valósult meg, amelyek kapcsolódnak . Ez arra vezet, hogy nagy időszeletek lekérdezésekor túlzottan sok RAM szükséges, mivel a metatáblázat végigmegy az összes partíción – még azokon is, amelyek nyilvánvalóan nem tartalmazzák a szükséges adatokat. Azonban a jelenlegi ClickHouse verziókra ez a megközelítés bátran elavultnak tekinthető (c ).
Végső soron világossá válik, hogy a ClickHouse-ban valós időben történő naplógyűjtéshez a szükséges erőforrások nem minden projekt számára elegendőek (pontosabban, ezek elosztása nem lesz célszerű). Ezenkívül szükséges lesz használni akkumulátor, ehhez még visszatérünk. A fent leírt eset – valós. Abban az időszakban nem tudtunk megbízható és stabil megoldást ajánlani, amely kielégítette volna a megrendelőt, és lehetővé tette volna a naplók minimális késleltetéssel történő gyűjtését…
De mi a helyzet az Elasticsearch-szel?
Tudvalévő, hogy az Elasticsearch jól kezeli a nagy terheléseket. Próbáljuk ki ugyanabban a projektben. Most a terhelés a következőképpen néz ki:
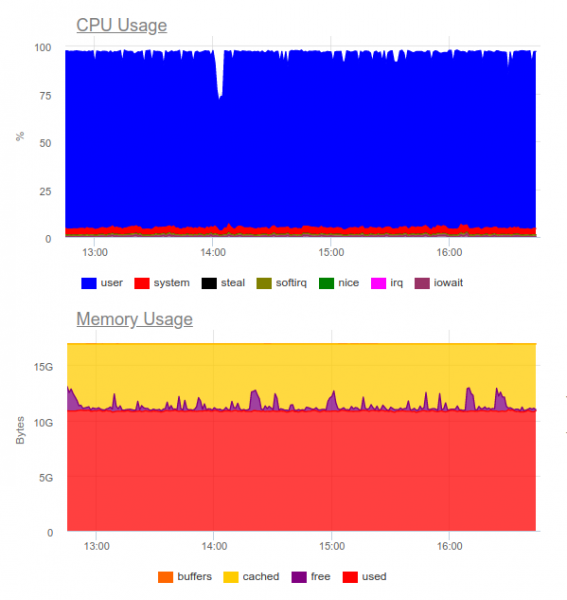
Az Elasticsearch képes volt feldolgozni az adatfolyamot, azonban az ilyen mennyiségű adat beírása erősen igénybe veszi a CPU-t. Ezt klaszterizálással lehet megoldani. Széles értelemben ez nem probléma, azonban előfordul, hogy a naplógyűjtő rendszer működéséhez már körülbelül 8 magot használunk, és egy további, nagy terhelésű komponens van a rendszerben…
Összegzés: ilyen megoldás indokolt lehet, de csak abban az esetben, ha a projekt nagy, és annak vezetősége hajlandó jelentős erőforrásokat költeni a központosított naplózási rendszerre.
Ezért felmerül a jogos kérdés:
Milyen naplókra van igazán szükség?
 Próbáljuk meg megváltoztatni magát a megközelítést: a naplóknak egyszerre információnak kell lenniük, és nem szabad lefedniük minden eseményt a rendszerben.
Tegyük fel, hogy van egy prosperáló internetes boltunk. Milyen naplók fontosak? Maximum információt gyűjteni például a fizetési kaputól – nagyszerű ötlet. De a termékek katalógusában található képfeldolgozó szolgáltatástól nem minden napló kritikus: elég csak a hibákra és a kiterjesztett monitorozásra (például az 500-as hibák százalékára, amelyeket ez a komponens generál).
Eljutottunk odáig, hogy a központosított naplózás távolról sem mindig indokolt. Nagyon gyakran a megrendelő szeretné az összes naplót egy helyen gyűjteni, bár a valóságban az egész naplóból csupán körülbelül 5%-os üzenetekre van szükség, amelyek kritikusak az üzlet számára:
- Néha elegendő csak a konténer napló méretét és a hibagagyogató beállításait (például Sentry) megadni.
- Az események kivizsgálásához gyakran elegendő a hibairól szóló értesítés és egy nagy helyi napló.
- Volt olyan projektünk is, amely kifejezetten funkcionális tesztekkel és hibagyűjtő rendszerekkel is megelégedett. A fejlesztőnek nem volt szüksége naplókra, hiszen mindent láttak a hibahelyek nyomán.
Életből vett illusztráció
Jó példaként szolgálhat egy másik történet. Egy ügyfelünk biztonsági csapatától érkezett kérés egy kereskedelmi megoldásra, amelyet még a Kubernetes bevezetése előtt fejlesztettek ki.
Szükség volt a központi naplógyűjtő rendszer és a vállalati problémadetektáló érzékelő – QRadar – összekapcsolására. Ez a rendszer képes a syslog protokollon logokat fogadni és FTP-n keresztül lekérdezni. Azonban az integrációt a fluentd remote_syslog pluginnal eleinte nem tudtuk megvalósítani. (mint kiderült, ). A QRadar beállításával kapcsolatos problémák az ügyfél biztonsági csapatának oldalán jelentkeztek.
Ennek eredményeként a naplók egy része, amely létfontosságú volt az üzlet számára, az FTP QRadar-ra került, míg a másik rész közvetlenül a csomópontokról jutott el a remote syslog-on keresztül. Ehhez még készítettünk - talán ez segít valakinek megoldani egy hasonló feladatot... A kapott séma alapján az ügyfél kapta és elemezte a kritikus naplókat (a kedvenc eszközeivel), míg mi csökkenteni tudtuk a naplózási rendszer költségeit, csak az utolsó hónapot megőrizve.
Egy másik példa jól mutatja, hogyan nem szabad csinálni. Az egyik ügyfelünk a felhasználótól érkező esemény feldolgozására többsoros minden strukturálatlan naplózást valósított meg. Mint könnyen kitalálható, az ilyen naplókat rendkívül nehéz volt olvasni és tárolni. Egy napló kritériumai
Az ilyen példák arra utalnak, hogy a naplógyűjtő rendszer kiválasztása mellett
a naplókat is meg kell tervezni! Mik a követelmények itt?A naplóknak gép által olvasható formátumban kell lenniük (például JSON).
- A naplóknak kompaktaknak és a naplózási szint variálásának lehetőségeivel kell rendelkezniük, hogy a lehetséges problémákat el lehessen hárítani. Ugyanakkor a production környezetekben olyan szintű naplózás mellett kell működtetni a rendszereket, mint
- Логи должны быть компактными и с возможностью изменения степени логирования, чтобы отладить возможные проблемы. При этом в production-окружениях следует запускать системы с уровнем логирования вроде Figyelmeztetés vagy Hiba.
- A naplóknak normalizáltnak kell lenniük, azaz a naplóobjektumban minden sor azonos mezőtípusú legyen.
A strukturálatlan naplók problémákat okozhatnak a naplók tárolásának betöltése során, és teljes megállásához vezethetnek. Példaként nézzük meg a 400-as hibát, amellyel sokan találkoztak a fluentd naplóiban:
2019-10-29 13:10:43 +0000 [figyelmeztetés]: hibás esemény átkonvertálása: error_class=Fluent::Plugin::ElasticsearchErrorHandler::ElasticsearchError hiba="400 - Megtagadva az Elasticsearch által"
A hiba azt jelenti, hogy egy olyan mezőt küldesz az indexbe egy előre felállított mapping-gal, amelynek típusa nem stabil. A legegyszerűbb példa egy mező a nginx naplóban a következő változóval: $upstream_status. Ebben lehet szám és szöveg egyaránt. Például:
{ "ip": "1.2.3.4", "http_user": "-", "request_id": "17ee8a579e833b5ab9843a0aca10b941", "time": "29/Oct/2019:16:18:57 +0300", "method": "GET", "uri": "/staffs/265.png", "protocol": "HTTP/1.1", "status": "200", "body_size": "906", "referrer": "https://example.com/staff", "user_agent": "Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/78.0.3904.70 Safari/537.36", "request_time": "0.001", "cache_status": "-", "upstream_response_time": "0.001, 0.007", "upstream_addr": "127.0.0.1:9000", "upstream_status": "200", "upstream_response_length": "906", "location": "staff"}
 { "ip": "1.2.3.4", "http_user": "-", "request_id": "47fe42807f2a7d8d5467511d7d553a1b", "time": "29/Oct/2019:16:18:57 +0300", "method": "GET", "uri": "/staff", "protocol": "HTTP/1.1", "status": "200", "body_size": "2984", "referrer": "-", "user_agent": "Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/78.0.3904.70 Safari/537.36", "request_time": "0.010", "cache_status": "-", "upstream_response_time": "0.001, 0.007", "upstream_addr": "10.100.0.10:9000, 10.100.0.11:9000", "upstream_status": "404, 200", "upstream_response_length": "0, 2984", "location": "staff"}
A naplók alapján a 10.100.0.10 szerver 404-es hibát adott vissza, és a lekérdezés egy másik tartalomtárolóra került. Ennek eredményeképpen a naplók értéke így alakult:
"upstream_response_time": "0.001, 0.007"
Ez a helyzet annyira elterjedt, hogy még külön említést is kapott a .
Mi a helyzet a megbízhatósággal?
Vannak esetek, amikor elengedhetetlen, hogy minden napló nélkül kivétel nélkül rendelkezésre álljon. Ezzel tipikus K8s naplóminták, amelyeket a fentiekben javasoltak/vizsgáltak, problémákba ütköznek.
Például a fluentd nem tudja összegyűjteni a naplókat a rövid életű konténerekből. Az egyik projektünkben a migrációs adatbázisokat kezelő konténer kevesebb mint 4 másodpercig élt, majd eltávolításra került — a megfelelő annotáció szerint:
"helm.sh/hook-delete-policy": hook-succeeded
Ezért a migrációs futás naplója nem került a tárolóba. Ebben az esetben segíthet a politics before-hook-creation..
Egy másik példa a Docker naplók forgatása. Tegyük fel, hogy van egy alkalmazás, amely aktívan ír a naplókba. Normál körülmények között a naplókat sikerül összegyűjtenünk, de amint probléma merül fel — például a fent említett hibás formátum megjelenésekor — a feldolgozás megáll, és a Docker forgatja a fájlt. Az eredmény: kritikus üzleti naplók veszhetnek el.
Ezért Fontos elkülöníteni a naplóáramokat, beépítve a legértékesebb üzenetek közvetlen küldését az alkalmazásba, hogy megőrizzük őket. Ezenkívül nem árt, ha létrehozunk egy naptárlapot a naplók számára, amely képes elviselni a tároló rövid ideig tartó elérhetetlenségét, miközben a kritikus üzeneteket menti.
Végül ne feledjük el, hogy fontos minden alrendszert megfelelően monitorozni. Ellenkező esetben könnyen szembesülhetünk azzal a helyzettel, amikor a fluentd CrashLoopBackOff állapotban van. és semmit nem küld el, ami fontos információk elvesztését ígéri.
Következtetések
Ebben a cikkben nem foglalkozunk a SaaS-megoldásokkal, mint például a Datadog. Sok, itt leírt problémát már megoldottak a kereskedelmi cégek, amelyek a naplógyűjtésre specializálódtak, de nem mindenki tudja használni a SaaS-t különböző okok miatt. (főbb okok — a költség és a 152-FZ betartása).
A központosított naplógyűjtés először egyszerű feladatnak tűnik, de valójában nem az. Fontos megjegyezni, hogy:
- Csak a kritikus összetevőket érdemes részletesen naplózni, míg a többi rendszer számára beállítható a hibák monitorozása és gyűjtése.
- A produkciós naplókat minimálisra kell csökkenteni, hogy ne terheljék túl a rendszert.
- A naplóknak géppel olvashatónak, normalizáltnak kell lenniük, és szigorú formátumot kell követniük.
- A valóban kritikus naplókat külön folyamként érdemes továbbítani, ami el kell, hogy legyen választva a fő folyamtól.
- Érdemes átgondolni egy naplóakkumulátort, amely megvéd a magas terhelések csúcsaitól, és egyenletesebbé teszi a tárolásra rakódó terhelést.
Ezek az egyszerű szabályok, ha mindenhol alkalmazzák őket, lehetővé tennék a fent leírt rendszerek működését — még akkor is, ha hiányoznak belőlük fontos összetevők (akkumulátor). Ha viszont nem tartjuk be ezeket az elveket, a feladat könnyedén egy újabb magas terhelésű (és egyben hatékonytalan) rendszerkomponenshez vezethet.
P.S.
Olvasson további információkat a blogunkban:
- «»;
- «»;
- «».
Forrás: habr.com
