

Előtted ismét egy objektumazonosító feladat áll. A prioritás a munka sebessége elfogadható pontosság mellett. Vedd a YOLOv3 architektúrát és finomítsd tovább. A pontosság (mAp75) meghaladja a 0.95-öt. De a futási sebesség még mindig alacsony. A francba.
Ma elkerüljük a kvantálást. A hivatkozás alatt megvizsgáljuk Model Pruning — a felesleges részek eltávolítása a hálózatból az Inferencia felgyorsítása érdekében anélkül, hogy csökkenne a pontosság. Látványosan — hol, mennyit és hogyan lehet kivágni. Megnézzük, hogyan lehet ezt kézzel végrehajtani, és hol lehet automatizálni. A végén — egy repozitórium a keras-ra.
Bevezetés
Az előző munkahelyemen, a perm városbeli Macroscop-nál egy szokásra tettem szert — mindig figyeltem az algoritmusok végrehajtási idejét. A hálózatok futási idejét mindig az adekvátsági szűrőn keresztül ellenőrzöm. Általában a legjobbnak számító modellek nem felelnek meg ennek a szűrőnek, ami elvezetett a Pruninghoz.
A Pruning — egy régi téma, amiről 2017-ben beszéltek. A fő ötlet — a tanult hálózat méretének csökkentése a pontosság elvesztése nélkül, különböző csomópontok eltávolításával. Jól hangzik, de ritkán hallok az alkalmazásáról. Valószínűleg nincsenek implementációk, nincsenek oroszul írt cikkek, vagy egyszerűen mindenki úgy véli, hogy a pruning újdonság és hallgat róla.
De nézzük meg közelebbről
Pillantás a biológiába
Szeretem, amikor a Deep Learning-be biológiából érkező ötletek csúsznak be. Nekik, akárcsak a fejlődésnek, lehet bízni (tudtad, hogy a ReLU nagyon hasonlít a ?)
A Model Pruning folyamata is közel áll a biológiához. A hálózat reakcióját itt össze lehet hasonlítani az agy plaszticitásával. Néhány érdekes példa található Norman Doidge könyvében. :
- A fiú megsebesítette magát az agyának azon részén, amely a látásért felelős. Idővel más agy részek átvették ezeket a funkciókat. (ezt nem próbáljuk megismételni)
- Éppen így a te modelledből is eltávolítható egy rész gyenge konvolúciós réteg. Végső esetben a megmaradt konvolúciók segíthetnek pótolni az eltávolítottakat.
Szereted a Transfer Learning-et, vagy nulláról tanulsz?
Első lehetőség.
Opció egy. Transfer Learning-t használsz a Yolov3-on. Retina, Mask-RCNN vagy U-Net. De a leggyakrabban nem kell 80 objektumtípus felismerése, mint a COCO-ban. A gyakorlatomban általában 1-2 osztályra korlátozódik. Felmerül a kérdés, hogy a 80 osztályra tervezett architektúra itt túlzó. Érdemes lenne csökkenteni az architektúrát, és szeretném ezt úgy megtenni, hogy ne veszítsek a meglévő előképzett súlyokból.
A második lehetőség. Lehet, hogy sok adatod és számítási erőforrásod van, vagy egyszerűen egy szuper testreszabott architektúrára van szükséged. Ez nem számít. De a hálózatot nulláról tanítod. A szokásos folyamat az, hogy megnézzük az adatszerkezetet, kiválasztunk egy TÚLZOTT teljesítményű architektúrát, és nyomjuk le a dropoutokat a túltanulás ellen. Láttam 0.6-os dropoutot, Karl.
Mindkét esetben a hálózat csökkenthető. Megmotiváltuk. Most nézzük meg, miről is van szó a pruning-ról.
Általános algoritmus
Úgy döntöttünk, hogy eltávolíthatunk konvolúciókat. Ez elég egyszerűen néz ki:
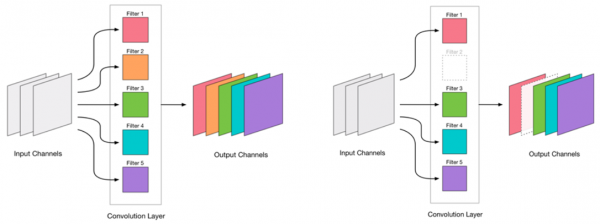
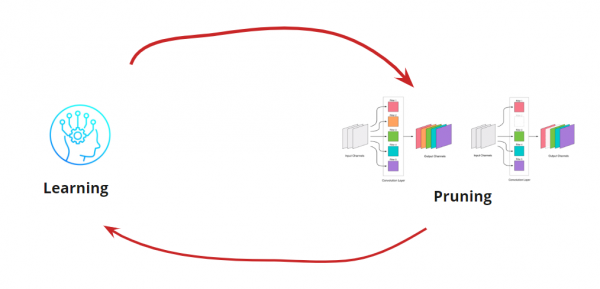
Bármely konvolúció eltávolítása stresszel jár a hálózat számára, ami általában egy bizonyos hibának a növekedésével jár. Egyfelől ez a hibanövekedés azt mutatja, hogy mennyire helyesen távolítjuk el a konvolúciókat (például egy nagy emelkedés azt jelzi, hogy valamit nem jól csinálunk). De egy kis növekedés teljesen elfogadható, és gyakran a következő könnyű finomítás megszünteti ezt kis LR-rel. Hozzáadunk egy finomítási lépést:
Most meg kell értenünk, mikor szeretnénk leállítani a Learning<->Pruning ciklusunkat. Létezhetnek egzotikus lehetőségek, amikor a hálózatot egy meghatározott méretre és gyorsaságra kell csökkenteni (például mobil eszközök esetén). Azonban a leggyakoribb lehetőség az, hogy folytatjuk a ciklust, amíg a hiba el nem éri a megengedett határt. Hozzáadunk egy feltételt:
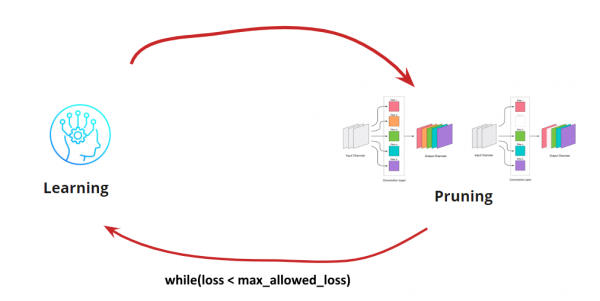
Tehát az algoritmus érthetővé válik. Még meg kell vizsgálni, hogyan határozzuk meg a törlendő konvolúciókat.
Törlendő konvolúciók keresése
Néhány konvolúciót el kell távolítanunk. Bemászni és "kilőni" a tetszőlegeseket rossz ötlet, bár működni fog. De mivel van eszünk, érdemes gondolkodni, és megpróbálni kiemelni a törlésre szánt "gyenge" konvolúciókat. Több lehetőség is van:
- . Az elképzelés azt mondja, hogy a kis súlyú konvolúciók kis mértékben járulnak hozzá a végső döntéshez.
- Legkisebb L1-érték, figyelembe véve az átlagot és a szórást. Kiegészítjük a megoszlás jellegének értékelésével.
- . A jelentéktelen burkolatok pontosabb meghatározása, de elég idő- és erőforrás-igényes.
- Egyéb
Mindegyik lehetőség életképes, és saját megvalósításának sajátosságai vannak. Itt a legkisebb L1-mértékkel rendelkező lehetőséget fogjuk megvizsgálni.
Kézi folyamat a YOLOv3 számára
A kiindulási architektúrában maradék blokkok találhatóak. De bármennyire is menők a mély hálózatoknál, egy kicsit zavaróak számunkra. A nehézség abban rejlik, hogy nem lehet különböző indexű burkolatokat törölni ezekben a rétegekben:
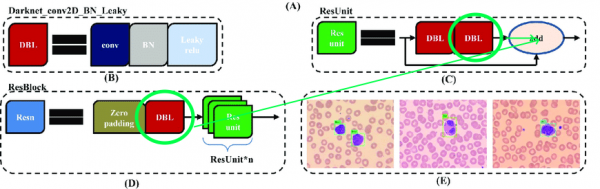
Ezért kiemeljük azokat a rétegeket, amelyekből szabadon eltávolíthatjuk a burkolatokat:

Most építsünk egy ciklust:
- Kivesszük az aktiválásokat
- Megfontoljuk, mennyit vágjunk ki
- Kivágjuk
- 10 epochot tanítunk LR=1e-4 mellett
- Tesztelés
A burkolatok eltávolítása hasznos, hogy felmérjük, milyen részt távolíthatunk el egy adott lépésben. Példák a kivonásra:
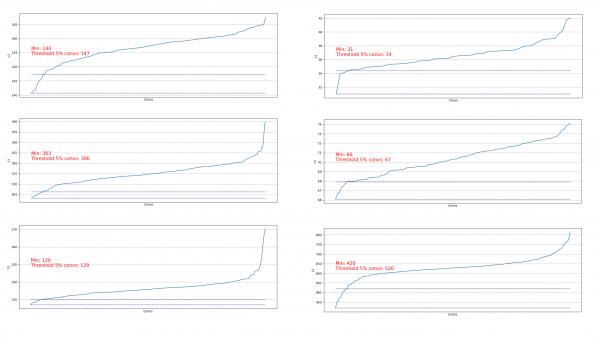
Látjuk, hogy szinte mindenütt 5% burkolat rendelkezik meglehetősen alacsony L1-normával, és eltávolíthatjuk őket. Minden lépésben ilyen kivonás történt és értékelést végeztünk, hogy mely rétegekből és mennyit szabad eltávolítani.
Az egész folyamat 4 lépésbe fért bele (itt és mindenhol a számok az RTX 2060 Super-hez tartoznak):
| teljes törlést tud végezni bármely fájlra, amely a helyi tárolóban található | mAp75 | Paraméterek száma, millió | A háló mérete, MB | A kezdeti állapothoz képest, % | Futási idő, ms | Kivágási feltételek |
|---|---|---|---|---|---|---|
| 0 | 0.9656 | 60 | 241 | 100 | 180 | — |
| 1 | 0.9622 | 55 | 218 | 91 | 175 | 5% az összesből |
| 2 | 0.9625 | 50 | 197 | 83 | 168 | 5% az összesből |
| 3 | 0.9633 | 39 | 155 | 64 | 155 | 15% a 400+ burkolatú rétegekhez |
| 4 | 0.9555 | 31 | 124 | 51 | 146 | 10% a 100+ burkolatú rétegekhez |
A 2. lépéshez hozzáadódott egy pozitív hatás — a memória meghallgatta a 4-es batch-size-t, ami jelentősen felgyorsította a további tanulási folyamatot.
A 4. lépésnél a folyamatot leállították, mivel még a hosszú további tanulás sem emelte meg a mAp75-öt a korábbi értékekre.
Végül sikerült felgyorsítani az inferencia folyamatát 15%, csökkenteni a méretet 35% és nem veszítettünk a pontosságból.
Automatizálás egyszerűbb architektúrákhoz
Egyszerűbb hálózati architektúrák esetén (feltételes add, concat és residual blokkok nélkül) célszerű lehet az összes burkolati réteg feldolgozására támaszkodni, és automatizálni a burkolatok kivágásának folyamatát.
Ezt a megoldást implementáltam .
Minden egyszerű: csak a veszteségfunkciót, az optimalizálót és a batch-generátorokat kell biztosítanod:
import pruning
from keras.optimizers import Adam
from keras.utils import Sequence

train_batch_generator = BatchGenerator...
score_batch_generator = BatchGenerator...

opt = Adam(lr=1e-4)
pruner = pruning.Pruner("config.json", "categorical_crossentropy", opt)

pruner.prune(train_batch, valid_batch)
Szükség esetén a konfigurációs paraméterek módosíthatók:
{
    "input_model_path": "model.h5",
    "output_model_path": "model_pruned.h5",
    "finetuning_epochs": 10, # a finomhangolás epokainak száma a metszési lépések között
    "stop_loss": 0.1, # a leállási folyamat vesztesége
    "pruning_percent_step": 0.05, # a törlendő konvolúciók része minden metszési lépésnél
    "pruning_standart_deviation_part": 0.2 # eltolás a metszési rész korlátozásához
}
Továbbá, megvalósítottunk egy korlátozást a szórás alapján. Célja a törlendő rész korlátozása, kizárva azokat a konvolúciókat, amelyek már "megfelelő" L1-értékekkel rendelkeznek:
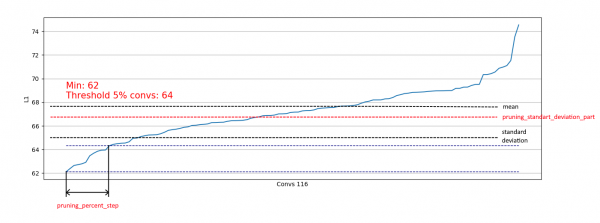
Ezzel lehetővé tesszük, hogy csak a gyenge konvolúciókat távolítsuk el az olyan eloszlásokból, mint a jobb oldali, és ne befolyásoljuk a bal oldali eloszlás törlését:
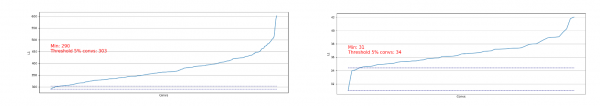
A normális eloszláshoz való közelítéssel a pruning_standart_deviation_part értékét a következőkből tudjuk megválasztani:
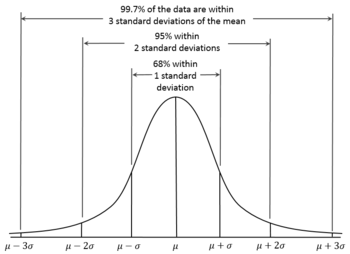
Ajánlom a 2 szigma alkalmazását. Vagy nem is kell figyelembe venni ezt a jellemzőt, és hagyhatjuk az értéket < 1.0.
Az eredmény egy grafikon a háló méretéről, a veszteségről és a háló futtatásának idejéről az egész teszt során, 1.0-ra normalizálva. Például itt a háló mérete majdnem a felére csökkent veszteség nélkül (kicsi konvolúciós háló 100k súllyal):
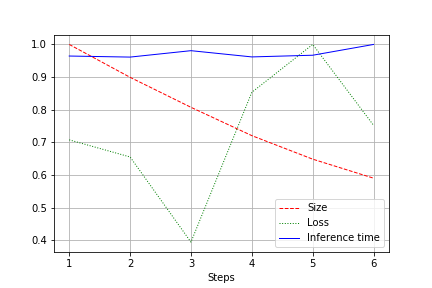
A futtatás sebessége normális ingadozásoknak van kitéve, és gyakorlatilag nem változott. Ennek magyarázata van:
- A konvolúciók száma a kényelmes (32, 64, 128) értékekről a videokártyák számára nem annyira kényelmesekre — 27, 51 stb. Itt hibázhatok, de valószínűleg ez befolyásolja.
- Az architektúra nem széles, de sorozatos. A szélesség csökkentésével nem érintjük a mélységet. Ezzel csökkentjük a terhelést, de nem változtatjuk a sebességet.
Ezért a javulás a CUDA terhelésének 20-30%-os csökkenésében nyilvánul meg, de nem a végrehajtási idő csökkenésében.
Összegzés
Gondolkodjunk el. Két pruning lehetőséget vizsgáltunk – a YOLOv3-hoz (amikor kézi munkára van szükség) és egyszerűbb architektúrájú hálózatokhoz. Látható, hogy mindkét esetben elérhető a háló méretének csökkentése és gyorsítás, anélkül hogy a pontosság csökkenne. Eredmények:
- Méretcsökkentés
- Futtatás felgyorsítása
- CUDA terhelés csökkentése
- Ennek következményeként a környezettudatosság (optimalizáljuk a jövőbeli számítási erőforrások használatát. Valahol örül egy )
Appendix
- A pruning lépés után lehetőség van a kvantálásra is (például TensorRT-vel)
- A Tensorflow lehetőségeket kínál a . Működik.
- Szeretném fejleszteni, és örömmel veszem a segítséget.
Forrás: habr.com
