

— egy oszlopos adatbázis-kezelő rendszer online analitikai kérdések feldolgozására (OLAP), nyílt forráskódú, amelyet a Yandex fejlesztett ki. A Yandex, CloudFlare, VK.com, Badoo és más szolgáltatások világszerte használják, hogy valóban nagy adatmennyiségeket tároljanak (ezrek beillesztése másodpercenként vagy petabájt adatok tárolása a lemezen).
A hagyományos, "soros" adatbázisok, mint például a MySQL, Postgres, MS SQL Server, az adatok a következő sorrendben vannak tárolva:
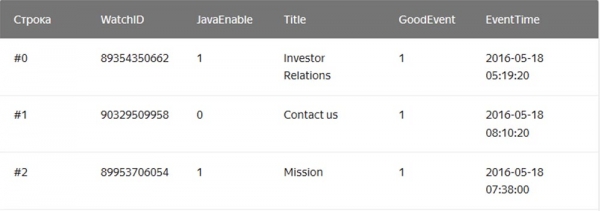
Ezenkívül az egy sorhoz tartozó értékek fizikailag közel vannak tárolva. Az oszlopos adatbázisokban a különböző oszlopok értékei külön tárolódnak, míg egy oszlop adatai együtt:
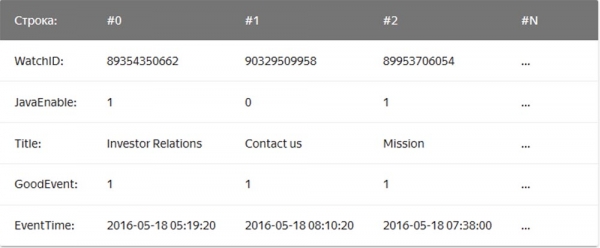
Az oszlopos adatbázisok példái a Vertica, Paraccel (Actian Matrix, Amazon Redshift), Sybase IQ, Exasol, Infobright, InfiniDB, MonetDB (VectorWise, Actian Vector), LucidDB, SAP HANA, Google Dremel, Google PowerDrill, Druid, kdb+.
Cég – levelező forwarder 2018-ban kezdte el használni a Clickhouse-t jelentések készítéséhez, és nagyon lenyűgözte a rendszer egyszerűsége, skálázhatósága, SQL támogatása és sebessége. Ennek az adatbázis-kezelő rendszernek a sebessége a varázslat határán állt.
Egyszerűség
A Clickhouse telepítése Ubuntura egyetlen parancs segítségével történik. Ha ismeri az SQL-t, azonnal elkezdheti használni a Clickhouse-t saját igényei szerint. Ez azonban nem jelenti azt, hogy egyszerűen végrehajthatja a "show create table" parancsot a MySQL-ben, majd másolhatja és beillesztheti az SQL-t a Clickhouse-ba.
A MySQL-hez képest ebben az adatbázis-kezelő rendszerben fontos különbségek vannak az adattípusokban a táblák sémadefinícióiban, ezért a kényelmes munka érdekében mégis szüksége lesz egy kis időre a táblasémák módosításához és a táblamozgatók tanulmányozásához.
A Clickhouse kiválóan működik bármilyen kiegészítő szoftver nélkül, de ha replikációt szeretne használni, telepítenie kell a ZooKeeper-t. A lekérdezések teljesítményének elemzése kiváló eredményeket mutat — a rendszer táblák minden információt tartalmaznak, és minden adat elérhető a régi és unalmas SQL segítségével.
Teljesítmény
- a Clickhouse és a Vertica, valamint a MySQL összehasonlítása egy konfigurációs szerveren: két Intel® Xeon® CPU E5-2650 v2 @ 2.60GHz; 128 GiB RAM; md RAID-5 8 6TB SATA HDD-n, ext4 fájlrendszeren.
- a Clickhouse összehasonlítása az Amazon Redshift felhőalapú adatbázisával.
- Az Clickhouse teljesítményéről szóló blogból származó kivonatok :
A ClickHouse adatbázis nagyon egyszerű dizájnnal rendelkezik – a klaszter összes csomópontja azonos funkcióval bír, és a koordinációhoz csak a ZooKeeper-t használják. Létrehoztunk egy kicsi klasztert néhány csomópontból, és tesztelést végeztünk, amely során megállapítottuk, hogy a rendszer meglehetősen figyelemre méltó teljesítménnyel bír, amely megfelel az analitikai DBMS-ek benchmarkjaiban megadott előnyöknek. Elhatároztuk, hogy részletesebben megvizsgáljuk a ClickHouse mögött álló koncepciót. Az első akadály a kutatások során az eszközök hiánya és a ClickHouse közösség csekély létszáma volt, ezért elmélyedtünk ennek az DBMS-nek a dizájnjában, hogy megértsük, hogyan működik.
A ClickHouse nem támogatja az adatok közvetlen fogadását a Kafkától, mivel ez csak egy adatbázis, ezért írtunk egy saját adapter szolgáltatást Go nyelven. Ez olvasta a Kafka által kódolt Cap’n Proto üzeneteket, átkonvertálta azokat TSV-re, és csoportosan beillesztette a ClickHouse-ba HTTP interfészen keresztül. Később ezt a szolgáltatást átírtuk, hogy a Go könyvtárat a ClickHouse saját interfészével együtt használja a teljesítmény növelése érdekében. A csomagok fogadásának teljesítményének értékelése során egy fontos dolgot fedeztünk fel – kiderült, hogy a ClickHouse teljesítménye jelentősen függ a csomag méretétől, vagyis a párhuzamosan beillesztett sorok számától. Hogy megértsük, miért történik ez, megvizsgáltuk, hogyan tárolja az adatokat a ClickHouse.
A ClickHouse által az adatok tárolására használt fő motor, pontosabban a táblák motorjainak családja a MergeTree. Ez a motor koncepcionálisan hasonló az LSM algoritmushoz, amelyet a Google BigTable vagy az Apache Cassandra alkalmaz, de elkerüli a köztes memóriatáblák létrehozását, és közvetlenül a lemezre írja az adatokat. Ez kiváló írási áteresztőképességet biztosít, mivel minden beillesztett csomag csak az elsődleges kulcs (primary key) szerint van rendezve, tömörítve és a lemezre írva a szegmens kialakítása érdekében.
A memória vagy bármilyen "frissességi" fogalom hiánya azt is jelenti, hogy az adatokat csak hozzáadni lehet, a módosítást vagy törlést a rendszer nem támogatja. Jelenleg az egyetlen módja az adatok törlésének az, hogy naptári hónapok szerint eltávolítjuk őket, mivel a szegmensek soha nem lépik át a hónap határait. A ClickHouse csapata aktívan dolgozik azon, hogy ezt a funkciót testreszabhatóvá tegye. Másrészt ez lehetővé teszi a szegmensek konfliktusmentes írását és egyesítését, így a bejövő sávszélesség lineárisan méretezhető a párhuzamos beszúrások számával, amíg csak nem következik be I/O vagy magok telítődése.
Ez a körülmény azonban azt is jelenti, hogy a rendszer nem alkalmas kisméretű csomagokra, ezért a párnázáshoz Kafka szolgáltatásokat és beszúrókat használnak. Ezen kívül a ClickHouse folyamatosan végzi a szegmensek háttérbeli egyesítését, így sok kisebb információs részlet egyesül és többször íródik, ezáltal növelve a rögzítési intenzitást. Ugyanakkor, ha túl sok kapcsolódatlan rész található, az agresszív beszúrás-throttlingot okozhat, amíg a folyamat egyesítése zajlik. Megállapítottuk, hogy a legjobb kompromisszum a valós idejű adatrögzítés és a bejövő teljesítmény között a másodpercenkénti korlátozott számú beszúrásos táblázat fogadása.
A táblák olvasási teljesítményének kulcsa az indexelés és az adatok lemezre helyezése. Bármilyen gyors is a feldolgozás, amikor a motornak terabájtnyi adatot kell átvizsgálnia a lemezről, és csak annak egy részét használja, az időt vesz igénybe. A ClickHouse oszlopos tároló, ezért minden szegmens tartalmaz egy fájlt minden oszlop számára (oszlopok) rendezett értékekkel minden sorhoz. Így a lekérdezésben lévő egész oszlopok először átugorhatók, majd néhány cella párhuzamosan feldolgozható a vektorizált végrehajtással. A teljes átvizsgálás elkerülése érdekében minden szegmensnek van egy kis indexfájlja.
Figyelembe véve, hogy az összes oszlop a „primer kulcs” alapján van rendezve, az index fájl csak a minden N-edik sor címkéit (befogott sorokat) tartalmazza, hogy még a nagyon nagy táblák esetében is képes legyen azokat memóriában tárolni. Például beállíthatók az alapértelmezett beállítások „minden 8192. sort megjelölni”, így egy „szegényes” indexelése egy 1 billió soros táblának, amely könnyen elfér a memóriában, mindössze 122 070 karaktert foglalna el.
A rendszer fejlődése
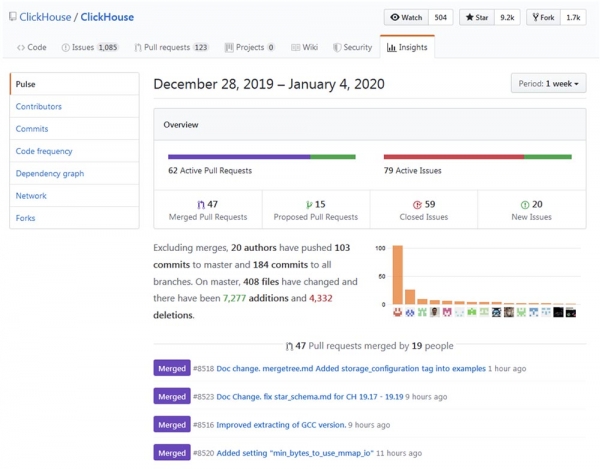
A Clickhouse fejlődése és tökéletesítése nyomon követhető a és meggyőződhet arról, hogy a „felnövés” folyamata imponáló sebességgel halad.
Népszerűség
Úgy tűnik, hogy a Clickhouse népszerűsége exponenciálisan nő, különösen a orosznyelvű közösségben. A tavalyi High load 2018 konferencia (Moscow, 2018. november 8-9.) megmutatta, hogy olyan óriások, mint a vk.com és a Badoo, használják a Clickhouse-t, mellyel adatokat (például naplókat) töltenek fel több ezer szerverről egyidejűleg. A 40 perces videóban . Hamarosan közzétesszük az anyaggal való könnyebb munkálkodás érdekében a beszámolót a Habr-n.
Alkalmazási területek
Miután eltöltöttem egy kis időt a kutatásokkal, úgy vélem, hogy vannak olyan területek, ahol a ClickHouse hasznos lehet vagy teljesen helyettesítheti más, hagyományosabb és népszerűbb megoldásokat, mint a MySQL, PostgreSQL, ELK, Google Big Query, Amazon RedShift, TimescaleDB, Hadoop, MapReduce, Pinot és Druid. Az alábbiakban részletezem a ClickHouse használatát a fent említett DBMS-ek modernizálása vagy teljes helyettesítése érdekében.
A MySQL és PostgreSQL lehetőségeinek szélesítése
Nemrégiben részben helyettesítettük a MySQL-t ClickHouse-szal az információs hírlevelek platformján . A probléma az volt, hogy a MySQL a nem átgondolt tervezés miatt minden elküldött levelet és az ebben lévő minden linket base64 hash-el rögzített, ezzel hatalmas MySQL táblát hozva létre (email_stats). Miután a szolgáltatás előfizetőinek mindössze 10 millió levelet küldtünk el, ez a tábla 150 GB fájlterületet foglalt el, és a MySQL elkezdett "lassulni" az egyszerű lekérdezések során. A fájlterület problémájának megoldására sikeresen alkalmaztuk az InnoDB tábla tömörítést, amely 4-szeresére csökkentette annak méretét. Azonban még mindig nincs értelme több mint 20-30 millió e-mailt tárolni a MySQL-ben csak a történelem olvasása miatt, mivel bármely egyszerű lekérdezés, amely valamilyen okból teljes átvizsgálást igényel, swap-hoz és nagy I/O terheléshez vezetett, amit rendszeresen Zabbix figyelmeztetésekkel jeleztünk.
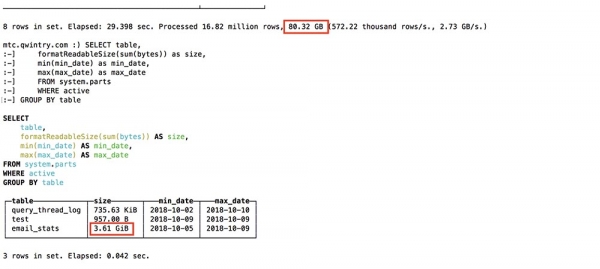
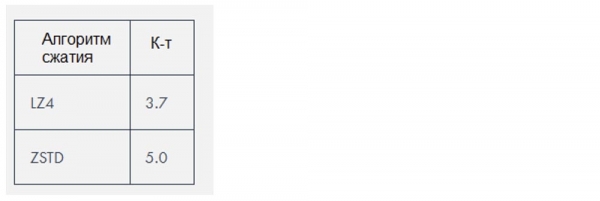
A Clickhouse két tömörítési algoritmust használ, amelyek körülbelül , de ebben az adott esetben az adatok különösen "tömöríthetők" voltak.
ELK kiváltása
Saját tapasztalatom alapján az ELK (ElasticSearch, Logstash és Kibana, ebben az esetben az ElasticSearch) sokkal több erőforrást igényel a működtetéshez, mint amennyi szükséges a naplók tárolásához. Az ElasticSearch egy kiváló motor, ha jó teljes szövegű keresést szeretne a naplókban (és nem hiszem, hogy valóban szüksége lenne rá), de érdekel, hogy miért vált de-facto standard motorrá a naplózáshoz. A vételi teljesítménye a Logstash-sal együtt problémákat okozott számunkra, még viszonylag kis terhelések mellett is, és egyre több RAM és tárolóhely hozzáadását igényelte. Az adatbázisként a Clickhouse jobb, mint az ElasticSearch az alábbi okok miatt:
- SQL dialektus támogatása;
- A tárolt adatok jobb tömörítési aránya;
- Regex szabályok keresésének támogatása a teljes szöveg keresése helyett;
- Javított lekérdezés-tervezés és általánosan magasabb teljesítmény.
Jelenleg a ClickHouse és az ELK összehasonlításának legnagyobb problémája a naplók kiszállítására szolgáló megoldások hiánya, valamint a témával kapcsolatos dokumentáció és útmutatók hiánya. Mindazonáltal minden felhasználó beállíthatja az ELK-t a Digital Ocean útmutatójával, ami nagyon fontos a hasonló technológiák gyors bevezetéséhez. Itt van egy adatbázis motor, de jelenleg nincs Filebeat a ClickHouse-hoz. Igen, ott van. és egy rendszer a naplók kezelésére , létezik egy eszköz a ClickHouse-ba történő naplófájlok betöltésére, de mindez több időt igényel. A ClickHouse mindenesetre vezető szerepet tölt be az egyszerűsége miatt, így még a kezdők is egyszerűen telepítik, és szó szerint 10 percen belül teljes funkcionálisan használják.
Minimalista megoldásokat preferálva megpróbáltam a FluentBit-et használni, amely egy nagyon kis memóriát igénylő naplóáramló eszköz, a ClickHouse-zal együtt, miközben próbáltam elkerülni a Kafka alkalmazását. Azonban néhány apró inkompatibilitást kell megszüntetni, mint például , mielőtt ezt proxy réteg nélkül lehetne megtenni, amely a FluentBit adatait ClickHouse-zá alakítja.
Alternatívaként a Kibana helyett a ClickHouse-t backendként használhatjuk . Amennyire megértettem, ez teljesítményproblémákat okozhat, amikor hatalmas mennyiségű adatpontot kell renderelni, különösen a régebbi Grafana verziókkal. A Qwintry-nk ezt eddig még nem próbálta, de időnként panaszok érkeznek a ClickHouse támogatási csatornájára a Telegramon.
A Google Big Query és az Amazon RedShift (nagyvállalati megoldás) helyett
A BigQuery tökéletes használata az 1 TB JSON adat betöltése és elemző lekérdezések futtatása. A Big Query egy nagyszerű termék, amelynek skálázhatóságát nehéz túlbecsülni. Ez egy sokkal bonyolultabb szoftver, mint a ClickHouse, amely saját klaszteren működik, de a kliens szempontjából sok közös van a ClickHouse-zal. A BigQuery gyorsan "drága" lehet, amint elkezdi fizetni minden SELECT után, így ez egy igazi SaaS megoldás az összes előnyével és hátrányával.
A ClickHouse a legjobb választás, ha sok számításigényes lekérdezést futtat. Minél több SELECT lekérdezést hajt végre naponta, annál inkább indokolt a Big Query ClickHouse-ra cserélése, mert ez több ezer dollárt segíthet megtakarítani, különösen, ha sok terabájt nyers adatot dolgoz fel. Ez nem vonatkozik a tárolt adatokra, amelyek feldolgozása a Big Query-ben viszonylag olcsó.
Alexander Zaytsev, az Altinity társalapítója által írt cikkben beszél a DB-hez való átállás előnyeiről.
Feleség TimescaleDB
A TimescaleDB a PostgreSQL kiterjesztése, amely optimalizálja az időalapú adatok kezelését az alapértelmezett adatbázisban., ).
Bár a ClickHouse nem komoly versenytárs az időalapú adatok terén, az oszlophatású struktúrája és vektoralapú lekérdezés-végrehajtási módszerei miatt az analitikai lekérdezések többségében lényegesen gyorsabb, mint a TimescaleDB. Ezenkívül a ClickHouse adatcsomagok feldolgozási teljesítménye körülbelül háromszorosa a TimescaleDB-nek, ráadásul 20-szor kevesebb lemezterületet használ fel, ami rendkívül fontos nagy mennyiségű történeti adatok kezelésekor..
A ClickHouse-szal ellentétben a TimescaleDB-ben csak ZFS vagy hasonló fájlrendszerek használatával lehet némi lemezterületet megtakarítani.
A ClickHouse közelgő frissítései valószínűleg bevezetik a delta tömörítést, ami még alkalmassá teszi az időalapú adatok feldolgozására és tárolására. A TimescaleDB jobb választás lehet, mint a "meztelen" ClickHouse a következő esetekben:
- kisebb telepítések esetén, nagyon kis memóriaállománnyal (<3 GB);
- a sok kis INSERT-események, amelyeket nem szeretne nagyobb töredékekbé bufferelni;
- jobb konzisztencia, egységesség és ACID követelmények;
- PostGIS támogatás;
- létező PostgreSQL táblákkal való integráció, mivel tulajdonképpen a TimescaleDB PostgreSQL.
Verseny a Hadoop és MapReduce rendszerekkel
A Hadoop és más MapReduce termékek sok bonyolult számítást képesek végezni, de általában hatalmas késleltetéssel működnek. A ClickHouse ezt a problémát javítja azzal, hogy terabájtnyi adatot dolgoz fel, és szinte azonnal szolgáltatja az eredményeket. Ennek következtében a ClickHouse sokkal hatékonyabb a gyors, interaktív analitikai kutatások lebonyolításában, ami érdekelheti az adatfeldolgozási szakembereket.
Verseny a Pinot és Druid rendszerekkel
A ClickHouse legközelebbi versenytársai az oszlopalapú, lineárisan skálázható open source termékek, a Pinot és a Druid. Az e rendszerek összehasonlításával kapcsolatos kiváló munka publikálva lett a 2018. február 1-jén.
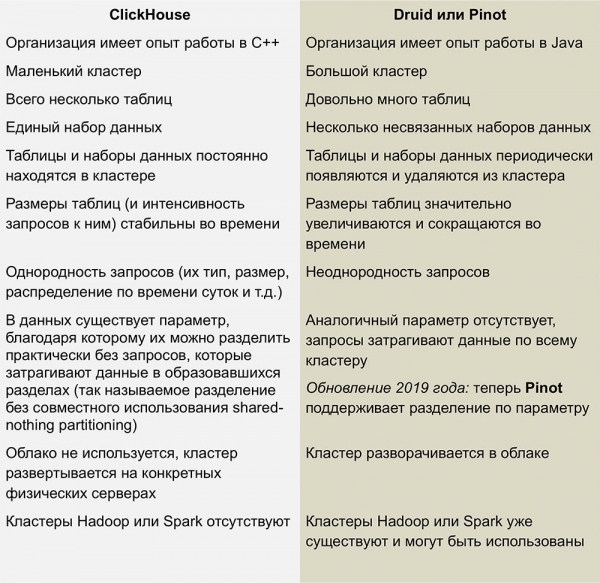
Ez a cikk frissítést igényel - azt állítja, hogy a ClickHouse nem támogatja az UPDATE és DELETE műveleteket, ami nem teljesen pontos a legújabb verziókkal kapcsolatban.
Nincs elegendő tapasztalatunk ezekkel az adatbázis-kezelő rendszerekkel, de egyáltalán nem tetszik a Druid és Pinot futtatásához szükséges infrastruktúra bonyolultsága — ez egy egész halom „mozgó alkatrész”, amiket Java vesz körül.
A Druid és a Pinot az Apache inkubátor projektei, fejlesztésük részletesen nyomon követhető az Apache GitHub oldalain. A Pinot 2018 októberében került az inkubátorba, míg a Druid 8 hónappal korábban, februárban született.
Az AFS működéséről szóló információk hiánya néhány, talán buta kérdést vet fel bennem. Érdekes, hogy észrevették-e a Pinot szerzői, hogy az Apache Alapítvány inkább a Druid felé hajlik, és vajon ez a versenytárs iránti hozzáállás nem okoz-e irigységet? Lassul-e a Druid fejlődése és felgyorsul-e a Pinot fejlődése, ha a Druidot támogató szponzorok hirtelen a Pinot iránt érdeklődnének?
A ClickHouse hátrányai
Éretlenség: nyilvánvaló, hogy ez még mindig egy izgalmas technológia, de így is, ilyesmi más oszlopos adatbázis-kezelőkben nem tapasztalható.
A kis beszúrások rosszul működnek nagy sebességgel: a beszúrásokat nagyobb darabokra kell osztani, mert a kis beszúrások teljesítménye arányosan csökken a soronkénti oszlopok számával. A ClickHouse-ban így tárolják az adatokat a lemezen — minden oszlop 1 fájlt vagy annál többet jelent, így egy 100 oszlopot tartalmazó sor beszúrásához legalább 100 fájlt kell megnyitni és írni. Ezért szükséges egy közvetítő a beszúrások pufferezéséhez (ha a kliens nem biztosítja a pufferezést) — általában ez a Kafka vagy valamilyen üzenetkezelő rendszer. Az is használható, mint a Buffer table motor, hogy később nagy mennyiségű adatot másoljunk a MergeTree táblákba.
A táblák közötti kapcsolatok a szerver memóriájára korlátozódnak, de legalább ott vannak! Például a Druid és a Pinot egyáltalán nem rendelkezik ilyen kapcsolatokkal, mivel ezek nehezen megvalósíthatók olyan elosztott rendszerekben, amelyek nem támogatják nagy mennyiségű adat mozgatását a csomópontok között.
Következtetések
A következő években széles körben tervezzük a ClickHouse használatát a Qwintryben, mivel ez az adatbázis-kezelő rendszer kiváló teljesítménye, alacsony költségei, skálázhatósága és egyszerűsége révén kiemelkedő. Szinte biztos vagyok benne, hogy gyorsan elterjed, amint a ClickHouse közössége több felhasználási módot kidolgoz a kis és közepes installációk számára.
Egy kis reklám 🙂
Köszönjük, hogy velünk maradtál. Tetszenek a cikkeink? Szeretnél több érdekes anyagot látni? Támogass minket, és rendelés leadásával vagy ismerősöknek ajánlással segíts nekünk. , Egyedülálló alternatívája az entry-level szervereknek, amelyet Önnek találtunk ki: (elérhetők RAID1 és RAID10 opciók, akár 24 magig és 40GB DDR4-ig).
Dell R730xd kétszer olcsóbban a Tier IV Equinix adatközpontban Amszterdamban? Csak nálunk Hollandiában! Dell R420 — 2x E5-2430 2.2GHz 6C 128GB DDR3 2x960GB SSD 1Gbps 100TB — 99 dollártól! Olvasd el ezt
Forrás: habr.com
