

A ünnepek véget értek, és visszatérünk Istio Service Mesh sorozatunk második bejegyzésével.
A mai téma a Circuit Breaker, ami magyarul 'automata', a köztudatban pedig 'védelem' néven ismert. Csakúgy, mint Istióban, ez az automata nem a rövidzárlatos vagy túlterhelt áramkört kapcsolja ki, hanem a hibás konténereket.
Hogyan kellene ideálisan működnie
Amikor a mikroszolgáltatásokat a Kubernetes kezeli, például az OpenShift platform keretében, automatikusan felskálázza őket a terheléstől függően. Mivel a mikroszolgáltatások podokban futnak, egy végponton egyszerre több példány is lehet a konténerizált mikroszolgáltatásból, és a Kubernetes irányítja a kéréseket, valamint elosztja a terhelést közöttük. Ideálisan mindez jól működik.
Tartsuk észben, hogy a mikroszolgáltatások kicsik és efemer természetűek. Az efemeritás, amely itt a keletkezés és eltűnés egyszerűségét jelenti, gyakran alábecsült. Egy újabb mikroszolgáltatás példány keletkezése és megszűnése a podban teljesen elvárt események, az OpenShift és a Kubernetes jól megbirkózik ezzel, és minden csodálatosan működik - de ismételni kell, ez csak elmélet.
Hogyan működik ez valójában
Most képzeljünk el egy konkrét mikroszolgáltatás példányt, vagyis egy konténert, ami meghibásodott: vagy nem válaszol (503 hiba), vagy - ami kellemetlenebb - reagál, de túl lassan. Más szóval, akadozik vagy nem válaszol a kérésekre, de a poolból automatikusan nem távolítják el. Mit kell tenni ebben az esetben? Ismételni a próbálkozást? Eltávolítani a forgalomirányítási sémából? És mit jelent az, hogy 'túl lassan' - mennyit jelent ez számokban, és ki határozza meg őket? Talán csak adjunk neki egy kis szünetet, és próbálkozzunk később? Ha igen, akkor mennyi később?
Mi az a Pool Ejection az Istióban
És itt jön a segítségünkre az Istio a Circuit Breaker védelemmel, amelyek ideiglenesen eltávolítják a hibás konténereket a forgalomirányítási és terheléselosztási erőforrások pooljából, megvalósítva a Pool Ejection eljárását.
Az Istio a kiugró detektálási stratégiát (outlier detection) alkalmazva azonosítja a görbéktől eltérő podokat, és eltávolítja őket a nyersanyag pooljából egy megadott időre, amit 'alvó ablaknak' (sleep window) neveznek.
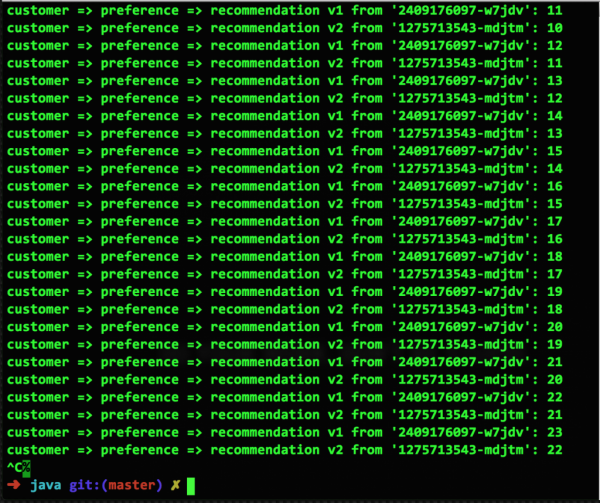
Ahhoz, hogy megmutassuk, hogyan működik a Kubernetes az OpenShift platformon, kezdjük egy képernyőképpel a megfelelően működő mikroszolgáltatásokról a tárolóból. . Itt két podunk van, v1 és v2, mindkettőben egy-egy konténerrel. Amikor az Istio irányítási szabályokat nem használják, a Kubernetes alapértelmezés szerint egyenletesen kiegyensúlyozott körkörös irányítást alkalmaz:
Felkészülés a hibára
Mielőtt végrehajtanánk a Pool Ejection-t, létre kell hoznunk egy Istio irányítási szabályt. Tegyük fel, hogy a pod-ok között 50/50 arányban szeretnénk elosztani a kéréseket. Ezen kívül növelni fogjuk a v2 konténerek számát egyből kettőre, így:
oc scale deployment recommendation-v2 --replicas=2 -n tutorial
Most beállítjuk az irányítási szabályt, hogy a forgalmat 50/50 arányban osszuk el a pod-ok között.
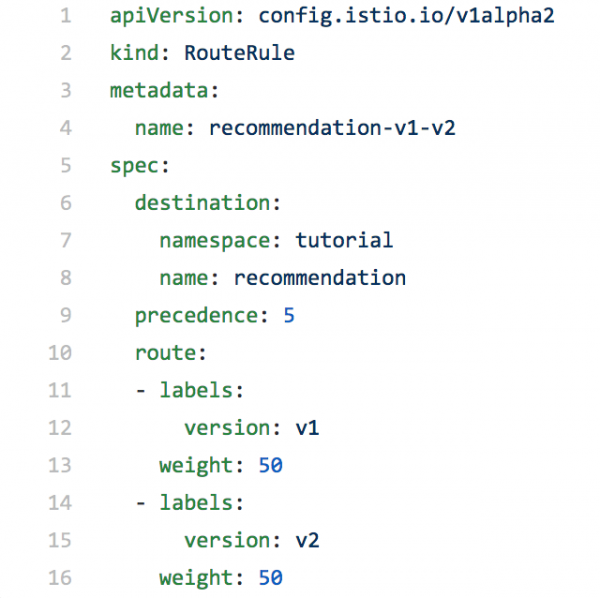
Így néz ki ennek a szabálynak az eredménye:
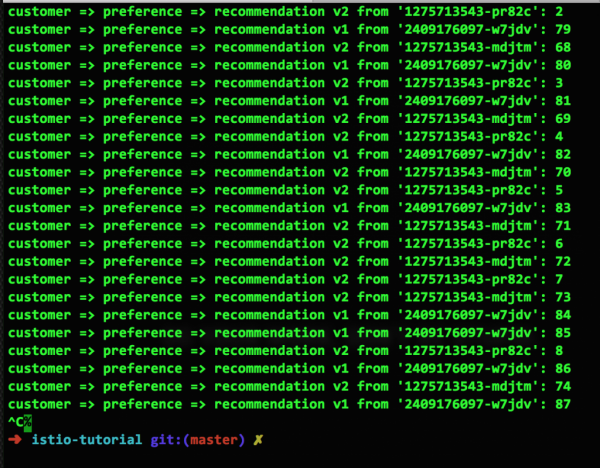
Jogosan merülhet fel a kérdés, hogy ezen a képernyőképen nem 50/50 az arány, hanem 14:9, de idővel a helyzet stabilizálódni fog.
Hiba okozása
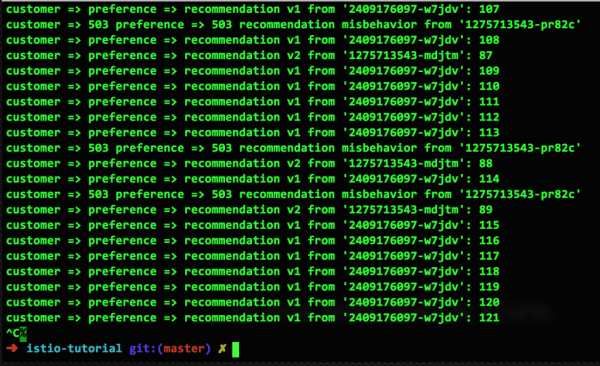
Most leállítunk egy v2 konténert, hogy legyen egy működő v1, egy működő v2 és egy nem működő v2 konténterünk:
Hiba javítása
Tehát van egy nem működő konténterünk, és itt az ideje a Pool Ejection-nak. Egy nagyon egyszerű konfigurációval 15 másodpercig kizárjuk ezt a hibás konténert minden irányítási sémából, abban a reményben, hogy magától visszatér a működésbe (vagy újraindul, vagy helyreállítja a teljesítményét). Így néz ki ez a konfiguráció és az eredményei:
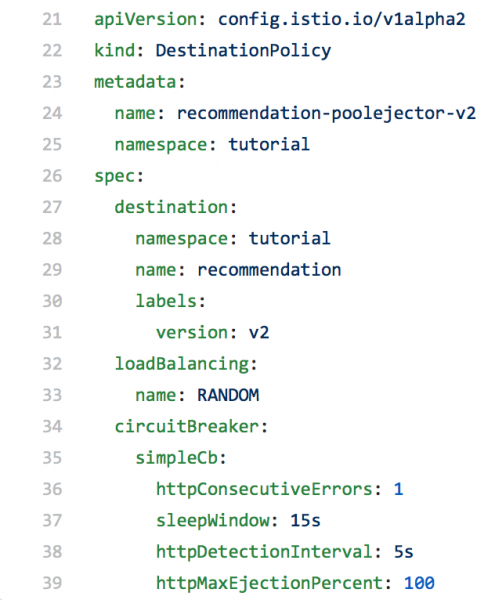
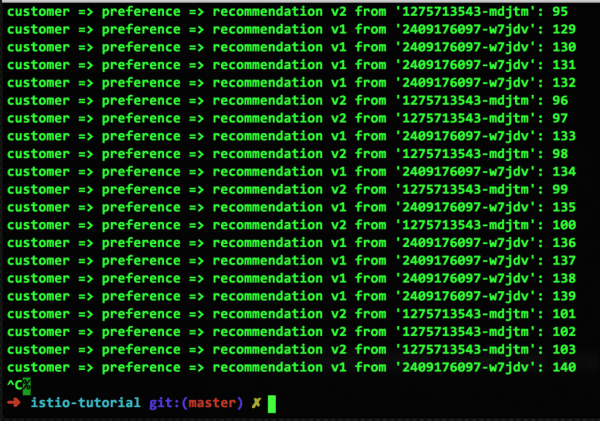
Ahogy látható, a hibás v2 konténert többé nem használják a kérések irányításában, mivel eltávolították a poolból. 15 másodperc elteltével automatikusan visszatér a poolba. Valójában csak most mutattuk be, hogyan működik a Pool Ejection.
Kezdünk építeni egy architektúrát
A Pool Ejection az Istio monitoring lehetőségeivel kombinálva lehetővé teszi a hibás konténerek automatikus helyettesítésére szolgáló keretrendszer kiépítését, hogy csökkentsük, vagy akár teljesen megszüntessük a leállásokat és hibákat.
A NASA-nak van egy híres mottója – Failure Is Not an Option, amelyet a repülési igazgató írt. . Magyarra úgy lehet lefordítani, hogy „A kudarc nem lehetőség”, és a jelentése az, hogy mindent működésre lehet bírni, ha van rá elegendő akarat. Az igazi életben azonban a hibák nem csupán előfordulnak, hanem elkerülhetetlenek, mindenhol és mindent. És hogyan kezeljük ezeket a mikroszolgáltatások esetében? Véleményünk szerint jobb, ha nem az akaratunkra támaszkodunk, hanem a konténerek képességeire, , , és a .
Az Istio, ahogy már említettük, remekül megvalósítja a fizikailag már jól bevált automatikus megszakítók koncepcióját. Ahogy az elektromos megszakító is lekapcsolja a problémás áramkört, úgy a programozási Circut Breaker az Istión az összeköttetést megszakítja a kérések áramlása és a problémás konténer között, amikor a végponttal valami baj van, például amikor a szerver leáll vagy elkezd akadozni.
A második esetben még több probléma merül fel, mivel egy konténer akadozása nemcsak láncreakciót indít el az általa elérni próbáló szolgáltatásokban, ezzel csökkentve a rendszer teljesítményét, hanem újabb kérésekhez is vezet a már amúgy is lassan működő szolgáltatáshoz, ami csak fokozza a helyzetet.
Circuit Breaker elméletben
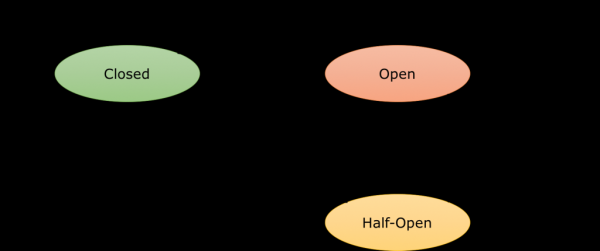
A Circuit Breaker egy proxy, amely ellenőrzi a kérések áramlását a végpont felé. Amikor ez a pont már nem működik, vagy – a beállításoktól függően – elkezd akadozni, a proxy megszakítja a kapcsolatot a konténerrel. A forgalom ezután más konténerekre kerül átirányításra, csupán a terhelés egyensúlyozása miatt. A kapcsolat nyitott (open) marad a megadott alvási időszak alatt, mondjuk két percig, majd félig nyitottnak (half-open) számít. A következő kérés elküldésének kísérlete meghatározza a kapcsolat állapotát. Ha a szolgáltatással minden rendben van, a kapcsolat visszatér a működő állapotba és ismét zártnak (closed) számít. Ha viszont a szolgáltatással továbbra is probléma van, a kapcsolat megszakad, és újraindul az alvási időszak. Íme, így néz ki a Circuit Breaker állapotváltásának leegyszerűsített diagramja:
Fontos megjegyezni, hogy mindez a rendszer architektúrájának szintjén zajlik. Ezért egy adott ponton meg kell tanítani az alkalmazásaidat a Circuit Breaker használatára, például alapértelmezett érték megadására válaszként, vagy ha lehetséges, a szolgáltatás létezésének figyelmen kívül hagyására. Ehhez a bulkhead minta használatos, de ez a cikk keretein túlmutat.
Circuit Breaker a gyakorlatban
Példának okáért futtatni fogunk két verziót a javaslatok mikroszolgáltatásunkból az OpenShift-en. Az 1. verzió normálisan fog működni, míg a v2-be késleltetést építünk be, hogy a szerver terhelését szimuláljuk. Az eredmények megtekintéséhez egy eszközt használunk :
siege -r 2 -c 20 -v customer-tutorial.$(minishift ip).nip.io
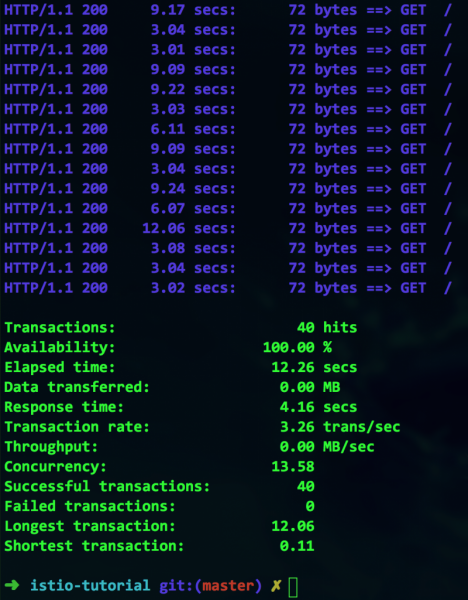
Minden úgy tűnik, hogy működik, de milyen áron? Első pillantásra 100% elérhetőségünk van, de nézd meg alaposabban – a tranzakciók maximális időtartama akár 12 másodperc is lehet. Ez nyilvánvalóan szűk keresztmetszet, és ezt kezelni kell.
Ezen okból kifolyólag az Istio segítségével kizárjuk a lassú konténerek elérését. Így néz ki a megfelelő konfiguráció a Circuit Breaker használatával:
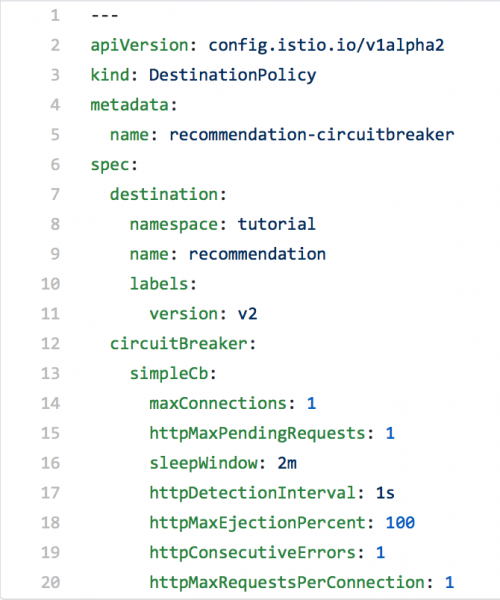
Az utolsó sor, amely a httpMaxRequestsPerConnection paramétert tartalmazza, jelzi, hogy a kapcsolatnak meg kell szakadásnia, ha próbálunk létrehozni egy új – második – kapcsolatot a már meglévő mellett. Mivel a konténerünk lassító szolgáltatást szimulál, ilyen helyzetek időről időre előfordulnak, és ilyenkor az Istio 503-as hibát fog visszaadni, de mit fog mutatni a siege:
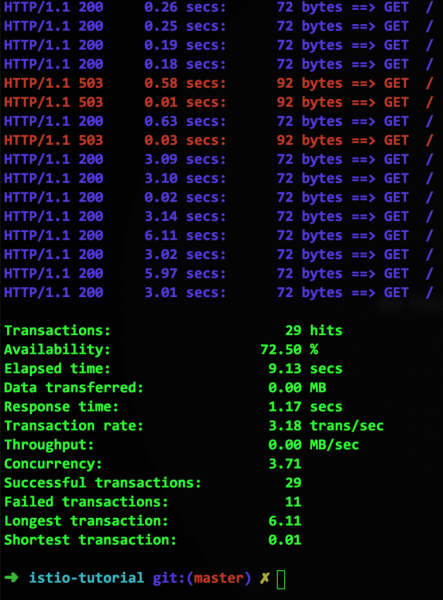
Rendben, van Circuit Breaker, mi a következő lépés?
Tehát automatikus lekapcsolást valósítottunk meg anélkül, hogy hozzá kellett volna nyúlnunk a szolgáltatások forráskódjához. A Circuit Breaker és a fent leírt Pool Ejection eljárás segítségével eltávolíthatjuk a lassító konténereket a források pooljából, amíg helyre nem állnak, és rendszeres időközönként ellenőrizhetjük az állapotukat – a példánkban ez két perc (sleepWindow paraméter).
Fontos megjegyezni, hogy az alkalmazásnak a 503-as hibára való reagálásának képessége még mindig a forráskódjában van meghatározva. Számos Circuit Breaker stratégiát alkalmaznak a helyzet függvényében.
A következő bejegyzésben: beszélünk a nyomkövetésről és a monitorozásról, amelyek már be vannak építve vagy könnyen hozzáadhatók az Istio-hoz, valamint arról, hogyan lehet szándékosan hibákat bevinni a rendszerbe.
Forrás: habr.com
