

Hogyan lehet az üzleti követelményeket konkrét adatstruktúrákba átültetni, a példán keresztül, ahogyan a "nulláról" tervezzük meg a messenger adatbázisát?
- 1. rész: az adatbázis vázszerkezetének megtervezése
Az adatbázisunk nem lesz olyan nagy és elosztott, vagy , hanem "csak, hogy legyen", de jól -- funkcionálisan, gyorsan és egyetlen szerverre elférjen PostgreSQL -- hogy külön példányt lehessen telepíteni valahol az oldalán, például.
Ezért nem fogjuk érinteni a sharding, replikáció és földrajzilag elosztott rendszerek kérdéseit, hanem a DB-beli sémákra összpontosítunk.
1. lépés: Kicsit üzlet-specifikus
A kommunikációnkat nem absztrakt módon tervezzük, hanem beágyazzuk a környezetébe. Vagyis az emberek nem "csak váltanak üzeneteket", hanem kommunikálnak egymással egy adott üzleti feladat megoldásának kontextusában.
Milyen feladatok léteznek az üzletben?.. Nézzük meg például Vasilyt, a fejlesztési osztály vezetőjét.
- "Nyikolaj, erre a feladatra a javítás már ma szükséges!"
Ezért a kommunikáció egy bizonyos kontextusban folytatódhat, dokumentum. - "Kolya, menjünk este Dota-ozni?"
Vagyis még egy pár beszélgető között is a kommunikáció egyszerre több témában zajlik különböző témák. - "Péter, Nyikolaj, nézd meg a csatolt árlistát az új szerverhez."
Tehát egy üzenetnek lehet több címzettje. Egy üzenet tartalmazhat csatolt fájlokat. - "Semen, te is nézd meg."
És lehetőség kell, hogy legyen már meglévő beszélgetésbe új résztvevőt meghívni.
Eddig megálljunk a "nyilvánvaló" igények listájával.
Anélkül, hogy megértenénk a feladat alkalmazási sajátosságait és az azok által támasztott korlátokat, szinte lehetetlen hatékony adatbázis-sémát tervezni a megoldáshoz.
2. lépés: Minimális logikai séma
A séma eddig nagyon hasonlít az email kommunikációhoz -- a hagyományos üzleti eszközhöz. Igen, "algoritmikusan" sok üzleti feladat hasonló egymáshoz, ezért az azok megoldásához használt eszközök is szerkezetileg hasonlóak lesznek.
Rögzítsük a már elkészült entitások közötti logikai kapcsolatot. Az egyszerűség kedvéért a modellünk megértéséhez a legegyszerűbb megjelenítést alkalmazzuk, bonyolult UML vagy IDEF- jegyzetek nélkül:
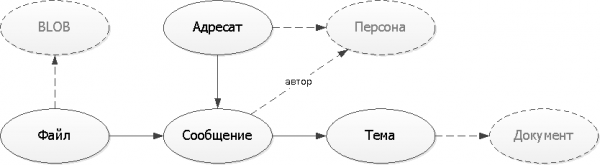
Példánkban a személy, a dokumentum és a fájl bináris »teste« olyan »külső« entitások, amelyek önállóan léteznek a szolgáltatásunk nélkül is. Így ezeket később egyszerű hivatkozásként kezeljük, mint »valahová« mutató UUID-t.
Rajzoljon a lehető legegyszerűbb diagramokat — a legtöbben, akiknek bemutatja őket, nem szakértők az UML/IDEF olvasásában. De — mindenképpen rajzoljon.
3. lépés: Vázoljuk fel a táblák struktúráját
A táblák és mezők neveirőlA "orosz" mező- és táblanevekhez különféleképpen viszonyulhatunk, de ez ízlés kérdése. Mivel nincsenek külföldi fejlesztők, és a PostgreSQL lehetővé teszi, hogy neveket adjon akár írásjelekből is, ha idézőjelbe vannak zárva, ezért megpróbáljuk az objektumokat egyértelműen érthető módon elnevezni, hogy ne legyenek félreértések.
Mivel üzeneteket több ember ír egyszerre, egyesek ezt akár offline módon is, a legegyszerűbb opció a UUID-k használata az azonosítókra nemcsak a külső entitások esetében, hanem a szolgáltatásunkon belüli összes objektumra is. Ráadásul ezeket akár az ügyféloldalon is generálhatjuk — ez segít megtartani az üzenetek küldését, amikor az adatbázis rövid időre nem érhető el, és a ütközés valószínűsége rendkívül alacsony.
A táblák tervezett struktúrája az adatbázisunkban a következő formát ölt:
Táblák : RU
CREATE TABLE "Téma"(
  "Téma"
    uuid
      PRIMARY KEY
, "Dokumentum"
    uuid
, "Cím"
    text
);

CREATE TABLE "Üzenet"(
  "Üzenet"
    uuid
      PRIMARY KEY
, "Téma"
    uuid
, "Szerző"
    uuid
, "DátumIdő"
    timestamp
, "Szöveg"
    text
);

CREATE TABLE "Címzett"(
  "Üzenet"
    uuid
, "Személy"
    uuid
, PRIMARY KEY("Üzenet", "Személy")
);

CREATE TABLE "Fájl"(
  "Fájl"
    uuid
      PRIMARY KEY
, "Üzenet"
    uuid
, "BLOB"
    uuid
, "Név"
    text
);
Táblák : EN
CREATE TABLE theme(
  theme
    uuid
      PRIMARY KEY
, document
    uuid
, title
    text
);

CREATE TABLE message(
  message
    uuid
      PRIMARY KEY
, theme
    uuid
, author
    uuid
, dt
    timestamp
, body
    text
);

CREATE TABLE message_addressee(
  message
    uuid
, person
    uuid
, PRIMARY KEY(message, person)
);

CREATE TABLE message_file(
  file
    uuid
      PRIMARY KEY
, message
    uuid
, content
    uuid
, filename
    text
);
A legegyszerűbb dolog a formátum leírásánál a kapcsolati háló kidolgozását kezdeni az olyan táblákból, amelyek nem hivatkoznak senkire.
4. lépés: Felfedezzük a nem nyilvánvaló igényeket
Minden megvan, megterveztük az adatbázist, amelybe kiválóan lehet írni és olvasni. Lépjünk a szolgáltatásunk felhasználójának helyébe — mit szeretnénk tenni a segítségével?
Legutolsó üzenetek
- kronológiai sorrendben rendezett
Ez különböző jellemzők alapján készített »saját« üzeneteim nyilvántartása. Ahol én vagyok az egyik címzett, ahol én vagyok a szerző, ahol írtak nekem, de nem válaszoltam, ahol nem válaszoltak nekem, … A beszélgetés résztvevői - Ki vesz részt egyáltalán ebben a hosszú-hosszú beszélgetésben?
Кто вообще участвует в этом длинном-длинном чате?
Struktúránk lehetővé teszi mindkét feladat megoldását "általában", de gyorsan - nem. A probléma az, hogy az első feladat keretén belül nem lehet indexet létrehozni, amely mindegyik résztvevő számára megfelelő (és ki kell nyernünk az összes rekordot), míg a második feladathoz szükséges mindegyik üzenetet előhúzni a témában.
A felhasználók által nem előre megfogalmazott feladatok súlyos hatással lehetnek a teljesítményre..
5. lépés: Ésszerű denormalizálás
Mindkét problémánkat további táblák oldják meg, amelyekben duplázzuk a szükséges adataink egy részét, amelyek szükségesek a feladatainknak megfelelő indexek létrehozásához.
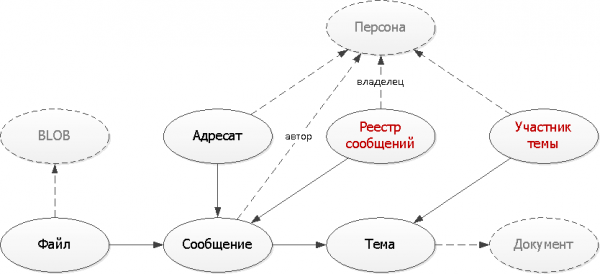
Táblák : RU
CREATE TABLE "ÜzenetekRegiszter"(
  "Tulajdonos"
    uuid
, "RegiszterTípus"
    smallint
, "DátumIdő"
    timestamp
, "Üzenet"
    uuid
, PRIMARY KEY("Tulajdonos", "RegiszterTípus", "Üzenet")
);
CREATE INDEX ON "ÜzenetekRegiszter"("Tulajdonos", "RegiszterTípus", "DátumIdő" DESC);

CREATE TABLE "TémaRésztvevő"(
  "Téma"
    uuid
, "Személy"
    uuid
, PRIMARY KEY("Téma", "Személy")
);
Táblák : EN
CREATE TABLE message_registry(
  owner
    uuid
, registry
    smallint
, dt
    timestamp
, message
    uuid
, PRIMARY KEY(owner, registry, message)
);
CREATE INDEX ON message_registry(owner, registry, dt DESC);

CREATE TABLE theme_participant(
  theme
    uuid
, person
    uuid
, PRIMARY KEY(theme, person)
);
Itt két tipikus megközelítést alkalmaztunk, amelyeket a segédtáblák létrehozásakor használnak:
- Rekordok megsokszorozása
Egyetlen eredeti üzenetből azonnal több következő rekordot hozunk létre különböző nyilvántartásokban különböző tulajdonosok számára - a feladó és a címzett számára is. Így minden nyilvántartásunk mostantól illeszkedik az indexhez - hiszen tipikus esetben csak az első oldalt szeretnénk látni. - Rekordok egyedivé tétele
Minden egyes üzenet elküldésekor egy adott téma keretén belül elegendő ellenőrizni, hogy már létezik-e ilyen rekord. Ha nem - hozzáadjuk a "szótárunkhoz".
A cikk következő részében a implementálásáról lesz szó
Forrás: habr.com
