

Január 9-én jelent meg a Pandas 1.0.0rc. A könyvtár korábbi verziója - 0.25.
Az első jelentős kiadás számos csodálatos újítást tartalmaz, többek között a DataFrame-ek automatikus összegzésének javítását, több kimeneti formátumot, új adattípusokat és még egy új dokumentációs weboldalt is.
Minden változást meg lehet nézni , a cikkben azonban egy rövid, kevésbé technikai áttekintéssel foglalkozunk a legfontosabbakra.
A könyvtárat szokás szerint a következő módon lehet telepíteni pip, de mivel a cikk megírásakor a Pandas 1.0 még mindig release candidate, egyértelműen meg kell adni a verziót:
pip install --upgrade pandas==1.0.0rc0Legyél óvatos: mivel ez egy főverzió, a frissítés megsértheti a régi kódot!
Egyébként ebben a verzióban teljesen megszűnik a Python 2 támogatása (ami jó indok lehet — ford. megj.). A Pandas 1.0 legalább Python 3.6+-ot igényel, így ha nem vagy biztos benne, pontosítsd, hogy melyik verzió van telepítve nálad:
$ pip --version
pip 19.3.1 from /usr/local/lib/python3.7/site-packages/pip (python 3.7)

$ python --version
Python 3.7.5
A Pandas verzióját a legegyszerűbben így lehet ellenőrizni:
>>> import pandas as pd
>>> pd.__version__
1.0.0rc0
Javított autóösszegzés a DataFrame.info-val
A kedvenc újítésem a következő módszer frissítése lett DataFrame.info. A funkció sokkal olvashatóbbá vált, ami még egyszerűbbé teszi az adatok kutatását:
>>> df = pd.DataFrame({
...:   'A': [1,2,3],
...:   'B': ["goodbye", "cruel", "world"],
...:   'C': [False, True, False]
...:})
>>> df.info()

RangeIndex: 3 entries, 0 to 2
Data columns (total 3 columns):
 #   Column  Non-Null Count  Dtype
---  ------  --------------  -----
 0   A       3 non-null      int64
 1   B       3 non-null      object
 2   C       3 non-null      object
dtypes: int64(1), object(2)
memory usage: 200.0+ bytes
Táblák exportálása Markdown formátumban
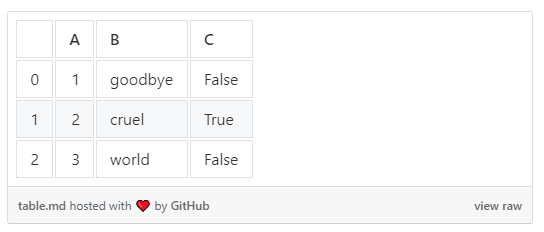
Nem kevésbé kellemes újítás lett a DataFrame-ek Markdown táblázatokba exportálásának lehetősége DataFrame.to_markdown.
>>> df.to_markdown()
|    |   A | B       | C     |
|---:|----:|:--------|:------|
|  0 |   1 | goodbye | False |
|  1 |   2 | cruel   | True  |
|  2 |   3 | world   | False |
Ez jelentősen megkönnyíti a táblázatok publikálását olyan oldalakon, mint a Medium, github gistek használatával.
Új típusok karakterekhez és logikai értékekhez
A Pandas 1.0 verzióba új kísérleti típusok is kerültek. Az API-juk még változhat, ezért használd őket óvatosan. De általában a Pandas azt javasolja, hogy új típusokat használj mindenhol, ahol értelme van.
Eddig a típuskonverziót explicit módon kell végezni:
>>> B = pd.Series(["goodbye", "cruel", "world"], dtype="string")
>>> C = pd.Series([False, True, False], dtype="bool")
>>> df.B = B, df.C = C
>>> df.info()

RangeIndex: 3 entries, 0 to 2
Data columns (total 3 columns):
 #   Column  Non-Null Count  Dtype
---  ------  --------------  -----
 0   A       3 non-null      int64
 1   B       3 non-null      string
 2   C       3 non-null      bool
dtypes: int64(1), object(1), string(1)
memory usage: 200.0+ bytes
Figyelem: hogyan jelenik meg az oszlop Dtype új típusokkal — string és bool.
Az új string típus legértékesebb jellemzője, hogy lehetővé teszi csak a string oszlopok kiválasztását a dataframekből. Ez jelentősen egyszerűsítheti a szöveges adatok elemzését:
df.select_dtypes("string")Korábban a string oszlopokat nem lehetett kiválasztani a nevek explicit megadása nélkül.
A új típusokról bővebben olvashat .
Köszönjük, hogy elolvasta! A teljes változások listáját, amint már említettük, megtekintheti .
Forrás: habr.com
