

Jó napot! A nevem Danil Lipovoy, a csapatunk a Szbertechnél elkezdte használni az HBase-t, mint valós idejű adatraktárat. Az alábbiakban összegyűjtött tapasztalatainkat szeretnénk rendszerezni és leírni (reméljük, sokak számára hasznos lesz). Az alább felsorolt kísérletek az HBase 1.2.0-cdh5.14.2 és 2.0.0-cdh6.0.0-beta1 verzióival történtek.
- Általános architektúra
- Adatok írása HBASE-be
- Adatok olvasása HBASE-ből
- Adatok gyorsítótárazása
- Tömeges adatfeldolgozás MultiGet/MultiPut
- A táblák régiókra bontásának stratégiája (sharding)
- Hibatűrés, tömörítés és az adatok lokációja
- Beállítások és teljesítmény
- Terheléses tesztelés
- Következtetések
1. Általános architektúra
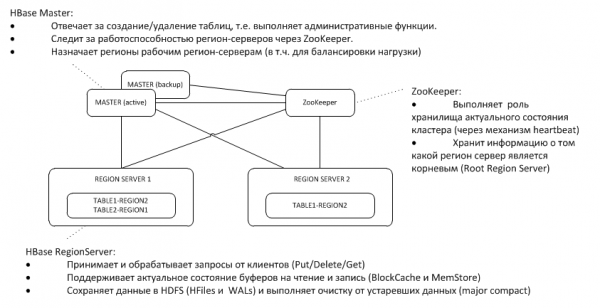
A tartalék Master a ZooKeeper csomóponton hallgatja a fő aktív csomópont heartbeat-jét, és a kiesés esetén átveszi a Master feladatait.
2. Adatok írása HBASE-be
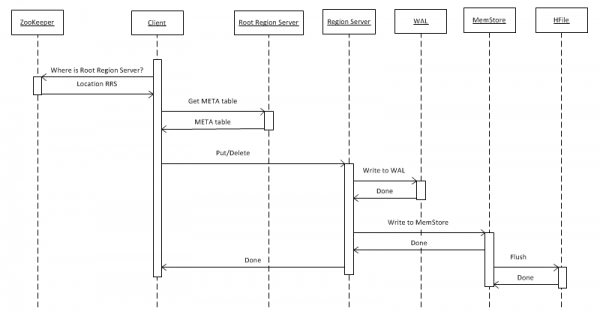
Először vizsgáljuk meg a legegyszerűbb esetet – egy kulcs-érték pár írását egy táblába put(rowkey) használatával. A kliensnek először is meg kell tudnia, hol található a gyökér régiószerver (Root Region Server - RRS), amely a hbase:meta táblát tárolja. Ezt az információt a ZooKeeper-től kapja. Ezután a RRS-hez fordul, és elolvassa a hbase:meta táblát, amelyből kinyeri, hogy melyik RegionServer (RS) felelős az adott rowkey kulcshoz tartozó adatok tárolásáért a választott táblában. A jövőbeli felhasználás érdekében a meta-táblát a kliens gyorsítótárazza, így a további kérések gyorsabban, közvetlenül az RS-hez érkeznek.
Ezután az RS, miután megkapta a kérést, először is beírja azt a WriteAheadLog (WAL) naplóba, ami a visszaállításhoz szükséges, ha a rendszer leáll. Ezt követően elmenti az adatokat a MemStore-ba. Ez egy memóriaalapú puffer, amely a régióhoz tartozó rendezett kulcskészletet tartalmazza. A tábla régiókra (partíciókra) bontható, amelyeket minden egyes régió nem átfedő kulcskészletek tárolására használ. Ez lehetővé teszi, hogy a régiókat különböző szervereken elhelyezve magasabb teljesítményt érjenek el. Azonban, annak ellenére, hogy ez a kijelentés nyilvánvalónak tűnik, hamarosan látni fogjuk, hogy nem minden esetben működik.
A MemStore-ba történő írást követően a kliens választ kap arról, hogy az adatokat sikeresen elmentették. Valójában azonban az adatok csak a pufferben tárolódnak, és csak egy megfelelő időintervallum után, vagy új adatok felvételének esetén kerülnek a lemezre.
A "Delete" operation does not physically remove data. It is merely marked as deleted, with actual deletion occurring at the time of calling the major compact function, which is explained in detail in section 7.
Files in HFile format accumulate in HDFS, and from time to time, a minor compact process is initiated, which simply merges small files into larger ones without deleting anything. Over time, this becomes a problem that manifests only when reading data (we will return to this later).
In addition to the loading process described above, there is a much more efficient procedure, which is perhaps the strongest point of this database – BulkLoad. This involves creating HFiles ourselves and placing them on the disk, allowing for excellent scalability and reaching quite respectable speeds. Essentially, the limitation here is not HBase, but the capabilities of the hardware. Below are the loading results on a cluster consisting of 16 RegionServers and 16 NodeManager YARN (CPU Xeon E5-2680 v4 @ 2.40GHz * 64 threads), HBase version 1.2.0-cdh5.14.2.
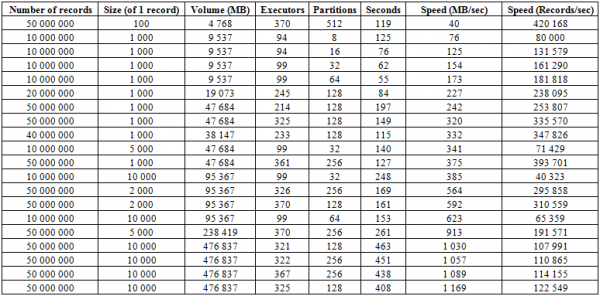
It can be seen that by increasing the number of partitions (regions) in the table, as well as Spark executors, we achieve an increase in loading speed. Speed also depends on the volume of records. Large blocks yield an increase in measurement in MB/sec, while smaller ones increase the number of inserted records per unit time, all else being equal.
You can also initiate loading into two tables simultaneously and achieve a doubling of speed. It can be seen below that writing 10 KB blocks straight into two tables runs at about 600 Mb/sec for each (totaling 1275 Mb/sec), matching the speed of writing into one table at 623 MB/sec (see #11 above).
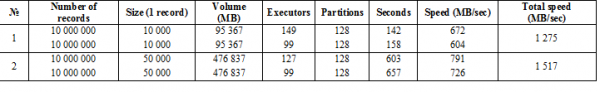
However, the second run with 50 KB records shows that the loading speed is growing only slightly, indicating a nearing of the limit values. It should be noted that HBASE itself is not significantly stressed here; all that is required from it is to initially hand over data from hbase:meta, and after placing the HFiles, flush the BlockCache data and save the MemStore buffer to disk, if it is not empty.
3. Reading data from HBASE
Ha feltételezzük, hogy az összes információ a hbase:meta már rendelkezésre áll a kliensnél (lásd 2. pont), akkor a kérés azonnal arra a RS-re érkezik, ahol a szükséges kulcsot tárolják. Először a MemCache-ben történik a keresés. Függetlenül attól, hogy vannak-e ott adatok vagy sem, a keresés a BlockCache pufferben is zajlik, szükség esetén pedig az HFiles-ban. Ha az adatokat megtalálják a fájlban, akkor a BlockCache-be helyezik, és a következő kéréskor gyorsabban visszaadják. A HFile-ban történő keresés viszonylag gyorsan zajlik a Bloom szűrő használatának köszönhetően, azaz egy kis mennyiségű adat beolvasásával azonnal meghatározza, hogy ez a fájl tartalmazza-e a szükséges kulcsot, és ha nem, akkor áttér a következőre.
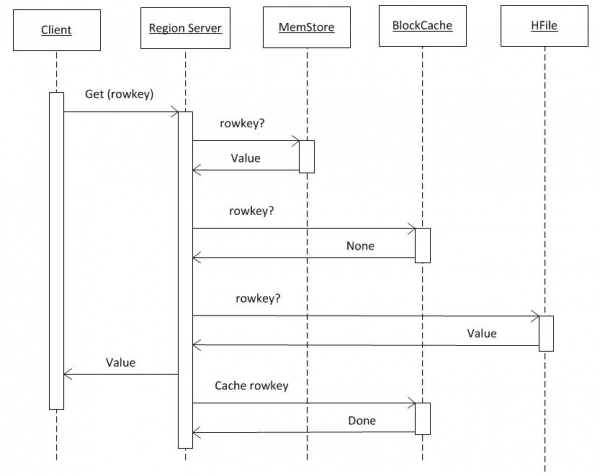
A három forrásból kapott adatok alapján az RS választ formál. Különösen, ha a kliens verziózást kért, akkor egyszerre számos megtalált verziót is továbbíthat.
4. Adatok gyorsítótárazása
A MemStore és BlockCache puffer 80%-ig terjedő on-heap memóriaigényt képvisel az RS számára (a többi a RS szolgáltatási feladatai számára van fenntartva). Ha a tipikus használati mód olyan, hogy a folyamatok írják és azonnal olvassák ezeket az adatokat, akkor érdemes csökkenteni a BlockCache méretet és növelni a MemStore-t, mivel íráskor az adatok nem kerülnek a gyorsítótárba olvasásra, így a BlockCache használata ritkábban fordul elő. A BlockCache puffer két részből áll: LruBlockCache (mindig on-heap) és BucketCache (általában off-heap vagy SSD-n). A BucketCache használatát akkor javaslom, ha az olvasási kérések száma nagyon magas, és nem férnek el az LruBlockCache-ben, ami aktív Garbage Collector működéshez vezet. Ekkor azonban radikális teljesítménynövekedést ne várjunk az olvasási gyorsítótár használatától, de erre még visszatérünk a 8. pontban.
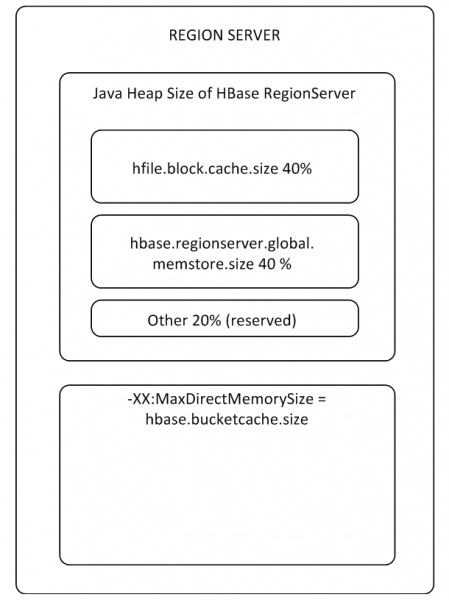
A BlockCache egy egész RS-re vonatkozik, míg a MemStore minden táblához saját (egy minden Column Family-hez).
Mint Elméletben, íráskor az adatok nem kerülnek a gyorsítótárba, és valóban, ezek a CACHE_DATA_ON_WRITE paraméterek a táblára és a „Cache DATA on Write” az RS-re false-ra vannak állítva. Praktikusan azonban, ha adatokat írunk a MemStore-ba, majd azokat leírjuk a lemezre (ezáltal törölve őket), majd a létrejött fájlt eltávolítjuk, akkor egy get kérés végrehajtásakor sikeresen megkapjuk az adatokat. Ráadásul, még ha teljesen le is állítjuk a BlockCache-t, és új adatokkal töltjük fel a táblát, majd elérjük a MemStore leírását a lemezre, eltávolítjuk az adatokat, és egy másik ülést kérünk, akkor az adatok valahonnan mégis visszanyerhetők. Tehát az HBase nemcsak az adatokat tárolja, hanem titokzatos rejtélyeket is.
hbase(main):001:0> create 'ns:magic', 'cf'
Létrehozva a táblázat: ns:magic
Eltelt: 1.1533 másodperc
hbase(main):002:0> put 'ns:magic', 'key1', 'cf:c', 'try_to_delete_me'
Eltelt: 0.2610 másodperc
hbase(main):003:0> flush 'ns:magic'
Eltelt: 0.6161 másodperc
hdfs dfs -mv /data/hbase/data/ns/magic/* /tmp/trash
hbase(main):002:0> get 'ns:magic', 'key1'
 cf:c      timestamp=1534440690218, érték=try_to_delete_me
A „Cache DATA on Read” paraméter false értékre van állítva. Ha van ötletem, szívesen várom a megjegyzéseket.
5. MultiGet/MultiPut kötegelt adatfeldolgozás
Az egyes lekérdezések (Get/Put/Delete) kezelése meglehetősen költséges művelet, ezért érdemes ezeket lehetőség szerint List-be vagy List-be csoportosítani, ami jelentős teljesítménynövekedést eredményez. Különösen az írási műveletek esetén, de olvasás közben az alábbi buktatóval találkozhatunk. Az alábbi grafikonon 50 000 rekord MemStore-ból történő olvasásának ideje látható. Az olvasás egy szálon zajlott, és a vízszintes tengelyen a lekérdezésben szereplő kulcsok száma látható. Itt látható, hogy ezer kulcsra emelve egy lekérdezés ideje csökken, azaz a sebesség nő. Azonban az alapértelmezett MSLAB mód bekapcsolása után ezen a határon túl drasztikusan csökken a teljesítmény, és minél nagyobb az adatmennyiség a feljegyzésben, annál hosszabb a feldolgozási idő.
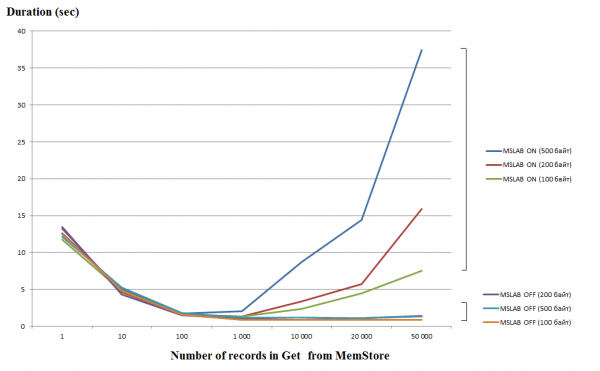
A teszteket virtuális gépen végezték, 8 mag, HBase 2.0.0-cdh6.0.0-beta1 verzió.
Az MSLAB mód célja a heap töredezettségének csökkentése, amely az új és régi generációk adatainak keveredése miatt keletkezik. A probléma megoldásaként, az MSLAB bekapcsolásakor az adatok viszonylag kis cellákba (chunk) kerülnek, és adagokban dolgozzák fel őket. Ennek eredményeként, amikor a kért adatmennyiség meghaladja a kijelölt méretet, a teljesítmény drasztikusan csökken. Másrészről, ennek a módnak a kikapcsolása sem kívánatos, mivel a GC miatti leállásokhoz vezethet az adatok intenzív kezelésekor. Jó megoldás lehet a cellaméret növelése, aktív írás közben a put parancs használatával, egyidejű olvasással. Érdemes megjegyezni, hogy a probléma nem merül fel, ha a feljegyzés után végrehajtjuk a flush parancsot, amely a MemStore-t a lemezre írja, vagy ha BulkLoad segítségével töltenek be. Az alábbi táblázatban látható, hogy a MemStore-ból nagyobb mennyiségű adat (és azonos számú) lekérdezések lassuláshoz vezetnek. Azonban a chunksize növelésével az feldolgozási idő normára állítható vissza.
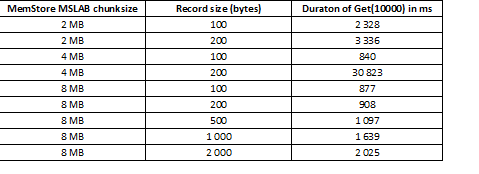
Az adatok régiók szerinti felosztása, azaz a táblák hasítása, segít a chunksize növelésében. Ez azt eredményezi, hogy minden régióhoz kevesebb kérés érkezik, és ha ezek egy cellába kerülnek, a válaszidő jó marad.
6. Stratégiák a táblák régiókra bontására (hasítás)
Mivel az HBase egy kulcs-érték tároló, ahol a partícionálás a kulcs alapján történik, rendkívül fontos, hogy az adatokat egyenletesen osszuk el a régiók között. Például egy ilyen táblát három részre osztva az adatok három régióra bontódnak:
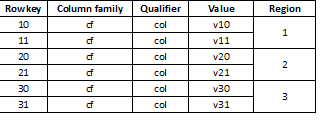
Előfordulhat, hogy ez drámai lassuláshoz vezet, ha a később betöltendő adatok többsége például hosszú értékekből áll, amelyek legtöbbje ugyanazzal a számmal kezdődik, például:
1000001
1000002
…
1100003
Mivel a kulcsok byte tömbként tárolódnak, mindegyik ugyanazzal kezdődik, és ugyanahhoz az #1 regionálhoz tartozik, amely ezt a kulcstartományt tárolja. Több hasítási stratégia létezik:
HexStringSplit – A kulcsot hexadecimális kódolású karakterlánccá alakítja a tartományban „00000000” => „FFFFFFFF”, balra nullákkal kitöltve.
UniformSplit – A kulcsot byte tömbbé alakítja hexadecimális kódolásban a tartományban „00” => „FF”, jobbra nullákkal kitöltve.
Ezen kívül megadhatunk bármilyen kulcstartományt vagy kulcskészletet a hasításhoz, és beállíthatjuk az automatikus hasítást. Azonban az egyik legegyszerűbb és leghatékonyabb megközelítés a UniformSplit és a hash konkatenáció használata, például a legmagasabb byte pár a kulcs CRC32(rowkey) függvényen való átfuttatásából és magából a rowkeyből:
hash + rowkey
Ezáltal az összes adat egyenletesen oszlik meg a régiók között. Olvasáskor az első két byte egyszerűen elvetésre kerül, és megmarad az eredeti kulcs. A RS szintén ellenőrzi a régióban található adatok és kulcsok számát, és ha a határértékeket túllépi, automatikusan felosztja azokat.
7. Hibatűrés és adatok helyi elérhetősége
Mivel minden kulcsgarnitúráért csak egy régió felel, a RS-el való problémák megoldása érdekében minden szükséges adatot az HDFS-ben kell tárolni. Ha a RS leáll, a mester az ezt követő heartbeat hiányából értesül róla a ZooKeeper csomóponton. Ekkor egy másik RS-nek rendeli hozzá a kezelendő régiót, és mivel az HFiles a elosztott fájlrendszerben tárolódik, az új gazda kiolvassa azokat és folytatja az adatok kezelését. Azonban mivel az adatok egy része lehet a MemStore-ban van, és még nem került az HFiles-ba, a tranzakciós előzmények helyreállításához a WAL-t használják, ami szintén az HDFS-ben van tárolva. A változtatások alkalmazása után a RS képes válaszolni a kérésekre, azonban a költözés miatt az adatok egy része és azokat kezelő folyamatok különböző csomópontokon helyezkednek el, ami csökkenti a helyi erőforrások használatát.
A probléma megoldása a major compaction - ez a folyamat áthelyezi a fájlokat azokra a csomópontokra, amelyekért felelősek (ahová a régióik is tartoznak), ennek eredményeként a folyamat alatt nagymértékben megnövekszik a hálózati és lemez terhelés. Azonban a későbbiekben az adatokhoz való hozzáférés jelentősen felgyorsul. Ezenkívül a major_compaction egyesíti az összes HFiles-t egy fájlba a régió keretein belül, és törli az adatokat a táblázat beállításaitól függően. Például megadható az objektumok verzióinak száma, amelyet meg kell őrizni, vagy az eltarthatósági idő, amely után az objektum fizikailag eltávolításra kerül.
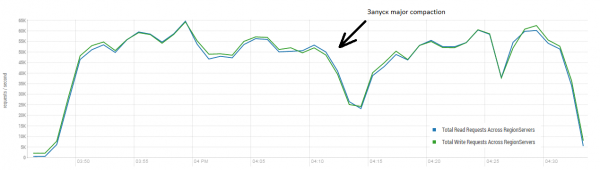
Ez a folyamat nagyon pozitív hatással lehet az HBase működésére. Az alábbi képen látható, hogyan csökkent a teljesítmény az aktív adatírás eredményeként. Látható, hogy egy táblázatba 40 szál írt és 40 szál egyidejűleg olvasott adatokat. Az író szálak egyre több HFiles-t képeztek, amelyeket a másik szál olvasott. Ennek eredményeképpen egyre több adatot kellett eltávolítani a memóriából, és végül elindult a GC, amely szinte megbénította az egész működést. A major compaction elindítása a felhalmozódások megtisztításához és a teljesítmény helyreállításához vezetett.
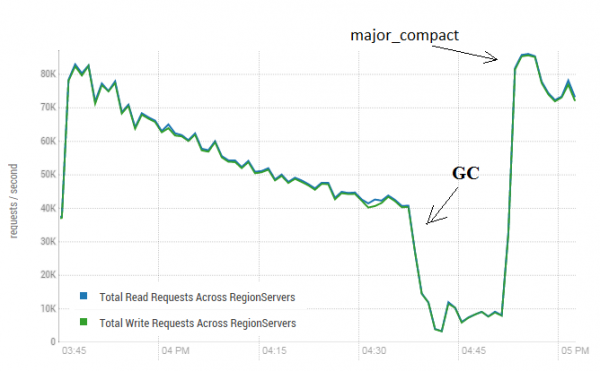
A teszt három DataNode-on és négy RS-en futott (CPU Xeon E5-2680 v4 @ 2.40GHz * 64 szál). HBase verzió: 1.2.0-cdh5.14.2
Fontos megjegyezni, hogy a major compaction egy "életben lévő" táblán hajtódott végre, amelybe aktívan írtak és olvastak adatokat. Az interneten olyan állítások fogalmazódtak meg, hogy ez helytelen válaszokat eredményezhet az adatok olvasásakor. A probléma ellenőrzésére egy folyamatot indítottunk, amely új adatokat generált és írt a táblába. Ezt követően azonnal olvasta és ellenőrizte, hogy a kapott érték megegyezik-e azzal, ami be volt írva. Ennek a folyamatnak a működése alatt körülbelül 200 alkalommal hajtottak végre major compaction-t, és egyetlen hiba sem történt. Lehetséges, hogy a probléma ritkán lép fel, csak magas terhelés esetén, ezért biztonságosabb lenne a írási és olvasási folyamatokat tervezetten leállítani, és tisztítást végezni, elkerülve a GC ilyen mélyrepüléseit.
A major compaction szintén nem befolyásolja a MemStore állapotát, annak lemezre írásához és tömörítéséhez flush-t kell használni (connection.getAdmin().flush(TableName.valueOf(tblName))).
8. Beállítások és teljesítmény
Ahogy már említettük, az HBase legnagyobb sikert akkor éri el, amikor nincs szüksége semmire, ha BulkLoad-ot hajt végre. Ez azonban a legtöbb rendszerre és emberre is igaz. Azonban ez az eszköz inkább a tömeges adatok nagy blokkokban történő elhelyezésére alkalmas, míg ha a folyamat versengő olvasási és írási kérések sokaságát igényli, az előzőleg említett Get és Put parancsokat használják. Az optimális paraméterek meghatározására különféle táblázati paraméterek és beállításkombinációk mellett hajtottunk végre teszteket:
- 10 szálat indítottunk párhuzamosan 3 alkalommal (nevezzük ezt egy szálblokknak).
- A blokk összes szálának futási idejét átlagoltuk, és ez lett a blokk eredménye.
- Minden szál ugyanazzal a táblával dolgozott.
- Minden szálblokk indítása előtt major compaction végrehajtásra került.
- Minden blokk csak az alábbi műveletek közül egyet hajtott végre:
— Put
— Get
— Get+Put
- Minden blokk 50 000 ismétlést hajtott végre a saját műveletéből.
- A blokkban lévő rekord mérete 100 bájt, 1000 bájt vagy 10000 bájt (véletlenszerű).
- A blokkok különböző számú kért kulccsal indultak (vagy egy kulcs, vagy 10).
- A blokkok különböző táblázati beállítások mellett indultak. A következő paraméterek változtak:
— BlockCache = be vagy ki volt kapcsolva
— BlockSize = 65 KB vagy 16 KB
— Partíciók = 1, 5 vagy 30
— MSLAB = be vagy ki volt kapcsolva
Így néz ki a blokk:
a. A MSLAB mód be vagy ki volt kapcsolva.
b. Készítettünk egy táblázatot, amelyhez a következő paraméterek lettek beállítva: BlockCache = true/nincs, BlockSize = 65/16 Kb, Partíciók = 1/5/30.
c. A GZ tömszelvény lett beállítva.
d. 10 párhuzamos szálat indítottunk, amelyek egyszerre végeztek 1/10 put/get/get+put műveleteket a táblázatban 100/1000/10000 byte rekordokkal, összesen 50 000 kérés végrehajtásával (a kulcsok véletlenszerűek voltak).
e. A d. pontot háromszor megismételtük.
f. Az összes szál futásának idejét átlagoltuk.
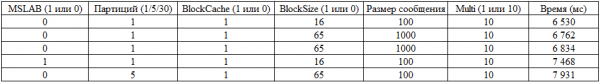
Minden lehetséges kombinációt ellenőriztünk. Logikus, hogy a rekord méretének növelésével a sebesség csökken, vagy hogy a cache kikapcsolása lelassít. Azonban a cél az volt, hogy megértsük minden paraméter hatásának mértékét és jelentőségét, ezért a begyűjtött adatokat lineáris regressziós függvénynek adtuk át, amely lehetővé teszi a megbízhatóság értékelését t-statisztikával. Az alábbiakban láthatók a Put műveleteket végrehajtó blokkok eredményei. A teljes kombinációs készlet 2*2*3*2*3 = 144 változat + 72, mivel egyesek kétszer lettek végrehajtva. Tehát összesen 216 futtatás:
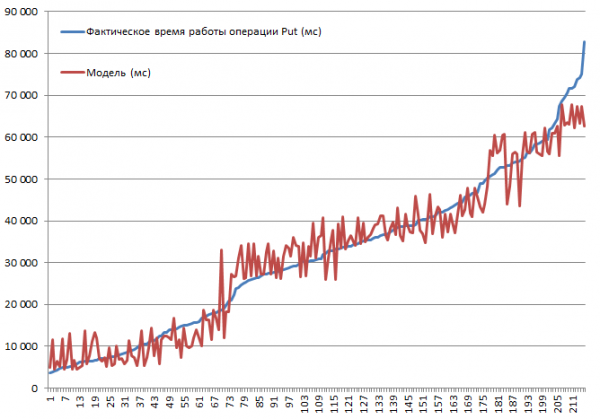
A tesztelés egy 3 DataNode-ból és 4 RS-ből álló mini klaszteren zajlott (CPU Xeon E5-2680 v4 @ 2.40GHz * 64 szál). Az HBase verziója 1.2.0-cdh5.14.2.
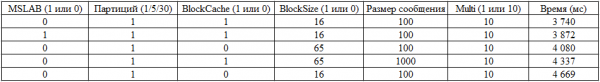
A legmagasabb beszúrási sebességet, 3.7 másodpercet, akkor értük el, amikor az MSLAB módban kikapcsoltuk, egy egypartíciós táblázaton, beaktivált BlockCache-sel, BlockSize = 16-tal, 100 byte-os rekordokkal, 10 darab egy csomagban.
A legalacsonyabb beszúrási sebességet, 82.8 másodpercet, akkor értük el, amikor az MSLAB módban beaktiváltuk, egy egypartíciós táblázaton, beaktivált BlockCache-sel, BlockSize = 16-tal, 10 000 byte-os rekordokkal, 1 darab egy csomagban.
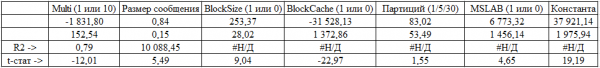
Most nézzük meg a modellt. Jól látható, hogy a modell R2 alapján jó minőségű, de világosan érhető, hogy az extrapoláció itt tilos. A rendszer valódi viselkedése a paraméterek megváltoztatásakor nem lineáris lesz, ez a modell nem előrejelzésre, hanem a megértésre szükséges, hogy mi történt a megadott paraméterek keretein belül. Például itt láthatjuk a t-érték szerint, hogy a Put műveletnél a BlockSize és a BlockCache paramétereknek nincs jelentősége (ami alapvetően teljesen logikus):
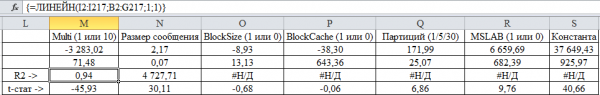
Nem kicsit meglepő, hogy a partíciók számának növelése csökkenti a teljesítményt (már láttuk a partíciók számának növelésének pozitív hatását a BulkLoad esetén), noha ez érthető. Először is, a feldolgozás során 30 régióra kell kérdéseket megfogalmazni egy helyett, és az adatmennyiség nem olyan nagy, hogy előnyt jelentsen. Másodszor, a teljes működési időt a leglassabb RS határozza meg, és mivel a DataNode-ok száma kevesebb, mint az RS-eké, néhány régió nullás lokálisággal bír. Nézzük meg az éllovas ötöst:
Most értékeljük a Get blokkok végrehajtásának eredményeit:
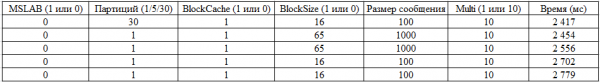
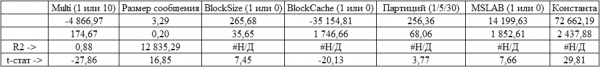
A partíciók száma elvesztette jelentőségét, amit valószínűleg az magyaráz, hogy az adatok jól gyorsítótárba kerülnek, és a gyorsítótár a legfontosabb (statisztikailag) paraméter olvasáskor. Nyilvánvaló, hogy a kérésben a visszajelzések számának növelése is nagyon hasznos a teljesítmény számára. A legjobb eredmények:
Végül nézzük meg a blokk modelljét, amely először get, majd put műveletet hajtott végre:
Itt minden paraméter jelentős. Az éllovasok eredményei:
9. Terheléses tesztelés
Most pedig indítsunk el egy viszonylag normális terhelést, de mindig érdekesebb, ha van mivel összehasonlítani. A DataStax weboldalán – a Cassandra kulcsfejlesztője – található a NoSQL tárolók NHT soráról, beleértve az HBase 0.98.6-1-es verzióját. A betöltés 40 szálon történt, az adatok mérete 100 bájt, SSD meghajtók. A Read-Modify-Write műveletek tesztelésének eredményei a következőképpen alakultak:
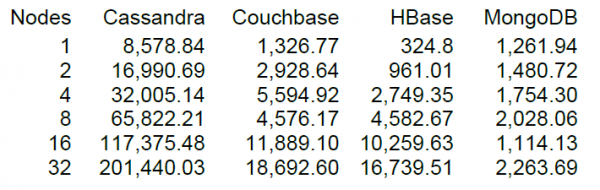
Amennyiben jól értettem, az olvasás 100 bejegyzés blokkjain történt, és a 16 HBase csomóponttal a DataStax teszt 10 ezer műveletet mutatott másodpercenként.
Szerencsés, hogy a klaszterünkben is 16 csomópont van, de nem annyira „szerencsés”, hogy mindegyiken 64 mag (szál) található, míg a DataStax tesztje során csak 4. Másrészt náluk SSD lemezek vannak, míg nálunk HDD, és a HBase egy újabb verziója, valamint a CPU kihasználtsága a terhelés alatt gyakorlatilag nem nőtt jelentősen (vizuálisan 5-10 százalékkal). Mindazonáltal megpróbálunk elindulni ezzel a konfigurációval. Az alapvető táblázati beállítások vannak érvényben, az olvasás véletlenszerűen történik a 0-tól 50 millió kulcs közötti tartományban (tehát lényegében minden alkalommal új). A táblázatban 50 millió bejegyzés található, 64 partícióra felosztva. A kulcsok crc32 szerint hash-eltek. A táblázati beállítások alapértelmezettek, MSLAB engedélyezve van. 40 szál indítása, mindegyik szál 100 véletlenszerű kulcsot olvas be és azonnal visszaír 100 byte-t az adott kulcsokhoz.
Állvány: 16 DataNode és 16 RS (CPU Xeon E5-2680 v4 @ 2.40GHz * 64 szál). HBase verzió: 1.2.0-cdh5.14.2.
Az átlagos eredmény közelebb áll a 40 ezer művelet/sekundumhoz, ami lényegesen jobb, mint a DataStax tesztjénél. Azonban kísérleti célokból érdemes lenne néhány feltételt megváltoztatni. Igencsak valószínűtlen, hogy az összes munka kizárólag egy táblázattal, illetve csak egyedi kulcsokkal fog zajlani. Tegyük fel, hogy van egy „forró” kulcssorozat, amely generálja a fő terhelést. Ezért próbáljunk meg nagyobb bejegyzésekkel (10 KB) terhelést generálni, szintén 100-as csomagokban, 4 különböző táblázatban, miközben 50 ezer kulcsra korlátozzuk a lekérdezési tartományt. Az alábbi grafikonon látható, hogy 40 szál indult, mindegyik szál 100 kulcsot olvas be és azonnal visszaír véletlenszerű 10 KB-ot ezekre a kulcsokra.
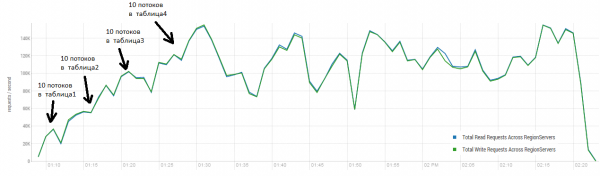
Állvány: 16 DataNode és 16 RS (CPU Xeon E5-2680 v4 @ 2.40GHz * 64 szál). HBase verzió: 1.2.0-cdh5.14.2.
A terhelés során többször indult major compaction, ahogy fentebb említettem, ennek az eljárásnak a hiányában a teljesítmény fokozatosan romlik, azonban végrehajtás közben is keletkezik további terhelés. Az esések különböző okokból adódnak. Néha a szálak befejezték a munkát és amíg újraindultak, szünet keletkezett, néha külső alkalmazások generáltak terhelést a klaszteren.
Az olvasás és az azonnali írás az egyik legnehezebb munkafolyamat az HBase számára. Ha csak kis méretű put kéréseket, például 100 byte-ot végezünk, és ezeket 10-50 ezer darabos kötegekbe csoportosítjuk, akkor másodpercenként több százezer műveletet érhetünk el, és hasonlóan a csak olvasási kérések esetében is. Érdemes megjegyezni, hogy az eredmények radikálisan jobbak, mint amit a DataStax esetében tapasztaltak, legfőképpen a 50 ezer darabos blokkokban végzett kérések miatt.
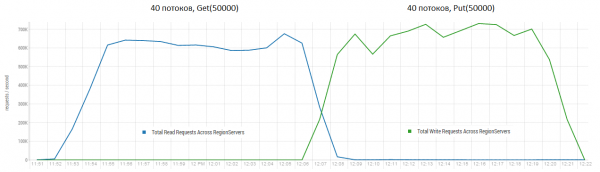
Állvány: 16 DataNode és 16 RS (CPU Xeon E5-2680 v4 @ 2.40GHz * 64 szál). HBase verzió: 1.2.0-cdh5.14.2.
10. Következtetések
Ez a rendszer elég rugalmasan konfigurálható, azonban a számos paraméter hatása még mindig ismeretlen. Néhányat teszteltek, de nem kerültek be a végső tesztkészletbe. Például az előzetes kísérletek azt mutatták, hogy a DATA_BLOCK_ENCODING paraméter, amely a szomszédos cellák értékeivel kódolja az információt, jelentéktelen hatással bír, ami érthető a véletlenszerűen generált adatok esetében. Amennyiben sok ismétlődő objektumot használunk, a nyereség jelentős lehet. Általában elmondható, hogy az HBase egy nagyon komoly és átgondolt adatbázis-kezelő rendszert alakít ki, amely nagy adathalmazok kezelésekor eléggé hatékony lehet. Különösen, ha lehetőség van az olvasási és írási folyamatok időbeli elkülönítésére.
Ha valami szerinted nem eléggé van kifejtve, szívesen beszélek részletesebben. Javasoljuk, hogy osszuk meg tapasztalatainkat, vagy vitatkozzunk, ha nem értünk egyet valamivel.
Forrás: habr.com
