

Megvizsgáljuk a Zabbix és a TimescaleDB adatbázis backend kapcsolatát. Megmutatjuk, hogyan lehet a nulláról indítani és hogyan lehet migrálni a PostgreSQL-ról. Teljesítményösszehasonlító teszteket is bemutatunk két konfiguráció között.
HighLoad++ Szibéria 2019. Terem: „Tomsk”. Június 24, 16:00. Előadási vázlatok és . A következő HighLoad++ konferenciát 2020. április 6-7-én tartják Szentpéterváron. Részletek és jegyek .
Andre Gussin (a továbbiakban: AG): – Én a ZABBIX (a továbbiakban: „Zabbix”) technikai támogató mérnöke vagyok, oktató. Több mint 6 éve dolgozom a technikai támogatásban, és közvetlenül tapasztaltam a teljesítményt. Ma arról fogok beszélni, hogy mit nyújthat a TimescaleDB teljesítménye a hagyományos PostgreSQL 10-hez képest. Az előadás elején némi bevezetőt is tartok arról, hogyan működik ez egyáltalán.
A teljesítmény fő kihívásai: az adatok gyűjtésétől a tisztításig
Kezdjük azzal, hogy léteznek bizonyos teljesítményi kihívások, amelyekkel minden megfigyelő rendszernek szembe kell néznie. Az első teljesítményi kihívás a gyors adatgyűjtés és -feldolgozás.
Egy jó megfigyelő rendszernek gyorsan és időszerűen kell megkapnia az összes adatot, azokat a riasztási kifejezéseknek megfelelően kell feldolgoznia, azaz bizonyos kritériumok szerint (különböző rendszerekben más és más módon), és el kell mentenie az adatbázisba, hogy ezeket az adatokat később fel lehessen használni.
A második teljesítményi kihívás a történelem tárolása. Az adatbázisban tárolni azokat az adatokat, és gyors, kényelmes hozzáférést biztosítani azokhoz a metrikákhoz, amelyeket egy bizonyos időszak alatt gyűjtöttek. A legfontosabb, hogy ezek az adatok könnyen elérhetők legyenek, felhasználhassák őket jelentésekben, grafikonokon, riasztásokban vagy bármilyen küszöbértékben, értesítésekhez stb.
A harmadik teljesítményi kihívás a történelem tisztítása, azaz amikor elérkezik az a nap, amikor nem kell bizonyos részletes metrikákat tárolni, amelyek 5 év alatt összegyűltek (még hónapok vagy két hónap is). Bizonyos hálózati csomópontok törlődnek, vagy bizonyos hosztok, a metrikák már nem szükségesek, mert elavultakká váltak és már nem gyűjtik őket. Ezt mind el kell távolítani, hogy az adatbázis ne nőjön túl nagyra. Valójában a történelem tisztítása gyakran komoly próbát jelent a tároló számára – gyakran nagyon jelentősen befolyásolja a teljesítményt.
Hogyan oldhatóak meg a gyorsítótárazási problémák?
Most az „Zabbix”-ról fogok beszélni. A „Zabbix”-ban az első és második hívások cache-eléssel lettek megoldva.
Az adatok gyűjtése és feldolgozása – RAM-ot használunk az összes adat tárolására. Most ezekről az adatokról részletesebben fogunk beszélni.
Az adatbázis oldalán is van bizonyos caching a fő lekérdezésekhez – a grafikonokhoz és más dolgokhoz.
Caching a Zabbix-server oldalán: van ConfigurationCache, ValueCache, HistoryCache, TrendsCache. Mik ezek?
A ConfigurationCache a fő cache, amiben a metrikákat, hosztokat, adatpontokat, riasztásokat tároljuk; mindent, ami a preprosesszinghez, az adatok gyűjtéséhez, a gyűjtési hosztokhoz és a gyűjtési gyakorisághoz szükséges. Mindezeket a ConfigurationCache-ben tároljuk, hogy ne kelljen az adatbázishoz fordulni, és ne generáljunk felesleges lekérdezéseket. A szerver indítása után frissítjük ezt a cache-t (létrehozzuk) és időszakonként frissítjük (a konfiguráció beállításaitól függően).
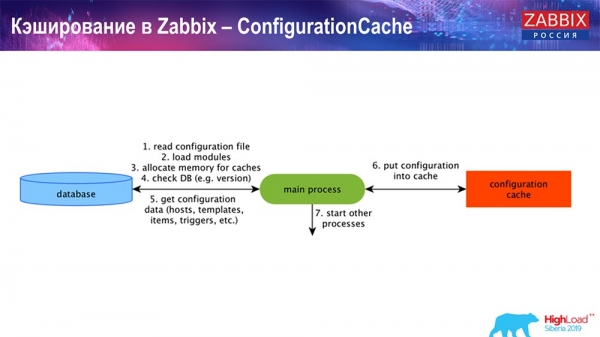
Caching a Zabbixban. Adatok gyűjtése
Itt a séma elég nagy:
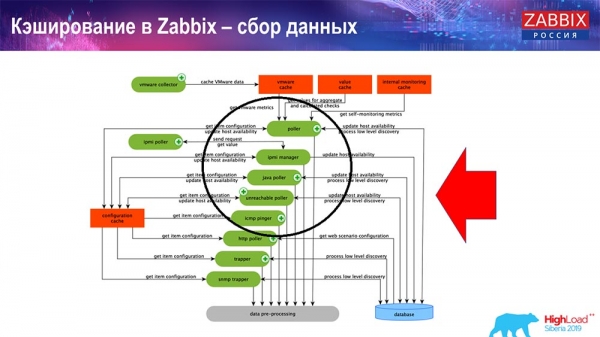
A séma fő elemei – ezek a gyűjtők:
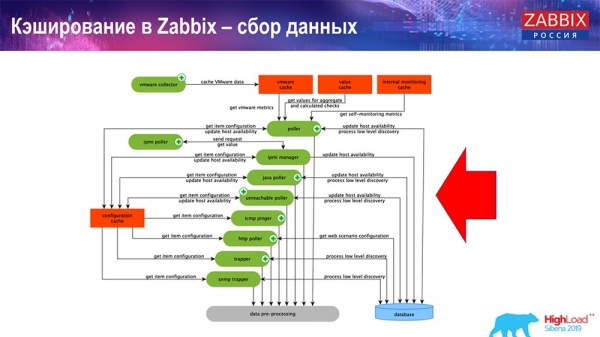
Ezek maguk a gyűjtési folyamatok, különféle „pollerek”, amelyek különböző típusú gyűjtésekért felelősek. Ezek begyűjtik az adatokat ICMP, IPMI és különböző protokollok alapján, majd átadják azt a preprosesszingnek.
PreProcessing HistoryCache
Továbbá, ha van számított adatpontunk (akik ismerik a „Zabbix”-ot, tudják), tehát számított, aggregált adatpontok, – ezeket közvetlenül a ValueCache-ből vesszük. Arról, hogy hogyan töltődik ez fel, később beszélek. Mindezek a gyűjtők a feladataik megszerzésére ConfigurationCache-t használnak, majd továbbadják azokat a preprosesszingnek.
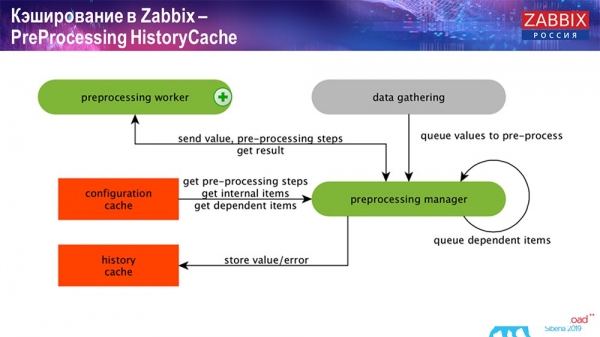
A preprosesszing szintén a ConfigurationCache-t használja a preprosesszing lépéseinek megszerzésére, és különböző módon dolgozza fel ezeket az adatokat. A 4.2-es verziótól kezdve a preprosesszing a proxy-ra került. Ez nagyon kényelmes, mert a preprosesszing egy elég nehéz művelet. Ha nagy a „Zabbix”-od, sok adatponttal és magas gyűjtési gyakorisággal, akkor ez jelentősen megkönnyíti a munkát.
Így miután ezeket az adatokat valamilyen módon feldolgoztuk a preprosesszing segítségével, elmentjük azokat a HistoryCache-be, hogy később feldolgozhassuk őket. Ezzel véget ér az adatok gyűjtése. Átérünk a fő folyamathoz.
A History syncer működése
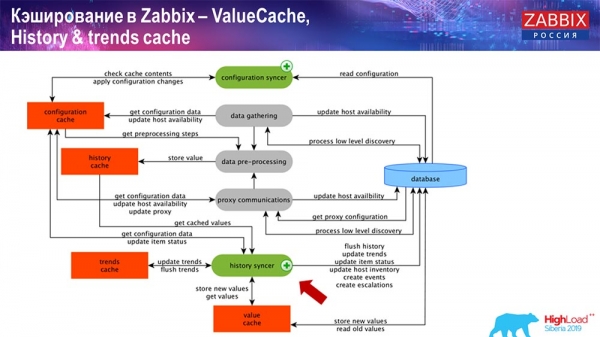
A fő folyamat a "Zabbix"-ban (mivel monolit architektúra) - History syncer. Ez a fő folyamat, amely az adatok minden egyes elemének atomikus feldolgozásával foglalkozik, tehát minden értékkel:
- érkezik egy érték (ezt a HistoryCache-ből veszi);
- ellenőrzi a Configuration syncer-ben: van-e bármilyen trigger a számításokhoz - ezeket kiszámítja;
ha van - eseményeket hoz létre, és eszkalációt generál, hogy értesítést hozzon létre, ha a konfiguráció szerint szükséges; - a trigger-eket rögzíti a későbbi feldolgozásra, aggregálásra; ha az utolsó órában aggregál, a ValueCache emlékezik erre az értékre, hogy ne kelljen az történeti táblához fordulni; így a ValueCache a szükséges adatokkal telítődik, amelyek szükségesek a trigger-ek, számított elemek stb. kiszámításához;
- ezután a History syncer minden adatot rögzít az adatbázisban;
- az adatbázis ezeket lementi a lemezre – ez a feldolgozási folyamat véget ér.
Adatbázisok. Cache-elés
Az adatbázis oldalán, amikor grafikonokat vagy eseményekről készült jelentéseket szeretne megtekinteni, különböző cache-ek állnak rendelkezésre. De erről a bemutató keretein belül nem fogok beszélni.
A MySQL esetében ott van az Innodb_buffer_pool, még sok más különböző cache, amelyeket szintén lehet konfigurálni.
De ezek a legfontosabbak:
- shared_buffers;
- effective_cache_size;
- shared_pool.
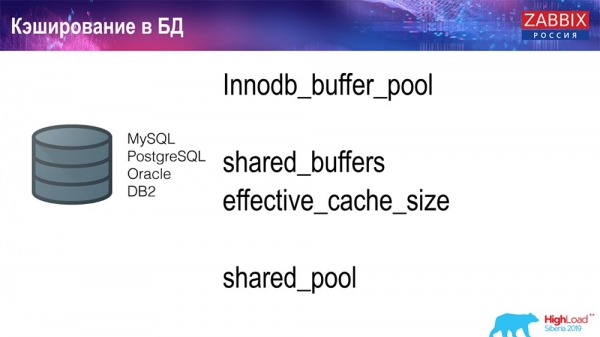
Minden adatbázis esetében bemutattam, hogy léteznek bizonyos cache-ek, amelyek lehetővé teszik az operatív memóriában azokat az adatokat tárolni, amelyek gyakran szükségesek a lekérdezésekhez. Itt saját technológiáik vannak erre.
Az adatbázis teljesítménye
Ennek megfelelően versenykörnyezet van, tehát a "Zabbix"-szerver adatokat gyűjt és rögzít. Indításkor szintén a történeti adatokból olvas a ValueCache feltöltéséhez stb. Itt lehetnek olyan szkriptek és jelentések, amelyek a "Zabbix"-API-t használják, amely a webes felület alapja. A "Zabbix"-API belép az adatbázisba és megkapja a szükséges adatokat a grafikonok, jelentések vagy események, legújabb problémák listájának megtekintéséhez.
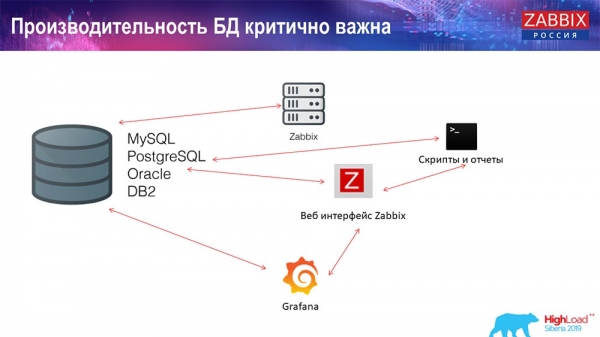
Egy másik népszerű megoldás a vizualizációra a Grafana, amelyet felhasználóink használnak. Képes közvetlenül belépni mind a "Zabbix"-API-n, mind az adatbázison keresztül. Ez szintén bizonyos versenyt teremt az adatok beszerzésében: szükség van egy finomabb, jól megtervezett adatbázis beállításra, hogy biztosítsa a gyors eredménykiadást és tesztelést.
Történetek törlése. A Zabbixban van Housekeeper.
A harmadik hívás, amelyet a Zabbix használ – a történelem törlése a Housekeeper segítségével. A 'Housekeeper' betart minden beállítást, azaz az adatelemekben meg van határozva, hogy mennyit kell tárolni (napokban), mennyit kell tárolni a trendekből és a változások dinamikájából.
Nem beszéltem a TrendCache-ről, amelyet valós időben számítunk: adatok érkeznek, aggregáljuk őket egy órára (főleg az utolsó óra számadatai), a középérték / minimális és ezt óránként egyszer rögzítjük a változások dinamikájának táblájába ('Trends'). A 'Housekeeper' elindul és sima szelektálásokkal törli az adatokat az adatbázisból, ami nem mindig hatékony.
Hogyan érthetjük meg, hogy ez nem hatékony? A belső folyamatok teljesítménygrafikonjain ezt a képet láthatja:
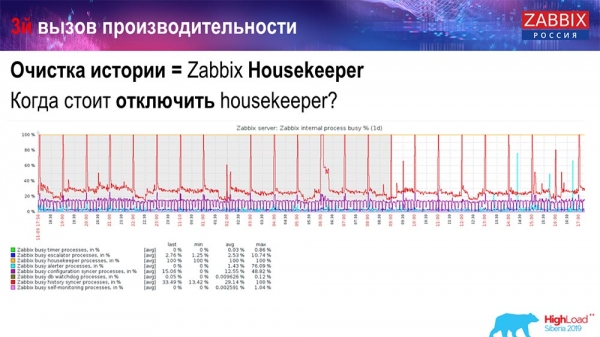
A History syncer folyamatosan lefoglalt (piros grafikon). És a 'narancssárga' grafikon, amely a felszínen fut. Ez a 'Housekeeper', amely elindul, és várja az adatbázist, hogy eltávolítsa az összes sort, amelyet megadott.
Vegyünk egy példa Item ID-t: törölni kell az utolsó 5000-et; természetesen indexek alapján. De általában az adathalmaz elég nagy – az adatbázis akkor is leolvassa az adathordozóról és emeli a cache-be, ez pedig nagyon költséges művelet az adatbázis számára. A méretétől függően ez teljesítményproblémákhoz vezethet.
A 'Housekeeper' letiltása egyszerű módon történhet – van egy mindenki által ismert webes felületünk. A beállítás az Administration general (beállítások a 'Housekeeper'-hez), ahol letiltjuk a belső housekeepingt a belső történelem és trendek számára. Ennek megfelelően a 'Housekeeper' már nem kezeli ezt:
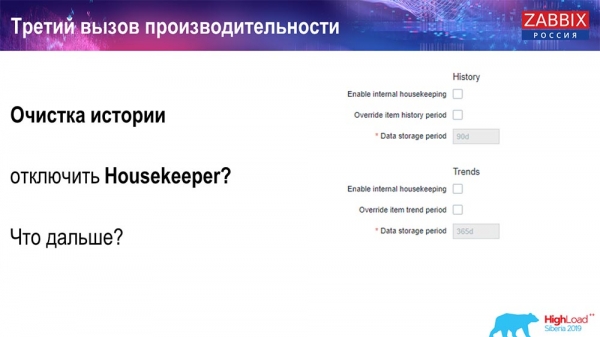
Mit lehet tenni tovább? Kikapcsolta, a grafikonok kiegyenlítődtek... Milyen további problémák merülhetnek fel ebben az esetben? Mi segíthet?
Particionálás (szekcionálás)
Ez általában minden relációs adatbázis esetében, amelyet felsoroltam, különböző módon van beállítva. A MySQL saját technológiájával rendelkezik. De összességében nagyon hasonlóak, ha a PostgreSQL 10 és a MySQL-ról beszélünk. Természetesen sok belső különbség van abban, hogy mindezt hogyan valósítják meg, és hogyan befolyásolja mindez a teljesítményt. De általában egy új partició létrehozása is gyakran bizonyos problémákhoz vezet.
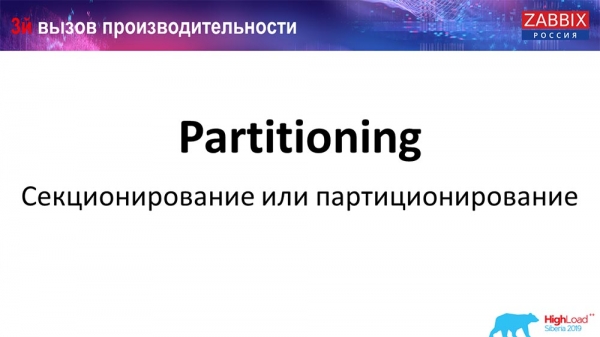
Az ön setup-jától függően (attól, hogy mennyi adatot generál naponta), általában a legminimálisabbat állítják be – ez 1 nap / partíció, a "trendek" és a változások dinamikája esetén pedig 1 hónap / új partíció. Ez változhat, ha nagyon nagy a setup-ja.
Először is, beszéljünk a setup méreteiről: 5 ezer új érték másodpercenként (nvps, ahogy mondják) már kis "setup-nak" számít. A közepes – 5-25 ezer érték másodpercenként. Mindent, ami ennél magasabb, már nagy és nagyon nagy telepítéseknek tekintünk, amelyek nagyon alapos adatbázis-beállítást igényelnek.
Nagyon nagy telepítéseknél 1 nap nem biztos, hogy optimális. Személyesen láttam MySQL partíciókat, amelyek 40 gigabyte-ot nyomtak egy nap alatt (és még többet is). Ez egy nagyon nagy adatmenyiség, ami problémákhoz vezethet. Csökkenteni kell.
Miért szükséges a partícionálás?
Mindenki tudja, mit jelent a partícionálás – ez a táblázatok szekcionálása. Gyakran ezek külön fájlok a lemezen és a span-lekérdezések. A partícionálás optimalizáltabb, ha egy partíciót választ ki, ha az a szokásos partícionálásba belefér.
"Zabbix" esetében például az intervallum alapján használják, tehát használjuk a timestamp-ot (szám, az idő az epoch kezdetétől). Beállít egy nap kezdetét / végét, és ez a partíció. Ennek megfelelően, ha két napos adatokhoz fér hozzá, azokat gyorsabban választják ki az adatbázisból, mert csak egy fájlt kell betölteni a gyorsítótárba és kiadni (nem egy nagy táblázatot).
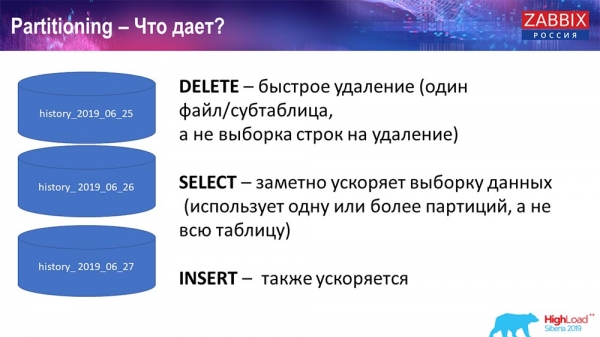
Sok adatbázis szintén felgyorsítja a beszúrást (az egy gyermek táblába). Amíg elvontan beszélek, de ez is lehetséges. A partícionálás gyakran segít.
Elasticsearch a NoSQL számára
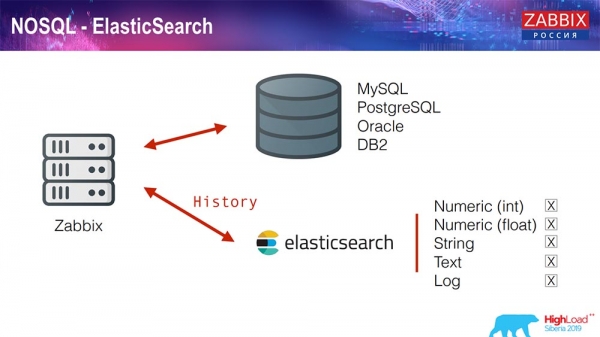
Nemrég, a 3.4-es verzióban, bevezettük a NoSQL megoldást. Lehetővé tettük, hogy írjon az Elasticsearch-be. Különböző típusokat írhat: választhat – vagy számokat, vagy valamilyen jelzéseket írjon; van string-text, logokat is írhat az Elasticsearch-be... Ezért a webes felület már az Elasticsearch-hez is kapcsolódni fog. Ez bizonyos esetekben nagyszerűen működik, de jelenleg ezt használni lehet.
TimescaleDB. Hipertáblák
A 4.4.2-ben figyelmet fordítottunk egy dologra, ami a TimescaleDB. Mi ez? Ez egy kiegészítő a PostgreSQL-hez, tehát natív PostgreSQL interfésze van. Plusz, ez a kiegészítő lehetővé teszi, hogy sokkal hatékonyabban dolgozzunk az időbeli adatokkal, és automatikus partícionálást kínál. Hogyan néz ki ez:
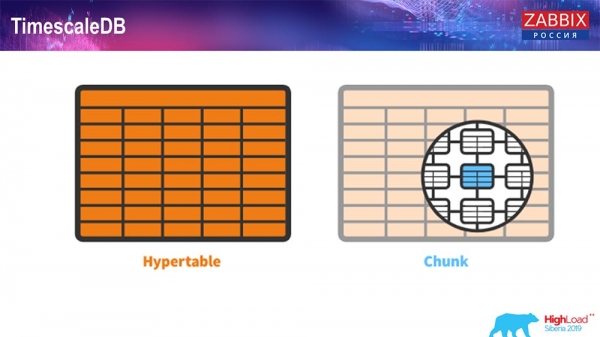
Ez egy hypertable - egy ilyen fogalom létezik a Timescale-ban. Ez egy hiper-tábla, amelyet létrehoz, és chunkok (chunk) találhatók benne. A chunkok partíciók, ezek gyerek-táblák, ha nem tévedek. Ez tényleg hatékony.
TimescaleDB és PostgreSQL
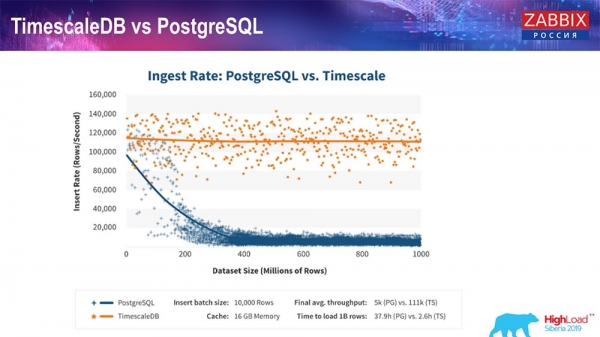
A TimescaleDB gyártói biztosítják, hogy a lekérdezések, különösen az insert-ek feldolgozásához sokkal helyesebb algoritmust használnak, amely lehetővé teszi, hogy a teljesítmény nagyjából állandó maradjon a növekvő adatkészlet-bővítés során. Tehát 200 millió sor után a PostgreSQL általában nagyon lelassul, és a teljesítménye szó szerint nullára csökken, míg a Timescale lehetővé teszi az insert-ek nagyon hatékony beillesztését bármilyen mennyiségű adaton.
Hogyan telepíthető a TimescaleDB? Minden egyszerű!
A dokumentációjában van, le van írva - bármilyen csomagból telepíthető... Függ a hivatalos PostgreSQL csomagoktól. Kézzel is le lehet fordítani. Így alakult, hogy nekem magamnak kellett fordítani az adatbázishoz.
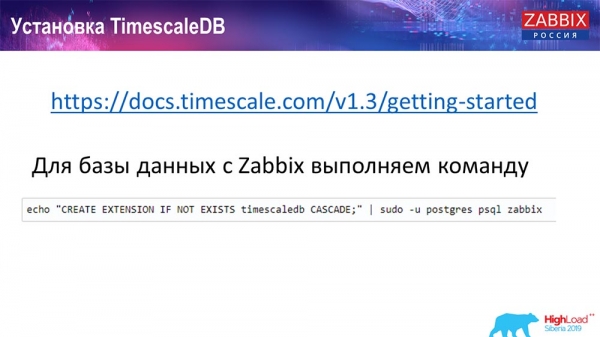
A Zabbix esetében egyszerűen aktiváljuk az Extention-t. Azt hiszem, hogy azok, akik használták a PostgreSQL-ben az Extention-t... Csak aktiválni kell az Extention-t, létrehozni azt a Zabbix adatbázis számára, amelyet használnak.
És az utolsó lépés...
TimescaleDB. Történeti táblák migrálása
Hypertable-t kell létrehoznia. Ehhez van egy külön funkció - Create hypertable. Az első paraméterben meg kell adni azt a táblát, amely szükséges ebben az adatbázisban (amelyhez hypertable-t szeretne létrehozni).
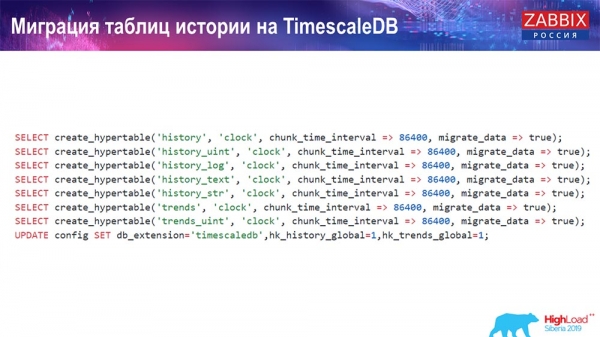
A mező, amely alapján létre kell hozni, és chunk_time_interval (ez az időszak, amelyet a chunkokhoz (partíciókhoz) használnak). 86 400 – ez egy nap.
A migrate_data paraméter: ha igazra állítja, akkor az összes jelenlegi adatot átkonvertálja a előre létrehozott chunkokba.
Személy szerint használtam a migrate_data-t - ez időigényes, a mérettől függően, amekkora az adatbázisa. Nekem több mint egy terabájt volt – a létrehozása több mint egy óráig tartott. Bizonyos esetekben a tesztelés során töröltem a történeti adatokat a szövegből (history_text) és a strungból (history_str), hogy ne kelljen átkonvertálnom – ezek valójában nem érdekeltek.
Az utolsó frissítést a db_extension-ünkben végezzük: a timescaledb-t állítjuk be, hogy az adatbázis és különösen a "Zabbix" felismerje, hogy van db_extension. Aktiválja és helyesen használja a szintaxist és a lekérdezéseket az adatbázisra, kihasználva a TimescaleDB-hez szükséges "funkciókat".
Szerver konfiguráció
Két szervert használtam. Az első szerver egy viszonylag kis virtuális gép, 20 processzorral és 16 gigabájt RAM-mal. Ezen beállítottam a PostgreSQL 10.8-at:
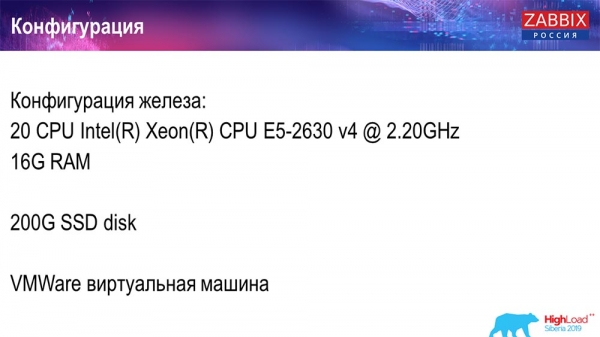
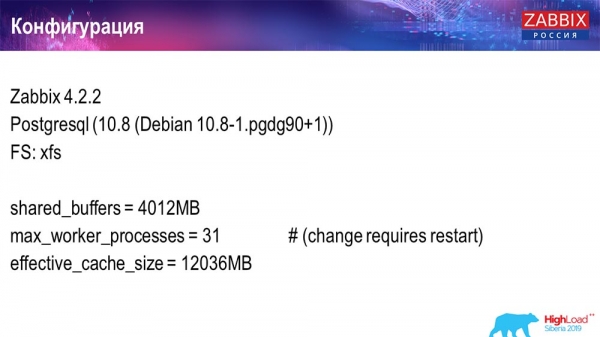
Az operációs rendszer Debian volt, a fájlrendszer – xfs. Minimális beállításokat végeztem, hogy ezt az adatbázist használjam, leszámítva, hogy az "Zabbix" is használni fogja. Ugyanezen a gépen volt a "Zabbix" szerver, a PostgreSQL és a terhelésgenerátor ügynökök.
50 aktív ügynököt használtam, amelyek LoadableModule-t használnak a különböző eredmények gyors generálására. Ők generálták a sorokat, számokat és így tovább. Nagy mennyiségű adatot töltöttem az adatbázisba. Kezdetben a konfiguráció 5000 adatpontot tartalmazott minden hoszton, és körülbelül minden adatpont tartalmazott egy kioldót – hogy valós beállítás legyen. Néha még több mint egy kioldó szükséges a használathoz.
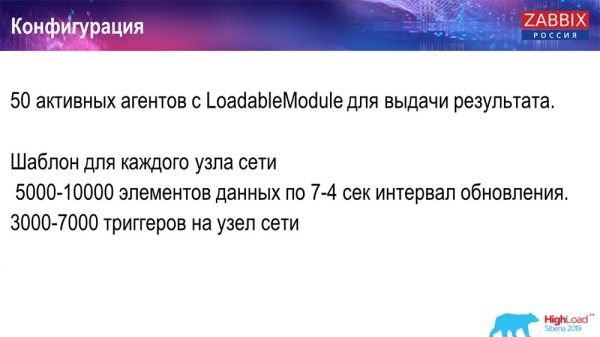
A frissítési intervallumot és magát a terhelést úgy szabályoztam, hogy nemcsak 50 ügynököt használtam (továbbiakat adtam hozzá), hanem dinamikus adatpontokkal is, és a frissítési intervallumot 4 másodpercre csökkentettem.
Teljesítményteszt. PostgreSQL: 36 ezer NVP.
Az első indítás, az első beállításom tiszta PostgreSQL 10-en volt ezen a hardveren (35 ezer érték másodpercenként). Összességében, ahogy a képernyőn látszik, az adatok beszúrása másodperc töredékeit veszi igénybe – minden jól és gyorsan zajlik, SSD meghajtók (200 gigabájt). Az egyetlen probléma, hogy a 20 GB elég gyorsan megtelik.
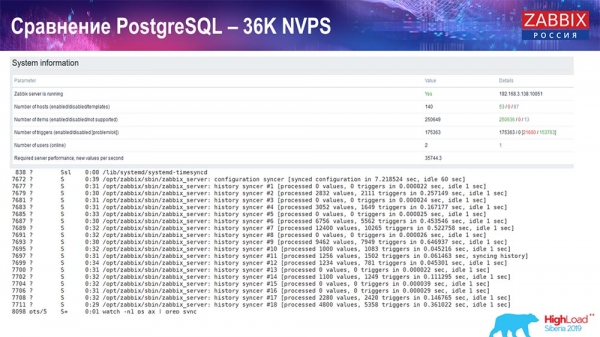
Több ilyen grafikon lesz a jövőben. Ez a "Zabbix" szerver teljesítményének standard irányítópultja.
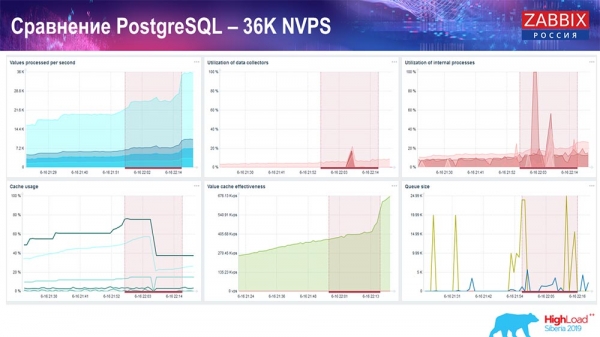
Az első grafikon – az értékek másodpercenkénti száma (kék, bal felső sarok), 35 ezer érték ebben az esetben. Ez (a középső felső részben) a gyűjtési folyamatok terhelése, míg ez (a jobb felső sarokban) az éppen belső folyamatok terhelése: history syncers és housekeeper, ami itt (a középső alsó részben) elég sokáig futott.
Ez a grafikon (középen alul) mutatja a ValueCache használatát - hány találat van a ValueCache-ben a triggereknél (több ezer érték másodpercenként). Egy másik fontos grafikon a negyedik (bal alul), amely a HistoryCache használatát mutatja be, amiről már beszéltem, amely a DB-be való beillesztés előtt működik mint puffert.
Teljesítményteszt. PostgreSQL: 50 ezer NVP
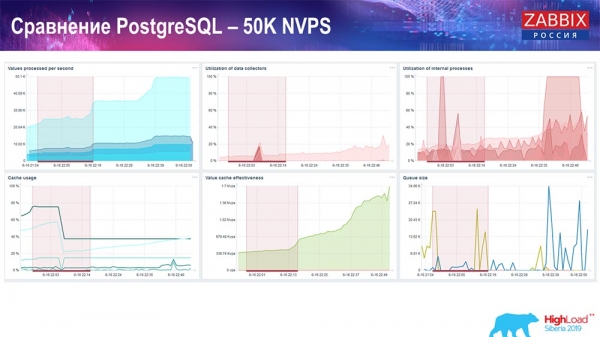
Ezután 50 ezer értékre emeltem a terhelést ugyanazon a hardveren. A «Housekeeper» terhelése mellett 10 ezer érték már 2-3 másodperc alatt lett beírva számítással. Ez látható a következő képernyőfelvételen:
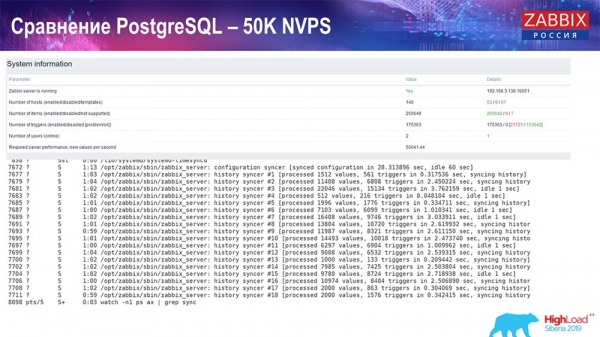
A «Housekeeper» már zavarni kezdte a működést, de összességében a history-szinkronizálók terhelése még mindig 60%-on áll (a harmadik grafikon, fent jobbra). A HistoryCache már a «Housekeeper» működése alatt aktívan kezdett feltöltődni (bal alul). Ez körülbelül fél gigabájt volt, 20%-ra töltődött.
Teljesítményteszt. PostgreSQL: 80 ezer NVP
Ezután 80 ezer értékre emeltem a terhelést:
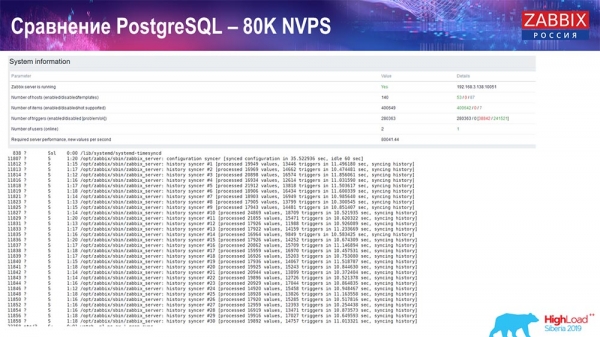
Ez körülbelül 400 ezer adatot, 280 ezer triggot jelentett. Ahogy látható, a history-szinkronizálók (30 darab volt) terhelése már eléggé magas volt. Ezután különböző paramétereket emeltem: history-szinkronizálók, cache… Ezen a hardveren a history-szinkronizálók terhelése már a maximum felé közelített, gyakorlatilag „a polcon” - következésképpen a HistoryCache nagyon magas terhelésre ment.
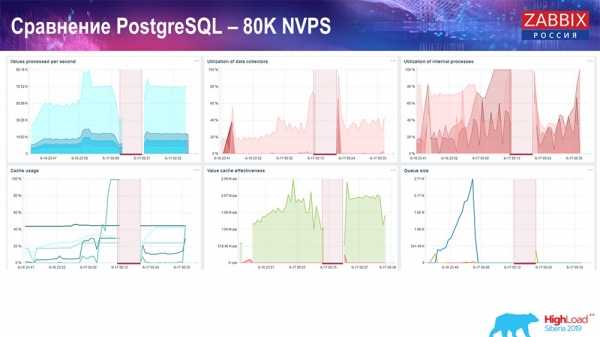
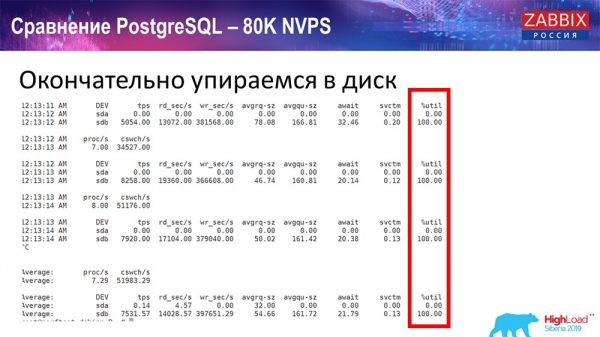
Ez idő alatt figyeltem az összes rendszerparamétert (hogy a CPU hogyan van kihasználva, a RAM) és felfedeztem, hogy a lemez kihasználtsága maximális volt - a maximális kapacitását kihasználva, ezen a hardveren, ezen a virtuális gépen. A «Postgres» ilyen intenzitás mellett aktívan kezdett adatokat törölni, és a lemez már nem tudta tartani az írást, olvasást...
Fogtam egy másik szervert, amely már 48 processzorral és 128 gigabájt RAM-mal rendelkezett:
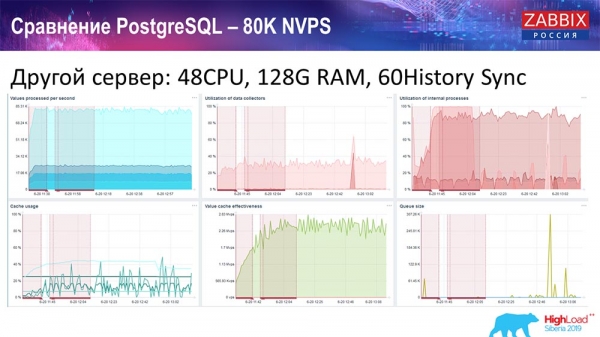
Ezen kívül még „feltuningoltam” - beraktam a History szinkronizálót (60 darab) és elértem a megfelelő teljesítményt. Gyakorlatilag nem vagyunk „a polcon”, de ez már valószínűleg a teljesítmény határa, ahol már lépni kell valamit.
Teljesítményteszt. TimescaleDB: 80 ezer NVP
A fő feladatom az volt - használni a TimescaleDB-t. Minden grafikonon látható a zuhanás:
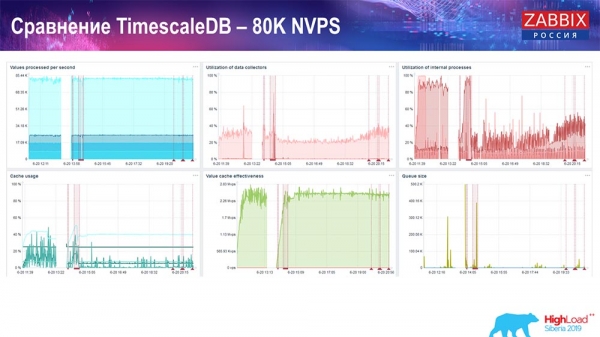
Ezek a hibák pontosan az adatmigrációk. Ezt követően a Zabbix szerverben a hibaelhárítók terhelési profilja, ahogy látják, jelentősen megváltozott. Ez gyakorlatilag háromszor gyorsabban teszi lehetővé az adatok betöltését és kevesebb HistoryCache-t használ – ennek megfelelően az adatok időben érkeznek. Ismét, 80 ezer érték másodpercenként – ez egy elég magas sebesség (bár nem a Yandex számára). Összességében ez egy elég nagy beállítás, egy szerverrel.
PostgreSQL teljesítményteszt: 120 ezer NVP
Ezután megemeltem az adatelemek számát félmillióra, és az eredményül kapott érték 125 ezer másodpercenként:
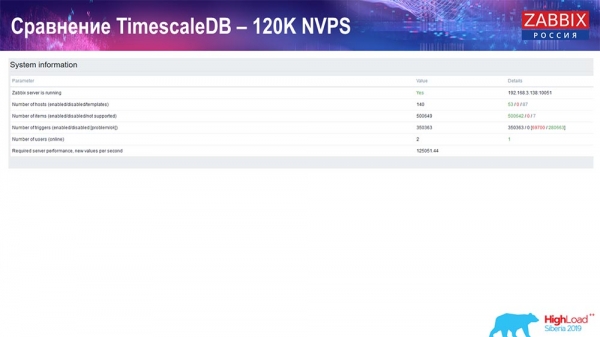
És ilyen grafikonokat kaptam:
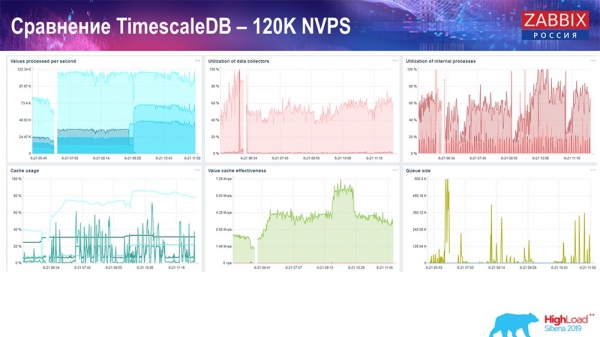
Alapján ez egy működő beállítás, amely elég hosszú ideig képes működni. De mivel csak másfél terabájtos lemezem volt, azt pár nap alatt felhasználom. A legfontosabb, hogy eközben új partíciók készültek a TimescaleDB-ben, és ez a teljesítmény szempontjából teljesen észrevétlenül zajlott, ami nem mondható el a MySQL-ről.
Általában a partíciókat éjszaka hozzák létre, mert ez blokkolhatja az adatbevitelt és a táblák kezelését, ami a szolgáltatás romlását eredményezheti. Ebben az esetben ez nem történt meg! A fő feladat az volt, hogy teszteljük a TimescaleDB lehetőségeit. Az eredmény: 120 ezer érték másodpercenként.
A közösségben is vannak példák:
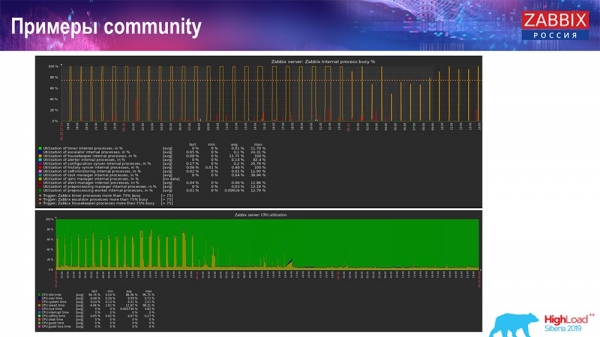
Valaki szintén bekapcsolta a TimescaleDB-t, és az io.weight használat csökkent a processzoron; és a belső folyamatok elemeinek használata is csökkent a TimescaleDB bekapcsolása miatt. Ráadásul ezek hagyományos merevlemezek, azaz egy átlagos virtuális gép hagyományos lemezekkel (nem SSD)!
Valamilyen kis beállításokhoz, amelyek a lemez teljesítményén állnak meg, a TimescaleDB, úgy gondolom, nagyon jó megoldás. Jól lehetővé teszi, hogy továbbra is dolgozzunk, mielőtt gyorsabb hardverre migrálnánk az adatbázishoz.
Mindenkit meghívlak az eseményeinkre: Konferencia – Moszkvában, csúcs – Rigában. Használja a csatornáinkat – Telegram, fórum, IRC. Ha kérdése van – jöjjön el hozzánk a pulthoz, beszélgessünk mindenről.
Kérdések a közönségtől
Kérdés a közönségtől (a továbbiakban: A): – Ha a TimescaleDB annyira egyszerűen konfigurálható, és ilyen teljesítménynövekedést biztosít, akkor talán ezt érdemes lenne a legjobb gyakorlatként használni a Zabbix és a PostgreSQL beállításánál? Vannak-e valamilyen buktatók vagy hátrányai ennek a megoldásnak, vagy igazából, ha én Zabbixot akarok csinálni, nyugodtan választhatom a PostgreSQL-t, azonnal telepítem a Timescale-t, használom, és nem kell aggódnom semmilyen probléma miatt?
AG: – Igen, azt mondanám, hogy ez egy jó ajánlás: a PostgreSQL-t azonnal használni a TimescaleDB kiterjesztéssel. Ahogy már korábban is említettem, sok jó vélemény érkezett, annak ellenére, hogy ez a "funkció" kísérleti. De valójában a tesztek azt mutatják, hogy ez egy nagyszerű megoldás (a TimescaleDB-vel), és úgy gondolom, hogy ez fejlődni fog! Figyelemmel követjük, hogyan fejlődik ez a kiterjesztés, és módosítjuk, ami szükséges.
Még a fejlesztés alatt is támaszkodtunk egy jól ismert "funkcióra": ott kicsit másképp lehetett dolgozni a chunk-kkal. De aztán ezt következő kiadásban eltávolították, és már nem tudtunk erre a kódra támaszkodni. Azt javaslom, hogy sok beállításnál használja ezt a megoldást. Ha MySQL-t használ... Közepes beállításokra bármelyik megoldás jól működik.
A: – Az utolsó grafikonokon, amik a közösségtől származnak, volt egy grafikon a "Housekeeper"-rel:
Folytatta a munkáját. Mit csinál a "Housekeeper" a TimescaleDB esetében?
AG: – Jelenleg nem tudom pontosan megmondani – megnézem a kódot, és részletesebben fogok nyilatkozni. A TimescaleDB kéréseit nem az adatok chunk-jainak eltávolítására használja, hanem valamilyen aggregálásra. Még nem vagyok kész válaszolni erre a technikai kérdésre. A standon ma vagy holnap pontosítjuk.
A: – Nekem hasonló kérdésem van – a Timescale műveletek törlésének teljesítményéről.
A (válasz a közönségtől): – Amikor adatokat töröl a táblázatból, ha ezt a delete paranccsal teszi, akkor végig kell mennie a táblázaton – törölni, tisztítani, mindent megjelölni a jövőbeli vákuumért. A Timescale-ban, mivel chunk-jai vannak, le tudja dobni. Durván szólva, egyszerűen mondja a fájlnak, ami a big data-ben van: "Törölni!"
A «TimeScale» egyszerűen megérti, hogy ilyen chunk már nincs. Mivel integrálódik a lekérdezés ütemezőbe, a hook-okon keresztül észleli az Ön által megadott feltételeket a select-ben vagy más műveletekben, és azonnal érti, hogy e chunk már nincs – „Többé nem megyek oda!” (nincsenek adatok). Ennyi! Tehát a táblaszkennelést a bináris fájl törlésére cserélik ki, ezért ez gyors.
A: – Korábban már érintettük az SQL nélküli témát. Amennyire értem, a «Zabbix»-nak nem igazán szükséges módosítani az adatokat, és az egész inkább egy naplófélének számít. Lehet-e használni olyan speciális adatbázisokat, amelyek nem tudják változtatni az adataikat, de sokkal gyorsabban képesek tárolni, gyűjteni, szolgáltatni - például a Clickhouse, esetleg valami Kafka-szerűt? A Kafka is log, ugye! Integrálhatóak valahogy?
AG: – Az exportálás lehetséges. Van egy bizonyos „funkciónk” a 3.4-es verzió óta: írhatsz fájlokba minden történelmi fájlt, eseményt és más egyebet; aztán valamilyen feldolgozóval továbbíthatod egy másik adatbázisba. Valójában sokan átalakítják és közvetlenül az adatbázisba írnak. A直播 történeti szinkronizálók mindezt fájlokba írják, forgatják ezeket a fájlokat és hasonlók, és ezeket át lehet rakni a „Clickhouse”-ba. Nem tudok a tervekről, de lehet, hogy a NoSQL megoldások további támogatása (mint a „Clickhouse”) folytatódni fog.
A: – Tehát igazából teljesen meg lehet szabadulni a Postgres-től?
AG: – Természetesen a legnehezebb része a «Zabbix»-nak a történeti táblák, amelyek a legtöbb problémát okozzák, és az események. Ebben az esetben, ha nem tárolja hosszú távon az eseményeket, és a trendek történelmét valamilyen más gyors tárolóban tartja, akkor összességében nem lesz probléma.
A: – Meg tudná mondani, mennyivel gyorsabban fog működni, ha átállunk a «Clickhouse»-ra, mondjuk?
AG: – Nem teszteltem. Szerintem a legalább ugyanolyan számokat el lehet majd érni viszonylag egyszerűen, figyelembe véve, hogy a «Clickhouse»-nak saját felülete van, de pontos választ nem tudok adni. Jobb lenne tesztelni. Minden a konfigurációtól függ: hány hosztja van és hasonlók. Az adatok beillesztése egy dolog, de azokat is el kell érni – Grafana vagy valami más segítségével.
A: – Tehát a szóban forgó dolog egyenlő küzdelmet jelent, nem pedig óriási előnyt ezeknek a gyors adatbázisoknak?
AG: – Azt hiszem, amikor integrálunk, akkor pontosabb teszteink lesznek.
A: – Hol maradt a régi jó RRD? Miért kellett áttérni az SQL adatbázisokra? Kezdetben minden metrika RRD-be gyűlt.
AG: – A «Zabbix»-ban az RRD, talán egy nagyon régi verzióban volt. Mindig is léteztek SQL alapú adatbázisok – klasszikus megközelítés. A klasszikus megközelítés a MySQL, PostgreSQL (már nagyon régóta léteznek). Szinte soha nem használtuk az SQL adatbázisokkal és az RRD-vel közös interface-t.

Egy kis reklám 🙂
Köszönjük, hogy velünk maradtál. Tetszenek a cikkeink? Szeretnél több érdekes anyagot látni? Támogass minket, és rendelés leadásával vagy ismerősöknek ajánlással segíts nekünk. , Egyedülálló alternatívája az entry-level szervereknek, amelyet Önnek találtunk ki: (elérhetők RAID1 és RAID10 opciók, akár 24 magig és 40GB DDR4-ig).
Dell R730xd kétszer olcsóbban a Tier IV Equinix adatközpontban Amszterdamban? Csak nálunk Hollandiában! Dell R420 — 2x E5-2430 2.2GHz 6C 128GB DDR3 2x960GB SSD 1Gbps 100TB — 99 dollártól! Olvasd el ezt
Forrás: habr.com
