

Időnként felmerül a szükség, hogy összefüggő adatokat keressünk egy kulcskészlet alapján, amíg el nem érjük a kívánt összesített rekordok számát..
A legéletszerűbb példa — megjeleníteni a 20 legöregebb feladatot,amelyek szerepelnek a munkatársak listáján, (például egy adott részlegen belül). Különböző menedzsment „dashbordok” esetében, amelyek rövid összefoglalókat adnak a munkaterületekről, hasonló téma elég gyakran szükséges.
A cikkben a PostgreSQL „naiv” megoldásának megvalósítását, egy „okosabb” és egy igazán bonyolult algoritmust fogunk megvizsgálni, SQL „ciklus” példáján keresztül, amely a megtalált adatok alapján lép ki,ami hasznos lehet a személyes fejlődés szempontjából, valamint más hasonló esetekben való alkalmazásra is.
Vegyünk egy tesztadat-készletet, Ahhoz, hogy a megjelenített rekordok ne „ugráljanak” alkalomról alkalomra a rendezett értékek megegyezésekor, tágítsuk az indexet az elsődleges kulcs hozzáadásával.Ez egyszerre egyedivé is teszi, és garantálja számunkra a rendezési sorrend egyértelműségét:
CREATE INDEX ON task(owner_id, task_date, id);
-- a régit töröljük
DROP INDEX task_owner_id_task_date_idx;
Ahogy hallatszik, úgy is írják.
Először is vázoljuk fel a leginkább alapvető lekérdezést, azzal, hogy az ügyfelek ID-ját :
SELECT
  *
FROM
  task
WHERE
  owner_id = ANY('{1,2,4,8,16,32,64,128,256,512}'::integer[])
ORDER BY
  task_date, id
LIMIT 20; 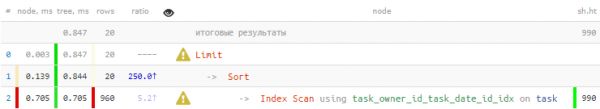
Kicsit szomorú — csak 20 rekordot kértünk, de az Index Scan összesen 960 sort adott vissza,amelyeket még rendezni is kellett... Na, próbáljuk meg kevesebbet olvasni.
unnest + ARRAY
Az első észrevétel, ami segíteni fog — ha csak 20 rendezett rekordra van szükségünk, akkor elegendő csak 20 rendezett rekordot olvasni a megfelelő sorrendben minden egyes kulcshoz. Szerencsére, a megfelelő index (owner_id, task_date, id) már létezik nálunk. Használjuk ugyanazt a mechanizmust az adatkinyeréshez és a „hasábokba fordításhoz”
az egész tábla rekordján , mint a. Emellett alkalmazzuk az ARRAY() funkciót a tömbokká való tömörítéshez. WITH T AS ( SELECT unnest(ARRAY( SELECT t FROM task t WHERE owner_id = unnest ORDER BY task_date, id LIMIT 20 -- itt korlátozzuk... )) r FROM unnest('{1,2,4,8,16,32,64,128,256,512}'::integer[]) ) SELECT (r).* FROM T ORDER BY (r).task_date, (r).id LIMIT 20; -- ... és itt is - ugyanúgy Oh, már sokkal jobb!:
40%-kal gyorsabb, és 4,5-szer kevesebb adatot 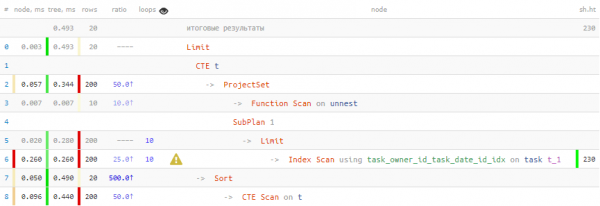
kellett olvasni. A táblázatok rekordjainak anyagba állítása CTE-n keresztül. Felhívom a figyelmet arra, hogy
a rekordok bevonása a célnak megfelelően történik, és a szükséges adatokkal gazdagodik,amely az eredmények megfelelő értelmezését garantálja. bizonyos esetekben a keresett rekord mezőivel való közvetlen munkavégzés a beágyazott lekérdezés után, anélkül, hogy "CTE-be" csomagolnánk, ilyenekhez vezethet a InitPlan "sokszorozásához" az említett mezők számának megfelelően:
SELECT
  ((
    SELECT
      t
    FROM
      task t
    WHERE
      owner_id = 1
    ORDER BY
      task_date, id
    LIMIT 1
  ).*);
Eredmény (költség=4.77..4.78 sor=1 szélesség=16) (valós idő=0.063..0.063 sor=1 ciklus=1)
Pufferek: megosztott hit=16
InitPlan 1 (visszaadja $0)
-> Limit (költség=0.42..1.19 sor=1 szélesség=48) (valós idő=0.031..0.032 sor=1 ciklus=1)
Pufferek: megosztott hit=4
-> Index Átvizsgálás a task_owner_id_task_date_id_idx index alapján a task t-n (költség=0.42..387.57 sor=500 szélesség=48) (valós idő=0.030..0.030 sor=1 ciklus=1)
Index feltétel: (owner_id = 1)
Pufferek: megosztott hit=4
InitPlan 2 (visszaadja $1)
-> Limit (költség=0.42..1.19 sor=1 szélesség=48) (valós idő=0.008..0.009 sor=1 ciklus=1)
Pufferek: megosztott hit=4
-> Index Átvizsgálás a task_owner_id_task_date_id_idx index alapján a task t_1-en (költség=0.42..387.57 sor=500 szélesség=48) (valós idő=0.008..0.008 sor=1 ciklus=1)
Index feltétel: (owner_id = 1)
Pufferek: megosztott hit=4
InitPlan 3 (visszaadja $2)
-> Limit (költség=0.42..1.19 sor=1 szélesség=48) (valós idő=0.008..0.008 sor=1 ciklus=1)
Pufferek: megosztott hit=4
-> Index Átvizsgálás a task_owner_id_task_date_id_idx index alapján a task t_2-n (költség=0.42..387.57 sor=500 szélesség=48) (valós idő=0.008..0.008 sor=1 ciklus=1)
Index feltétel: (owner_id = 1)
Pufferek: megosztott hit=4
InitPlan 4 (visszaadja $3)
-> Limit (költség=0.42..1.19 sor=1 szélesség=48) (valós idő=0.009..0.009 sor=1 ciklus=1)
Pufferek: megosztott hit=4
-> Index Átvizsgálás a task_owner_id_task_date_id_idx index alapján a task t_3-on (költség=0.42..387.57 sor=500 szélesség=48) (valós idő=0.009..0.009 sor=1 ciklus=1)
Index feltétel: (owner_id = 1)
Pufferek: megosztott hit=4
Ugyanazt a rekordot "kerestük" meg 4 alkalommal... A PostgreSQL 11-ig ez a viselkedés rendszeres volt, és a megoldás a "CTE-be" való csomagolás, amely ezekben a verziókban a lekérdezésoptimalizáló határvonalát képezi.
Rekurzív akkumulátor
A korábbi változatban összesen 200 sort olvastunk a szükséges 20-ért. Már nem 960, de még kevesebb – lehetséges?
Próbáljuk meg felhasználni azt a tudást, hogy nekünk összesen 20 rekordra van szükségünk. Tehát csak addig iterálunk az adatok kiolvasásán, amíg elérjük a szükséges mennyiséget.
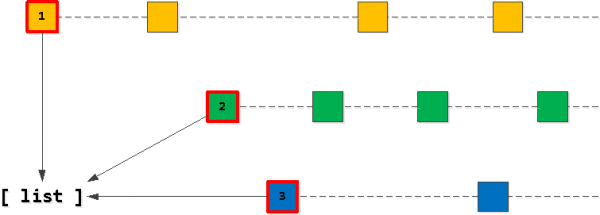
1. lépés: kezdő lista
Nyilvánvaló, hogy a célzott 20 rekordból álló listánknak az "első" rekordokkal kell kezdenie, egyes owner_id kulcsok között. Ezért először ilyeneket kell találnunk "legelsőket" minden egyes kulcs alapján és fel kell venni a listába, a kívánt sorrendben rendezve – (task_date, id).
2. lépés: megtaláljuk a "következő" rekordokat
Most, ha az első rekordot vesszük a listánkból és elkezdünk "lépkedni" tovább az indexen a tulajdonos_azonosító kulcs megtartásával az összes megtalált bejegyzés pontosan a következő a lekérdezési eredményben. Természetesen csak amíg nem lépjük át az alkalmazási kulcsot a lista második bejegyzését.
Ha úgy alakult, hogy a második bejegyzést "átléptük", akkor az utolsó olvasott bejegyzést kell hozzáadni a listához az első helyett (ugyanazzal a tulajdonos_azonosítóval), majd a listát újra rendezni kell.
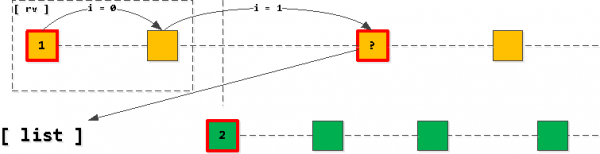
Ez azt jelenti, hogy folyamatosan olyan helyzet áll elő, hogy a listában legfeljebb egy bejegyzés van minden kulcs számára (ha a bejegyzések elfogytak, és mi nem "léptük át", akkor az első bejegyzés egyszerűen eltűnik a listából, és semmi nem kerül hozzá), és ezek mindig rendezettek az alkalmazási kulcs (task_date, id) növekvő sorrendjében.
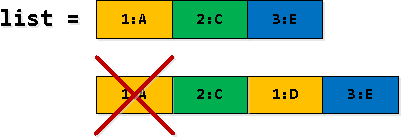
3. lépés: szűrjük és "kiterjesztjük" a bejegyzéseket
A rekuzív lekérdezés egyes sorai esetében néhány bejegyzés rv megismétlődik - először megtaláljuk azokat, amelyek "átlépik a lista 2. bejegyzésének határát", majd az elsőként helyettesítjük őket a listában. Nos, az első előfordulását ki kell szűrni.
Szörnyű végső lekérdezés
REKURZÍV T KÉPVISELŐJELENETAS SELECT * GI SORNÁKRA MINDEN KULCSOT RÉSZÉRE KIALAKÍTOTT KEDVEZMÉNYLEHETŐSÉGKÉRÉSSEL MINDEN KULCSOT KÜLÖN KELLETT HASZNÁLNI! A WRAP ( - A HESTE VISSZAHÚZÁSÁVAL, ÉS A SEGÍTSÉGEK NEM CSÖKKENK FOLYAMATOS LEÍRÁSA MALCOLM ELEMENTÁRI RECORD-HOZ TISZTESSÉG RÉF ‘FELBONTÁS’ AZ HATÓANYAGOK MINT KÜLÖN ÖSSZEFONÓDÁSKI, TEHÁT A 3-IK HATÓANYAGOT KIZÁRJA, RÉG KEDVEZMÉNY ÉS MULTIPLICEI FORGÓK KERÜLNEK A LISTÁBÓL. LEGOLDALASBAN A FELIRAT NEM LETTED EZT A PONTOT, HANEM ENNEK AZ OLDTALAN PONTNAK A FŐ LEBONYOLÍTÁSÁVAL RÉGIVEL, HANEM KIEGÉSZÍTETT A KONDÍCIÓVAL KAPCSOLÓDÓ TARTALMAZÁSNAK FEJLŐDÉSÉRE. 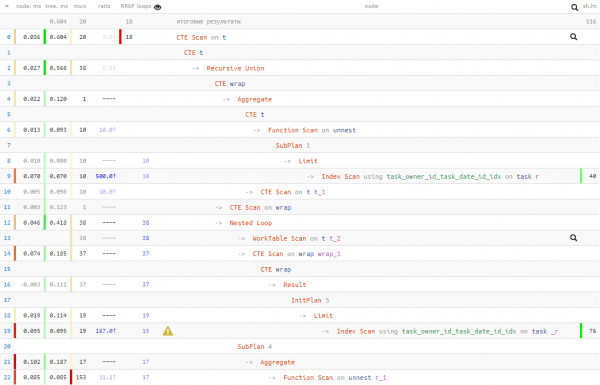
Ezért 50%-os adatolvasásra 20%-os futási időt cseréltünk.Tehát, ha úgy gondolja, hogy az olvasás hosszú ideig eltarthat (például, ha az adatok gyakran nincsenek a gyorsítótárban, és a lemezen kell őket keresni), akkor ebben az esetben kevesebbet lehet függni az olvasástól.
Mindenesetre a végrehajtási idő jobban alakult, mint a „naiv” első változatban. De hogy melyik ezek közül a 3 változatot használja – az az Ön döntése.
Forrás: habr.com
