

A következő HighLoad++ konferencia 2020. április 6-án és 7-én kerül megrendezésre Szentpéterváron. Részletek és jegyek . HighLoad++ Moszkva 2018. Terem: „Moszkva”. November 9., 15:00. Összefoglalók és .
* Monitoring — online és analitika.
* A ZABBIX platform főbb korlátai.
* Megoldás az analitika tárolásának skálázására.
* A ZABBIX szerver optimalizálása.
* UI optimalizálás.
* Több mint 40k NVPS terhelés esetén szerzett tapasztalatok.
* Röviden a következtetések.
Mihail Makurov (a továbbiakban MM): – Üdvözlök mindenkit!
Maxim Csernyecov (a továbbiakban MCS): – Jó napot kívánok!
MM: – Engedjék meg, hogy bemutassam Maxit. Max egy tehetséges mérnök, a legjobb hálózati szakember, akit ismerek. Maxim a hálózatokkal és szolgáltatások fejlesztésével és üzemeltetésével foglalkozik.
MCS: – Én pedig Mihailról szeretnék beszélni. Mihail C nyelven programozó. Számos nagy terhelést igénylő forgalomkezelő megoldást írt a cégünk számára. Az Uralban élünk és dolgozunk, a kemény férfiak városában, Cseljabinszkban, az „Interszvjaz” cégnél. Cégünk internetes és kábeltévé szolgáltatást nyújt egymillió embernek 16 városban.
MM: – És érdemes megemlíteni, hogy az „Interszvjaz” sokkal több, mint egy egyszerű szolgáltató, ez egy IT-cég. A megoldásaink nagy része a mi IT-osztályunk munkájának eredménye.
A: a forgalmat kezelő szerverektől kezdve a call centerig és a mobilalkalmazásig. Az IT-osztályon jelenleg körülbelül 80 ember dolgozik, nagyon sokféle kompetenciával.
A Zabbixról és annak architektúrájáról
MCS: – Most pedig megpróbálom felállítani a személyes rekordomat, és egy perc alatt elmondani, mi is a Zabbix (a továbbiakban „Zabbix”).
A „Zabbix” úgy pozicionálja magát, mint egy vállalati szintű monitoring rendszer, amely „dobozból ki” működik. Számos hasznos funkciónk van: fejlett eszkalációs szabályok, API integrációhoz, hosztok és metrikák csoportosítására és automatikus felfedezésére. A „Zabbix”-ban vannak úgynevezett skálázási eszközök – proxyk. A „Zabbix” nyílt forráskódú rendszer.
Röviden az architektúráról. Mondhatjuk, hogy három komponensből áll:
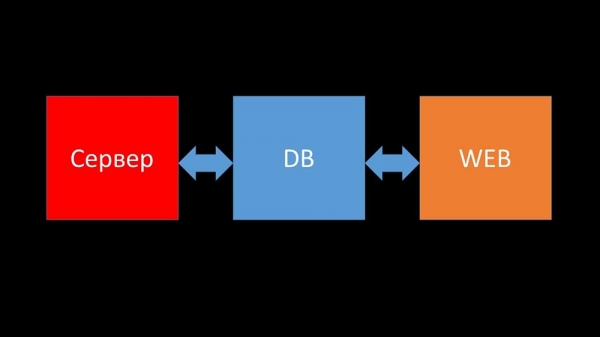
- Szerver. C nyelven íródott. Elég bonyolult információfeldolgozással és -átadással a szálak között. Az összes feldolgozás itt történik: az adatfogadástól a tárolásig.
- Minden adat az adatbázisban tárolódik. A „Zabbix” támogatja a MySQL, PostgreSQL és Oracle rendszereket.
- A web interface is written in PHP. Most systems come with the Apache server, but it works more efficiently in conjunction with nginx + php.
Today we would like to share a story from our company related to "Zabbix"…
A story from the life of the company "Intersvyaz". What do we have and what do we need?
5 or 6 months ago. One day after work…
MCS: – Misha, hi! Glad I caught you – we need to talk. We had issues with monitoring again. During a major outage, everything slowed down, and there was no information about the network status. Unfortunately, this is not the first time this has happened. I need your help. Let's make sure our monitoring works under any circumstances!
MM: – But first, let’s synchronize. I haven’t looked at it in a couple of years. As far as I remember, we gave up Nagios and switched to "Zabbix" about 8 years ago. And now we seem to have 6 powerful servers and about a dozen proxies. Am I mixing things up?
MCS: – Almost. We have 15 servers, some of which are virtual machines. The main issue is that this doesn't save us at the moment when we need it the most. When an outage happens, the servers slow down, and nothing is visible. We tried to optimize the configuration, but it doesn't yield any optimal performance gains.
MM: – I see. Have you looked at anything, dug up any diagnostics?
MCS: – The first thing to deal with is the database. MySQL is constantly overloaded, saving new metrics, and when "Zabbix" starts generating a ton of events – the database locks itself for literally several hours. I’ve already told you about the configuration optimization, and just this year we updated the hardware: there are over a hundred gigs of memory on the servers and SSD RAID arrays – there’s no point in growing it linearly any further. What shall we do?
MM: – I see. Generally, MySQL is a LTP database. It seems it's no longer suitable for storing an archive of metrics of our size. Let's figure it out.
MCS: – Let's do it!
Integration of Zabbix and Clickhouse as a result of the hackathon
After a while, we received interesting data:
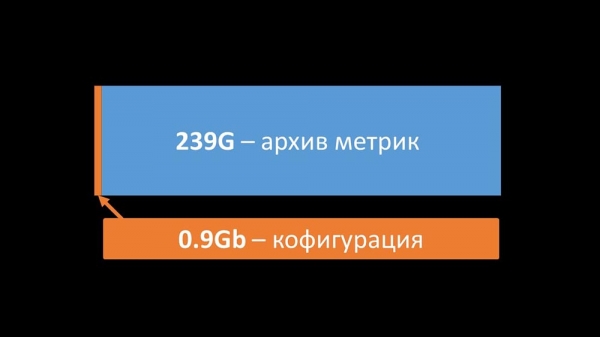
A legtöbb hely a rendszerünkben a metrikák archívumával volt elfoglalva, és kevesebb mint 1%-ot használtunk konfigurációra, sablonokra és beállításokra. Ekkor már több mint egy éve használtuk a Big Data megoldást Clickhouse alapokon. Az irányunk egyértelmű volt. A tavaszi Hackathonon írtam egy integrációt a Zabbix és a Clickhouse között a szerver és a frontend számára. Abban az időben a Zabbix már támogatta az ElasticSearch-t, és úgy döntöttünk, hogy összehasonlítjuk őket.
Clickhouse és Elasticsearch összehasonlítása
MM: – Az összehasonlításhoz olyan terhelést generáltunk, mint amit a Zabbix szerver biztosít, és megnéztük, hogyan fogják viselni a rendszerek. 1000 soros csomagokban írtunk adatokat, CURL-t használtunk. Előre feltételeztük, hogy a Clickhouse hatékonyabb lesz a Zabbix által generált terhelési profilhoz képest. Az eredmények még a vártnál is jobbakk lettek:
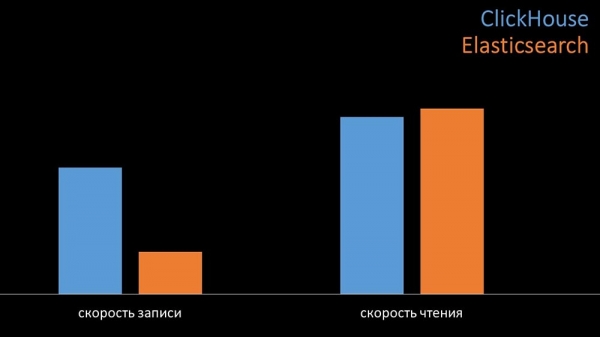
Azonos körülmények között a teszteken a Clickhouse háromszor annyi adatot írt. Eközben mindkét rendszer nagyon hatékonyan használta az erőforrásokat az adatok olvasásakor. De az ElasticSearch esetében íráskor nagy CPU kapacitásra volt szükség:
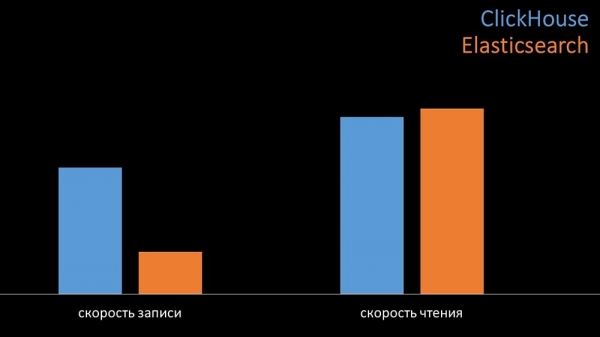
Összességében a Clickhouse lényegesen túlszárnyalta az ElasticSearch-t CPU fogyasztásban és sebességben. A tömörítési technológia miatt a Clickhouse 11-szer kevesebb helyet használ a merevlemezen, és körülbelül 30-szor kevesebb lemezműveletet végez:
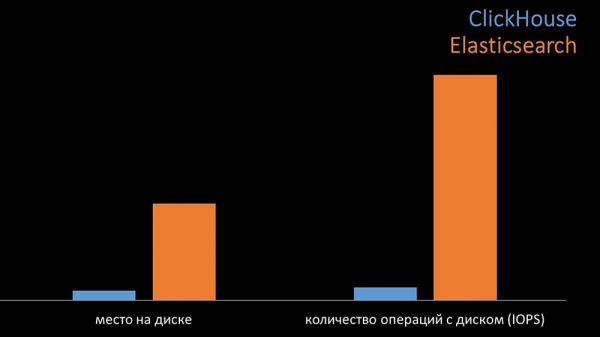
MCS: – Igen, a Clickhouse lemezkezelése rendkívül hatékonyan van megvalósítva. Határtalan SATA lemezeket használhatunk az adatbázisokhoz, és akár százezernyi sor másodpercenkénti írási sebességet érhetünk el. A rendszer „out of the box” támogatja a shardingot és a replikációt, és meglehetősen egyszerű a beállítása. Több mint elégedettek vagyunk a tavalyi üzemeltetésével.
Az erőforrások optimalizálása érdekében a Clickhouse-t közvetlenül a meglévő fő adatbázis mellett is telepíthetjük, ezáltal rengeteg CPU időt és lemezműveletet takaríthatunk meg. Az archív metrikákat átvittük a már meglévő Clickhouse klaszterekre:
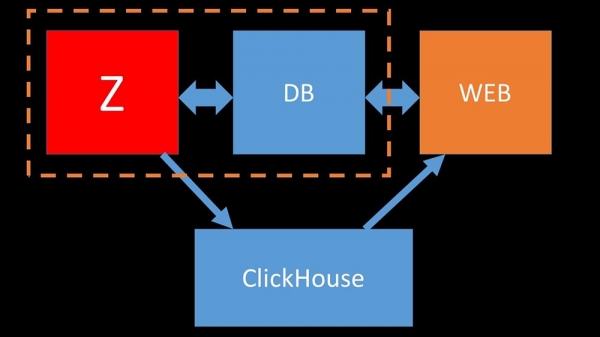
Annyira tehermentesítettük a fő MySQL adatbázist, hogy egy gépen egyesíthettük a Zabbix szerverrel, és lemondhattunk a MySQL-hez fenntartott dedikált szerverről.
Hogyan működik a polling a Zabbixban?
4 hónapja
MM: – Nos, a felmerült adatbázis problémákról végre megfeledkezhetünk?
MCS: – Ez pontosan így van! A másik feladat, amelyet meg kell oldanunk, az az adatgyűjtés lassúsága. Jelenleg mind a 15 proxy szerverünk túlterhelt az SNMP és pollingen végzett folyamatokkal. Nincs más megoldás, mint újabb és újabb szerverek telepítése.
MM: – Nagyszerű. De először mesélj, hogyan működik a polling a Zabbixban?
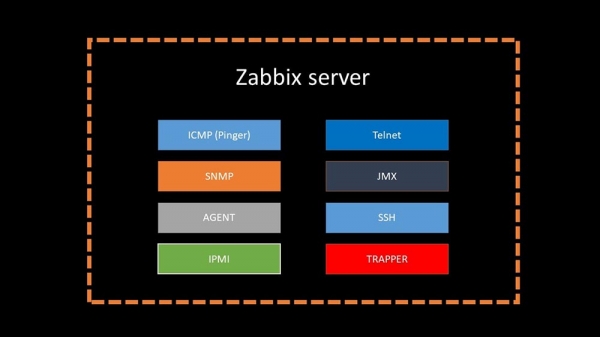
MCS: – Röviden, 20 típusú metrika létezik és tucatnyi módja van ezek megszerzésének. A Zabbix képes adatokat gyűjteni vagy kérés-válasz módban, vagy várhat új adatokat a Trapper interfészen keresztül.
Érdemes megjegyezni, hogy az eredeti Zabbixben ez a módszer (Trapper) a leggyorsabb.
Vannak proxy szerverek a terhelés elosztására:
A proxik ugyanazokat a gyűjtési funkciókat tudják ellátni, mint a Zabbix szerver, azaz feladatokat kapnak tőle és az összegyűjtött metrikákat a Trapper interfészen keresztül küldik vissza. Ez a hivatalosan ajánlott módszer a terhelés elosztására. A proxik hasznosak a távoli infrastruktúra monitorozásakor is, amely NAT-on keresztül vagy lassú kapcsolaton működik:
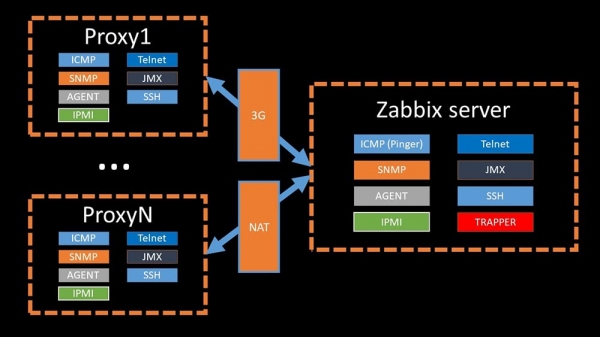
MM: – Az architektúra világos. Meg kell néznünk a forrást…
Pár nappal később
A mese arról, hogyan győzött az nmap fping
MM: – Úgy tűnik, valamit találtam.
MCS: – Mesélj!
MM: – Felfedeztem, hogy a Zabbix elérhetőség-ellenőrzése maximum 128 hosztot ellenőriz egyszerre. Megpróbáltam ezt a számot 500-ra növelni és eltávolítottam a ping közötti késleltetést – ez körülbelül duplájára növelte a teljesítményt. De szeretnék még nagyobb számokat.
MCS: – A gyakorlatomban néha ezer hoszt elérhetőségének ellenőrzésére van szükségem, és semmi gyorsabbat nem találtam, mint az nmap. Biztos vagyok benne, hogy ez a leggyorsabb módszer. Próbáljuk ki! Jelentősen növelnünk kell a hosztok számát egy iterációban.
MM: – Több mint ötszázat ellenőrizni? 600?
MCS: – Legalább pár ezer.
MM: – Rendben. A legfontosabb, amit el akartam mondani: felfedeztem, hogy a Zabbix legtöbb pollingja szinkron módon történik. Feltétlenül át kell alakítanunk aszinkron módra. Akkor drasztikusan növelhetjük a pollerek által gyűjtött metrikák számát, különösen, ha növeljük a metrikák számát egy iterációban.
MCS: – Nagyszerű! És mikor?
MM: – Mint mindig, tegnap.
MCS: – Összehasonlítottuk az fping és az nmap két verzióját:
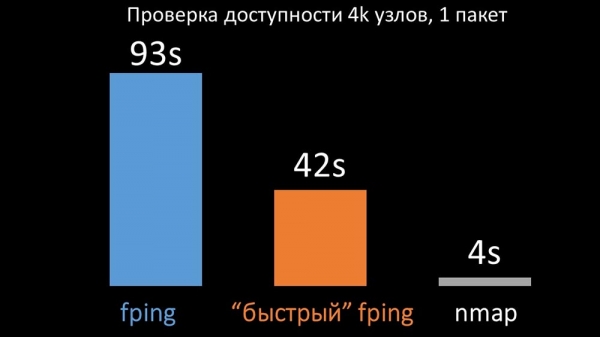
Számos hoszten az nmap várhatóan akár ötödével is hatékonyabb volt. Mivel az nmap csak a hozzáférhetőség tényét és a válaszidőt ellenőrzi, a veszteségek számítását áthelyeztük a triggerekkel, és jelentősen csökkentettük a hozzáférhetőség ellenőrzésének intervallumait. Az nmap optimális hosztszámát egy iterációnként körülbelül 4000 körüli értékben határoztuk meg. Az nmap segítségével háromszorosára csökkentettük a CPU-költségeket a hozzáférhetőség ellenőrzése során, és az intervallumot 120 másodpercről 10 másodpercre csökkentettük.
A polling optimalizálása
MM: – Ezután a pollerekkel foglalkoztunk. Elsősorban az SNMP-lekérdezések és az ügynökök érdekeltek minket. A "Zabbix"-ban a polling szinkron módon történik, és külön intézkedéseket vezettek be a rendszer hatékonyságának növelése érdekében. Szinkron üzemmódban a hosztok nem elérhetősége jelentős romlást okoz a pollingban. Egy teljes állapot rendszert alkalmaznak, és külön folyamatok is léteznek – úgynevezett unreachable-pollerek, amelyek csak a nem elérhető hosztokkal foglalkoznak:

Ez egy megjegyzés, amely bemutatja az állapotok mátrixát, és azt a komplexitást, amely a rendszer hatékonyságának fenntartásához szükséges átmenetekből fakad. Ezenkívül a szinkron polling önmagában is viszonylag lassú:
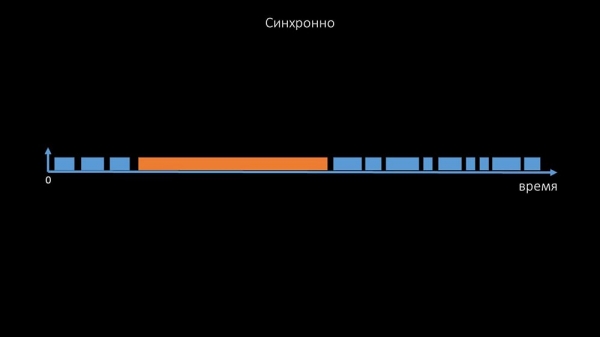
Ezért több ezer poller a tucatnyi proxyval nem tudta összegyűjteni a szükséges mennyiségű adatot. Az aszinkron megvalósítás nemcsak a szálak számával kapcsolatos problémákat oldotta meg, hanem jelentősen leegyszerűsítette a nem elérhető hosztok állapotainak rendszerét is, mivel bármennyi hoszt ellenőrzése során a maximális várakozási idő 1 időtúllépés volt:
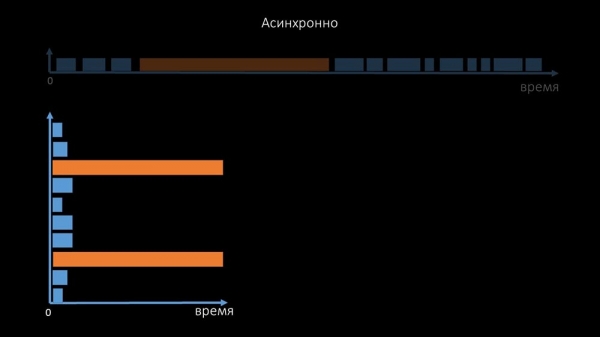
Emellett módosítottuk és továbbfejlesztettük az SNMP-lekérdezések polling rendszerét. Az a helyzet, hogy a legtöbb rendszer nem tud egyszerre több SNMP-lekérdezésre válaszolni. Ezért bevezettünk egy hibrid üzemmódot, ahol a ugyanannak a hosztnak az SNMP-pollingja aszinkron módon történik:
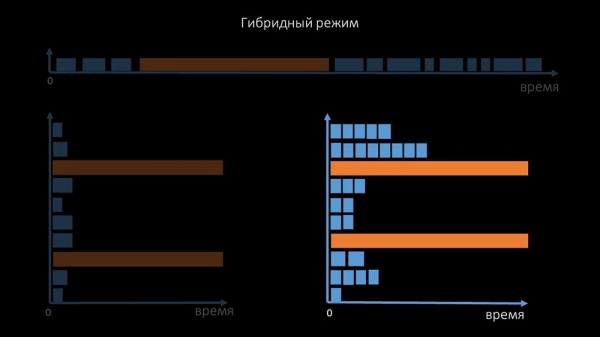
Ez minden hosztcsoportra vonatkozik. Ez az üzemmód végül nem lassabb, mint a teljes mértékben aszinkron, mivel másfél száz SNMP-érték lekérdezése így is sokkal gyorsabb, mint 1 időtúllépés.
Kísérleteink azt mutatták, hogy az optimális lekérdezési szám egy iteráción belül körülbelül 8000 az SNMP-polling során. Az aszinkron módra való átállás összességében 200-szorosára gyorsította a polling teljesítményét, több százszorosára.
MCS: A kapott polling optimalizálások azt mutatták, hogy nemcsak megszabadulhatunk az összes proxy-tól, hanem sok ellenőrzés intervallumait is lerövidíthetjük, a proxy-kra pedig már nincs szükség mint terhelésmegosztási módszer.
Körülbelül három hónappal ezelőtt
Változtasd meg az architektúrát – növeld a terhelést!
MM: – Nos, Max, itt az ideje a termelésnek? Szükségem van egy erős szerverre és egy jó mérnökre.
MCS: – Rendben, tervezzünk! Itt az ideje végre lépni a 5000 metrika/másodperces holtpontból.
A reggel az frissítés után
MCS: – Misha, frissítettünk, de reggelre visszaálltunk… Találd ki, milyen sebességet sikerült elérni?
MM: – Maximum 20 ezer.
MCS: – Igen, 25! Sajnos ugyanott vagyunk, ahonnan indultunk.
MM: – Miért van ez? Készítettetek diagnosztikát?
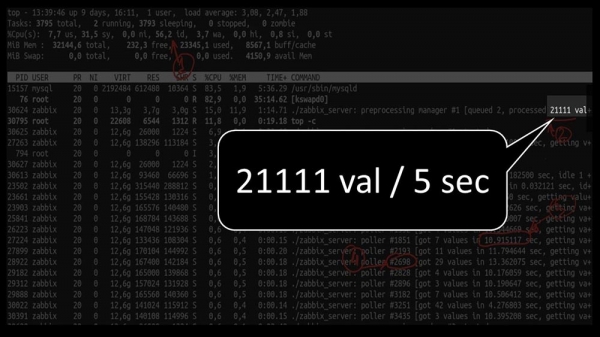
MCS: – Igen, természetesen! Íme, például egy érdekes top:
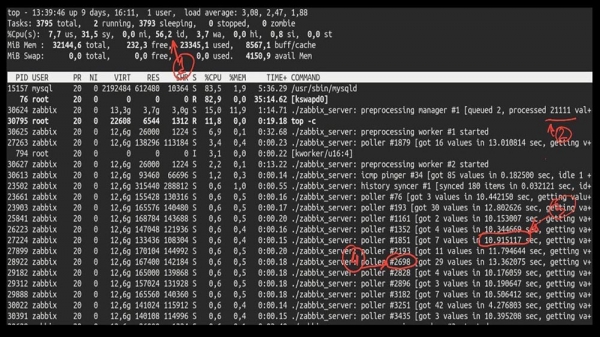
MM: – Nézzük meg. Látom, hogy hatalmas mennyiségű polling szálat próbáltunk:
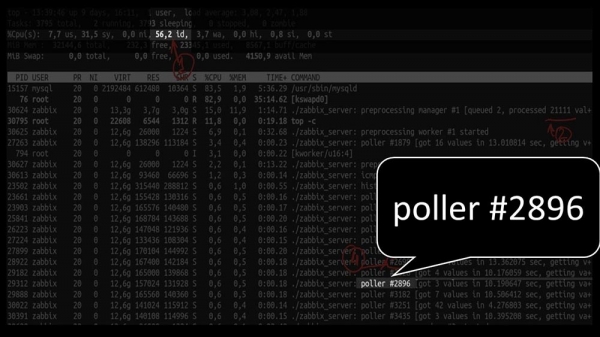
De még így sem tudtuk a rendszert a fele kapacitásig se kihasználni:
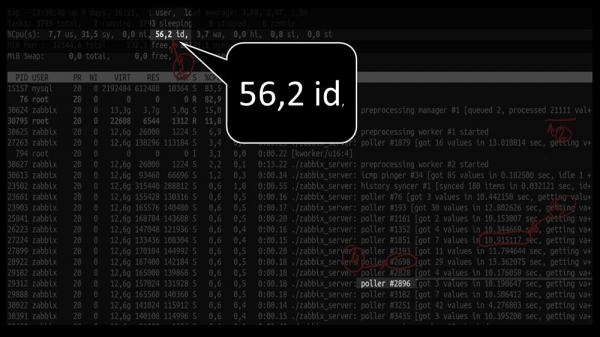
A teljesítmény viszont meglehetősen alacsony, körülbelül 4000 metrika/másodperc:
Van valami más?
MCS: – Igen, az egyik poller strace:
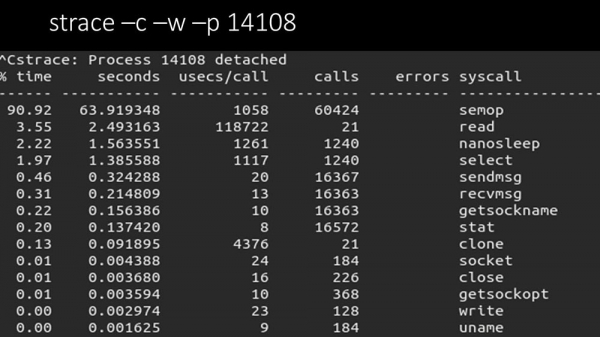
MM: – Itt világosan látszik, hogy a polling folyamat „semaphore”-ra vár. Ezek blokkolások:
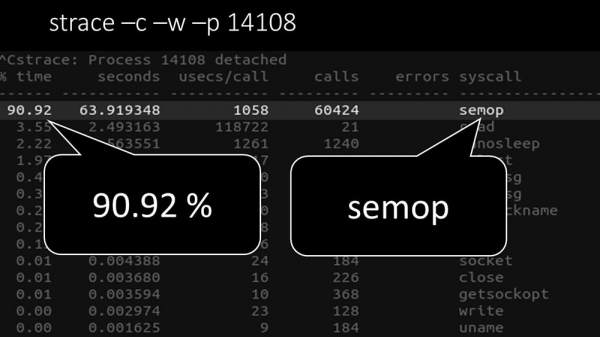
MCS: – Nem világos.
MM: – Nézd, ez inkább olyan helyzetnek tűnik, amikor sok szál próbál egy olyan erőforrással dolgozni, amelyhez egyszerre csak egyetlen egy férhet hozzá. Akkor mindaz, amit tehetnek, az az erőforrás időbeli megosztása:
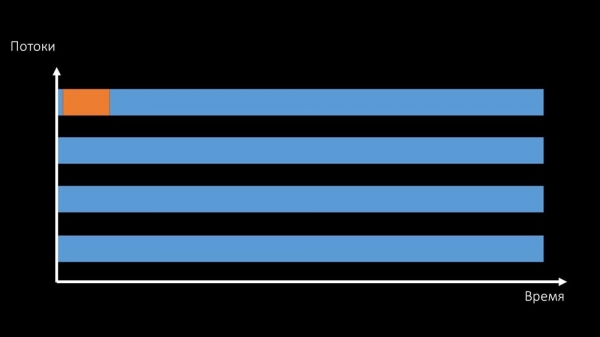
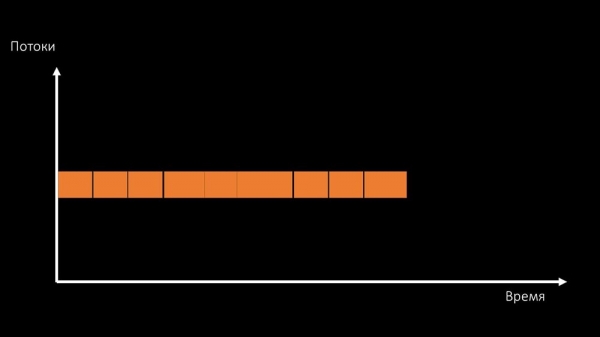
És az ilyen erőforrással való munka összesített teljesítménye egy mag sebességére korlátozódik:
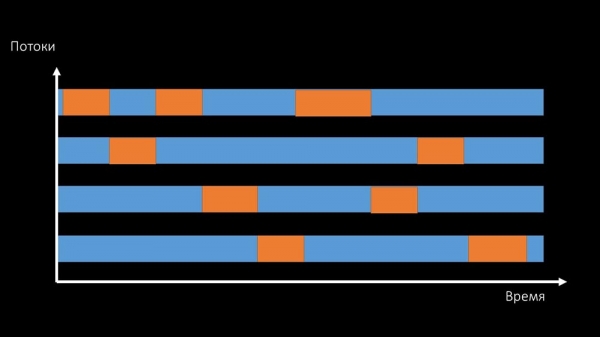
Ez a probléma két módon megoldható.
Felkészítheted a gép hardverét és áttérhetsz gyorsabb magokra:
Vagy megváltoztathatod az architektúrát és párhuzamosan – a terhelést:
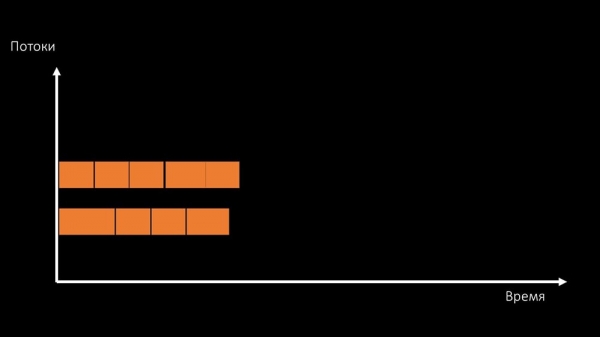
MCS: – A tesztgépen kevesebb magot használunk, mint a termelőn, de ezek 1,5-ször gyorsabbak a magfrekvenciában!
MM: – Érthető? Meg kell néznünk a szerver kódját.
Adatok útja a Zabbix szerveren
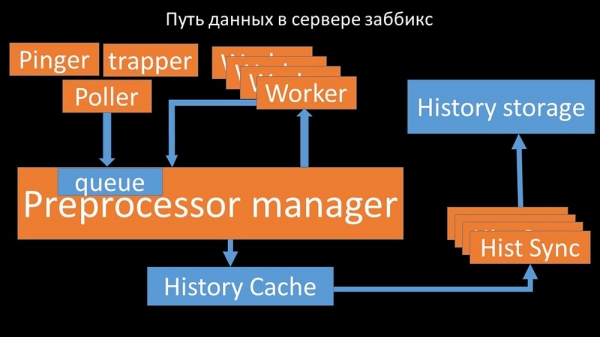
MCS: – Azért, hogy megértsük, elkezdtük elemezni, hogyan történik az adatok továbbítása a Zabbix szerveren belül:
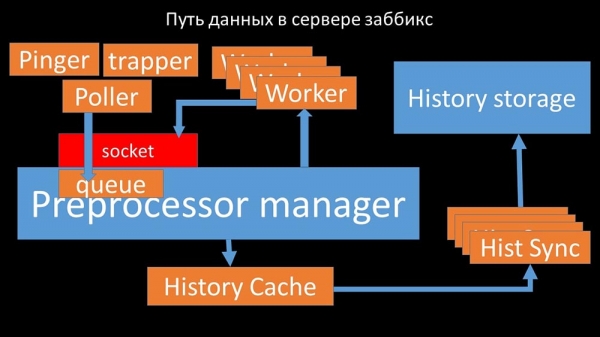
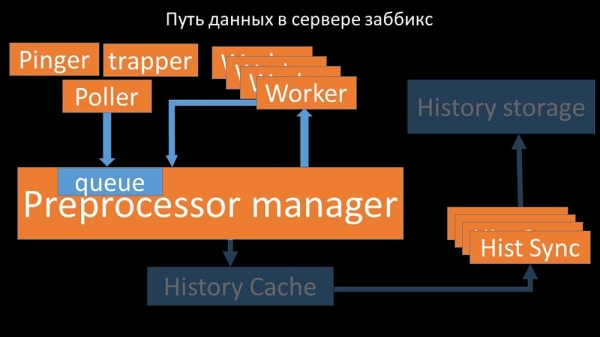
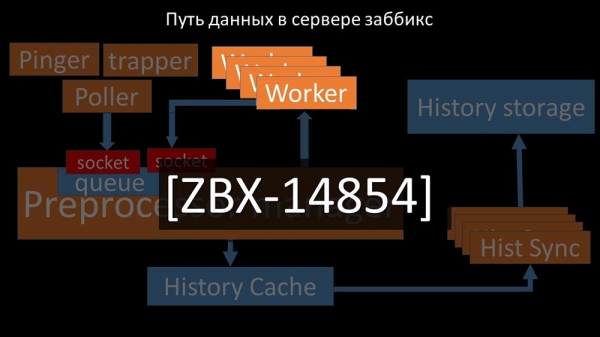
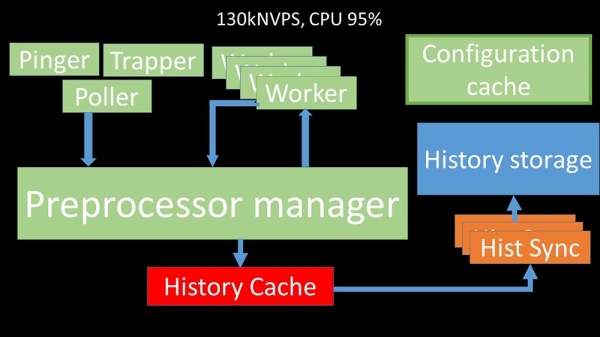
Nagyszerű kép, igaz? Nézzük meg lépésről lépésre, hogy nagyjából tisztában legyünk vele. Vannak szálak és szolgáltatások, amelyek felelősek az adatok gyűjtéséért:
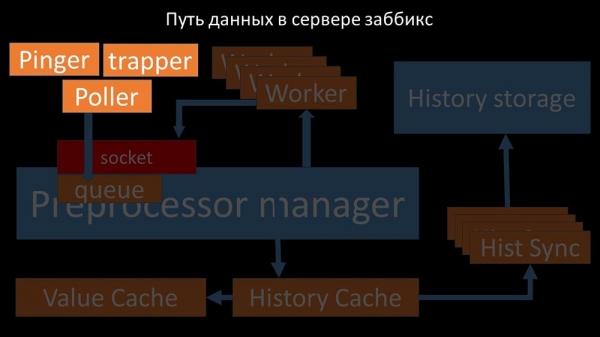
A begyűjtött metrikákat socketen keresztül továbbítják a Preprocessor manager-hez, ahol sorba kerülnek:
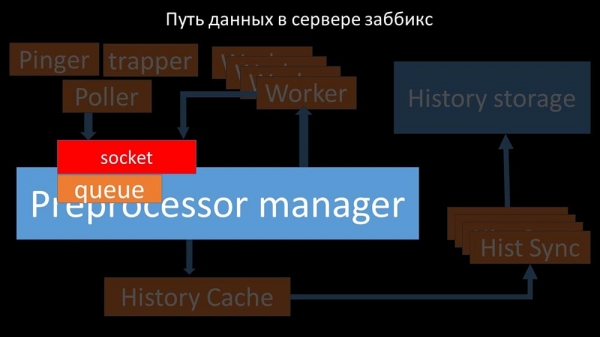
A „Preprocessor manager” továbbítja az adatokat a munkásainak, akik végrehajtják az előfeldolgozási utasításokat és ugyanazon a socketen keresztül visszaküldik.
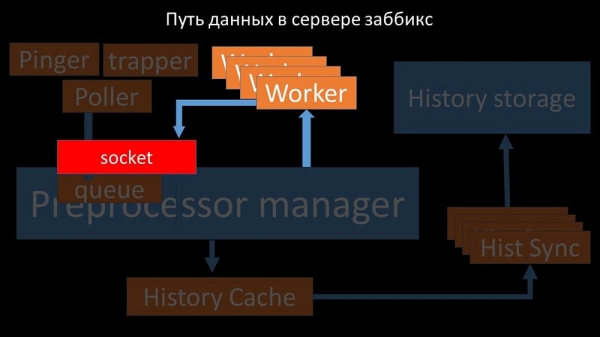
Ezután a preprocessor menedzser tárolja őket a történeti gyorsítótárban:
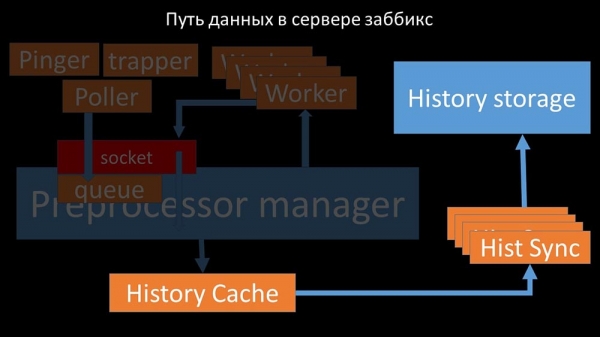
Onnan veszik a hítori szinkronizálók, amelyek számos funkciót látnak el: például trigger kiszámítása, értékek gyorsítótárba töltése, és ami a legfontosabb, metrikák mentése a történeti tárolóba. Összességében a folyamat bonyolult és meglehetősen zavaros.
MM: – Az első dolog, amit láttunk, hogy a legtöbb szál a úgynevezett "konfigurációs gyorsítótár" (memória terület, ahol az összes szerverkonfiguráció tárolódik) megszerzéséért versenyez. Különösen sok zárolás történik az adatok kinyeréséért felelős szálak miatt:
…mivel a konfigurációban nemcsak a metrikák tárolódnak a paramétereikkel, hanem azok a sorok is, ahonnan a pollerek értesítést kapnak arról, hogy mi lesz a következő lépés. Amikor sok poller van, és az egyik zárolja a konfigurációt, a többiek várják a kérdéseket:
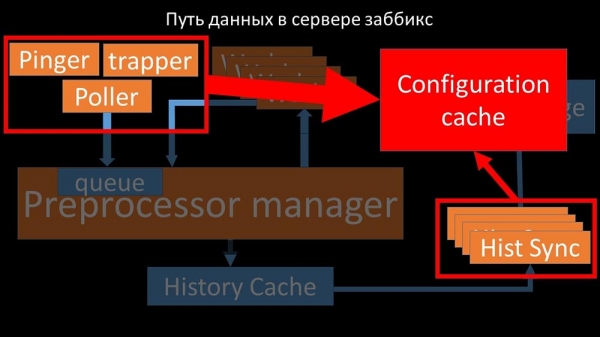
A pollereknek nem szabad konfliktusba kerülnie
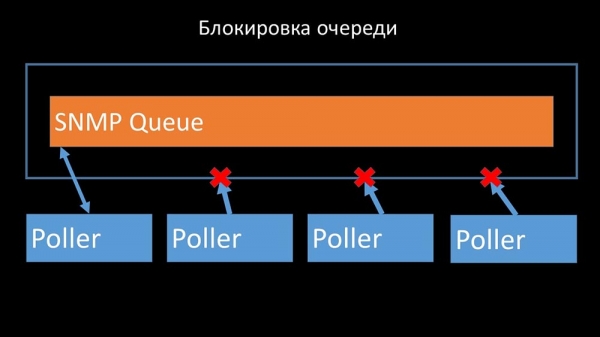
Ezért az első dolog, amit tettünk, az volt, hogy a sort 4 részre osztottuk, és biztonságos körülmények között engedélyeztük a pollereknek, hogy egyszerre zárolják ezeket a részeket:
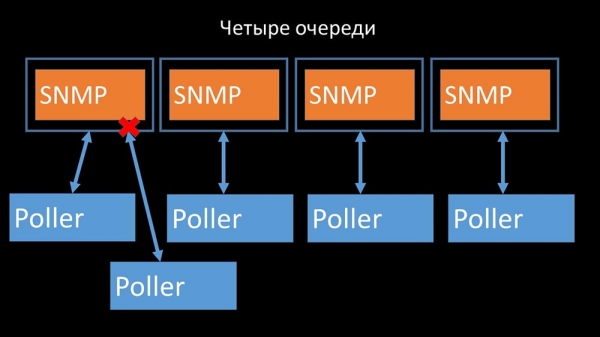
Ez megszüntette a versenyt a konfigurációs gyorsítótárért, és a pollerek munkagyorsasága jelentősen megnőtt. De aztán szembesültünk azzal, hogy a preprocessor menedzser elkezdte felhalmozni a feladatok sorát:
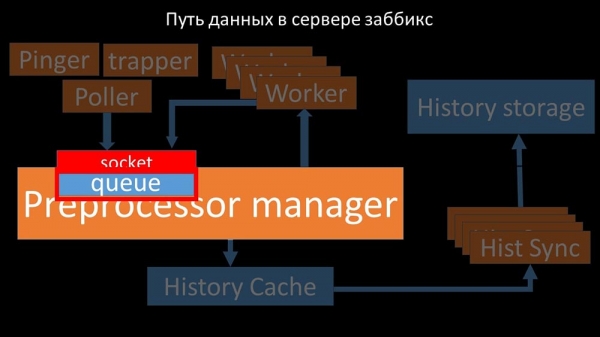
A preprocessor menedzsernek képesnek kell lennie prioritásokat felállítani
Ez azokban az esetekben történt, amikor hiányzott a teljesítmény. Akkor minden, amit tehetett – a gyűjtő folyamatoktól érkező kéréseket halmozni és felhalmozni a pufferbe, amíg az el nem érte az összes memóriát, és összeomlott:
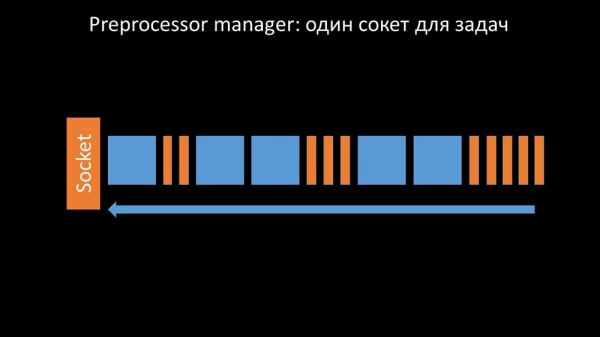
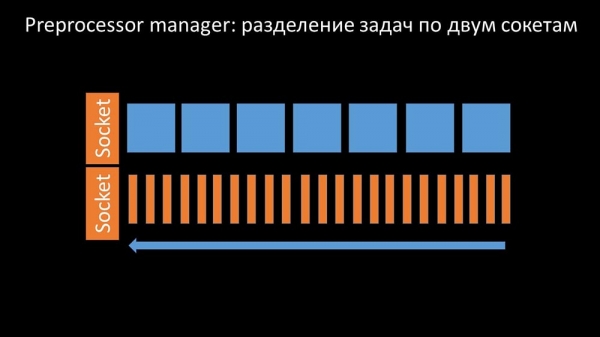
A probléma megoldására hozzáadtunk egy második socketet, amelyet kifejezetten a munkások számára szántunk:
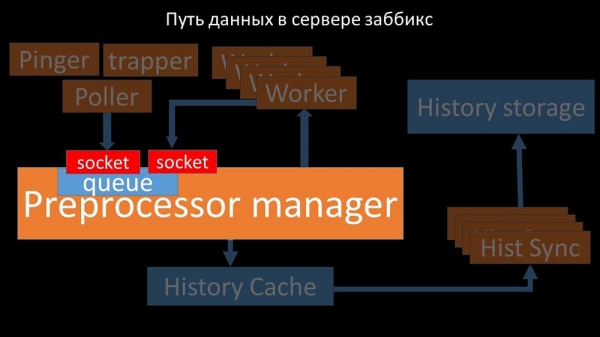
Ezzel a preprocessor menedzsernek lehetősége nyílt a feladat prioritásának megállapítására, és ha a puffer növekedett, a feladat lelassította a kinyerést, lehetőséget adva a munkásoknak, hogy elvegyék ezt a puffert:
Ezután felfedeztük, hogy az egyik ok, amiért lelassult a teljesítmény, maguk a munkások voltak, mivel versenyeztek egy teljesen lényegtelen erőforrásért a működésükhöz. Ezt a problémát bug-fixként rögzítettük, és az új "Zabbix" verziókban már megoldották:
A socketek számának növelésével – eredményt kapunk
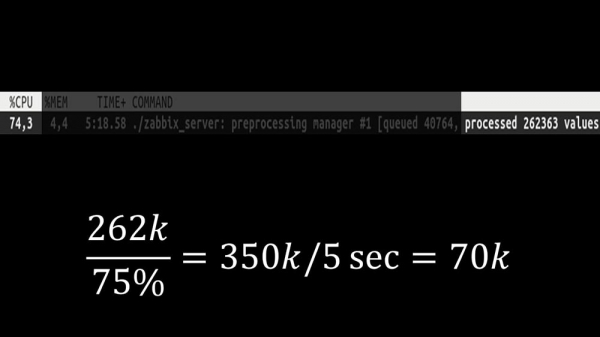
Ezt követően a preprocessor menedzser lett a szűk keresztmetszet, mivel ez egy szál. A mag sebességébe ütközött, maximálisan körülbelül 70 ezer metrikát tudott másodpercenként kezelni:
Ezért négyet készítettünk, négy szettel és munkásokkal:
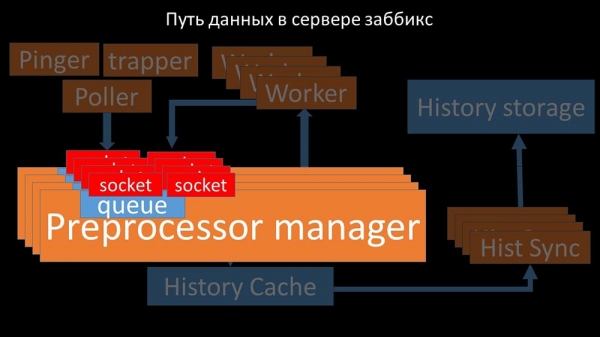
Ez lehetővé tette, hogy a sebesség körülbelül 130 ezer metrikáig emelkedjen:
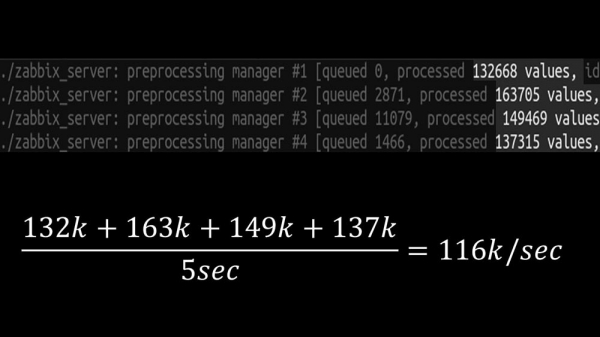
A növekedés nemlineáris volt, mivel verseny alakult ki a történet cache-ért. Négy előfeldolgozó menedzser és történet-szinkronizáló versengett érte. Ekkorra a tesztgépünk körülbelül 130 ezer metrikát tudott produkálni másodpercenként, a processzorunk körülbelül 95%-át kihasználva:
Körülbelül 2,5 hónappal ezelőtt
Az snmp-community elhagyása másfél szorosára növelte az NVP-ket
MM: – Max, szükségem van egy új tesztgép! A jelenlegi már nem bír el minket.
MCS: – Mi van most?
MM: – Jelenleg – 130k NVP és a processzor "a polcon".
MCS: – Wow! Szuper! Várj, kettő kérdésem van. A számításaim szerint a szükségletünk körülbelül 15-20 ezer metrikára van másodpercenként. Miért van szükségünk többre?
MM: – Szeretném a dolgot végleg befejezni. Szeretném látni, mennyit tudunk kihozni ebből a rendszerből.
MCS: – De…
MM: – De ez a vállalatnak haszontalan.
MCS: – Értem. És a második kérdés: amit most van, azt tudjuk tartani magunknak, fejlesztő segítsége nélkül?
MM: – Nem hiszem. A konfigurációs cache-sel való munka megváltoztatása probléma. Ez a legtöbb folyamatban változásokkal jár, és elég nehezen karbantartható. Valószínűleg nagyon nehéz lesz fenntartani.
MCS: – Akkor szükség van valamilyen alternatívára.
MM: – Van egy lehetőség. Át tudunk térni a gyors magokra, úgy, hogy lemondunk az új zárolási rendszerről. Így is 60-80 ezer metrikát fogunk produkálni. Ezen kívül az összes többi kódot megőrizzük. A ClickHouse, az aszinkron polling működni fog. És ezt könnyű lesz karbantartani.
MCS: – Csodás! Javaslom, hogy ezen álljunk meg.
A szerveroldali optimalizálás után végre sikerült az új kódot bevezetni a termelésbe. Néhány változtatást elhagytunk az átállás érdekében a gyors magokra, minimalizálva a kódmódosításokat. Ezenkívül egyszerűsítettük a konfigurációt, és ahol lehetett, lemondtunk a makrókról az adatelemekben, mivel ezek további zárolások forrása volt.
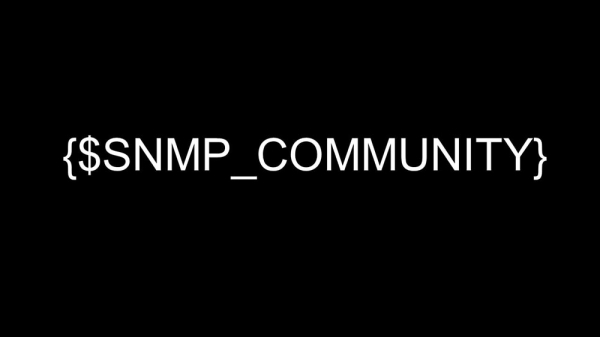
Például az snmp-community makró elhagyása, ami gyakori a dokumentációban és a példákban, a mi esetünkben körülbelül másfél szeres gyorsulást eredményezett az NVP-k számára.
Két nap után a termelésben
Eltávolítjuk az incidenstörténetek felugró ablakait
MCS: – Misi, már két napja használjuk a rendszert, és minden működik. De csak akkor, amikor minden rendben van! Volt egy tervezett karbantartásunk, amely során egy elég nagy hálózati szegmenst kellett áttelepítenünk, és ismét manuálisan ellenőriztük, hogy mi működik és mi nem.
MM: – Ez nem lehet igaz! Tízszer ellenőriztük mindent. A szerver még a teljes hálózati elérhetetlenséget is azonnal feldolgozza.
MCS: – Én mindent értek: a szerver, az adatbázis, a top, az austat, a logok – minden gyors… De mi a webes felületet nézzük, és ott van a processzor „szünet” a szerveren és ez a dolog:
MM: – Értem. Nézzük a webet. Felfedeztük, hogy abban az esetben, ha sok aktív incidens volt, a legtöbb operatív widget nagyon lassan kezdett működni:
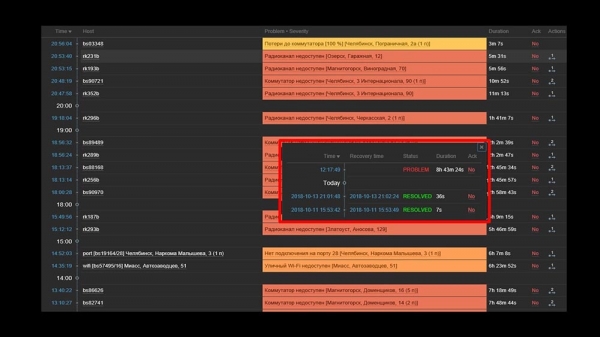
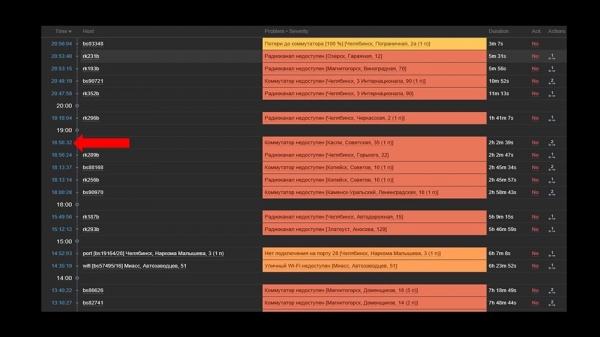
Ennek az oka az incidens történetekkel kapcsolatos felugró ablakok generálása volt, amelyek minden egyes elemhez készülnek a listában. Ezért lemondtunk ezen ablakok generálásáról (5 sort kommenteztünk ki a kódban), és ez megoldotta a problémáinkat.
A widgetek betöltési ideje, még teljes elérhetetlenség esetén is, néhány percről a számunkra megengedett 10-15 másodpercre csökkent, és a történetet továbbra is egy időpontra kattintva lehet megtekinteni:
Munka után. 2 hónappal ezelőtt
MCS: – Misi, mész? Van egy beszélgetésem.
MM: – Nem akartam. Megint valami a „Zabbix”-szal?
MCS: – Dehogy, lazíts! Csak azt akartam mondani: minden működik, köszi! Tőlem sör jár.
A Zabbix hatékony
A „Zabbix” egy meglehetősen univerzális és gazdag rendszer és funkció. Teljesen használható kis telepítésekhez „dobozból”, de a növekvő igények miatt azt optimalizálni kell. Nagy mennyiségű metrikák tárolásához megfelelő tárolót használj:
- felhasználhatod a beépített eszközöket az „Elasticsearch” integrációjaként vagy a történelem szöveges fájlokba való exportálásával (elérhető a negyedik verziótól);
- felhasználhatod a tapasztalatainkat és az „ClickHouse” integrációt.
A metrikák gyűjtési sebességének radikális növeléséhez aszinkron módszerekkel gyűjtsd őket, és továbbítsd őket a Zabbix-szerver trap-interface-en keresztül; vagy használhatsz patch-et a Zabbix pollerek aszinkron működéséhez.
A «Zabbix» C nyelven íródott, és meglehetősen hatékony. Néhány szűk architektúrájú megoldás lehetőséget ad a teljesítmény további növelésére, és tapasztalataink szerint több mint 100 ezer metrikát tudunk begyűjteni egy egyprocesszoros gépen.
Ez az a Zabbix folt
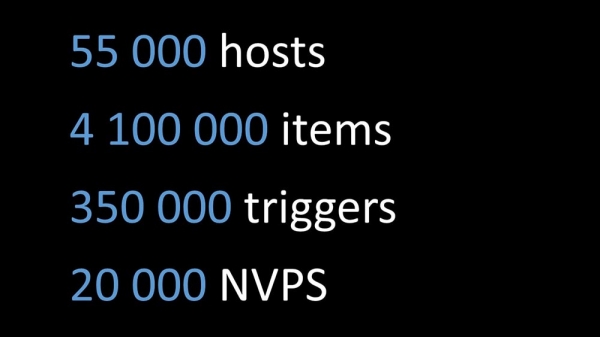
MM: – Szeretnék hozzátenni pár dolgot. Az összes jelenlegi jelentés, minden teszt és szám arra a konfigurációra vonatkozik, amelyet mi használunk. Jelenleg körülbelül 20 ezer metrikát gyűjtünk másodpercenként. Ha próbálja megérteni, hogy ez önöknél működne-e, hasonlítsa össze. Amit ma bemutattunk, GitHub-on érhető el foltként:
A folt tartalmazza:
- teljes integráció a «Clickhouse»-szal (mind a «Zabbix» szerverek, mind a frontend számára);
- problémák megoldása a preprocesszor-vezetővel;
- aszinkrón pollezés.
A folt kompatibilis a 4-es verzióval, beleértve az lts-t is. Valószínűleg minimális változtatásokkal működni fog a 3.4-es verzióval is.
Köszönöm a figyelmet.
Kérdések
Kérdés a közönségből (továbbiakban – K): – Jó napot! Mondja meg kérem, van-e terve az intenzív együttműködésre a Zabbix csapattal, vagy ők önökkel, hogy ez ne csak folt legyen, hanem a «Zabbix» normális működése?
MM: – Igen, a változások egy részét mindenképpen elkötelezzük. Lesz, ami foltban marad.
A: – Nagyon köszönöm a nagyszerű előadást! Mondja meg kérem, a folt alkalmazása után a «Zabbix»-tól milyen támogatás marad, és hogyan lehet tovább frissíteni a magasabb verziókra? Lesz lehetőség frissíteni a «Zabbix»-t az önök foltjával 4.2-re, 5.0-ra?
MM: – A támogatásról nem tudok nyilatkozni. Ha én lennék a «Zabbix» technikai támogatása, akkor valószínűleg azt mondanám, hogy nem, mert ez idegen kód. Ami a 4.2-es kód alapját illeti, a mi álláspontunk a következő: „Követni fogjuk az időt, és magunk is frissülni fogunk a következő verzióra”. Ezért egy ideig ki fogjuk adni a frissített verziókhoz tartozó foltot. Már említettem az előadásomban: a verziók közti változások eddig meglehetősen csekélyek. Úgy gondolom, hogy a 3.4-ről 4-re való áttérés körülbelül 15 percet vett igénybe. Ott valami megváltozott, de nem túl lényeges.
A: – Tehát tervezik a folt támogatását, és biztonságosan telepíthető éles környezetbe, a további frissítések megszerzése mellett?
MM: – Ezt kategorikusan javasoljuk. Számos problémánkat megoldja.
MCS: – Még egyszer szeretném hangsúlyozni, hogy a módosítások, amelyek nem érintik az architektúrát és nem kapcsolódnak a blokkolásokhoz vagy sorokhoz – modulárisak, és külön modulokban találhatók. Még kisebb módosítások esetén is elég könnyen karbantarthatók.
MM: – Ha érdeklik a részletek, a "ClickHouse" a történeti könyvtár nevű könyvtárat használja. Ez laza kapcsolatban van – ez az "Elasticsearch" támogatásának másolata, tehát konfigurálható. A polling csak a pollereket változtatja meg. Úgy gondoljuk, hogy hosszú ideig működni fog.
A: – Nagyon köszönöm. Tudna esetleg információt adni a végrehajtott módosításokról készült dokumentációról?
MM: – A dokumentáció egy javítás. Nyilvánvaló, hogy a "ClickHouse" bevezetésével, új típusú pollerek bevezetésével új konfigurációs opciók jelennek meg. Az utolsó dián található linken rövid leírás van arról, hogyan használja ezt.
Az fping nmap-ra való cseréjéről
A: – Végül hogyan valósították ezt meg? Tudna konkrét példákat mondani: az önök esetében ez strap-on és külső szkript? Mi ellenőrzi ilyen gyorsan ennyi hosztot? Hogyan szerzik ezeket a hosztokat? Az nmap-nak valahogy meg kell adni őket, valahonnan megkapni, elhelyezni, valamit elindítani?..
MM: – Szuper. Nagyon helyes kérdés! A lényeg a következő: módosítottuk a könyvtárat (ICMP ping, a "Zabbix" része) az ICMP ellenőrzésekhez, ahol a csomagok száma - egy (1) - és a kód próbálja használni az nmap-et. Ez a "Zabbix" belső munkája lett, a pinger belső munkájává vált. Ennek megfelelően nincs szükség szinkronizációra vagy trap használatra. Ezt szándékosan tettük, hogy a rendszert érintetlenül tartsuk, és ne foglalkozzunk a két rendszer adatbázisának szinkronizálásával: mit ellenőrizzünk, mit töltsünk be a polleren keresztül, és hogy nem sérült-e a betöltés?.. Ez sokkal egyszerűbb.
A: – Ez a proxyra is működik?
MM: – Igen, de ezt nem ellenőriztük. A polling kódja mind a "Zabbix"-ban, mind a szerveren egységes. Működnie kell. Még egyszer hangsúlyozom: a rendszer teljesítménye olyan, hogy nekünk proxyra nincs szükségünk.
MCS: – A helyes kérdés erre a következőt mondja: "Miért van szüksége proxy-ra egy ilyen rendszer esetén?" Csak a NAT miatt vagy valamilyen lassú kapcsolaton keresztül monitorozni...
A: – Ön a "Zabbix"-ot használja riasztásra, ha jól értettem. Vagy a grafikonok (ahol az archív réteg van) egy másik rendszerbe, például a Grafanába költöztek? Vagy nem használja ezt a funkciót?
MM: – Még egyszer hangsúlyozom: teljes integrációt valósítottunk meg. A history-t a „Clickhouse”-ba öntjük, de eközben megváltoztattuk a PHP frontendet. A PHP frontend a „Clickhouse”-hoz való átkéréseket végez, és onnan készíti el az összes grafikonunkat. Amennyire őszinte tudok lenni, van egy részünk, amely a „Clickhouse”-ból és a „Zabbix” azon adataiból készít adatokat más grafikonábrázoló rendszerekhez.
MCS: – A „Grafanában” is.
Hogyan született a döntés a források allokálásáról?
A: – Kérlek, oszd meg egy kicsit a belső folyamatokat. Hogyan született a döntés, hogy forrásokat kell allokálni a termék jelentős átalakítására? Ez egy bizonyos kockázatot rejteget. És kérlek, mondjátok el, hogy a frissített verziók támogatásának fényében: hogyan indokolható ez a döntés a menedzsment szempontjából?
MM: – Valószínűleg nem meséltük el jól a történet drámáját. Abban a helyzetben voltunk, hogy valamit tennünk kellett, és lényegében két párhuzamos csapat fele mentünk:
- Az egyik a monitorozási rendszer új módszerekkel történő bevezetésével foglalkozott: monitorozás mint szolgáltatás, különböző nyílt forráskódú megoldások, amelyeket kombinálunk, majd megpróbáljuk átalakítani az üzleti folyamatot, hogy működni tudjunk az új monitorozási rendszerrel.
- Párhuzamosan volt egy lelkes programozó, aki ezzel foglalkozott (magáról). Így alakult, hogy ő győzött.
A: – Mekkora a csapat létszáma?
MCS: – Önök előtt áll.
A: – Tehát, mint mindig, szükség van egy szenvedélyes emberre?
MM: – Nem tudom, mi az a szenvedélyes ember.
A: – Ebben az esetben valószínűleg te. Nagyon köszönöm, ti nagyszerűek vagytok.
MM: – Köszönöm.
A Zabbix patch-ekről
A: – Egy olyan rendszer esetében, amely proxykat használ (például egyes elosztott rendszerekben), lehetséges az Önök megoldásának alkalmazása és patch-elése például a pollereknek, proxyknak és részben a „Zabbix” előfeldolgozójának; és ezek kölcsönhatásának? Lehetőség van a meglévő megoldások optimalizálására egy több proxyval rendelkező rendszerhez?
MM: – Tudom, hogy a „Zabbix” szerver proxy segítségével épül fel (kompilálódik és kapja a kódot). Ezt nem teszteltük termelésben. Nem vagyok benne biztos, de úgy gondolom, hogy az előfeldolgozó-igazgató nem használható proxyban. A proxy feladata egy készlet metrikiát venni a „Zabbix”-tól, feldolgozni őket (őt magát is a konfiguráció, lokális adatbázis rögzítése közben) és visszaadni a „Zabbix” szervernek. Az előfeldolgozást később maga a szerver végzi el, amikor megkapja.
A proxy piques interest. We'll check it out. It's an intriguing topic.
A: – The idea was this: if you can patch pollers, you can patch them to work with proxies and adapt the preprocessor for these purposes only on the server.
MM: – I think it's even simpler. You take the code, apply the patch, then configure it as needed – collect proxy servers (for example, with ODBC) and distribute the patched code across systems. Where needed, you assemble proxies, where needed, a server.
A: – You probably won't need to additionally patch the proxy transmission to the server?
MCS: – No, it's standard.
MM: – In fact, one of the ideas wasn't voiced. We've always maintained a balance between an explosion of ideas and the number of changes, as well as ease of maintenance.
Egy kis reklám 🙂
Köszönjük, hogy velünk maradtál. Tetszenek a cikkeink? Szeretnél több érdekes anyagot látni? Támogass minket, és rendelés leadásával vagy ismerősöknek ajánlással segíts nekünk. , Egyedülálló alternatívája az entry-level szervereknek, amelyet Önnek találtunk ki: (elérhetők RAID1 és RAID10 opciók, akár 24 magig és 40GB DDR4-ig).
Dell R730xd kétszer olcsóbban a Tier IV Equinix adatközpontban Amszterdamban? Csak nálunk Hollandiában! Dell R420 — 2x E5-2430 2.2GHz 6C 128GB DDR3 2x960GB SSD 1Gbps 100TB — 99 dollártól! Olvasd el ezt
Forrás: habr.com
