

Helló, Habr.
Nemrég megosztottam a tapasztalataimat A modern alkalmazások nagyon bonyolult környezetben működnek. Az üzleti logika, amely a modern technológiai stack-be van csomagolva, Docker-képben fut, amelyet olyan orchestrátor irányít, mint a Kubernetes vagy az OpenShift, és más alkalmazásokkal vagy vállalati megoldásokkal kommunikál a fizikai és virtuális routerek láncolatán keresztül. Ilyen környezetben mindig történhet valami hiba, ezért az események újrafeldolgozása a külső rendszerek egyikének elérhetetlensége esetén fontos része üzleti folyamataik.
A Kafka előtt
Korábban a projektben IBM MQ-t használtunk az aszinkron üzenetküldéshez. Ha hiba történt a szolgáltatás működése során, a kapott üzenet helyet cserélhetett a dead-letter-queue (DLQ) számára további kézi elemzés céljából. A DLQ az érkező queue mellett jött létre, az üzenet átkonvertálása az IBM MQ-n belül történt.
Ha a hiba átmeneti volt és ezt meg tudtuk határozni (például ResourceAccessException HTTP-híváskor vagy MongoTimeoutException MongoDb lekérdezésnél), akkor lépett életbe az újrahívási stratégia. Függetlenül az alkalmazás logikájának elágazásától, az eredeti üzenet vagy a rendszerqueue-ba került az elhalasztott küldéshez, vagy egy külön alkalmazásba, amelyet régen készítettek üzenetek újraküldésére. Eközben az üzenet fejlécébe fel lett tüntetve az újraküldések száma, amely a késleltetési intervallumhoz vagy az alkalmazás szintjén lévő stratégia végéhez volt kötve. Ha elértük a stratégia végét, de a külső rendszer még mindig nem elérhető, az üzenet a DLQ-be kerül a kézi elemzéshez.
Megoldás keresése
Interneten keresgélve
. Röviden, azt javasolják, hogy minden késleltetéshez egy topikot hozzanak létre, és az alkalmazás oldalán Consumer-eket implementáljanak, amelyek a szükséges késéssel olvassák el az üzeneteket. .
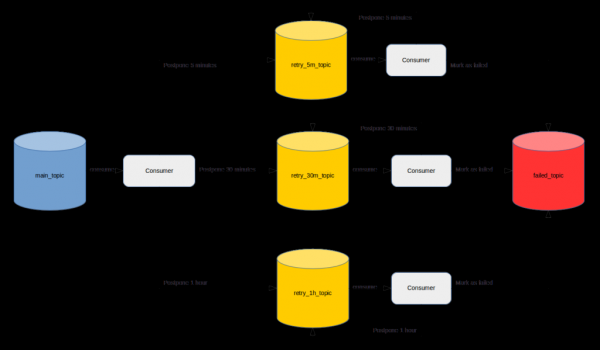
Bár sok pozitív véleményt kaptam, számomra nem tűnik teljesen sikeresnek. Elsősorban azért, mert a fejlesztőnek, a biznisz követelmények megvalósítása mellett, sok időt kell majd fordítania a leírt mechanizmus megvalósítására.
Továbbá, ha a Kafka klaszteren engedélyezve van a hozzáféréskezelés, akkor valamennyi időt el kell tölteni a témák létrehozásával és a szükséges hozzáférések biztosításával. Ezen kívül meg kell találni a megfelelő retention.ms paramétert minden egyes retry-témához, hogy az üzenetek időben újra elküldésre kerülhessenek, és ne tűnjenek el. A hozzáférések megvalósítását és igénylését minden meglévő vagy új szolgáltatás esetén meg kell ismételni.
Nézzük most meg, milyen mechanizmusokat kínál a spring a visszafejlesztéshez általában, és a spring-kafka különösen. A spring-kafka tranzitív függőséget hoz létre a spring-retry-hoz, amely absztrakciókat biztosít a különböző BackOffPolicy kezelésekhez. Ez egy elég rugalmas eszköz, de jelentős hátránya a váró üzenetek memória-alapú tárolása a alkalmazásban. Ez azt jelenti, hogy az alkalmazás újraindítása frissítés vagy hiba miatt elveszíti az összes üzenetet, amely a visszafejlesztésre vár. Mivel ez a pont kritikus a rendszerünk számára, további vizsgálat nélkül elvetettük.
A spring-kafka maga többféle ContainerAwareErrorHandler implementációt kínál, például , amellyel a hiba előfordulása esetén az offset elmozdítása nélkül később kezelhetjük az üzenetet. A spring-kafka 2.3 verziójától lehetőség van a BackOffPolicy beállítására is.
Ez a megközelítés lehetővé teszi, hogy a visszafejlesztett üzenetek túléljék az alkalmazás újraindítását, de a DLQ mechanizmus továbbra is hiányzik. Ezt a lehetőséget választottuk 2019 elején, optimistán abban bízva, hogy a DLQ-ra nincs szükség (szerencsénk volt, és valóban nem volt szükség rá az alkalmazás pár hónapján keresztül üzemeltetési rendszerével). A temporális hibák aktiválták a SeekToCurrentErrorHandler-t. A többi hiba a naplóban jelent meg, offset elmozduláshoz vezetett, és a feldolgozás a következő üzenetnél folytatódott.
A végső döntés
A SeekToCurrentErrorHandler alapú megvalósítás rávett minket, hogy saját mechanizmust fejlesszünk ki az üzenetek újraküldésére.
Elsősorban a meglévő tapasztalatok kihasználására és az alkalmazás logikájától függően a bővítésére törekedtünk. Lineáris logikájú alkalmazás esetén optimális lett volna, ha a hibás üzenetek újraolvasását egy rövid időre leállítjuk, amelyet a visszahívási stratégia keretein belül határoztunk meg. Más alkalmazások esetén szeretnénk egy egységes pontot, amely biztosítja a visszahívási stratégia végrehajtását. Ezen kívül ennek az egységes pontnak DLQ funkcionalitással is rendelkeznie kell mindkét megközelítéshez.
A visszahívási stratégia maga az alkalmazásban kell, hogy tárolódjon, amely felelős a következő időintervallum megszerzéséért, amikor ideiglenes hiba lép fel.
A Consumer megállítása lineáris logikájú alkalmazás esetén
A spring-kafka használata során a Consumer leállításához a kód nagyjából így nézhet ki:
public void pauseListenerContainer(MessageListenerContainer listenerContainer,
                                   Instant retryAt) {
        if (nonNull(retryAt) && listenerContainer.isRunning()) {
            listenerContainer.stop();
            taskScheduler.schedule(() -> listenerContainer.start(), retryAt);
            return;
        }
        // to DLQ
    }
A példában a retryAt az az idő, amikor újra kell indítani a MessageListenerContainer-t, ha még mindig működik. Az újraindítás egy külön szálban történik, amely a TaskScheduler-ben fut, amit a spring is biztosít.
A retryAt értékét a következő módon találjuk meg:
- Megkeressük a visszahívások számát.
- A számláló értéke alapján megkeressük a jelenlegi késleltetési intervallumot a visszahívási stratégiában. A stratégia magában az alkalmazásban van deklarálva, tárolására JSON formátumot választottunk.
- A JSON tömbben talált intervallum tartalmazza azokat a másodperceket, amelyek elteltével újra kell kezdeni a feldolgozást. Ez a másodperc szám hozzáadódik a jelenlegi időhöz, így létrehozva a retryAt értékét.
- Ha az intervallum nem található, a retryAt értéke null lesz, és az üzenet a DLQ-ba kerül a kézi feldolgozás érdekében.
Ezzel a megközelítéssel csak a jelenleg feldolgozás alatt álló üzenetek számának megőrzése marad, például az alkalmazás memóriájában. Az újrapróbálkozási számláló memóriában való tárolása nem kritikus ehhez a megközelítéshez, mivel a lineáris logikával rendelkező alkalmazás nem tudja az egész feldolgozást elvégezni. A spring-retrytől eltérően az alkalmazás újraindítása nem vezet az összes üzenet elvesztéséhez az újrafeldolgozáshoz, hanem csupán a stratégia újraindításához.
Ez a megközelítés segít csökkenteni a külső rendszer terhelését, amely esetleg nem elérhető nagyon nagy terhelés miatt. Más szavakkal, az újrafeldolgozás mellett a mintát is sikerült megvalósítanunk. .
A mi esetünkben a hibaküszöb mindössze 1, és a rendszer állásidőjének minimalizálása érdekében, a hálózati fennakadások ideiglenes volta miatt, nagyon granularis újrapróbálkozási stratégiát alkalmazunk, rövid késleltetési időkkel. Ez nem biztos, hogy minden vállalati alkalmazás számára megfelelő, ezért a hibaküszöb és a késleltetési intervallum arányát a rendszer sajátosságainak figyelembevételével kell meghatározni.
Külön alkalmazás az indeterminisztikus logikájú alkalmazások üzeneteinek feldolgozására.
Itt van egy példa kód, amely üzenetet küld egy olyan alkalmazásba (Retryer), amely újra megpróbálja elküldeni a DESTINATION témába az RETRY_AT idő elérésekor:
public  void retry(ConsumerRecord record, String retryToTopic,
                         Instant retryAt, String counter, String groupId, Exception e) {
        Headers headers = ofNullable(record.headers()).orElse(new RecordHeaders());
        List arrayOfHeaders =
            new ArrayList(Arrays.asList(headers.toArray()));
        updateHeader(arrayOfHeaders, GROUP_ID, groupId::getBytes);
        updateHeader(arrayOfHeaders, DESTINATION, retryToTopic::getBytes);
        updateHeader(arrayOfHeaders, ORIGINAL_PARTITION,
                     () -> Integer.toString(record.partition()).getBytes());
        if (nonNull(retryAt)) {
            updateHeader(arrayOfHeaders, COUNTER, counter::getBytes);
            updateHeader(arrayOfHeaders, SEND_TO, "retry"::getBytes);
            updateHeader(arrayOfHeaders, RETRY_AT, retryAt.toString()::getBytes);
        } else {
            updateHeader(arrayOfHeaders, REASON,
                         ExceptionUtils.getStackTrace(e)::getBytes);
            updateHeader(arrayOfHeaders, SEND_TO, "backout"::getBytes);
        }
        ProducerRecord messageToSend =
            new ProducerRecord(retryTopic, null, null, record.key(), record.value(), arrayOfHeaders);
        kafkaTemplate.send(messageToSend);
    }
A példa alapján látható, hogy sok információt továbbítunk a fejlécben. A RETRY_AT értéke ugyanott van, mint a fogyasztó leállításán keresztül történő újrapróbálkozás mechanizmusánál. A DESTINATION és RETRY_AT mellett továbbítjuk:
- A GROUP_ID-t, amellyel a kézi elemzés és a keresés megkönnyítése érdekében csoportosítjuk az üzeneteket.
- Az ORIGINAL_PARTITION-t, hogy megpróbáljuk megőrizni ugyanazt a fogyasztót az újrafogalmazás során. Ez a paraméter null értékű is lehet, ebben az esetben az új partíció a record.key() eredeti üzenet kulcsán keresztül kerül megszerzésre.
- A COUNTER frissített értéke, hogy követhessük az újrapróbálkozási stratégiát.
- A SEND_TO - állandó, amely megmutatja, hogy az üzenetet vissza kell-e küldeni az újrafeldolgozásra a RETRY_AT elérésekor, vagy a DLQ-ba kell-e helyezni.
- A REASON - az az ok, amiért az üzenet feldolgozása megszakadt.
A Retryer tárolja az üzeneteket az újraküldéshez és a kézi elemzéshez PostgreSQL-ben. Egy időzítő által indított feladat keresi meg azokat az üzeneteket, amelyeknél elérkezett a RETRY_AT, és visszaküldi őket az ORIGINAL_PARTITION partícióba a DESTINATION topikban a record.key() kulccsal.
Az üzenetek elküldése után törlésre kerülnek a PostgreSQL-ből. Az üzenetek kézi elemzése egy egyszerű felhasználói felületen történik, amely a Retryer-szel REST API-n keresztül kommunikál. Főbb funkciói az üzenetek újraküldése vagy törlése a DLQ-ból, a hibainformációk megtekintése és az üzenetek keresése, például a hiba neve alapján.
Mivel a klasztereinken engedélyezve van a hozzáférés-kezelés, külön hozzáférést kell kérni a Retryer által hallgatott topikhoz, és engedélyezni a Retryer számára, hogy írhasson a DESTINATION topikba. Ez kényelmetlen, de a periódikus topik megközelítéssel ellentétben teljes körű DLQ-t és felhasználói felületet kapunk a kezelésére.
Előfordulnak esetek, amikor a bejövő topikot több különböző fogyasztói csoport olvassa, amelyek különböző logikát valósítanak meg. Az üzenet Retryer általi újrafeldolgozása egy ilyen alkalmazás esetén duplikátumot eredményezhet egy másik alkalmazásban. Ennek elkerülése érdekében külön topikot hozunk létre az újrafeldolgozáshoz. A bejövő és az újrafeldolgozó topikot ugyanaz a fogyasztó korlátozások nélkül olvashatja.
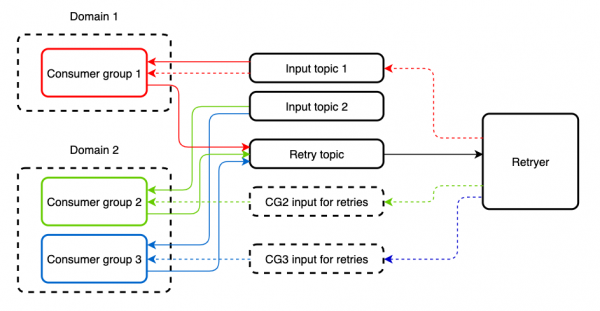
Alapértelmezés szerint ez a megközelítés nem biztosít lehetőséget a circuit breaker-re, azonban hozzáadhatjuk az alkalmazáshoz a vagy az új , azáltal, hogy a külső szolgáltatások meghívásának helyeit megfelelő absztrakciókkal körülveszünk. Ezen túlmenően a választás lehetősége is megjelenik a stratégiára vonatkozóan, pattern, ami szintén hasznos lehet. Például a spring-cloud-netflix esetében ez lehet thread pool vagy szeminárium.
Következtetés
Ennek eredményeként egy külön alkalmazást kaptunk, amely lehetővé teszi az üzenet feldolgozásának megismétlését, ha bármely külső rendszer ideiglenesen nem elérhető.
Az alkalmazás egyik legnagyobb előnye, hogy a külső rendszerek, amelyek ugyanazon a Kafka klaszteren működnek, jelentős módosítások nélkül használhatják. Az alkalmazásnak csak hozzáférést kell kérnie a retry-topikhoz, kitöltenie néhány Kafka-irányelvet, és üzenetet kell küldenie a Retryerbe. Nincs szükség további infrastruktúra építésére. Annak érdekében, hogy csökkentsük a Retryerbe és onnan vissza átadott üzenetek számát, az alkalmazásokat lineáris logikával különítettük el, és a visszafeldolgozást a Consumer leállításával valósítottuk meg.
Forrás: habr.com
