

A következő HighLoad++ konferenciát 2020. április 6-7-én Szentpéterváron tartják.
Részletek és jegyek . HighLoad++ Szibéria 2019. Terem: „Krasznojarszk”. Június 25., 12:00. Absztraktok és .
Előfordul, hogy a gyakorlati követelmények ellentétben állnak az elmélettel, ahol a kereskedelmi termék szempontjából fontos szempontok nincsenek figyelembe véve. Ez a prezentáció bemutatja a különböző Causal consistency komponensek létrehozási megközelítések kiválasztásának és kombinálásának folyamatát a tudományos kutatások alapján, figyelembe véve a kereskedelmi termék igényeit. A hallgatók megismerik a logikai órák, függőségi nyomon követés, rendszerbiztonság, óra szinkronizáció létező elméleti megközelítéseit, és hogy miért döntött a MongoDB az egyes megoldások mellett.
Mihail Tyulenyev (továbbiakban – MT): – Beszélni fogok a Causal consistency-ről – ez egy funkció, amelyen dolgoztunk a MongoDB-nél. A disztribúciós rendszerek csapatában dolgozom, körülbelül két éve készítettük el ezt.
A folyamat során jelentős mennyiségű tudományos kutatással kellett megismerkednünk, mert ez a funkció elég jól tanulmányozott. Kiderült, hogy egyetlen cikk sem illeszkedik az ipari igényekhez, figyelembe véve a nagyon specifikus követelményeket, amelyek valószínűleg minden gyártási alkalmazásban jelen vannak.
Beszélni fogok arról, hogyan alakítjuk át a tudományos kutatást olyan formába, amelyet utána bemutathatunk a felhasználóinknak, mint egy kész ételt, amely kényelmesen és biztonságosan használható.
Ok-okozati összefüggés (Causal consistency). Határozzuk meg a fogalmakat
Kezdetben általánosan szeretném elmondani, hogy mi is az a Causal consistency. Két karakter van – Leonard és Penny (a „Nagy Lebowski” sorozatból):
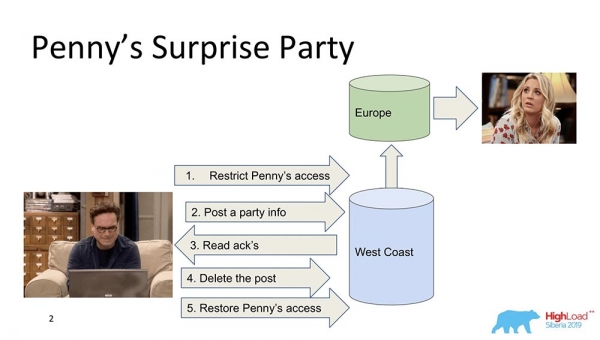
Tegyük fel, hogy Penny Európában van, és Leonard meglepetést akar neki szervezni. És nem talál jobb ötletet, mint hogy eltávolítja őt a barátai listájáról, majd küld egy frissítést minden barátjának a feedre: „Örüljünk Penny-nek!” (ő Európában van, amíg alszik, nem látja ezt, és nem is tud róla, mert nem ott van). A végén törli ezt a bejegyzést, eltávolítja a „Feed”-ből, és helyreállítja a hozzáférést, hogy ne vegye észre, és ne legyen botrány.
Ez mind szép és jó, de tegyük fel, hogy a rendszer elosztott, és az események nem éppen úgy alakultak. Például előfordulhat, hogy a Penny hozzáférésének korlátozása a bejegyzés megjelenése után következett be, ha az események között nincs ok-okozati kapcsolat. Ez lényegében egy példa arra, amikor a Causal consistency megléte szükséges egy üzleti funkció teljesítéséhez (ebben az esetben).
Valójában ezek elég nem triviális jellemzők az adatbázisokban – nagyon kevesen támogatják őket. Térjünk át a modellekre.
Konzisztencia modellek (Consistency Models)
Mi is az adatbázisok konzisztencia modellt? Ezek olyan garanciák, amelyeket az elosztott rendszer nyújt a kliens számára, hogy milyen adatokat és milyen sorrendben kaphat.
Alapvetően minden konzisztenciamodellek arra vonatkoznak, hogy mennyire hasonlít az elosztott rendszer egy laptopon, például egyetlen nodon működő rendszerhez. És hogy mennyire hasonlít a rendszer, amely ezrekben elosztott 'nodok' közül működik egy laptophoz, amelyben ezek a tulajdonságok elvileg automatikusan megvalósulnak.
Ezért a konzisztenciamodellek csak az elosztott rendszerekre vonatkoznak. Minden olyan rendszer, amely korábban létezett és egyetlen függőleges skálázáson működött, nem tapasztalt ilyen problémákat. Ott volt egy Buffer Cache, és abból mindig kiolvasták az adatokat.
Strong modell
Az első modell a Strong (vagy vonallegelőség, ahogyan gyakran nevezik) modell. Ez egy olyan konzisztencia modell, amely garantálja, hogy minden változás, amint megkapja a megerősítést arról, hogy megtörtént, minden felhasználó számára láthatóvá válik.
Ez létrehozza az események globális sorrendjét az adatbázisban. Ez egy nagyon erős konzisztenciájú tulajdonság, és valójában nagyon drága. Ennek ellenére jól támogatott. Csak nagyon drága és lassú – ezért ritkán használják. Ezt nevezik vonallegelőségnek.
Van még egy, a 'Spanner'-ben támogatott erősebb tulajdonság – ezt nevezik External Consistency-nek. Erről kicsit később beszélünk.
Causal
A következő a Causal, amiről beszéltem. A Strong és a Causal között vannak még alacsonyabb szintek, amikről nem beszélek, de mindezek a Causal-hoz vezetnek. Ez egy fontos modell, mert ez a legerősebb az összes modell közül, és a legnagyobb konzisztenciát biztosít hálózatok vagy partíciók esetén.
A Causals konkrétan az a helyzet, amikor az események ok-okozati összefüggésben állnak egymással. Gyakran úgy tekintenek rájuk, mint Read your on rights a kliens szempontjából. Ha a kliens észlelte az értékeket, nem láthatja a múltbeli értékeket. Már elkezdheti látni a prefix olvasásokat. Mindez ugyanoda vezet.
A Causals mint a konzisztencia modellje – részleges eseményrend a szerveren, ahol az eseményeket minden ügyfél ugyanabban a sorrendben észleli. Ebben az esetben – Leonard és Penny.
Eventual
A harmadik modell az Eventual Consistency. Ez az, ami minden elosztott rendszert támogat, a legkisebb modell, ami egyáltalán értelmet nyer. Ez azt jelenti, hogy amikor a adatokban változások történnek, azok egy időpontban konzisztensé válnak.
Ebben a pillanatban semmit nem mond, különben External Consistency-ra változna – egészen más történet lenne. Mégis, ez egy nagyon népszerű modell, a legelterjedtebb. Alapértelmezés szerint az elosztott rendszerek összes felhasználója az Eventual Consistency-t alkalmazza.
Szeretnék néhány összehasonlító példát hozni:
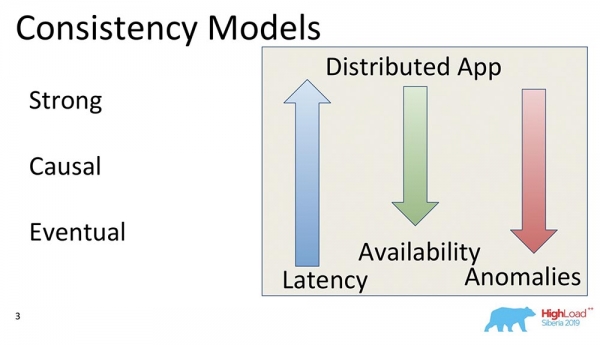
Mit jelentenek ezek a nyilak?
- Késleltetés. A konzisztencia erejének növelésével nyilvánvaló okokból nő: több bejegyzést kell végrehajtani, és megerősítést kell kapni az összes hosttól és node-tól, amelyek részt vesznek a klaszterben, hogy az adatok ott vannak. Ezért az Eventual Consistency a leggyorsabb válasz, mert általában még a memóriába is el lehet kötelezni, és ez alapvetően elegendő lesz.
- Elérhetőség. Ha azt értjük alatta, hogy a rendszer képes válaszolni hálózati megszakadások, partíciók vagy egyéb hibák esetén – a hibatűrőség nő a konzisztencia modellek csökkentésével, mivel elég, ha egy host működik és adatokkal szolgál. Az Eventual Consistency a végsőkig semmit nem garantál az adatokról – ez lehet bármi.
- Anomáliák. Ez persze, a anomáliák száma növekszik. A Strong Consistency esetén gyakorlatilag nem lenne szabad, hogy létezzenek, míg az Eventual Consistency esetén bármilyenek lehetnek. Felmerül a kérdés: miért választják az emberek az Eventual Consistency-t, ha az anomáliákat is tartalmaz? A válasz az, hogy az Eventual Consistency modellek alkalmazhatóak, és az anomáliák például csak rövid időszakra léteznek; van lehetőség olvasni a mestert és viszonylag konzisztens adatokat olvasni; gyakran van lehetőség az erős konzisztencia modellek használatára. Gyakorlatilag ez működik, és sokszor az anomáliák időben korlátozottak.
CAP tétel
Amikor a consistency és availability szavakat hallja, mi jut eszébe? Helyes, a CAP tétel! Most szeretném eloszlatni a mítoszt... Ez nem én vagyok – van egy Martin Kleppmann, aki írt egy csodás cikket, csodás könyvet.
A CAP tétel egy elv, amit az 2000-es években fogalmaztak meg, miszerint a Consistency, Availability és Partitions közül bármely kettőt választhatunk, de a hármat nem. Ez egy bizonyos elv volt. Néhány évvel később tétellé bizonyították Gillbert és Lynch. Ezt követően mantrává vált – a rendszereket CA, CP, AP stb. kategóriákra osztották.
Ez a tétel valójában az alábbi esetekben lett bizonyítva... Először is, az Availability-t nem folyamatos értékként vizsgálták a nullától a százig (0 – a rendszer „halott”, 100 – gyorsan válaszol; így szoktuk nézni), hanem mint algoritmus egy tulajdonságát, amely garantálja, hogy minden végrehajtásakor visszaadja az adatokat.
A válaszidőről egy szó sem esik! Van egy algoritmus, amely 100 év múlva adja vissza az adatokat – egy teljesen kiváló, elérhető algoritmus, amely a CAP tétel része.
Másodszor: a tételt egy és ugyanazon kulcs értékeinek változásaira bizonyították, miközben ezek a változások resizable vonalak. Ez azt jelenti, hogy gyakorlatilag soha nem használják őket, mert más modellek vannak, mint az Eventual Consistency, Strong Consistency (lehetséges).
Mire is van ez az egész? Arra, hogy a CAP tétel abban a formában, ahogy bizonyították, gyakorlatilag nem alkalmazható, ritkán használják. Elméleti formájában valamilyen módon minden korlátoz. Egy bizonyos elvet kapunk, amely intuitíven igaz, de valójában nem bizonyított.
Causal consistency – a legszilárdabb modell
Ami most zajlik – mindhárom dolgot megkaphatjuk: a konzisztenciát, az elérhetőséget a partíciókon keresztül. Különösen a kauzális konzisztencia – a legerősebb konzisztencia modell, amely még partíciók (hálózati megszakítások) esetén is működik. Ezért van olyan nagy érdeklődés iránta, és ezért foglalkoztunk vele.
Először is, egyszerűsíti a fejlesztők munkáját. Különösen azért, mert jelentős szerver támogatással bír: amikor az egy ügyfél által végrehajtott összes bejegyzés garantáltan ugyanabban a sorrendben érkezik meg egy másik ügyfélhez. Másodszor, képes elviselni a partíciókat.
A MongoDB belső működése
Emlékezve arra, hogy ebédidő van, átvonulunk a konyhába. Beszélek a rendszer modelljéről, nevezetesen arról, hogy mi is a MongoDB azok számára, akik először hallanak erről az adatbázisról.
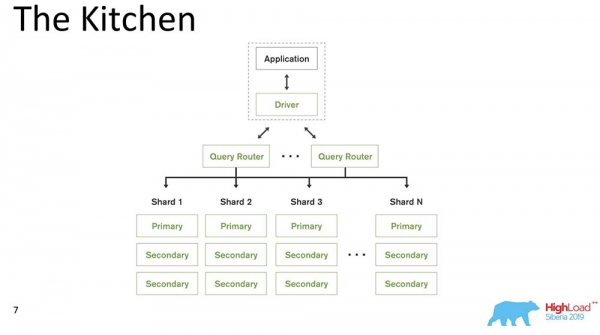
A MongoDB (a továbbiakban: „MongoDB”) egy elosztott rendszer, amely támogatja a vízszintes skálázódást, azaz a shardolást; és minden shardon belül is támogatja az adat redundanciát, azaz a replikációt.
A shardolás a „MongoDB”-ben (nem relációs adatbázis) automatikus egyensúlyozást végez, tehát minden dokumentumgyűjtemény (vagy „tábla” relációs adatok terminológiájában) darabokra van osztva, és a szerver automatikusan mozgatja őket a shardok között.
A kérésirányító, amely az ügyfél kéréseit elosztja, egy bizonyos ügyfél számára egy olyan kliens, amin keresztül dolgozik. Ő már tudja, hol és milyen adatok találhatók, és irányítja az összes kérést a megfelelő shardra.
Még egy fontos pont: a MongoDB egyetlen mester. Van egy primary – ő tud bejegyzéseket fogadni, támogató kulcsokkal, amiket tartalmaz. Nem lehet multi-master írást csinálni.
Kiadtuk a 4.2-es verziót – itt új érdekes dolgok jelentek meg. Különösen beillesztettük a Lucene-t – keresést – valódi executable java közvetlenül a „Mongo”-ba, és ott lehetőség nyílt keresési műveletek végrehajtására Lucene-nel, mint az „Elastic”-ban.
És létrehoztunk egy új terméket – Charts, ez is elérhető az „Atlas”-on (a Mongo saját felhőszolgáltatása). Van egy ingyenes szint – lehet játszadozni vele. A Charts nagyon tetszett – adatok vizualizálása, intuitív.
A kauzális konzisztencia összetevői
Körülbelül 230 cikket számoltam, amelyek ebben a témában lettek publikálva – Leslie Lampertől. Most pedig elmondok nektek néhány részletet ezekből az anyagokból az emlékeimből.
Minden a Leslie Lampert által írt cikkel kezdődött, amely az 1970-es években készült. Ahogy látható, a téma még mindig kutatás tárgyát képezi. Jelenleg a Causal consistency iránt érdeklődés mutatkozik a elosztott rendszerek fejlődése miatt.
Korlátozások
Milyenek a korlátok? Ez valójában az egyik legfontosabb szempont, mert a produkciós rendszerek által támasztott korlátozások jelentősen eltérnek azoktól, amelyek az akadémiai cikkekben találhatók. Gyakran elég mesterségesek.
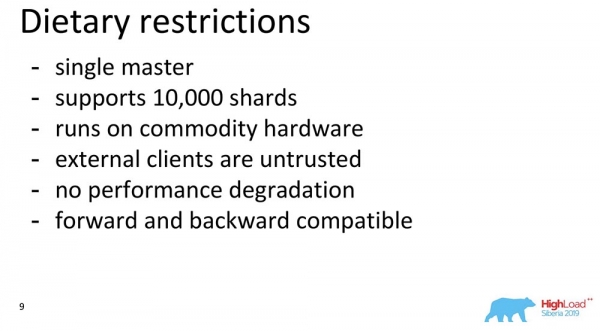
- Először is, a 'MongoDB' egy single master, ahogy már említettem (ez jelentősen egyszerűsíti a helyzetet).
- Azt gondoljuk, hogy a rendszernek körülbelül 10 ezer shardot kell támogatnia. Nem hozhatunk olyan architekturális döntéseket, amelyek egyértelműen korlátozzák ezt az értéket.
- Van felhőnk, de azt feltételezzük, hogy az embereknek lehetőséget kell biztosítani, amikor letöltik a binárist, elindítják a laptopjukon, és minden tökéletesen működik.
- Feltételezzük, hogy a kutatás során ritkán használt: a külső ügyfelek bármit megtehetnek. A 'MongoDB' nyílt forráskódú. Ennek megfelelően az ügyfelek lehetnek nagyon okosak, akár gonoszak – mindent el akarnak rontani. Feltételezzük, hogy bizánci hibák előfordulhatnak.
- A külső ügyfelek számára, akik a peremen kívül helyezkednek el – fontos korlátozás: ha ez a funkció ki van kapcsolva, akkor nem kell teljesítménycsökkenést tapasztalni.
- Még egy szempont – sőt, kifejezetten antikademikus: a korábbi és jövőbeli verziók kompatibilitása. A régi illesztőprogramoknak támogatnia kell az új frissítéseket, és az adatbázisnak támogatnia kell a régi illesztőprogramokat.
Összességében mindez korlátozásokat ró ki.
A Causal consistency komponensei
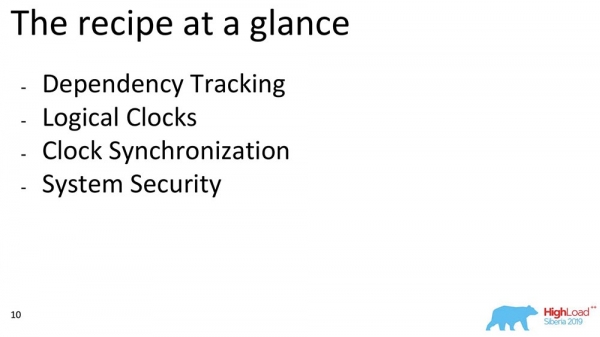
Most néhány komponensről fogok beszélni. Ha általában a Causal consistency-t nézzük, blokkokat lehet kiemelni. Olyan munkákból válogattunk, amelyek egy adott blokkhoz kapcsolódnak: Dependency Tracking, órajelek kiválasztása, hogyan lehet ezeket az órákat szinkronizálni egymással, és hogyan biztosítjuk a biztonságot – ez egy összefoglaló terv arról, amiről beszélni fogok:
Teljes függőségi nyomkövetés (Full Dependency Tracking)
Miért van szükség rá? Azért, hogy amikor az adatok replikálódnak, minden egyes bejegyzés, minden adatváltozás tartalmazza az információt arról, hogy milyen változásoktól függ. Az első és legegyszerűbb változás az, amikor minden üzenet, amely tartalmaz egy bejegyzést, tartalmazza az előző üzenetek információját:
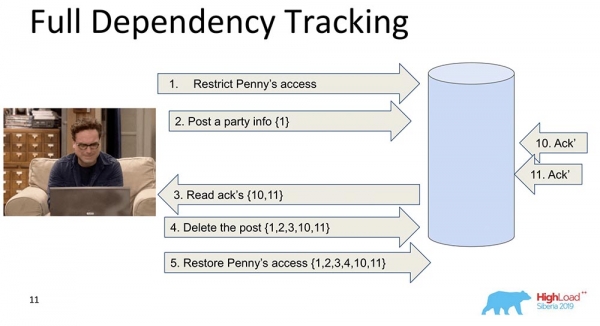
Ebben a példában a kapcsos zárójelek közötti számok a bejegyzések azonosítói. Néha ezeket a bejegyzéseket értékekkel együtt teljesen átadják, néha bizonyos verziókat adnak át. A lényeg az, hogy minden változás tartalmazza az előzőről szóló információt (nyíltan hordozza azt).
Miért döntöttünk úgy, hogy nem használunk ilyen megközelítést (teljes nyomkövetés)? Nyilvánvalóan azért, mert ez a megközelítés nem praktikus: bármely változás a közösségi hálón függ minden korábbi változástól ezen a közösségi hálón, mondjuk „Facebook” vagy „Vkontakte” minden frissítésben. Ennek ellenére számos kutatás létezik a Full Dependency Tracking tekintetében – ez a társadalmi hálózatok előtt létezett, bizonyos helyzetekben ez tényleg működik.
Kifejezett függőség nyomkövetés (Explicit Dependency Tracking)
A következő egy korlátozottabb megközelítés. Itt is információk átadásáról van szó, de csak arról, ami nyíltan függ. Az, hogy mi függ mitől, általában az Alkalmazás határozza meg. Amikor az adatok replikálódnak, a kérések során csak azok a válaszok jelennek meg, amelyeknél az előző függőségek teljesültek, azaz meg lettek mutatva. Ez a lényege annak, hogyan működik a Causal consistency.
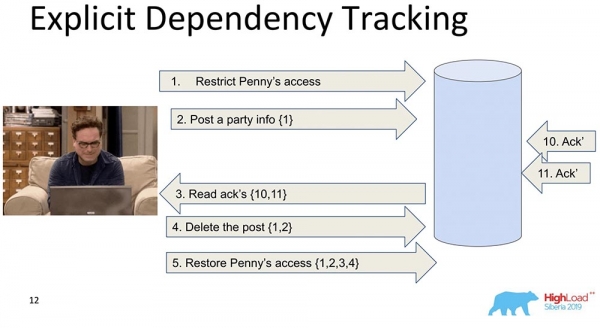
Látja, hogy az 5-ös bejegyzés a 1-es, 2-es, 3-as és 4-es bejegyzésektől függ – ennek megfelelően vár, mielőtt a kliens hozzáférne az access Pennys által végrehajtott változtatásokhoz, amikor minden korábbi változás már átment az adatbázison.
Ez sem elfogadható számunkra, mert így is túl sok információ van, és ez lassítani fog. Van egy másik megközelítés...
Lamport óra (Lamport Clock)
Ezek nagyon régiek. A Lamport Clock azt jelenti, hogy ezek a függőségek egy skaláris funkcióba tömörülnek, amit Lamport Clock-nak neveznek.
A skaláris függvény egy absztrakt szám. Gyakran logikai időnek nevezik. Minden eseménynél ez a számláló növekszik. Az a számláló, amelyet a folyamat jelenleg ismer, minden üzenetet elküld. Nyilvánvaló, hogy a folyamatok deszinkronizálódhatnak, lehet teljesen eltérő időzítésük. Ennek ellenére így üzeneteket váltva a rendszer valahogy egyensúlyozza az órákat. Mi történik ebben az esetben?
Két részre osztottam azt a nagy shardot, hogy világos legyen: a Friends akár egy noden is élhet, amely egy gyűjtemény darabját tartalmazza, míg a Feed – egy teljesen más noden, amely szintén egy darabot tartalmaz ebből a gyűjteményből. Hogyan kerülhetnek ki a sorból? Először a Feed azt mondja: „Replikálva lett”, majd a Friends. Ha a rendszer nem garantál semmit, hogy a Feed nem jelenik meg, amíg a Friends gyűjtemény függőségei szintén nem kerültek átadásra, akkor pontosan egy olyan helyzet áll elő, amiről beszéltem.
Látja, hogyan növekszik logikailag a számláló ideje a Feed-en:
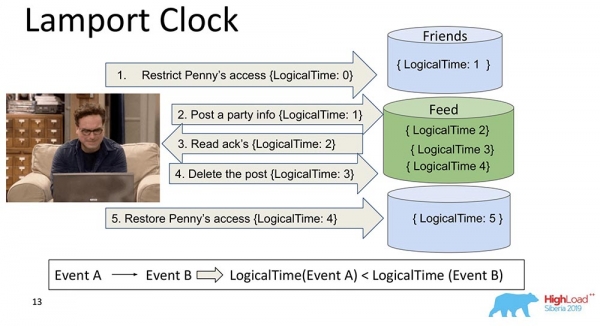
Így a Lamport-óra és a Kausal konzisztenzia (Lamport-órán keresztül elmagyarázva) fő jellemzője a következő: ha van egy A és B eseményünk, és a B esemény függ az A eseménytől *, akkor ebből következik, hogy az A esemény LogikaiIdeje kisebb, mint a B esemény LogikaiIdeje.
* Néha azt is mondják, hogy A megelőzte B-t, azaz A korábban történt, ez egy olyan viszony, amely részben rendezetté teszi az összes eseményt, amely valaha is megtörtént.
A fordított irányban nem igaz. Ez valójában a Lamport-óra egyik fő hátránya – a részleges sorrend. Létezik a párhuzamos események fogalma, azaz az események, amelyek esetében sem (A megelőzte B-t), sem (A utána történt B előtt) nem áll meg. Egy példa lehet Leonard barátként való párhuzamos hozzáadása valakihez (még csak nem is Leonard, hanem például Sheldon).
Ez a tulajdonság az, amelyet gyakran használnak a Lamport-órák munkája során: a függvényre néznek, és ebből következtetnek – lehet, hogy ezek az események függnek egymástól. Mert egy irányban ez igaz: ha A LogikaiIdeje kisebb, mint B LogikaiIdeje, akkor B nem megelőzheti A-t; ha pedig nagyobb, akkor lehet, hogy megelőzheti.
Vektoros órák (Vector Clock)
A Lamport-órák logikai fejlődése a Vektoros órák. Az az eltérés, hogy minden node, amely itt van, tartalmaz saját, külön órákat, és ezeket vektor formájában továbbítják.
Ebben az esetben látja, hogy a vektor nulla indexe a Feed-ért felel, míg az első index a Friends-ért (mindkét nod esetében). Most pedig ezek növekedni fognak: a „Feed” nulla indexe 1, 2, 3-ra nő.
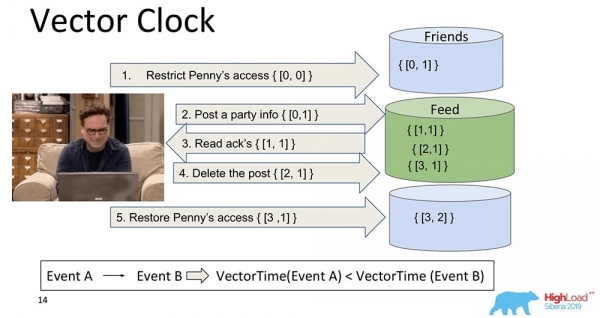
Miért jobbak a Vektoras órák? Azért, mert lehetővé teszik, hogy megértsük, mely események történnek egyidőben és mikor zajlanak le a különböző nodokon. Ez nagyon fontos a shardolási rendszer számára, mint például a „MongoDB”. Azonban ezt nem választottuk, bár szuper dolog, csodálatosan működik, valószínűleg nekünk is megfelelne...
Ha 10 ezer shardunk van, nem tudunk 10 ezer komponenst átadni, még ha tömörítjük is, vagy valami mást kitalálunk – akkor is a hasznos teher töredéke lesz a teljes vektor mennyiségének. Ezért, szívemre és fogaimra tapasztva, lemondtunk erről a megközelítésről, és másra tértünk át.
Spanner TrueTime. Atomórák
Mondtam, hogy a „Spannerről” fogok mesélni. Ez egy menő dolog, igazi XXI. század: atomórák, GPS-szinkronizáció.
Mi az ötlet? A „Spanner” egy Google rendszer, ami nemrégiben elérhetővé vált az emberek számára (SQL-t adtak hozzá). Minden tranzakciónak van egy timestamp-je. Mivel az idő szinkronizált*, minden eseményhez hozzárendelhető egy meghatározott idő – az atomórák bizonyos várakozási idővel rendelkeznek, amely után garantáltan „fakad” már egy másik idő.
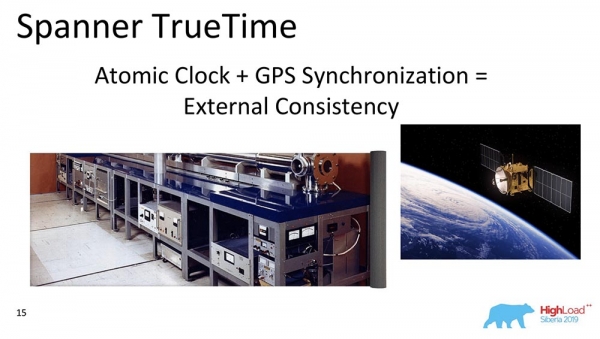
Így, egyszerűen a DB-be írás és egy bizonyos várakozási idő elteltével automatikusan garantált a rendezhetőség (Serializability) az eseményeknél. Ennek a legerősebb konzisztencia-modellje van, amelyet elvileg elképzelhetünk – ez az external consistency.
* Ez a Lambert órákkal kapcsolatos fő probléma – sosem szinkronizáltak elosztott rendszerekben. Megtarthatják a különbséget, még ha NTP is van, akkor sem működnek túl jól. A „Spanner” atomórákkal és szinkronizációval rendelkezik, úgy tűnik, mikro-szekundumokkal.
Miért nem választottuk? Nem számítunk arra, hogy a felhasználóinknak beépített atomórái lennének. Amikor azok megjelennek, beépítve minden laptopba, lesz valami szuper GPS-szinkronizáció – akkor igen… De addig a legjobb, amit lehet, az az „Amazon”, Base Stations – a fanatikák számára… Ezért más órákat használtunk.
Hibrid órák (Hybrid Clock)
Ez lényegében az, ami a 'MongoDB'-ben működik a kauzális konzisztencia biztosításánál. Miben hibrid? A hibrid egy skaláris érték, de két komponensből áll:
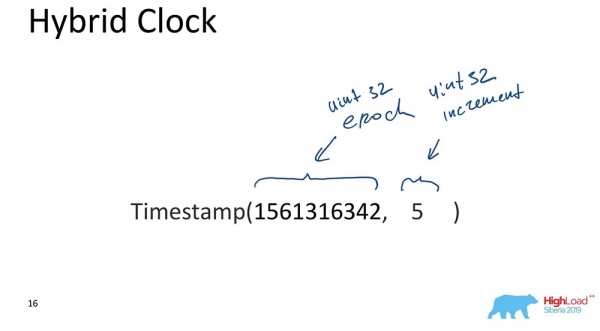
- Az első a unix időszámítás (mennyi másodperc telt el a 'számítógépes világ kezdetétől').
- A második egy bizonyos inkrement, szintén 32-bites unsigned int.
Ez tulajdonképpen minden. Létezik egy megközelítés: az időért felelős rész folyamatosan szinkronizálva van az órákkal; mindig, amikor frissítés történik, ez a rész szinkronizálva van az órákkal, így az idő mindig nagyjából helyes, míg az inkrement lehetővé teszi az események megkülönböztetését, amelyek ugyanabban az időpontban történtek.
Miért fontos ez a 'MongoDB'-nek? Mert lehetővé teszi bizonyos időpontra vonatkozó biztonsági mentések és visszaállítások végrehajtását, tehát az eseményeket idő alapján indexálják. Ez különösen fontos, amikor bizonyos események szükségesek; az adatbázisok esetében az események azok a változások, amelyek az adatbázisban bizonyos időintervallumokban történtek.
A legfontosabb okról csak nektek fogok beszélni (kérlek, ezt senkinek ne mondjátok el)! Így csináltuk, mert a rendezett, indexelt adatok ilyen formában jelennek meg a MongoDB OpLog-ban. Az OpLog egy olyan adatstruktúra, amely tartalmazza az összes változást az adatbázisban: először az OpLog-ba kerülnek, majd aztán alkalmazva lesznek a tárolóra, ha ez egy replikált adat vagy shard.
Ez volt a fő ok. Azonban praktikus követelmények is léteznek az adatbázis fejlesztésénél, ami azt jelenti, hogy egyszerűnek kell lennie – minél kevesebb kód, és a lehető legkevesebb törött dolog, amit újra kell írni és tesztelni. Az, hogy az op logjaink hibrid órák által indexáltak, nagyon segített, és lehetővé tette a helyes választás meghozatalát. Ez valóban megérte, és valahogy varázslatosan működött, már az első prototípuson is. Nagyon menő volt!
Órák szinkronizálása
Többféle szinkronizálási módszer létezik, amelyek a tudományos irodalomban szerepelnek. A szinkronizálás alatt azt értem, amikor két különböző shardunk van. Ha van egy replikakészlet – akkor nincs szükség szinkronizálásra: ez egy »single-master«; van egy OpLog, ahova minden módosítás bekerül – ebben az esetben minden már sorozatosan rendezett az »OpLogban«. De ha két különböző shardunk van, akkor az idő szinkronizációja fontos. Itt a vektormutatók sokat segítenek! De nekünk nincs ilyen.
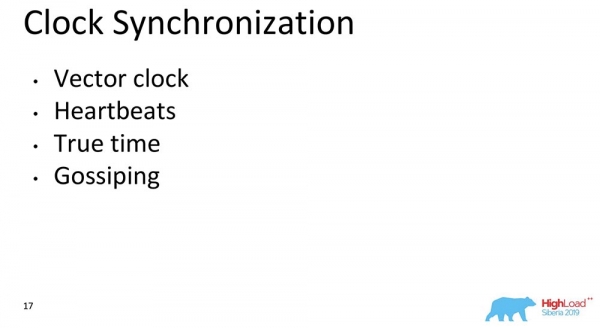
A második lehetőség a »Heartbeats« (szívverések). Lehet jeleket cserélni, amelyek egy bizonyos időközönként történnek. De a »Heartbeats« túl lassúak, nem tudunk latenciát biztosítani az ügyfelünknek.
A valódi idő – természetesen, csodálatos dolog. De, megint csak, ez talán a jövő... Bár az »Atlasban« már lehet ilyet csinálni, már léteznek gyors »amazonos« időszinkronizálók. De ez nem lesz mindenki számára elérhető.
A Gossiping – az amikor minden üzenet tartalmazza az időt. Ez körülbelül az, amit használunk. Minden üzenet a csomópontok között, a meghajtó, az adatcsomópontok routerei, abszolút minden a »MongoDB«-ben – ezek valamilyen elemek, az adatbázis komponensei, amelyek tartalmazzák az időmérőket, amelyek folynak. Mindenhol van hibrid időérték, ez átadódik. 64 bit? Ez lehetővé teszi, ez működhet.
Hogyan működik ez együtt?
Itt egy replikakészletet vizsgálok, hogy egy kicsit egyszerűbb legyen. Van egy Primary és egy Secondary. A Secondary replikál és nem mindig teljesen szinkronizált a Primaryval.
A »Primaryban« történik egy beszúrás (insert) valamilyen időértékkel. Ez a beszúrás 11-re növeli a belső számlálót, ha ez a maximum. Vagy ellenőrzi az időértékeket és az idő szerint szinkronizálódik, ha az időértékek nagyobbak. Ez lehetővé teszi az időbeli rendezést.
Miután végrehajtotta a feljegyzést, egy fontos pillanat következik. Az órák a »MongoDB«-ben csak akkor emelkednek, ha a »Oplog«-ba történik feljegyzés. Ez az az esemény, amely megváltoztatja a rendszer állapotát. Minden klasszikus cikkben eseménynek számít az üzenet érkezése a csomópontba: ha az üzenet megérkezett – akkor a rendszer megváltoztatta az állapotát.
Ez azért van, mert a kutatás során nem lehet teljesen megérteni, hogyan fogják értelmezni ezt az üzenetet. Pontosan tudjuk, hogy ha nem tükröződik az «OpLog»-ban, akkor semmilyen módon nem lesz értelmezve, és a rendszer állapotának megváltoztatása csak az «OpLog»-ban való bejegyzést jelenti. Ez mindent leegyszerűsít nekünk: a modelt is egyszerűsíti, és lehetővé teszi a rendezést egy replika-csoport keretein belül, és sok más hasznos dolgot.
Visszatér a már az «OpLog»-ban rögzített érték – tudjuk, hogy az «OpLog»-ban már megtalálható ez az érték, és az ideje – 12. Most mondjuk, hogy egy másik node (Secondary) elkezdi az olvasást, és ő már az afterClusterTime-ot továbbítja az üzenetben. Azt mondja: „Szükségem van mindenre, ami legalább 12 után vagy éppen 12-kor történt” (lásd a fenti ábrát).
Ez az, amit Causal a consistent (CAT)-nak hívnak. Van egy olyan fogalom az elméletben, hogy ez egy időbeli szelet, amely önmagában konzisztens. Itt elmondható, hogy ez a rendszer állapota, amely 12 óra pillanatában figyelhető meg.
Jelenleg semmi sincs itt, mert ez szimulálja azt a helyzetet, amikor a Secondary-nak a Primary-ról kell replikálnia az adatokat. Vár… És most megérkeztek az adatok – visszaadja ezeket az értékeket.
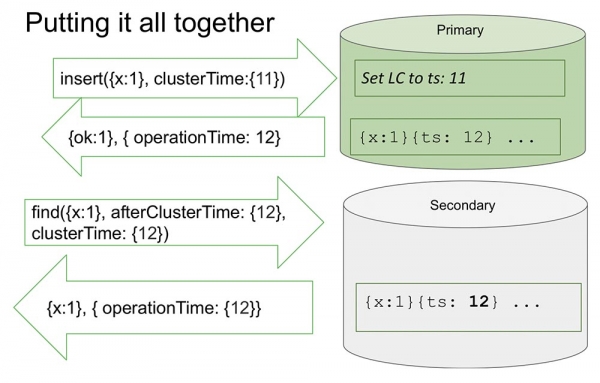
Hát, nagyjából így működik minden. Szinte.
Mit jelent az, hogy „szinte”? Tegyük fel, hogy van egy ember, aki elolvasta és megértette, hogyan működik ez az egész. Megértette, hogy minden alkalommal, amikor ClusterTime történik, frissíti a belső logikai órákat, és aztán a következő bejegyzés eggyel növel azokat. Ez a funkció 20 sort foglal magában. Tegyük fel, hogy ez az ember átadja a lehető legnagyobb 64 bites számot, eggyel csökkentve.
Miért „eggyel csökkentve”? Mert a belső órák ezt az értéket fogják csatolni (nyilvánvalóan ez a legnagyobb lehetséges és nagyobb a jelenlegi időnél), majd bejegyzés történik az «OpLog»-ban, és az órák újabb eggyel növekednek – és már teljesen maximális érték lesz (ott csak egyesek vannak, tovább nem lehet, unsaint int-ek).
Nyilvánvaló, hogy ezután a rendszer teljesen elérhetetlenné válik mindenre. Csak ki lehet üríteni, tisztítani – sok manuális munka. Teljes elérhetőség:
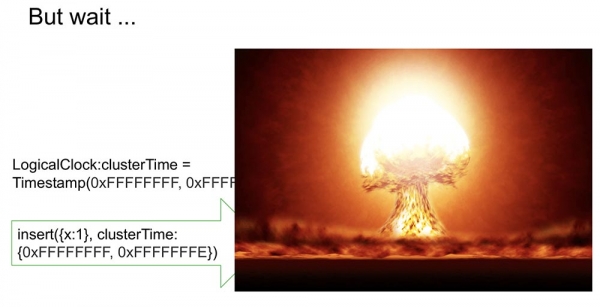
Amennyiben ez más helyekre is replikálódik, az egész klaszter egyszerűen leáll. Teljesen elfogadhatatlan szituáció, amelyet bárki nagyon gyorsan és egyszerűen létrehozhat! Ezért ezt a pontot a legfontosabbak között kezeltük. Hogyan tudjuk megakadályozni?
Az utunk – a clusterTime aláírása
Így kerül át a üzenetbe (a kék szöveg előtt). De elkezdtünk generálni egy aláírást is (kék szöveg):
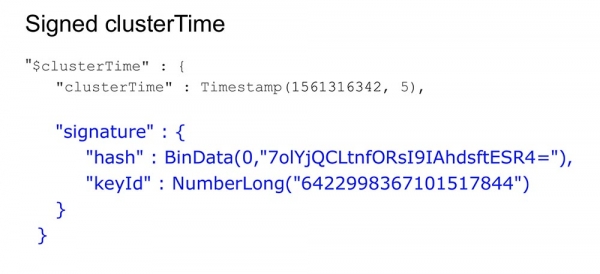
Az aláírás egy kulccsal generálódik, amely az adatbázison belül, a védett peremeken tárolódik; maga generálódik, frissül (ezt a felhasználók nem látják). Generálódik egy hash, és minden üzenet létrehozásakor aláírásra kerül, míg fogadáskor érvényesítjük.
Valószínűleg sok emberben felmerül a kérdés: "Mennyire lassítja ezt az egészet?" Én azt mondtam, hogy gyorsan kell működnie, különösen ennek a funkciónak a hiányában.
Mit jelent a Causal consistency használata ebben az esetben? Az afterClusterTime paraméter megjelenítése. Enélkül az értékeket mindenképpen továbbítja. A Gossiping a 3.6-os verziótól mindig működik.
Ha folyamatosan generáljuk az aláírásokat, akkor az lassítani fogja a rendszert, még a funkció hiányában is, ami nem felel meg a megközelítéseinknek és követelményeinknek. Mit tettünk?
Tedd ezt gyorsan!
Meglehetősen egyszerű dolog, de az ötlet érdekes – megosztom, hátha valakinek érdekes lesz.
Van egy hash, amely az aláírt adatokat tárolja. Minden adat a cache-en keresztül megy. A cache nem konkrét időt, hanem Range-t ír alá. Amikor egy bizonyos érték érkezik, generálunk egy Range-t, elfedjük az utolsó 16 bitet, és ezt az értéket írjuk alá:
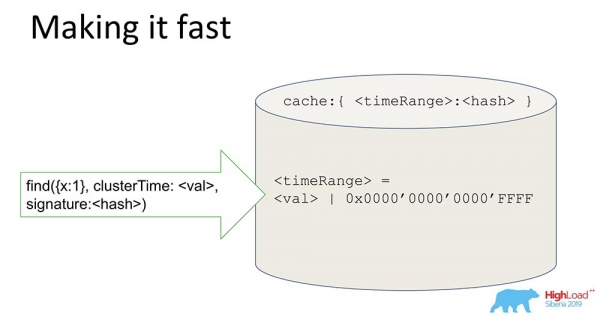
Egy ilyen aláírás megszerzésével a rendszert (jó értelemben) 65 ezer alkalommal gyorsítjuk. Kiválóan működik: amikor elvégeztük a kísérleteket – valóban 10 ezer alkalommal csökkent a folyamatos frissítés ideje. Nyilvánvaló, hogy amikor azok szétszórtak, ez nem működik. De a legtöbb gyakorlati esetben ez működik. A Range aláírás és az aláírás kombinációja megoldotta a biztonsági problémát.
Mit tanultunk?
A leckék, amelyeket ebből levontunk:
- Olvasni kell a anyagokat, történeteket, cikkeket, mert sok érdekes dolog van számunkra. Amikor egy új funkción dolgozunk (különösen most, amikor tranzakciókat hajtottunk végre stb.), fontos elolvasni és megérteni. Ez időt vesz igénybe, de valójában nagyon hasznos, mert világossá válik, hol tartunk. Úgy tűnik, hogy nem találtunk ki semmi újat - csupán összegyűjtöttük az összes hozzávalót.
Alapvetően észlelhető egyfajta különbség a gondolkodásban, amikor egy akadémiai konferencia van (például a 'Sigmon') - ott mindenki az új ötletekre fókuszál. Mi az algoritmusunk újdonsága? Itt igazából nem található nagy újdonság. Az újdonság inkább abban rejlik, ahogyan összeolvasztottuk a meglévő megközelítéseket. Ezért az első lépés - olvasni a klasszikusokat, kezdve Lamporttól.
- A produkciós környezetben teljesen más követelmények vannak. Biztos vagyok benne, hogy sokan nem 'sférikus' adatbázisokkal találkoznak egy absztrakt vákuumban, hanem normális, valós dolgokkal, amelyeknek vannak problémáik a rendelkezésre állás, késleltetés és hibatűrés terén.
- Az utolsó dolog, ami az, hogy különböző ötleteket kellett megfontolnunk és több különböző cikket kellett egyesítenünk egy módszerré. Az ötlet a digitális aláírásról például egy cikkből származik, amely a Paxos-protokollt vizsgálta, amely a nem bizánci hibák számára az autorizációs protokollon belül, a bizánciak számára pedig az autorizációs protokollon kívül… Olyan lett, amit végül is megcsináltunk.
Itt abszolút semmi új nincs! De amikor mindezt együtt összekevertük… Olyan, mintha azt mondanánk, hogy az Olivier saláta receptje nonszensz, mert a tojásokat, majonézt és uborkát már feltalálták… Ez körülbelül ugyanez a történet.
Ezzel befejezem. Köszönöm!
Kérdések
Kérdés a közönségtől (a továbbiakban: K): – Köszönöm, Mihail a beszámolóért! Az idővel kapcsolatos téma érdekes. Önök Gossiping-et használnak. Azt mondták, hogy mindenkinek megvan a saját ideje, mindenki tudja a helyi idejét. Jól értettem, hogy van egy illesztőprogram - sok ügyfél lehet sok illesztőprogrammal, sok lekérdezési tervező is, sok shard is… Mi történik a rendszerrel, ha hirtelen eltérés lép fel: valaki azt hiszi, hogy egy perccel előrébb van, valaki - egy perccel hátrább? Hol fogunk találkozni?
MT: – Valóban kiváló kérdés! Éppen a shardokról szerettem volna beszélni. Ha jól értem a kérdést, az a helyzet, hogy van egy 1-es shard és egy 2-es shard, az olvasás ezekről a shardokról történik – eltérések vannak, nem lépnek kapcsolatba egymással, mert az idő, amit tudnak – különböző, különösen az idő, ami az oplogjaikban létezik.
Tegyük fel, hogy az 1-es shard egymillió bejegyzést készített, a 2-es shard – egyet sem, és a kérés mindkét shardhoz megérkezett. Az első shardnak van afterClusterTime értéke, ami meghaladja az egymilliót. Ilyen helyzetben, ahogy magyaráztam, a 2-es shard soha nem fog válaszolni.
K: – Azt szerettem volna megtudni, hogyan szinkronizálják őket és választanak egy logikai időt?
MT: – Nagyon egyszerűen szinkronizálják. A shard, amikor megkapja az afterClusterTime értéket, és nem talál időt az „Oplog”-ban – kezdeményez egy no approved műveletet. Tehát manuálisan felemeli az időértékét erre az értékre. Ez azt jelenti, hogy nincsenek események, amelyek megfelelnek ennek a kérésnek. Mesterségesen létrehoz egy eseményt, és így Causal Consistent lesz.
K: – És mi van, ha azt követően még jönnek hozzá olyan események, amelyek a hálózaton valahol elvesztek?
MT: – A shard úgy van felépítve, hogy ezek már nem fognak megérkezni, mivel ez egy single master rendszer. Ha már rögzítette, akkor ezek már nem fognak visszajönni, hanem csak később. Nem történhet meg, hogy valahol valami beragadt, majd ő no write műveletet hajt végre, és aztán ezek az események jönnek – és ezzel megsértettük a Causal consistency-t. Amikor no write-ot végez, minden eseménynek meg kell érkeznie tovább (ő várni fog rájuk).
K: – Van néhány kérdésem a sorokkal kapcsolatban. A Causal consistency azt feltételezi, hogy van egy bizonyos cselekvéssorozat, amit el kell végezni. Mi történik, ha egy csomag eltűnik? Az jött a 10-es, 11-es... a 12-es eltűnt, és mindenki vár arra, hogy az végrehajtódjon. És hirtelen megmondta a gép, hogy vége, semmit sem tudunk tenni. Van egy maximális hossza a sorozatnak, ami felhalmozódik, mielőtt végrehajtanák? Milyen végzetes hiba történik, ha bármelyik állapot elveszik? Ráadásul, ha rögzítjük, hogy van egy korábbi állapot, akkor abból kell valahogyan kiindulnunk? De abból nem tudunk kiindulni!
MT: – Szintén nagyszerű kérdés! Mit csinálunk? A MongoDB-ben létezik a kvórumszerű írások és olvasások fogalma. Milyen esetekben tűnhet el egy üzenet? Amikor a rögzítés nem kvórumszerű, vagy amikor az olvasás nem kvórumszerű (valamiféle hulladék is érkezhet).
A Causal consistency-vel kapcsolatosan egy jelentős kísérleti ellenőrzést hajtottunk végre, amelynek eredményeként megállapítottuk, hogy nem quorum-os írás és olvasás esetén megsértés lép fel a Causal consistency-ben. Pontosan azt mondja, amit Ön is állít!
Tanácsunk: használjon legalább quorum-os olvasást a Causal consistency alkalmazása során. Így semmi sem fog elveszni, még akkor sem, ha a quorum-os írás eltűnik... Ez ortogonális helyzet: ha a felhasználó nem akarja, hogy adatokat veszítsen, quorum-os írást kell használnia. A Causal consistency nem garantálja a tartósságot. A tartósság garanciáját a replikáció és a replikációval kapcsolatos mechanizmusok nyújtják.
K: – Amikor létrehozunk egy példányt, amelynek shardingot végzünk (nem master, hanem slave), az saját gépe unix idejére támaszkodik, vagy a „mester” idejére; szinkronizálódik először vagy időszakosan?
MT: – Most tisztázom. A shard (azaz a horizontális partíció) mindig tartalmaz egy Primary-t. A shardban lehet „mester” és lehetnek replikák. De a shard mindig támogatja az írást, mert egy bizonyos domént kell támogatnia (a shardban található a Primary).
K: – Tehát minden a „mester”-től függ? Mindig a „mester”-idő van használatban?
MT: – Igen. Képzelhető, hogy az órák akkor ketyegnek, amikor írás történik a „mester”-nél, az „OpLog”-ban.
K: – Van egy ügyfelünk, aki csatlakozik, és neki semmit sem kell tudnia az időről?
MT: – Valóban semmit sem kell tudnia! Ha arról beszélünk, hogy ez az ügyfélnél hogyan működik: az ügyfélnek, amikor a Causal consistency-t szeretné használni, meg kell nyitnia egy munkamenetet. Most ott van minden: tranzakciók a munkamenetben, és jogok visszanyerése... A munkamenet a klienssel történő logikai események rendezett sorrendje.
Ha megnyitja ezt a munkamenetet és azt mondja, hogy szeretné a Causal consistency-t (ha a munkamenet alapértelmezés szerint támogatja a Causal consistency-t), minden automatikusan működik. A vezérlő megjegyzi ezt az időt, és növeli, amikor új üzenetet kap. Emlékezik arra, hogy milyen választ adott meg a korábbi szerver, amely az adatokat visszaküldte. A következő kérés tartalmazni fogja az afterCluster-t („idő minden felett” esetén).
A kliensnek nincs szüksége pontosan semmire tudnia! Ez teljesen átláthatatlan számára. Ha az emberek használják ezeket a funkciókat, mit lehet tenni? Először is, biztonságosan olvashatók a másodlagos adatok: lehet írni az elsődlegesre, míg a földrajzilag replika másodlagosokról olvasunk, és biztosak lehetünk benne, hogy ez működik. Emellett a másodlagosra át lehet vinni az elsődlegesen rögzített munkameneteket, tehát nem egyetlen munkamenetet, hanem többet is használhatunk.
K: – Az Eventual consistency témája szorosan összefügg az új Compute science réssel – az CRDT (Conflict-free Replicated Data Types) adatszerkezetekkel. Fontolgattátok ezeknek az adatszerkezeteknek az integrálását az adatbázisba, és mit tudtok erről mondani?
MT: – Jó kérdés! A CRDT-nek van értelme az írásbeli konfliktusok kezelésére: a MongoDB esetében – egyetlen mester.
K: – Van egy kérdésem a DevOps szakemberektől. A valós világban előfordulnak olyan helyzetek, amikor bizánci hibák lépnek fel, és rossz emberek a védett peremen belül hozzáférnek a protokollhoz, és speciálisan elkészített csomagokat küldenek?
MT: – Rossz emberek a perimen belül – olyan, mint egy trójai faló! A peremen belüli rossz emberek sok rossz dolgot tehetnek.
K: – Nyilvánvaló, hogy a szerverben, durván szólva, hagyni egy rést, amelyen keresztül elefántokat lehet beszuszakolni és véglegesen megsemmisíteni az egész klasztert… Időbe telik a kézi helyreállítás… Ez enyhén szólva is helytelen. Másrészt az a kérdés érdekes, hogy a való életben előfordulnak-e valaha hasonló belső támadások?
MT: – Mivel ritkán találkozom biztonsági részekkel a való életben, nem tudom mondani – lehet, hogy előfordulnak. De ha a fejlesztői filozófiáról beszélünk, úgy gondoljuk, hogy van egy peremünk, amely biztosítja a biztonságért felelős embereket – ez a zár, a fal; a perem belsejében viszont bármit meg lehet csinálni. Nyilvánvaló, hogy vannak felhasználók, akik csak megtekinthetik az adatokat, és vannak, akik lehetőséget kapnak a visszavonásra.
A jogoktól függően a felhasználók által okozott kár lehet egérrel vagy akár elefánthoz hasonló. Egyértelmű, hogy a teljes jogokkal rendelkező felhasználó bármit megtehet. A szűk jogokkal rendelkező felhasználó viszont jelentősen kevesebbet árthat. Különösen nem tudja lebontani a rendszert.
K: – A védett területen valaki váratlan protokollokat próbál kialakítani a szerverhez, hogy a szervert akassza fel, és ha szerencséje van, akkor az egész klasztert is... Lehet ez ennyire "jó"?
MT: – Eddig még sosem hallottam ilyen dolgokról. Az, hogy így le lehet terhelni egy szervert – nem titok. Belül, a protokollon keresztül, bejelentkezett felhasználóként, aki írást tud elhelyezni egy üzenetben... Valójában nem lehet, mert mindenképpen érvényesíteni fogják. Van lehetőség kikapcsolni ezt az azonosítást azok számára, akik nem akarják – na, ez már az ő problémájuk; durván fogalmazva, ők maguk rombolták le a falakat, és lehet bepasszírozni oda egy elefántot, ami aztán eltapossa... Egyébként, be lehet öltözni karbantartónak, és bejönni, hogy kivegyük!
K: – Köszönöm a prezentációt. Szergely ("Yandex"). A "Mongóban" van egy konstans, amely korlátozza a szavazásra jogosult tagok számát a Replica Set-ben, és ez a konstans 7 (hét). Miért ez a konstans? Miért nem valami paraméter?
MT: – A Replica Set-ünk lehet akár 40 csomópont is. Ott mindig megvan a többség. Nem tudom, hogy melyik verzió...
K: – A Replica Set-ben nem szavazó tagokat is lehet indítani, de a szavazók maximum 7. Hogyan tudjuk ebben az esetben elviselni a leállást, ha a Replica Set három adatközpont között van? Az egyik adatközpont simán le tud állni, és egy másik gép is kieshet.
MT: – Ez már kicsit túl van a prezentáción. Ez egy általános kérdés. Talán később elmondhatom.
Egy kis reklám 🙂
Köszönjük, hogy velünk maradtál. Tetszenek a cikkeink? Szeretnél több érdekes anyagot látni? Támogass minket, és rendelés leadásával vagy ismerősöknek ajánlással segíts nekünk. , Egyedülálló alternatívája az entry-level szervereknek, amelyet Önnek találtunk ki: (elérhetők RAID1 és RAID10 opciók, akár 24 magig és 40GB DDR4-ig).
Dell R730xd kétszer olcsóbban a Tier IV Equinix adatközpontban Amszterdamban? Csak nálunk Hollandiában! Dell R420 — 2x E5-2430 2.2GHz 6C 128GB DDR3 2x960GB SSD 1Gbps 100TB — 99 dollártól! Olvasd el ezt
Forrás: habr.com
