

Megjegyzés fordítás.: Ebben a cikkben a Banzai Cloud bemutatja annak az egyedi eszközének használatát, amely megkönnyíti a Kafka üzemeltetését a Kubernetes keretein belül. A bemutatott utasítások szemléltetik, hogyan lehet meghatározni az optimális infrastruktúra méretét és beállítani magát a Kafkát a szükséges áteresztőképesség eléréséhez.
Az Apache Kafka egy elosztott streamelő platform, amely megbízható, skálázható és nagy teljesítményű valós idejű adatfolyam rendszerek létrehozására szolgál. Figyelemre méltó képességeit a Kubernetes segítségével lehet tovább bővíteni. Ehhez kidolgoztuk és egy eszközt, amelyet hívunk. Ezek lehetővé teszik a Kafka futtatását Kubernetes-ben, és kihasználhatjuk számos funkcióját, például a broker konfiguráció finomhangolását, a metrikák alapú skálázást újra egyensúlyozással, a rack awareness-t (hardver erőforrások tudomásul vétele), a „lágy” (graceful) frissítések kiadását stb.
Próbálja ki a Supertubes-t a klaszterében:
curl https://getsupertubes.sh | sh és supertubes install -a --no-democluster --kubeconfigVagy lépjen kapcsolatba a -kal. Emellett olvashat a Kafka számos funkciójáról, amelyek automatizálásra kerültek a Supertubes és a Kafka operátor segítségével. Ezekről már írtunk a blogunkban:
- ;
- ;
- ;
- ;
- ;
- ;
- .
Ha úgy dönt, hogy Kafka klasztert telepít Kubernetes-be, valószínűleg szembesül majd a megfelelő alapinfrastruktúra méretének meghatározásával és a Kafka konfigurációjának finomhangolásának szükségességével az áteresztőképességi követelmények kielégítése érdekében. Minden broker maximális teljesítménye az alapjául szolgáló infrastruktúra komponensek teljesítményétől függ, mint például a memória, a processzor, a lemez sebessége, a hálózati sávszélesség stb.
Ideális esetben a brókerek konfigurációja úgy kellene, hogy alakuljon, hogy az összes infrastruktúraelem maximális kapacitásával működhessen. Azonban a valóságban ez a beállítás meglehetősen bonyolult. Sokkal valószínűbb, hogy a felhasználók a brókerek konfigurációját úgy állítják be, hogy egy vagy két komponens (tároló, memória vagy processzor) maximális kihasználása érdekében optimalizálják. Általánosságban elmondható, hogy a bróker a legjobb teljesítményt akkor nyújtja, amikor a konfigurációja lehetővé teszi a leglassabb komponens „teljes kihasználását”. Így körülbelül megérthetjük, milyen terhelésnek képes megfelelni egy bróker.
Elméletileg a brókerek számát is megbecsülhetjük, amely szükséges egy adott terhelés kezelésére. A gyakorlatban azonban a különböző szintű beállítási lehetőségek olyan számosak, hogy meglehetősen nehéz (ha nem lehetetlen) megbecsülni egy adott konfiguráció potenciális teljesítményét. Más szavakkal: nehéz olyan konfigurációt tervezni, amely egy adott teljesítményre alapozva történik.
A Supertubes felhasználói számára általában a következő megközelítést alkalmazzuk: egy adott konfigurációval (infrastruktúra + beállítások) kezdünk, majd mérjük a teljesítményét, kiigazítjuk a bróker beállításait és újra ismételjük a folyamatot. Ez addig folytatódik, amíg az infrastruktúra leglassabb komponensének potenciálját teljesen ki nem használjuk.
Ezzel a módszerrel világosabb képet kapunk arról, hogy hány bróker szükséges a klaszternek ahhoz, hogy kezelni tudjon egy adott terhelést (a brókerek száma más tényezőktől is függ, például a reziliencia biztosításához szükséges minimális üzenetreplica számától, a partíció-vezetők számától stb.). Ezenkívül képet kapunk arról is, hogy melyik infrastruktúraelemet javasolt függőlegesen skálázni.
Ebben a cikkben arról lesz szó, hogy milyen lépéseket teszünk annak érdekében, hogy „kihozzunk mindent” a leglassabb komponensekből a kezdeti konfigurációkban, és hogyan mérjük a Kafka klaszter áteresztőképességét. A magas rendelkezésre állású konfiguráció legalább három működő brókert igényel (min.insync.replicas=3), amelyek három különböző elérhetőségi zónára vannak osztva. A Kubernetes infrastruktúra beállításához, méretezéséhez és monitorozásához saját konténerkezelő platformunkat használjuk hibrid felhőkhoz — . Támogatja az on-premise (bare metal, VMware) és öt különböző felhőtípust (Alibaba, AWS, Azure, Google, Oracle), valamint ezek bármilyen kombinációját.
Gondolatok a Kafka infrastruktúrájáról és a klaszter konfigurálásáról
A következő példákhoz az AWS-t választottuk felhőszolgáltatóként és az EKS-t Kubernetes disztribúcióként. Hasonló konfiguráció valósítható meg — a Banzai Cloud Kubernetes disztribúciója, amelyet a CNCF tanúsított.
Lemez
Az Amazon különböző . Az alapja gp2 és io1 SSD meghajtók, azonban a nagy sávszélesség biztosításához gp2 az összegyűjtött krediteket használja (I/O kreditek), ezért egy olyan típust választottunk, io1, amely stabil, magas sávszélességet kínál.
Az instances típusa
A Kafka teljesítménye nagymértékben függ az operációs rendszer lapcache-étől, ezért elegendő memóriával kell rendelkeznünk a broker számára (JVM) és a lapcache-hez. A c5.2xlarge nagyszerű kezdet, mivel 16 GB memóriát kínál és Hátránya, hogy maximális teljesítményt legfeljebb 30 percig képes biztosítani 24 órán belül. Ha a munkaterhelés hosszabb ideig igényli a maximális teljesítményt, érdemes más instance típusokat is megfontolni. Mi így is tettünk, és a c5.4xlargetípus mellett döntöttünk. Ez biztosítja a maximális sávszélességet 593,75 MB/s. Az EBS kötet maximális sávszélessége io1 nagyobb, mint az instance-é, c5.4xlargeezért az infrastruktúra leglassabb eleme vélhetően a VM instance I/O sávszélessége (amit a terhelési tesztjeink eredményei is megerősíthetnek).
Hálózat
A hálózati sávszélességnek elegendően nagynak kell lennie az VM instance és a lemez teljesítményéhez képest, különben a hálózat szűk keresztmetszetté válik. A mi esetünkben a hálózati interfész c5.4xlarge 10 Gb/s-ig támogatott, ami jelentősen meghaladja a VM instance I/O sávszélességét.
Broker-ek telepítése
A brókereknek dedikált csomópontokon kell futniuk (Kubernetes-ben üzembe helyezve), hogy elkerüljék a versenyt más folyamatokkal a processzor, memória, hálózat és lemez erőforrásaiért.
Java verzió
A logikus választás a Java 11, mivel az kompatibilis a Dockerrel abban az értelemben, hogy a JVM helyesen azonosítja a brokerhez elérhető processzorokat és memóriát. Tudva, hogy a processzorlimitek fontosak, a JVM belsőleg és átláthatóan beállítja a GC és JIT fordító szálak számát. Mi a következő képet használtuk: banzaicloud/kafka:2.13-2.4.0, amely tartalmazza a Kafka 2.4.0 (Scala 2.13) verziót Java 11-en.
Ha többet szeretne tudni a Java/JVM Kubernetes-en végzett használatáról, figyeljen a következő kiadványainkra:
- ;
- .
Broker memória beállításai
Két kulcsfontosságú aspektusa van a broker memória beállításának: a JVM és a Kubernetes pod beállításai. A pod-ra beállított memóriahatárnak nagyobbnak kell lennie, mint a maximális heap size, hogy a JVM-nek helye maradjon a Java metatér számára, amely saját memóriában található, és az operációs rendszer lapkészletének, amelyet a Kafka aktívan használ. A tesztjeinkben a Kafka brókereket a következő paraméterekkel futtattuk: -Xmx4G -Xms2G, míg a pod memóriahatára 10 Gi. Vegye figyelembe, hogy a JVM memória beállításai automatikusan is nyerhetők a következőkkel: -XX:MaxRAMPercentage és -X:MinRAMPercentage, a pod memóriahatárának megfelelően.
Broker CPU beállításai
Általánosságban elmondható, hogy a párhuzamosság növelésével javítható a teljesítmény a Kafka által használt szálak számának növelésével. Minél több processzor áll rendelkezésre a Kafka számára, annál jobb. Tesztünkben 6 processzor limitjével kezdtünk, és fokozatosan (iterációkkal) növeltük a számot 15-re. Ezenkívül beállítottuk num.network.threads=12 a broker beállításaiban, hogy növeljük a hálózatról érkező és azokat küldő szálak számát. Azonnal észrevettük, hogy a követő brókerek nem tudják elég gyorsan megkapni a replikákat, így emeltük num.replica.fetchers 4-re, hogy növeljük a követő brókerek üzenet replikációs sebességét a vezetőktől.
Terhelésgeneráló eszköz
Fontos biztosítani, hogy a választott terhelésgenerátor potenciálja ne merüljön ki, mielőtt a Kafka klaszter (amelynek benchmarkingját végezzük) elérné maximális terhelését. Más szavakkal, előzetes értékelést kell végezni a terhelésgenerátor lehetőségeiről, és olyan instance típusokat kell választani, amelyek elegendő CPU-t és memóriát biztosítanak. Ebben az esetben az eszközünk nagyobb terhelést fog produkálni, mint amit a Kafka klaszter kezelni tud. Számos kísérlet után három instance-nál álltunk meg c5.4xlarge, mindegyikben elindítottuk a generátort.
Benchmarking
A teljesítmény mérés egy iteratív folyamat, amely a következő szakaszokat tartalmazza:
- az infrastruktúra beállítása (EKS klaszter, Kafka klaszter, terhelésgeneráló eszköz, valamint Prometheus és Grafana);
- terhelés generálása egy adott időszak során a teljesítménymutatókban tapasztalható véletlenszerű eltérések kiszűrésére;
- az infrastruktúra és a bróker konfigurálásának finomítása a megfigyelt teljesítménymutatók alapján;
- a folyamat megismétlése, amíg el nem érjük a kívánt Kafka klaszter áteresztőképességi szintjét. Ennek stabilan reprodukálhatónak kell lennie, és minimális variációkat kell mutatnia az áteresztőképességben.
A következő részben ismertetjük a lépéseket, amelyeket a teszt klaszter benchmarking folyamata során végeztünk.
Eszközök
A gyors alapkonfiguráció, terhelésgenerálás és teljesítménymérés érdekében a következő eszközöket használtuk:
- az Amazon EKS klaszterének szervezéséhez (a Kafka és az infrastruktúra metrikáinak gyűjtésére) és (e metrikák vizualizálására). Igénybe vettük a integrált be. szolgáltatásokat, amelyek biztosítják a federális megfigyelést, a központosított naplógyűjtést, a sebezhetőségek szkennelését, a hibahelyreállítást, a vállalati szintű biztonságot és még sok mást.
- — eszköz a Kafka klaszter terheléses tesztelésére.
- Grafana panelek a Kafka és az infrastruktúra metrikáinak vizualizálására: , .
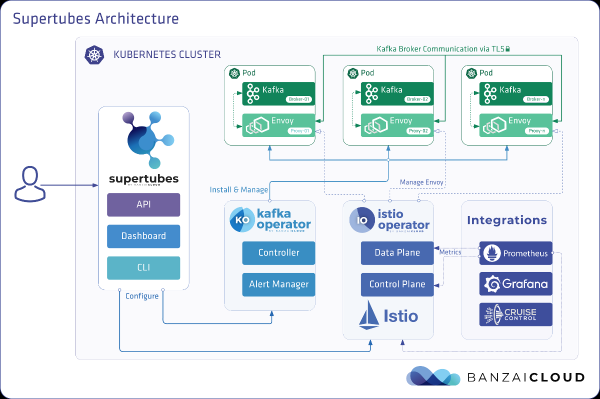
- A Supertubes CLI a Kafka klaszter egyszerű beállításához Kubernetes alatt. A Zookeeper, Kafka operátor, Envoy és számos más összetevő telepítve van, és megfelelően konfigurálva van egy production-kész Kafka klaszter futtatására Kubernetesben.
- A telepítéshez supertubes CLI használja a megadott utasításokat .
EKS klaszter
Készítse elő az EKS klasztert dedikált munkacsomópontokkal c5.4xlarge különböző elérhetőségi zónákban a Kafka broker podok számára, valamint dedikált csomópontok a terhelésgeneráló és megfigyelési infrastruktúrához.
banzai cluster create -f https://raw.githubusercontent.com/banzaicloud/kafka-operator/master/docs/benchmarks/infrastructure/cluster_eks_202001.jsonAmikor az EKS klaszter működni kezd, aktiválja az integrált — ez telepíti a Prometheust és a Grafanát a klaszterre.
Kafka rendszerelemek
Telepítse a Kafka rendszerelemeket (Zookeeper, kafka-operator) az EKS-be supertubes CLI használatával:
supertubes install -a --no-democluster --kubeconfigKafka klaszter
Az EKS-ben alapértelmezés szerint EBS típusú tárolók használatosak, gp2, ezért egy külön tárolóosztályt kell létrehozni a klaszterhez io1 :
kubectl create -f - <<EOF
apiVersion: storage.k8s.io/v1
kind: StorageClass
metadata:
  name: fast-ssd
provisioner: kubernetes.io/aws-ebs
parameters:
  type: io1
  iopsPerGB: "50"
  fsType: ext4
volumeBindingMode: WaitForFirstConsumer
EOF
Állítson be paramétert a broker számára min.insync.replicas=3 és telepítse a broker podokat a csomópontokon három különböző elérhetőségi zónában:
supertubes cluster create -n kafka --kubeconfig -f https://raw.githubusercontent.com/banzaicloud/kafka-operator/master/docs/benchmarks/infrastructure/kafka_202001_3brokers.yaml --wait --timeout 600Témák
Párhuzamosan három terhelésgenerátor példányt futtattunk. Mindegyik saját témájába ír, tehát összesen három témára van szükségünk:
supertubes cluster topic create -n kafka --kubeconfig  -f -<<EOF
apiVersion: kafka.banzaicloud.io/v1alpha1
kind: KafkaTopic
metadata:
  name: perftest1
spec:
  name: perftest1
  partitions: 12
  replicationFactor: 3
  retention.ms: '28800000'
  cleanup.policy: delete
EOF

supertubes cluster topic create -n kafka --kubeconfig  -f -<<EOF
apiVersion: kafka.banzaicloud.io/v1alpha1
kind: KafkaTopic
metadata:
    name: perftest2
spec:
  name: perftest2
  partitions: 12
  replicationFactor: 3
  retention.ms: '28800000'
  cleanup.policy: delete
EOF

supertubes cluster topic create -n kafka --kubeconfig  -f -<<EOF
apiVersion: kafka.banzaicloud.io/v1alpha1
kind: KafkaTopic
metadata:
  name: perftest3
spec:
  name: perftest3
  partitions: 12
  replicationFactor: 3
  retention.ms: '28800000'
  cleanup.policy: delete
EOF
Minden témához a replikációs faktornak 3-nak kell lennie — ez a minimum ajánlott érték a magas rendelkezésre állású production rendszerek esetén.
Terhelésgeneráló eszköz
Három példányt indítottunk el a terhelés-generátorból (mindegyik külön témába írt). A terhelés-generátor podjainak esetében meg kell határozni a node affinitást, hogy csak az őket kijelölt csomópontokra ütemezzék őket:
apiVersion: extensions/v1beta1
kind: Deployment
metadata:
  labels:
    app: loadtest
  name: perf-load1
  namespace: kafka
spec:
  progressDeadlineSeconds: 600
  replicas: 1
  revisionHistoryLimit: 10
  selector:
    matchLabels:
      app: loadtest
  strategy:
    rollingUpdate:
      maxSurge: 25%
      maxUnavailable: 25%
    type: RollingUpdate
  template:
    metadata:
      creationTimestamp: null
      labels:
        app: loadtest
    spec:
      affinity:
        nodeAffinity:
          requiredDuringSchedulingIgnoredDuringExecution:
            nodeSelectorTerms:
            - matchExpressions:
              - key: nodepool.banzaicloud.io/name
                operator: In
                values:
                - loadgen
      containers:
      - args:
        - -brokers=kafka-0:29092,kafka-1:29092,kafka-2:29092,kafka-3:29092
        - -topic=perftest1
        - -required-acks=all
        - -message-size=512
        - -workers=20
        image: banzaicloud/perfload:0.1.0-blog
        imagePullPolicy: Always
        name: sangrenel
        resources:
          limits:
            cpu: 2
            memory: 1Gi
          requests:
            cpu: 2
            memory: 1Gi
        terminationMessagePath: /dev/termination-log
        terminationMessagePolicy: File
      dnsPolicy: ClusterFirst
      restartPolicy: Always
      schedulerName: default-scheduler
      securityContext: {}
      terminationGracePeriodSeconds: 30
Néhány dolog, amire érdemes figyelni:
- A terhelés-generátor 512 byte méretű üzeneteket generál, és 500 üzenetből álló csomagokban publikálja őket a Kafka-ban.
- Az alábbi argumentummal
-required-acks=alla publikálás akkor minősül sikeresnek, ha az összes szinkronizált üzenet-replika megérkezik és a Kafka broker-ek által megerősítésre kerül. Ez azt jelenti, hogy a benchmark során nemcsak a vezető broker-ek üzeneteket fogadó sebességét, hanem a követőiket is mértük, amelyek replikálják az üzeneteket. Az adott teszt célja nem a fogyasztók általi újonnan érkezett üzenetek olvasási sebességének értékelése, (consumers) amelyek még az operációs rendszer lapkészítő cache-jében vannak, és ennek összehasonlítása a lemezen tárolt üzenetek olvasási sebességével. - A terhelés-generátor párhuzamosan 20 munkás (
-workers=20) példányát indítja el. Minden munkás 5 producer-t tartalmaz, amelyek közösen használják a munkás csatlakozását a Kafka klaszterhez. Így minden generátor összesen 100 producer-t számlál, és mindegyik üzeneteket küld a Kafka klaszterre.
A klaszter állapotának megfigyelése
A terheléses tesztelés alatt a Kafka klaszter egészségét is figyeltük, hogy megbizonyosodjunk arról, hogy nincsenek pod újraindítások, szinkronizálatlan replikák és maximális áteresztőképesség minimális fluktuációk mellett:
- A terhelésgeneráló által rögzített statisztikák a közzétett üzenetek számáról és a hibaszintről szólnak. A hibák arányának értékének alacsonyan kell maradnia
0,00%. - , amelyet a kafka-operator telepít, egy olyan monitoring panelt biztosít, ahol figyelemmel kísérhetjük a klaszter állapotát. A panel megnyitásához futtassa:
supertubes cluster cruisecontrol show -n kafka --kubeconfig - ISR szint (a szinkronban lévő replikák száma) a shrink és expansion 0.
Mért eredmények
3 broker, üzenetméret — 512 bájt
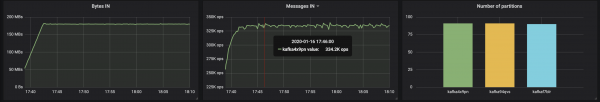
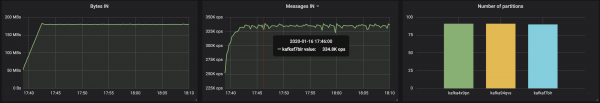
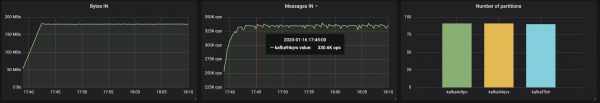
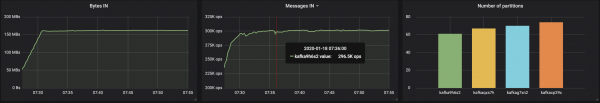
A partition-ök egyenletes elosztásával három broker között sikerült elérni a ~500 MB/s (kb. 990 ezer üzenet másodpercenként):
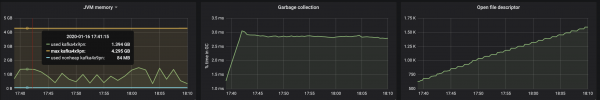
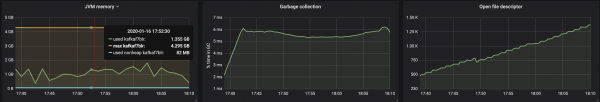
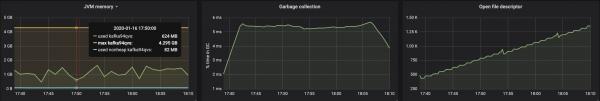
A JVM virtuális gép memóriafogyasztása nem haladta meg a 2 GB-ot:
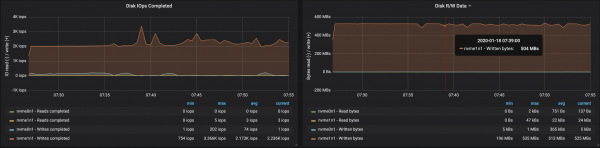
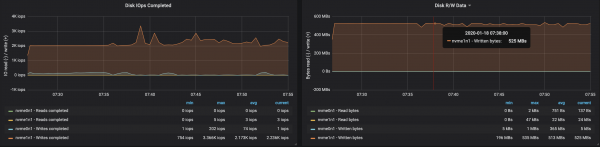
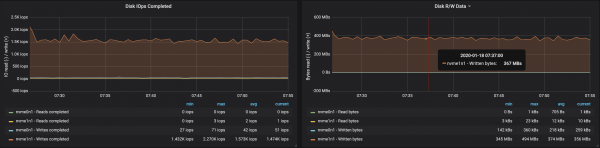
A lemezelérési sebesség elérte az I/O csomópont maximális áteresztőképességét mindhárom broker esetében:
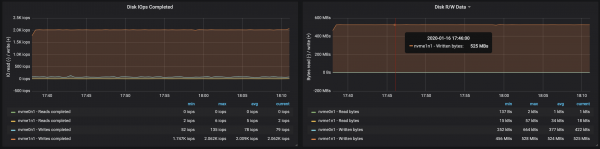
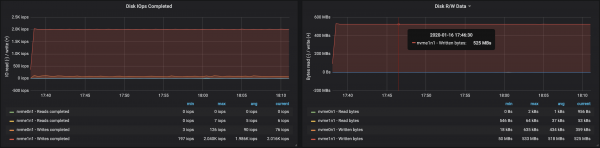
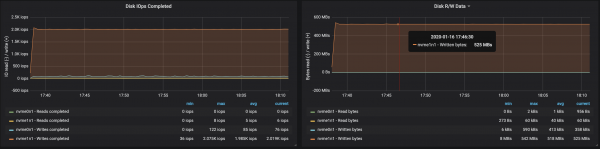
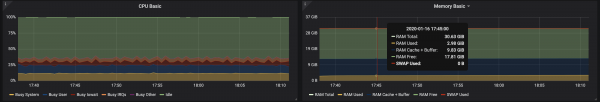
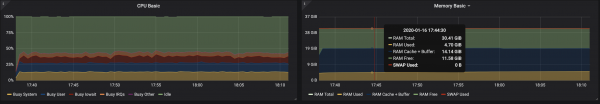
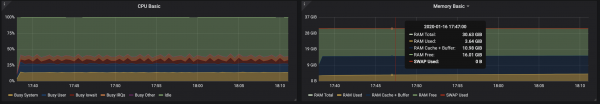
A csomópontok memóriahasználatából adódóan a rendszeres pufferelés és gyorsítótárazás körülbelül 10-15 GB-ot használt fel:
3 broker, üzenetméret — 100 bájt
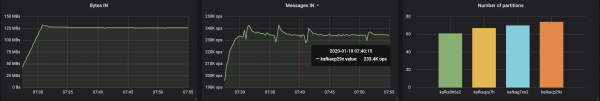
Az üzenetméret csökkentésekből adódóan az áteresztőképesség körülbelül 15-20%-kal csökken: ez a feldolgozási időt érinti minden egyes üzenetnél. Ráadásul a CPU terhelése majdnem megduplázódott.
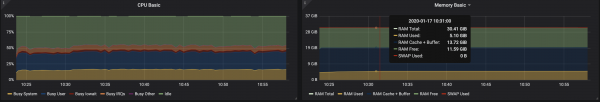
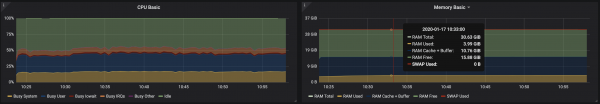
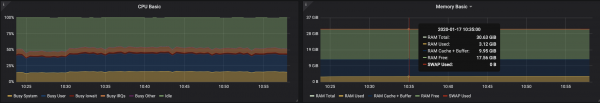
Mivel a broker csomópontokon még mindig vannak kihasználatlan magok, a Kafka konfiguráció módosításával javítható a teljesítmény. Ez nem egyszerű feladat, ezért a nagyobb méretű üzenetekkel való munka a legjobb az áteresztőképesség növeléséhez.
4 broker, üzenetméret — 512 bájt
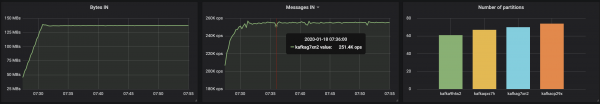
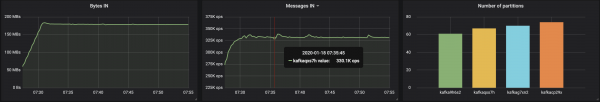
A Kafka klaszter teljesítményét könnyedén növelhetjük, ha új brokereket adunk hozzá, miközben megőrizzük a partition-ok egyensúlyát (ez biztosítja a terhelés egyenletes elosztását a broker-ek között). Ebben az esetben a broker hozzáadását követően a klaszter áteresztőképessége nőtt ~580 MB/s (~1,1 millió üzenet másodpercenként). A növekedés kisebb lett, mint amire számítottunk: elsősorban a partition-ok egyensúlyhiányával magyarázható (nem minden broker dolgozik a maximális kapacitásán).
A JVM gép memóriakihasználása 2 GB alatt maradt:
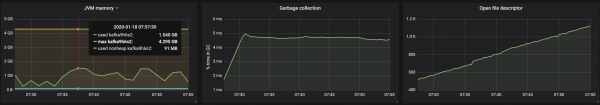
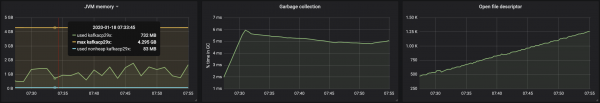
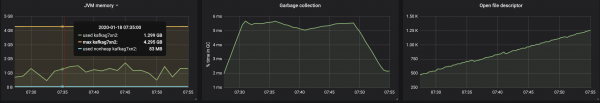
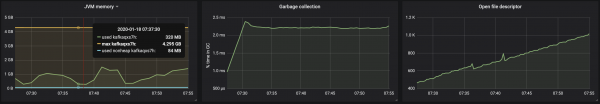
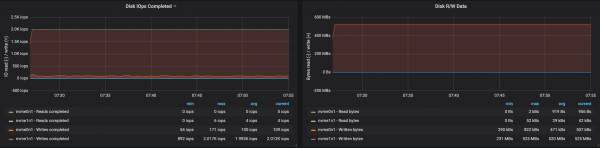
A brókerek munkáját a partíciók közötti egyensúlyhiány befolyásolta:
Következtetések
A fent bemutatott iteratív megközelítés kiterjeszthető bonyolultabb forgatókönyvekre, amelyek számos fogyasztót, újraparticionálást, frissítéseket, podok újraindítását stb. tartalmaznak. Mindez lehetővé teszi számunkra, hogy felmérjük a Kafka klaszter korlátait különböző körülmények között, azonosítva a szűk keresztmetszeteket, és megtalálva a megoldásokat.
Kifejlesztettük a Supertubes-t a klaszter gyors és könnyű telepítésére, konfigurálására, a brókerek és a témák hozzáadására/törlésére, riasztásokra való reagálásra, valamint a Kafka megfelelő működésének biztosítására a Kubernetesben. Célunk, hogy segítsünk a fő feladatra összpontosítani (a Kafka üzenetek "előállítása" és "fogyasztása"), míg a nehéz munkát a Supertubes-ra és a Kafka operátorra bízzuk.
Ha érdekli a Banzai Cloud technológiái és nyílt forráskódú projektjei, kövesse a céget a , vagy .
Fejlesztési eszközök, amelyek Kubernetesben futnak
Olvasson további információkat a blogunkban:
- «»;
- «»;
- «».
Forrás: habr.com
