

Az írás fordítása kifejezetten a kurzus hallgatói számára készült .
Az elmúlt néhány hétben hozzáadtuk a bináris stream formátumot, kiegészítve a már meglévő random access / IPC fájlformátumot. Van megvalósításunk Java és C++ nyelveken, valamint Python összekötők. Ebben a cikkben elmondom, hogyan működik a formátum, és megmutatom, hogyan lehet nagyon magas adatáttételt elérni a pandas DataFrame esetében.
Osztott adatok streamelése
Gyakori kérdés, amit az Arrow felhasználóitól kapok, az a probléma, hogy miért olyan költséges nagy táblázatos adatállományokat átkonvertálni a sor-orientált vagy rekordszerű formátumból oszloporientált formátumba. A több gigabájtos adathalmazok esetében a memória- vagy lemezbeli transzponálás megoldhatatlan feladat lehet.
Adatok streamelésénél, függetlenül attól, hogy az alapadatok sor- vagy oszloporientáltak, az egyik lehetőség, hogy kisebb, oszlopok szerinti elrendezést tartalmazó sorcsomagokat küldünk.
Az Apache Arrow-ban a memóriában lévő oszlopos tömbök gyűjteményét, amely egy táblázat chunk-ját képviseli, rekordcsomagnak (record batch) hívjuk. Az adatok logikai táblázatának egyetlen struktúrába történő képviseletéhez több rekordcsomagot is összegyűjthetünk.
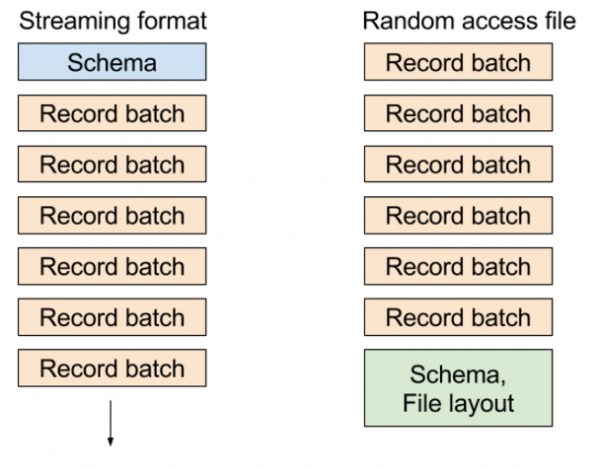
A meglévő random access fájlformátumban metaadatokat írunk, amelyek a táblázat sémáját és a blokkok helyét tartalmazzák a fájl végén, ami lehetővé teszi, hogy rendkívül alacsony költséggel válasszunk ki bármely rekordcsomagot vagy oszlopot az adathalomból. Streamelt formátumban sorozatban küldjük az üzeneteket: a sémát, majd egy vagy több rekordcsomagot.
A különböző formátumok a következőképpen néznek ki:
Adatok streamelése PyArrow-ban: alkalmazás
Hogy megmutassam, hogyan működik ez, létrehozok egy példát, amely egy streamelt chunkot reprezentál:
import time
import numpy as np
import pandas as pd
import pyarrow as pa

def generate_data(total_size, ncols):
    nrows = int(total_size / ncols / np.dtype('float64').itemsize)
    return pd.DataFrame({
        'c' + str(i): np.random.randn(nrows)
        for i in range(ncols)
    })
Most feltételezzük, hogy 1 Gb adatot szeretnénk írni, amely 1 Mb-os chunkokból áll, összesen 1024 chunkot. Először is, hozzunk létre egy 1 Mb-os méretű első DataFrame-t 16 oszloppal:
KILOBYTE = 1 << 10
MEGABYTE = KILOBYTE * KILOBYTE
DATA_SIZE = 1024 * MEGABYTE
NCOLS = 16

df = generate_data(MEGABYTE, NCOLS)
Ezután ezeket átkonvertálom pyarrow.RecordBatch:
batch = pa.RecordBatch.from_pandas(df) Most már létrehozok egy kimeneti folyamatot, amely a memóriába fog írni, és létrehozok StreamWriter:
sink = pa.InMemoryOutputStream()
stream_writer = pa.StreamWriter(sink, batch.schema)
Ezután 1024 darabot írunk be, amelyek végül 1 GB adathalmazt alkotnak:
for i in range(DATA_SIZE // MEGABYTE):
    stream_writer.write_batch(batch)
Mivel a RAM-ba írtunk, az egész folyamatot egyetlen pufferben kaphatjuk meg:
In [13]: source = sink.get_result()

In [14]: source
Out[14]:

In [15]: source.size
Out[15]: 1074750744
Mivel ezek az adatok a memóriában vannak, az Arrow rekordcsomagok olvasása zero-copy műveletnek számít. Megnyitom a StreamReader-t, és olvasom az adatokat pyarrow.Table, majd átkonvertálom őket DataFrame pandas:
In [16]: reader = pa.StreamReader(source)

In [17]: table = reader.read_all()

In [18]: table
Out[18]:

In [19]: df = table.to_pandas()

In [20]: df.memory_usage().sum()
Out[20]: 1073741904
Mindez persze jó, de kérdései lehetnek. Milyen gyorsan történik ez? Hogyan befolyásolja a csomag mérete a DataFrame pandas megkapásának teljesítményét?
Adatfolyama teljesítménye
A csomag méretének csökkentésével az adatfolyam újbóli felépítésének költsége a pandas-ban található folyamatos oszlopos DataFrame-ben megnövekszik a nem hatékony gyorsítótárazási sémák miatt. Vannak további költségek is a C++ adatstruktúrák és tömbök, valamint azok memória puffereinek kezeléséből.
1 MB esetén, ahogy fent említettem, az én laptopomon (Quad-core Xeon E3-1505M) a következőket kapom:
In [20]: %timeit pa.StreamReader(source).read_all().to_pandas()
10 loops, best of 3: 129 ms per loop
Tehát a hatékony átvitel sebessége 7,75 GB/s, amikor 1 GB-os DataFrame-t állítunk helyre 1024 darab 1 MB-os csomagból. Mi történik, ha nagyobb vagy kisebb csomagokat használunk? Ilyen eredmények születnek:
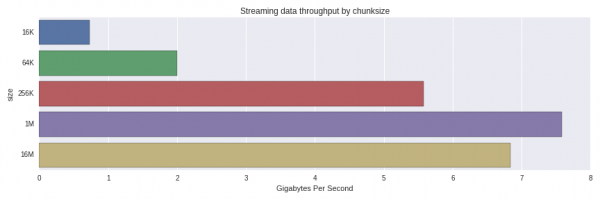
A teljesítmény jelentősen csökken a 256K-ról 64K csomagokra. Meglepett, hogy az 1 MB-os csomagok gyorsabban kerültek feldolgozásra, mint a 16 MB-osak. Érdemes lenne alaposabb kutatást végezni és megérteni, hogy ez normális eloszlás-e, vagy hogy van-e más befolyásoló tényező.
A formátum aktuális megvalósításában az adatok alapvetően nem össze vannak tömörítve, ezért a memória mérete és a "vezetékeken" való méret körülbelül azonos. A jövőben a tömörítés plusz opcióvá válhat.
Result
A oszlopos adatok streamelése hatékony módja lehet nagy adathalmazok átadásának oszlopos elemző eszközökbe, például a pandasba, kis darabokban. Azok az adatszolgáltatások, amelyek sororientált tárolást használnak, képesek kisebb adathalmozott blokkokat átadni és transzponálni, amelyek jobban illeszkednek a CPU L2 és L3 gyorsítótárához.
Teljes kód
import time
import numpy as np
import pandas as pd
import pyarrow as pa

def generate_data(total_size, ncols):
    nrows = total_size / ncols / np.dtype('float64').itemsize
    return pd.DataFrame({
        'c' + str(i): np.random.randn(nrows)
        for i in range(ncols)
    })

KILOBÁJT = 1 << 10
MEGABÁJT = KILOBÁJT * KILOBÁJT
ADAT_MÉRET = 1024 * MEGABÁJT
NCOLS = 16

def get_timing(f, niter):
    start = time.clock_gettime(time.CLOCK_REALTIME)
    for i in range(niter):
        f()
    return (time.clock_gettime(time.CLOCK_REALTIME) - start) / NITER

def read_as_dataframe(klass, source):
    reader = klass(source)
    table = reader.read_all()
    return table.to_pandas()
NITER = 5
results = []

DARAB_MÉRETEK = [16 * KILOBÁJT, 64 * KILOBÁJT, 256 * KILOBÁJT, MEGABÁJT, 16 * MEGABÁJT]

for chunksize in DARAB_MÉRETEK:
    nchunks = ADAT_MÉRET // chunksize
    batch = pa.RecordBatch.from_pandas(generate_data(chunksize, NCOLS))

    sink = pa.InMemoryOutputStream()
    stream_writer = pa.StreamWriter(sink, batch.schema)

    for i in range(nchunks):
        stream_writer.write_batch(batch)

    source = sink.get_result()

    elapsed = get_timing(lambda: read_as_dataframe(pa.StreamReader, source), NITER)

    result = (chunksize, elapsed)
    print(result)
    results.append(result)
Forrás: habr.com
