

Helló, Habr!
Emlékeztetjük, hogy megjelent a legújabb rendkívül érdekes és hasznos a Kubernetes mintázatairól. Minden a "" Brendan Burns-től indult, és egyébként a munkánk ezen a területen . Ma ajánljuk önöknek a MinIO blogjából származó cikket, amely röviden összefoglalja a Kubernetes adatkezelési mintázatainak tendenciáit és sajátosságait.
A Kubernetes alapjaiban megváltoztatta a hagyományos alkalmazásfejlesztési és telepítési mintákat. Most a csapatoknak csak néhány napra van szükségük az alkalmazás fejlesztésére, tesztelésére és telepítésére – különböző környezetekben, mindez Kubernetes klasztereken belül. Az ilyen munka a korábbi generációs technológiákkal általában hetekbe, ha nem hónapokba telt.
Ez a felgyorsulás a Kubernetes által biztosított absztrakciónak köszönhető – azaz annak, hogy a Kubernetes saját maga kezeli az alacsony szintű részleteket a fizikai vagy virtuális gépekkel, lehetővé téve a felhasználók számára, hogy többek között kijelöljék a szükséges processzort, a szükséges memória mennyiséget, valamint a konténer példányok számát. Mivel a Kubernetes támogatásában egy hatalmas közösség dolgozik, és a Kubernetes alkalmazásának mértéke folyamatosan bővül, a tartályorchestration platformok között messze vezet.
Ahogy a Kubernetes használata bővül, úgy nő a zűrzavar is a benne alkalmazott adatkezelési mintázatok körül.
Mivel mindenki verseng a Kubernetes „tortájáért” (azaz az adatkezelésért), amikor az adatok tárolására kerül a sor, a jel itt egy erős zajban elvész.
A Kubernetes megtestesíti a modern alkalmazásfejlesztési és telepítési modellt, valamint azok kezelését. Ez a modern modell leválasztja az adatkezelést a számításokról. Ahhoz, hogy teljesen megértsük ezt a leválasztást a Kubernetes kontextusában, meg kell értenünk, hogy mik is azok az állapotot megőrző és az állapotot nem megőrző alkalmazások, valamint hogyan illeszkedik ehhez az adatkezelés. Éppen itt a REST API megközelítés, amelyet az S3 alkalmaz, egyértelmű előnyökkel rendelkezik a POSIX/CSI megközelítéssel szemben, amely más megoldásokra jellemző.
Ebben a cikkben a Kubernetes adatkezelési mintáiról fogunk beszélni, és külön foglalkozunk a tartós és állapot nélküli alkalmazásokkal, hogy alaposan megértsük, mi a különbség közöttük, és miért fontos ez. A szöveg további részében az alkalmazásokat és az azokban használt adatkezelési mintákat vizsgáljuk meg a konténerek és a Kubernetes legjobb gyakorlatai fényében.
Állapot nélküli konténerek
A konténerek természetüknél fogva könnyűek és efemeriek. Ezeket könnyedén leállíthatjuk, törölhetjük vagy másik csomóponton telepíthetjük – mindez néhány másodpercet vesz igénybe. Nagyobb konténer-orchestration rendszerekben ezek a műveletek folyamatosan zajlanak, és a felhasználók még csak észre sem veszik ezeket a változásokat. Azonban a mozgás csak akkor lehetséges, ha a konténernek nincsenek függőségei a csomóponttól, amelyen éppen található. Az ilyen konténerekről azt mondják, hogy állapot nélkül működnek. állapot nélkül.
Állapotú konténerek
Ha egy konténer helyi csatlakoztatott eszközökön (vagy blokkszinten) tárol adatokat, akkor az adatokat tároló tárolót a konténerrel együtt egy új csomópontba is át kell helyezni – hibásodás esetén. Ez fontos, mert különben az adott konténerben futó alkalmazás nem működik helyesen, mivel hozzá kell férnie a helyi tárolókon elmentett adatokhoz. Az ilyen konténerekről azt mondják, hogy állapotosan működnek. állapotosan.
Tiszta technikai szempontból az állapotú konténereket is lehet más csomópontokra helyezni. Ezt általában elosztott fájlrendszerekkel vagy a konténerek által használt összes csomóponthoz csatolt blokkhálózati adattárolókkal biztosítják. Így a konténerek hozzáférnek a tartós adatok tárolására szolgáló kötetekhez, és az információk a hálózatban szétszórt lemezeken tárolódnak. Ezt a módszert 'állapotú konténer megközelítésnek' fogom nevezni, és a cikk hátralévő részében így fogom említeni az egységesség kedvéért.
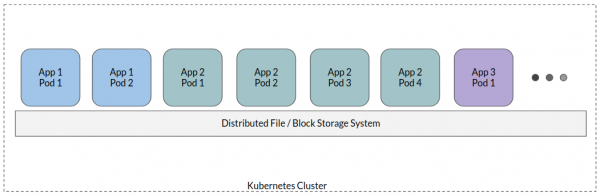
A tipikus állapot-megtartó konténeres megközelítés esetén az alkalmazások összes podja egy megosztott fájlrendszerhez csatlakozik – ez egyfajta megosztott tárolónak számít, ahol az alkalmazások összes adatát tárolják. Bár bizonyos eltérések lehetségesek, ez egy magas szintű megközelítés.
Most nézzük meg, miért tekinthető az állapot-megtartó konténeres megközelítés antipatternnek a felhőorientált világban.
Felhőorientált alkalmazás-tervezés
Hagyományosan az alkalmazások adatbázisokat használtak az információ strukturált tárolására, és helyi lemezeket vagy megosztott fájlrendszereket, ahová minden strukturálatlan vagy akár félig strukturált adatot kiírtak. Ahogy a strukturálatlan adatok mennyisége nőtt, a fejlesztők rájöttek, hogy a POSIX túl "beszédes", jelentős költségekkel jár, és végső soron akadályozza az alkalmazás működését, ha valóban nagy méretekre akarunk váltani.
Ez főként hozzájárult egy új adatkezelési szabvány megjelenéséhez, nevezetesen a felhőorientált tárolókéhoz, amelyek túlnyomórészt REST API-n alapulnak, és felszabadítják az alkalmazást a helyi adatkezelés terhe alól. Ilyen esetben az alkalmazás lényegében állapot nélküli működésre vált (mivel az állapot az távoli tárolón található). A modern alkalmazásokat már ebből a szempontból építik fel. Általában bármely modern alkalmazás, amely bizonyos típusú adatokat kezel (naplók, metaadatok, blobok stb.) felhőorientált paradigmára épül, ahol az állapotot egy kifejezetten erre a célra kifejlesztett szoftverrendszer tárolja.
Az állapot-megtartó konténeres megközelítés mindezt a paradigmát arra kényszeríti, hogy visszatérjen oda, ahol elkezdődött!
A POSIX interfészek használata során az alkalmazások úgy működnek, mintha állapotot tárolnának, és emiatt eltérnek a felhőalapú tervezés legfontosabb alapelveitől, nevezetesen, hogy lehetőséget adjanak az alkalmazás munkafolyamatainak méretének változtatására a bejövő terhelés függvényében, átköltözzenek egy új csomópontba, amint az aktuális csomópont meghibásodik és így tovább.
Ha közelebbről megvizsgáljuk ezt a helyzetet, azt találjuk, hogy az adatraktár kiválasztásakor újra és újra találkozunk a "POSIX vs REST API" dilemmával, DE a POSIX problémáit tovább súlyosbítja a Kubernetes környezetek elosztott természet.
- POSIX beszédes: A POSIX szemantika megköveteli, hogy minden művelethez metaadatokat és fájl-azonosítókat rendeljenek, amelyek segítenek fenntartani a művelet állapotát. Ez jelentős költségeket eredményez, amelyeknek nincs valós értékük. Az objektumtároló API-k, különösen az S3 API, megszabadultak ezektől az követelményektől, lehetővé téve, hogy az alkalmazás működjön, majd "elfelejtse" a hívást. A tároló rendszer válasza jelzi, hogy a művelet sikeresen végrehajtódott-e vagy sem. Sikertelenség esetén az alkalmazás megpróbálhatja újra.
- Hálózati korlátozások: Elosztott rendszerben azt feltételezzük, hogy több alkalmazás is megpróbálhat adatokat írni ugyanarra a csatolt tárolóra. Ezért nemcsak az alkalmazások versenyeznek a sávszélességért (hogy adatokat küldjenek a tárolóra), hanem magának a tároló rendszernek is versenyeznie kell ezért a sávszélességért, az adatokat fizikai lemezekre szétosztva. A POSIX szócséplése miatt a hálózati hívások száma többszörösére nő. Másrészről az S3 API világos határokat biztosít a hálózati hívások között, az ügyféltől a szerverig irányuló hívások és a szerveren belüli hívások között.
- Biztonság: A POSIX security model is designed for active human involvement: administrators configure specific access levels for each user or group. This paradigm is difficult to adapt to a cloud-oriented world. Modern applications depend on security models tied to APIs, where access rights are defined as a set of policies, service accounts are allocated, temporary credentials are issued, etc.
- Irányíthatóság: Stateful containers incur certain costs associated with management. This involves synchronizing parallel access to data, ensuring data consistency, and all of this requires careful consideration of which data access patterns to use. Additionally, it involves setting up, monitoring, and configuring extra programs, not to mention the additional effort required in development.
Konténer alapú adat tároló interfész
While the Container Storage Interface (CSI) has greatly assisted in the propagation of Kubernetes volume layers, partially delegating it to third-party data storage vendors, it has also inadvertently contributed to the belief that the stateful container approach is the recommended method for data storage in Kubernetes.
CSI was developed as a standard for providing arbitrary block and file storage systems to legacy applications working with Kubernetes. And, as shown in this article, the only situation where the stateful container approach (and CSI in its current form) makes sense is when the application itself is a legacy system that cannot be updated to include support for object storage API.
It is important to understand that by using CSI in its current form, that is, mounting volumes when working with modern applications, we will encounter approximately the same problems that arose in systems where data storage was organized in a POSIX style.
Magasabb minőségű megközelítés
Ebben az esetben fontos megérteni, hogy a legtöbb alkalmazás alapvetően nem olyan, hogy állapotmegőrzésre vagy állapotmentes működésre lenne tervezve. Ez a viselkedés a rendszer általános architektúrájától és a tervezés során választott konkrét megoldásoktól függ. Beszéljünk egy kicsit az állapotmegőrző alkalmazásokról.
Elvileg az alkalmazások adatai több széles típusra oszthatók:
- Logadatok
- Időbélyeg adatok
- Tranzakciós adatok
- Metainformációk
- Konténerképek
- BLOB adatok (nagy bináris objektumok)
Mindezek a típusú adatok nagyon jól támogatottak a modern adat-tárolási platformokon, és léteznek különböző felhőorientált platformok, amelyek alkalmazkodnak az egyes konkrét formátumokban történő adatszolgáltatáshoz. Például a tranzakciós adatok és metainformációk modern felhőorientált adatbázisokban, mint például a CockroachDB, YugaByte stb. találhatók. A konténerképek vagy a BLOB adatok a MinIO alapú Docker registry-ben tárolhatók. Az időbélyeg adatok időszakos adatbázisban, például InfluxDB-ben tárolhatók. Nem akarunk a különböző típusú adatok és a hozzájuk tartozó alkalmazások részleteibe merülni, de az általános ötlet az, hogy elkerüljük a helyi lemezmountra alapozott állandó tárolást.
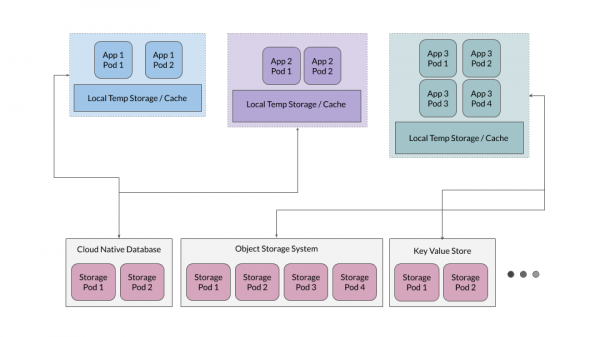
Ezen kívül gyakran hatékony a versenyképességi szint biztosítása, amely ideiglenes fájlok tárolására szolgál az alkalmazások számára, de az alkalmazásoknak nem szabad támaszkodniuk erre a szintre, mint az igazság forrására.
Állapotmegőrző alkalmazások tárolása
Bár a legtöbb esetben hasznos az állapotmentes alkalmazások fenntartása, azok az alkalmazások, amelyek az adatok tárolására szolgálnak – mint például adatbázisok, objektumtárolók, kulcs-érték tárolók – állapotot kell, hogy megtartóak legyenek. Nézzük meg, miért indítanak ezeket az alkalmazásokat Kubernetes-en. Például vegyük a MinIO-t, de hasonló elvek alkalmazhatók bármely más nagy felhőorientált adattároló rendszerre.
A felhőalapú alkalmazásokat a konténerek rugalmasságának maximális kihasználására tervezték. Ez azt jelenti, hogy nem tesznek fel semmiféle feltételezést azokról a környezetekről, ahol telepítve lesznek. Például a MinIO egy belső redundáns kódolási (erasure coding) mechanizmust használ, amely biztosítja a rendszer elegendő ellenállóképességét ahhoz, hogy működőképes maradjon még a lemezek felének meghibásodása esetén is. A MinIO emellett az adatok integritását és biztonságát saját hash-ing és titkosítás révén biztosítja a szerveren.
Az ilyen felhőalapú alkalmazások számára a legmegfelelőbb biztonsági tároló a helyi perzisztens kötet (PV). A helyi PV lehetőséget biztosít a nyers adatok tárolására, míg az ezen PV-k felett működő alkalmazások saját maguk gyűjtik össze azokat az információkat, amelyek lehetővé teszik az adatok skálázását és a növekvő adatigények kezelését.
Ez a megközelítés sokkal egyszerűbb és jelentősen jobban skálázható, mint a CSI alapú PV-k, amelyek saját adatkezelési és redundancia szinteket hoznak be a rendszerbe; a gond az, hogy ezek a szintek általában ellentmondanak a states preservation elvén tervezett alkalmazásoknak.
Magabiztos lépés az adatok leválasztása a számításokról
Ebben a cikkben beszéltünk arról, hogyan irányítják át az alkalmazásokat a state-mentes működésre, más szavakkal, az adatkezelés leválik a számításokról. Végezetül nézzünk meg néhány valós példát ebből a tendenciából.
, a híres adat-analizáló platform hagyományosan state preservation-el és HDFS fájlrendszeren való telepítéssel működött. Azonban ahogy a Spark átlépett a felhőalapú világba, ez a platform egyre inkább state-mentes működésre vált az `s3a` használatával. A Spark az s3a-t használja az állapot átadására más rendszerekhez, míg a Spark konténerei teljes egészében state-mentes működnek. Más nagyvállalati szereplők a nagy adatelemzés terén, különösen, , , szintén áttérnek az adatok tárolásának és a felette végzett számítások leválasztására.
Hasonló mintázatok figyelhetők meg más nagyobb elemző platformokon is, mint például a Presto, Tensorflow R-be, Jupyter. Az állapotok távoli felhőalapú adattárolókba történő kiadása révén sokkal könnyebbé válik az alkalmazás kezelése és skálázása. Ezen kívül hozzájárul az alkalmazás hordozhatóságához különféle környezetekben.
Forrás: habr.com
