

Az ország összes értékesítési irodájának ezrei rögzítik a naponta több tízezer kapcsolattartást — a potenciális vagy már velünk dolgozó ügyfelekkel folytatott kommunikáció tényeit. Ehhez az ügyfélhez először meg kell találni, és lehetőleg nagyon gyorsan. Ez általában a név alapján történik.
Ezért nem meglepő, hogy amikor újra megvizsgáltam a „nehéz” lekérdezéseket az egyik legterheltebb adatbázisunkban — a saját , felfedeztem a „top”-on a név alapú „gyors” kereséshez az üzleti kártyákhoz.
Sőt, a további nyomozás érdekes példát történt először az optimalizálás, majd a teljesítményromlás lekérdezés teljesítményének fokozatos javítása során, melynek során több csapat működött, mindegyik a lehető legjobb szándékkal.
0: mit akart a felhasználó
 [KDPV ]
Mit is jelent általában a felhasználó számára a „gyors” keresés a név alapján? Szinte soha nem jelent „őszinte” keresést egy substringre, mint például ... LIKE '%rózsa%' — hiszen akkor a találatok közé nem csak 'Rózsalia' és 'Bolt Rózsa', hanem 'Grózsa' Kapcsolja össze saját domainjét 'Télapó házarózsa'.
A felhasználó pedig a háztartási szinten azt érti, hogy biztosítani fogja neki a szó elejére történő keresést a névben, és relevánsabbnak fogja mutatni azt, ami kezdődik a beírt kifejezéssel. ÉS ezt meg fogja tenni gyakorlatilag azonnal — a substring bevitelénél.
1: korlátozzuk a feladatot
Aztán a felhasználó biztosan nem fogja külön beírni 'róz bolt',hogy minden egyes szót prefikszálva kelljen keresnie. Nem, a felhasználónak sokkal egyszerűbb reagálni a legutolsó szó gyors javaslatára, mint szándékosan „hátrahagyni” az előzőket — nézd meg, hogy működik ez bármely keresőnél.
Alapvetően, kell a követelmények megfogalmazása — a megoldás több mint fele. Néha a felhasználási eset alapos elemzése .
Mit tesz egy elvont fejlesztő?
1.0: külső keresőmotor
Jaj, a keresés bonyolult, valójában nem is akarjuk ezzel foglalkozni — adjuk át a devopsnak! Hadd telepítsenek nekünk egy külső kereső rendszert az adatbázisunkkal, mint például Sphinx, ElasticSearch,…
Működő, bár munkaigényes a szinkronizáció és azonnali változások szempontjából. De a mi esetünkben nem, mivel a keresés minden ügyfél esetében csak az ő fiókjának adatai között történik. Az adatok elég jelentős változékonysággal bírnak — és ha most a menedzser létrehozott egy kártyát, 'Rózsa Bolt', akkor 5-10 másodperc múlva már emlékezhet arra, hogy elfelejtette megadni az emailt, és szeretné megtalálni és javítani azt.
Ezért — nézzük meg, hogyan kereshetünk "közvetlenül a adatbázis szerint". Szerencsére a PostgreSQL lehetővé teszi számunkra, és nem egyetlen megoldással — ezeket fogjuk megvizsgálni.
1.1: "őszinte" részstring
Kapcsolódjunk a "részstring" szóra. Hiszen pontosan az indexelésre a részstring (és akár reguláris kifejezések!) alapján van egy nagyszerű modulunk! Csak aztán helyesen kell majd rendezni.
Próbáljunk meg egyszerűség kedvéért egy ilyen táblát létrehozni:
CREATE TABLE firms(
  id
    serial
      PRIMARY KEY
, name
    text
);
Feltöltjük 7,8 millió valós szervezet rekordjával és indexeljük:
CREATE EXTENSION pg_trgm;
CREATE INDEX ON firms USING gin(lower(name) gin_trgm_ops);
Kezdjük a részstring keresésével, keressük az első 10 rekordot:
SELECT
  *
FROM
  firms
WHERE
  lower(name) ~ ('(^|s)' || 'rózsa')
ORDER BY
  lower(name) ~ ('^' || 'rózsa') DESC -- először a "kezdetben álló"
, lower(name) -- a többi ábécé sorrendben
LIMIT 10;
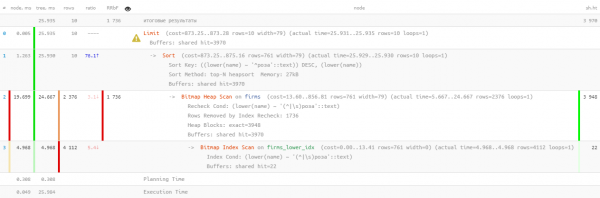
Hát, ilyen... 26ms, 31MB olvasott adatok és több mint 1,7K szűrt rekord — a 10 keresett közül. A költségek túl magasak, nem lehetne hatékonyabb megoldás?
1.2: keresés szöveg alapú? ez FTS!
Valóban, a PostgreSQL nagyon erős (Full Text Search) mechanizmust biztosít, beleértve a prefix keresést is. Nagyszerű megoldás, még kiterjesztéseket sem szükséges telepíteni! Nézzük meg:
CREATE INDEX ON firms USING gin(to_tsvector('simple'::regconfig, lower(name)));SELECT
*
FROM
firms
WHERE
to_tsvector('simple'::regconfig, lower(name)) @@ to_tsquery('simple', 'rózsa:*')
ORDER BY
lower(name) ~ ('^' || 'rózsa') DESC
, lower(name)
LIMIT 10; 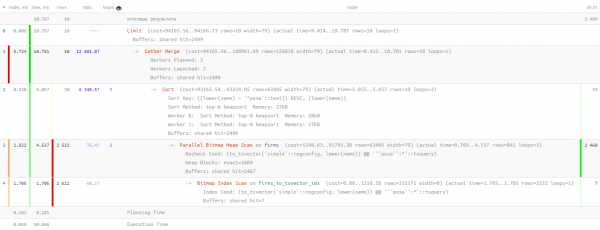
Itt segített nekünk egy kicsit a lekérdezés párhuzamosítása, amely megfelezte az időt 11ms. És 1,5-ször kevesebbet kellett olvasnunk — mindössze 20MB. Itt a kevesebb jobb, hiszen minél nagyobb mennyiséget olvasunk ki, annál nagyobb a cache miss lehetősége, és minden egyes felesleges olvasott adatlap a lemezről potenciálisan "lassítja" a lekérdezést.
1.3: végül is LIKE?
Az előző lekérdezés nagyszerű, de ha naponta százezerszer meghívják, akkor már 2TB olvadt adatok. Legjobb esetben is a memóriából, de ha nem vagyunk szerencsések, akkor a lemezről. Szóval próbáljuk meg kisebbre venni.
Emlékezzünk, hogy a felhasználó mit szeretne látni először a "...ra kezdődőket". De hát ez tisztán van segítségével text_pattern_ops! És csak akkor, ha "nem elég" 10 keresett bejegyzésig, akkor a FTS-kereséssel kell folytatnunk az olvasást:
INDÍTS INDEX A firms(lower(name) text_pattern_ops);VÁLASZD
*
BŐVÍTSD
firms
HOL
lower(name) LIKE ('rózsa' || '%')
LIMIT 10; 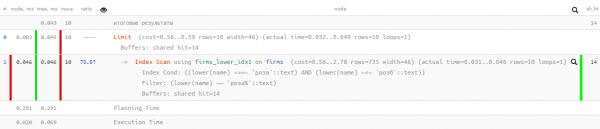
Kiváló mutatók — mindössze 0.05ms és kissé több mint 100KB elolvasva! Csak elfelejtettük a nevek szerinti rendezést, hogy a felhasználó ne tévedjen el az eredmények között:
VÁLASZD
  *
BŐVÍTSD
  firms
HOL
  lower(name) LIKE ('rózsa' || '%')
RENDEZÉS
  lower(name)
LIMIT 10; 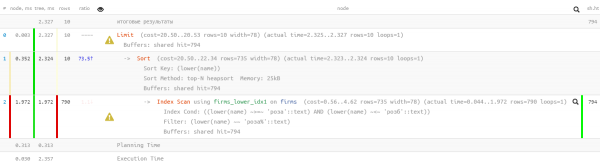
Ó, már nem néz ki olyan jól — úgy tűnik, hogy van index, de a rendezés mellette elszáll... Persze, már sokkal hatékonyabb, mint az előző változat, de...
1.4: "finomítsuk a fájlt"
De van egy index, amely lehetővé teszi a tartomány szerinti keresést és a rendezést is — normál btree!
INDÍTS INDEX A firms(lower(name));Csak a lekérdezést "kézzel" kell összerakni:
VÁLASZD
  *
BŐVÍTSD
  firms
HOL
  lower(name) >= 'rózsa' ÉS
  lower(name) <= ('rózsa' || chr(65535)) -- UTF8 esetén, egybájtosoknak - chr(255)
RENDEZÉS
   lower(name)
LIMIT 10; 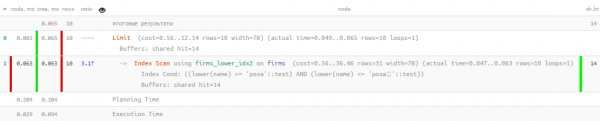
Kiváló — és a rendezés működik, és az erőforrás-felhasználás "mikroszkopikus" maradt, ezerszer hatékonyabb, mint a "tisztán" FTS! Már csak egy összetett lekérdezést kell készíteni:
(
  VÁLASZD
    *
  BŐVÍTSD
    firms
  HOL
    lower(name) >= 'rózsa' ÉS
    lower(name) <= ('rózsa' || chr(65535)) -- UTF8, egybájtos kódolás esetén - chr(255)
  RENDEZÉS
     lower(name)
  LIMIT 10
)
UNION ALL
(
  VÁLASZD
    *
  BŐVÍTSD
    firms
  HOL
    to_tsvector('simple'::regconfig, lower(name)) @@ to_tsquery('simple', 'rózsa:*') ÉS
    lower(name) NOT LIKE ('rózsa' || '%') -- "...ra kezdődőket" már megtaláltuk
  RENDEZÉS
    lower(name) ~ ('^' || 'rózsa') DESC -- ugyanazt a rendezést használjuk, hogy NE lépjünk át a btree-indexen
  , lower(name)
  LIMIT 10
)
LIMIT 10;
Megjegyzem, hogy a második alkérdezés csak akkor fut le ha az első kevesebb elvárt sorok számát adta vissza. Erről a lekérdezések optimalizálásáról korábban már írtam LIMIT Igen, most már egyidőben van btree és gin a táblán, de statisztikailag kiderült, hogy .
. Tehát ezekkel a híresen előre meghatározott tipikus korlátokkal a feladatnál a szerver erőforrás-felhasználását szinte ezerszer csökkentettük! 1.5*: megoldjuk anélkül a finomítótFent
Megjegyzem, hogy
Fent LIKE Zavaradtuk a helytelen rendezés használatába. De a USING operátor megadásával „rá tudjuk vezetni az igaz útra”:
Alapértelmezés szerint értendő
ASC. Ezen kívül megadhatunk egy specifikus rendező operátor nevét a lekérdezésbenUSING. A rendező operátornak egy „kisebb” vagy „nagyobb” B-fa operátoral kell lennie.ASCáltalában egyenértékűUSING <ésDESCáltalában egyenértékűUSING >.
A mi esetünkben a „kisebb” a ~<~:
SELECT
  *
FROM
  firms
WHERE
  lower(name) LIKE ('rózsa' || '%')
ORDER BY
  lower(name) USING ~<~
LIMIT 10; 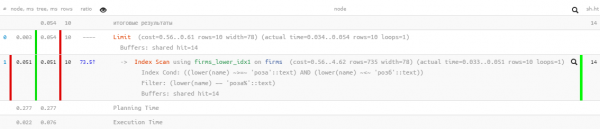
2: ahogy a lekérdezések „megromlanak”
Most hagyjuk, hogy a lekérdezésünk „érjen” fél évig egy évet, és meglepetésünkre újra felfedezzük a „top” részen a napi összesített „memória feltornászás” mutatókkal (buffers shared hit) a 5.5TB — tehát még több, mint amennyi eredetileg volt.
Nem, természetesen, a vállalkozásunk is nőtt, és a terhelés is növekedett, de nem ennyire! Tehát itt valami nem stimmel — nézzük meg közelebbről.
2.1: a lapozás születése
Egy ponton a másik fejlesztőcsapat meg akarta valósítani, hogy a gyors alsókeresésből „ugrani” lehessen a tárolóba az ugyanazokkal, de kibővített eredményekkel. De milyen tároló lapozás nélkül? Csatlakoztassuk!
( ... LIMIT  + 10)
UNION ALL
( ... LIMIT  + 10)
LIMIT 10 OFFSET ;
Ezután a fejlesztő könnyedén prezentálhatta a keresési eredmények listáját „típusú-lapozásos” alámerítéssel.
Persze, valójában minden egyes következő adatoldalhoz egyre nagyobb mennyiségű adatot olvasunk el (az összes az előző alkalommal, amelyet eldobunk, plusz a szükséges „farok”) — tehát ez egyértelmű antipattern. Ami helyesebb lenne — a keresést a felhasználói felületen megjegyzett kulcsról indítani, de erről majd egy másik alkalommal.
2.2: vágyakozás az egzotikumra
Egy ponton a fejlesztő vágyott rá hogy színesítse az eredményhalmazt adatokkal egy másik táblázatból, ezért a teljes korábbi lekérdezés CTE-be került:
WITH q AS (
  ...
  LIMIT  + 10
)
SELECT
  *
, (SELECT ...) sub_query -- egy lekérdezés a kapcsolódó táblához
FROM
  q
LIMIT 10 OFFSET ;
És még így is — nem rossz, mivel a beágyazott lekérdezést csak a 10 visszaadott rekordra számolják ki, ha nem lenne…
2.3: DISTINCT értelmetlen és könyörtelen
Valahol ebben a fejlődés során a 2. allekérdezésből kivilágosodott NOT LIKE a feltétel. Nyilvánvaló, hogy ezután UNION ALL kezdett visszaadni bizonyos rekordokat duplán — először a sorok elején találhatóakat, majd ismét az ezen sor első szavánál. A határon belül a második lekérdezés összes bejegyzése megegyezhetett az első bejegyzéseivel.
Mit csinál a fejlesztő a hiba keresése helyett?.. Nem kérdés!
- kétszeresére bővítjük a méretet forrásminták
- alkalmazzuk a DISTINCT-ot, hogy csak egyedi példányok maradjanak meg az egyes sorokból
WITH q AS (
  ( ... LIMIT  + 10)
  UNION ALL
  ( ... LIMIT  + 10)
  LIMIT  + 10
)
SELECT DISTINCT
  *
, (SELECT ...) sub_query
FROM
  q
LIMIT 10 OFFSET ;
Tehát egyértelmű, hogy a végeredmény pont ugyanaz, de a második CTE lekérdezés „kiugrásának” esélye jelentősen megnőtt, és ezen kívül is, nyilvánvalóan többet olvas..
De ez még nem a legrosszabb. Mivel a fejlesztő azt kérte, hogy ne specifikus, hanem az összes mező alapján válogassunk DISTINCT az bejegyzések között, így automatikusan bekerült a sub_query mező is — a lekérdezés eredménye. Most a végrehajtás érdekében , a rendszernek már DISTINCTnem 10, hanem mind + 10 lekérdezést kellett végrehajtania. 2.4: a kooperáció mindennél fontosabb!!
Így éltek a fejlesztők — nem panaszkodtak, mert a nyilvántartás „finomhangolása” érdekében a kritikus N értékek eléréséhez a következő „oldal” megjelenítésekor a felhasználónak nyilvánvalóan nem volt elég türelme.
Amíg nem jöttek a másik osztály fejlesztői, és nem akarták használni ezt a kényelmes módszert
az iteratív kereséshez. — azaz veszünk egy darabot a mintából, szűrjük további feltételek szerint, megrajzoljuk az eredményt, majd a következő darabot (ami az esetünkben N növelésével érhető el), és így folytatjuk, amíg ki nem töltjük a képernyőt. Összességében a megfogott példányban
N csaknem 17K-ra nőtt, és mindössze egy nap alatt „láncban” nem kevesebb mint 4K ilyen lekérdezést hajtottak végre. Az utolsókat már bátran vizsgálták1 GB memória minden iterációnál. Ezer értékesítési menedzser az ország irodáiból naponta tucatnyi ezer kapcsolatot rögzít a CRM rendszerünkben — a kommunikáció tényét.…
Összesen
Forrás: habr.com
