

A PostgreSQL belső mechanizmusainak működése lehetővé teszi, hogy egyes helyzetekben nagyon gyors legyen, és máskor pedig „nem annyira”. Ma egy klasszikus példán keresztül nézzük meg a konfliktust a DBMS működése és a fejlesztő által végzett munka között — UPDATE vs MVCC elvek.
Röviden a cikkből :
Amikor egy sor frissül az UPDATE parancs által, valójában két művelet történik: TÖRLÉS és BEÍRÁS. Az aktuális verzióban a sorban az xmax értéke beállításra kerül arra a tranzakciós számra, amely végrehajtotta az UPDATE-et. Ezután létrejön új verzió ugyanannak a sornak egy új verziója; az új verzió xmin értéke megegyezik a korábbi verzió xmax értékével.
Néhány idő elteltével a tranzakció befejezése után a régi vagy új verziók, attól függően, hogy COMMIT/ROLLBACK, el lesznek ismerve „halottként” (halott adattörzsek) az asztalon való áthaladás során, és törlésre kerülnek. VACUUM De ez nem fog azonnal megtörténni, viszont a „halottakkal” kapcsolatos problémák gyorsan felmerülhetnek — többszörös vagy
tömeges rekordfrissítések VACUUM nem tud segíteni. .
#1: I Like To Move It
UPDATE tbl SET X = WHERE pk = $1;
Aztán, a végrehajtás során arra is rájön, hogy a Y mezőt is frissíteni kellene:UPDATE tbl SET Y = WHERE pk = $1;
… majd még a Z mezőt is — minek fukarkodni?UPDATE tbl SET Z = WHERE pk = $1;
Hány verziója van most ennek a rekordnak az adatbázisban? Aha, 4 darab! Ezekből egy aktív, a másik hármat le kell majd takarítania [auto]VACUUM.Ne csináld ezt! Használj
több mező frissítését egy kérésben — a módszer működésének logikáját szinte mindig így lehet módosítani: UPDATE tbl SET X = , Y = , Z = WHERE pk = $1;
Így tehát, mégis kedvet kaptál#2: Use IS DISTINCT FROM, Luke!
sok-sok rekord frissítéséhez a táblában UPDATE tbl SET X = WHERE pk BETWEEN $1 AND $2;
Nehéz elképzelni, de ilyen formában a lekérdezés elég gyakran előfordul, és szinte mindig nem új mező kitöltésére, hanem valamilyen adatkorrekcióra szolgál. E közben amár meglévő adatok korrektúrája nem is kerül figyelembevételre — pedig milyen kár! Így tehát a rekord átírásra kerül, még akkor is, ha éppen az, amire szükség volt — miért is? Javítsuk ki: UPDATE tbl SET X = WHERE pk BETWEEN $1 AND $2 AND X IS DISTINCT FROM ;
UPDATE tbl SET X = WHERE pk BETWEEN $1 AND $2 AND X IS DISTINCT FROM ; Sokan nincsenek tisztában ennek a csodálatos operátornak a létezésével, ezért itt egy rövid útmutató IS DISTINCT FROM és más logikai operátorokhoz is:
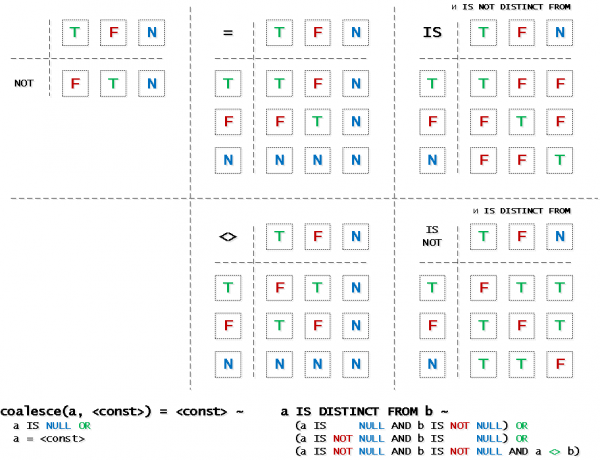
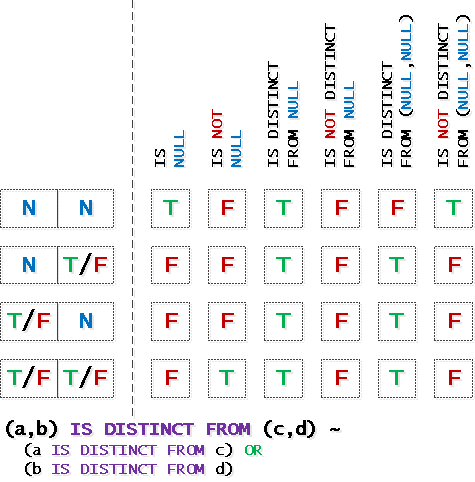
… és egy kicsit a bonyolult ROW()-kifejezésekről:
#3: А я милого узнаю по… блокировке
Két azonos párhuzamos folyamat indul , mindegyik megpróbálja megjelölni a rekordot, hogy "munkában" van:UPDATE tbl SET processing = TRUE WHERE pk = $1;
Még ha ezek a folyamatok lényegében független dolgokat is csinálnak, egyazon ID keretein belül a második kliens "lezáródik" ezen a lekérdezésen, amíg az első tranzakció be nem fejeződik.Megoldás №1
: a feladat a korábbiakraEgyszerűen újra hozzáadjuk
UPDATE tbl SET processing = TRUE WHERE pk = $1 AND processing IS DISTINCT FROM TRUE; IS DISTINCT FROM:
Ebben a formában a második lekérdezés egyszerűen nem fog semmit változtatni az adatbázisban, ott már "minden rendben van" - ezért a blokkolás nem fog fellépni. Ezt követően a rekord "nemlétezését" már a alkalmazás algoritmusában kezeljük.Megoldás №2
: tanácsadó zárolásokNagy téma, amelyről érdemes egy külön cikkben olvasni, ahol
a hasznosítási módokról és a "csapdákról" a tanácsadó zárolásokról .
: bolondos hívásokBiztosan kell, hogy nálatok történjen
párhuzamos munka ugyanazzal a rekorddal MVCC-3. Sorok verziói? Или вы все-таки накосячили с алгоритмами вызовов бизнес-логики со стороны клиента, например? А если подумать?..
Forrás: habr.com
