

A klasszikus kérdés, amellyel a fejlesztő a DBA-jához vagy a PostgreSQL tanácsadójához fordul, szinte mindig ugyanúgy hangzik: „Miért tart olyan sokáig a lekérdezések végrehajtása?”
Hagyományos okok halmaza:
- hatékonytalan algoritmus
amikor úgy döntött, hogy JOIN-t végez több CTE-vel néhány tízezer rekord esetén - elavult statisztikák
ha a táblában a tényleges adateloszlás már nagyon eltér a legutolsó ANALYZE során összegyűjtött adatoktól - „elakadás” az erőforrásokban
és már nem elegendőek a kiosztott CPU számítási kapacitásai, folyamatosan megnövekszik a memóriahasználat vagy a lemez nem tud lépést tartani az adatbázis minden „kívánságával” - zárolások a versengő folyamatok által
És ha a zárolások meglehetősen nehezen megfoghatók és elemezhetők, akkor a többihez elég nekünk lekérdezési terv, amit a következővel szerezhetünk be: (jobb, ha azonnal EXPLAIN (ANALYZE, BUFFERS) …) vagy .
De, ahogy a dokumentációban is mondják,
„A terv megértése művészet, és annak elsajátításához bizonyos tapasztalat szükséges, …”
De nélküle is megoldható, ha egy megfelelő eszközt használunk!
Hogyan néz ki általában a lekérdezési terv? Valahogy így:
Index Scan using pg_class_relname_nsp_index on pg_class (actual time=0.049..0.050 rows=1 loops=1)
  Index Cond: (relname = $1)
  Filter: (oid = $0)
  Buffers: shared hit=4
  InitPlan 1 (returns $0,$1)
    ->  Limit (actual time=0.019..0.020 rows=1 loops=1)
          Buffers: shared hit=1
          ->  Seq Scan on pg_class pg_class_1 (actual time=0.015..0.015 rows=1 loops=1)
                Filter: (relkind = 'r'::"char")
                Rows Removed by Filter: 5
                Buffers: shared hit=1
vagy így:
"Append  (cost=868.60..878.95 rows=2 width=233) (actual time=0.024..0.144 rows=2 loops=1)"
"  Buffers: shared hit=3"
"  CTE cl"
"    ->  Seq Scan on pg_class  (cost=0.00..868.60 rows=9972 width=537) (actual time=0.016..0.042 rows=101 loops=1)"
"          Buffers: shared hit=3"
"  ->  Limit  (cost=0.00..0.10 rows=1 width=233) (actual time=0.023..0.024 rows=1 loops=1)"
"        Buffers: shared hit=1"
"        ->  CTE Scan on cl  (cost=0.00..997.20 rows=9972 width=233) (actual time=0.021..0.021 rows=1 loops=1)"
"              Buffers: shared hit=1"
"  ->  Limit  (cost=10.00..10.10 rows=1 width=233) (actual time=0.117..0.118 rows=1 loops=1)"
"        Buffers: shared hit=2"
"        ->  CTE Scan on cl cl_1  (cost=0.00..997.20 rows=9972 width=233) (actual time=0.001..0.104 rows=101 loops=1)"
"              Buffers: shared hit=2"
"Planning Time: 0.634 ms"
"Execution Time: 0.248 ms"
De a tervet „papírról” olvasni nagyon nehéz és nem szemléletes:
- a csomópontban megjelenik az erőforrások összessége az alsó fában
tehát ahhoz, hogy megértsük, mennyi idő telt el egy adott csomópont végrehajtására, vagy hogy pontosan mennyi időt vett igénybe az adatok leolvasása a táblázatból — valahogy ki kell vonnunk az egyiket a másikból - szükség van a csomópont időre szorozni a loops-szal
igen, a kivonás még nem a legnehezebb művelet, amit "fejben" el kell végezni — hiszen a végrehajtási idő az egy végrehajtásra vonatkozó átlagolt időt mutat, és ezekből több száz is lehet - nos, és mindez együtt megnehezíti a fő kérdés megválaszolását — ki is a leggyengébb láncszem a "leggyengébb láncszem"?
Amikor megpróbáltuk mindezt elmagyarázni néhány száz fejlesztőnknek, rájöttünk, hogy kívülről ez körülbelül így néz ki:
Akkor tehát szükségünk van…
Eszköz
Ebben próbáltunk összegyűjteni minden kulcsmechanikát, amely segít a terv és a kérés alapján megérteni, "ki a felelős és mit kell tenni". Nos, és a tapasztalatunk egy részét is megosztani az közösséggel.
Itt az ideje, hogy megismerd és használd —
A tervek áttekinthetősége
Könnyű megérteni a tervet, amikor így néz ki?
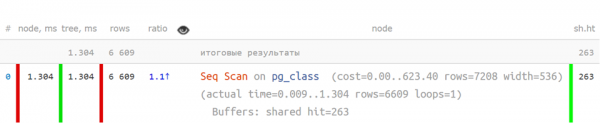
Seq Scan on pg_class (aktualizált idő=0.009..1.304 sor=6609 ciklus=1)
  Pufferek: megosztott találat=263
 Tervezési idő: 0.108 ms
 Végrehajtási idő: 1.800 ms
Nem igazán.
De így, rövidített formában, amikor a kulcsfontosságú mutatók elkülönítve vannak — már sokkal érthetőbb:
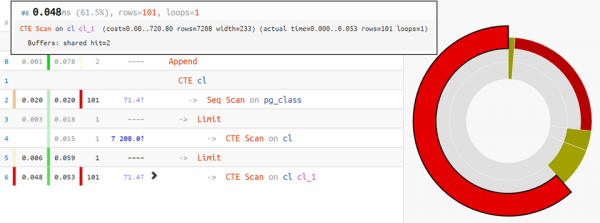
De ha a terv bonyolultabb — segítséget nyújt a piechart a töltött idő eloszlásáról a csomópontok szerint:
Nos, a legbonyolultabb esetekhez segítségül siet a végrehajtási diagram:
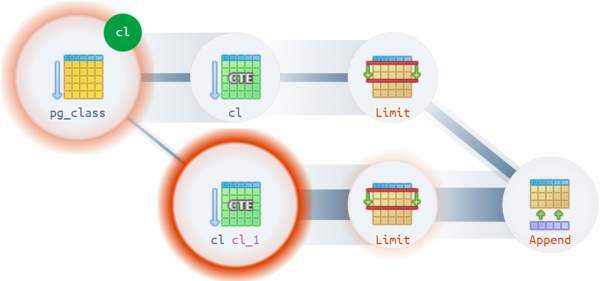
Például vannak olyan elég nem triviális helyzetek, amikor a terv több tényleges gyökérrel rendelkezhet:
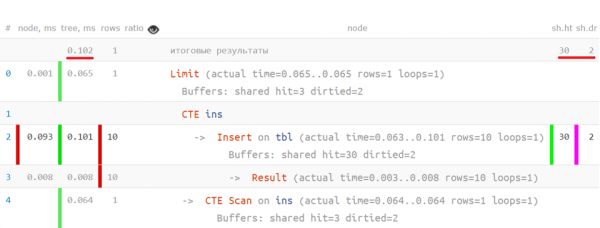
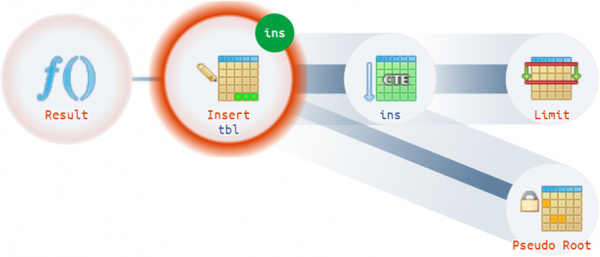
Strukturált tippek
Nos, ha a terv teljes szerkezete és a gyenge pontjai már ki vannak dolgozva és láthatóak — miért ne emelhetnénk ki őket a fejlesztőnek, és magyarázhatnánk "anyanyelvi" érthetőséggel?
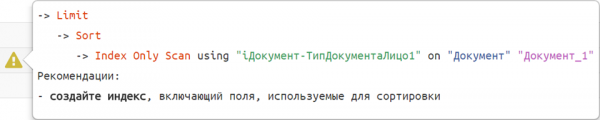 Ezekből a javaslati sablonokból már összegyűjtöttünk néhány tucatot.
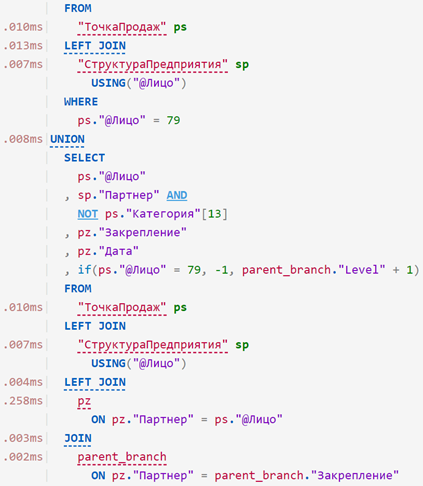
Sor szerinti lekérdezésprofiláló
Most, ha az elemzett tervhez hozzácsatolják az eredeti lekérdezést, látható, mennyi időt töltöttek el egyes operátorokkal — körülbelül így:
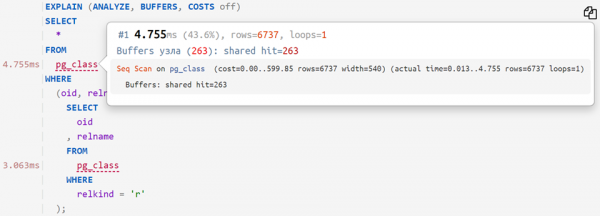
… vagy akár így:
Paraméterek behelyettesítése a lekérdezésbe
Ha "hozzákapcsoltad" a tervhez nemcsak a lekérdezést, hanem annak paramétereit is a log DETAIL sorából, akkor egy kibővített formában lemásolhatod:
- értékek behelyettesítése a lekérdezésbe
közvetlen végrehajtás céljából a saját adatbázisodon és további profilozásraSELECT 'const', 'param'::text; - értékek behelyettesítése a PREPARE/EXECUTE segítségével
a feladatkezelő működésének szimulálására, amikor a paraméteres rész figyelmen kívül hagyható — például, ha szegmentált táblákon dolgozunkDEALLOCATE ALL; PREPARE q(text) AS SELECT 'const', $1::text; EXECUTE q('param'::text);
Tervezetek archívuma
Illessze be, elemezze, ossza meg kollégáival! A tervek az archívumban maradnak, és később visszatérhet hozzájuk:
De ha nem szeretné, hogy mások lássák a tervét, ne felejtse el bejelölni a „ne tegyük közzé az archívumban” lehetőséget.
A következő cikkekben beszélek azokról a nehézségekről és megoldásokról, amelyek az elemzési tervvel kapcsolatban merülnek fel.
Forrás: habr.com
