

Néhány hónappal ezelőtt — nyilvános PostgreSQL-hez.
Az eltelt idő alatt már több mint 6000 alkalommal használtad, de az egyik hasznos funkció észrevétlen maradhatott — ez pedig a strukturált javaslatok, amelyek nagyjából így néznek ki:
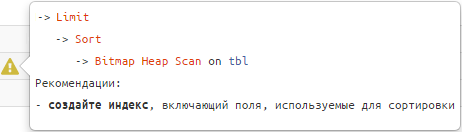
Figyelj rájuk, és a kereséseid „simává és selymessé” válnak. 🙂
Ha komolyan vesszük, akkor sok olyan helyzet, amely lassúvá és „erőforrás-igényessé” teszi a lekérdezést, tipikus, és a struktúra és az adatok mintázata alapján felismerhetők..
Ilyen esetben minden egyes fejlesztőnek nem kell egyedül az optimalizálási lehetőségeket keresnie, kizárólag a saját tapasztalatára támaszkodva — tudunk neki támogatást nyújtani arról, hogy mi történik, mi lehet az oka, és hogyan lehet a megoldásra közelíteni. Amit meg is tettünk.
Nézzük meg részletesebben ezeket az eseteket — hogyan határozzák meg őket és milyen ajánlásokhoz vezetnek.
A témába való jobb betekintés érdekében először érdemes meghallgatni a megfelelő blokkot a majd részletesebben áttérni minden példára:
#1: индексная «недосортировка»
Amikor felmerül
Mutasd az utolsó számlát a "KoloKochi Kft." ügyfélnek.
Hogyan ismerjük fel
-> Limit
   -> Sort
      -> Index [Csak] Vizsgálat [Megfordított] | Bitmap Heap Scan
Ajánlások
Használatban lévő index bővíteni a rendezési mezőkkel.
Példa:
CREATE TABLE tbl AS
SELECT
  generate_series(1, 100000) pk  -- 100K "tény"
, (random() * 1000)::integer fk_cli; -- 1K különböző külső kulcsok

CREATE INDEX ON tbl(fk_cli); -- index a külső kulcshoz

SELECT
  *
FROM
  tbl
WHERE
  fk_cli = 1 -- szűrés egy konkrét kapcsolatra
ORDER BY
  pk DESC -- csak egy "legutóbbi" bejegyzést akarunk
LIMIT 1; 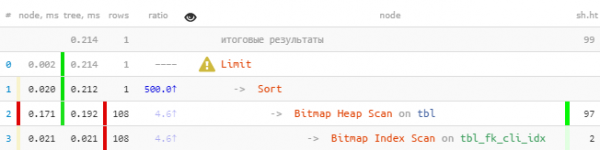
Azonnal látható, hogy az index alapján több mint 100 rekordot olvastak ki, amelyeket ezután mind rendeztek, és végül csak egy maradt.
Javítjuk:
DROP INDEX tbl_fk_cli_idx;
CREATE INDEX ON tbl(fk_cli, pk DESC); -- hozzáadtuk a rendezési kulcsot
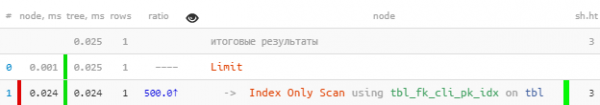
Még egy ilyen primitív kiválasztás során is — 8,5-szer gyorsabb, és 33-szor kevesebb olvasást igényel.A hatás annál szembetűnőbb lesz, minél több "tény" áll rendelkezésre minden egyes értékhez fk.
Megjegyzem, hogy egy ilyen index "prefix" jellegű módon fog működni, nem rosszabbul az előzőnél, és más lekérdezéseknél is, fk, ahol a rendezéseket nem végeztek el a pk nélküli és nincs (a nem hatékony indexekről szóló cikkemben bővebben olvasható támogatást a kifejezett külső kulcsokhoz ezen a mezőn. Mutass minden megállapodást a "KoloKochi Kft." ügyfélről, amelyet a "Veszik Kft." nevében kötöttek.
#2: пересечение индексов (BitmapAnd)
Amikor felmerül
-> BitmapAnd -> Bitmap Index Vizsgálat -> Bitmap Index Vizsgálat
Hogyan ismerjük fel
-> BitmapAnd
   -> Bitmap Index Scan
   -> Bitmap Index Scan
Ajánlások
Létrehozás összetett index a két forrásmezőből vagy egy meglévő mező bővítése a másik mezővel.
Példa:
CREATE TABLE tbl AS
SELECT
  generate_series(1, 100000) pk      -- 100K "adat"
, (random() *  100)::integer fk_org  -- 100 különböző külső kulcs
, (random() * 1000)::integer fk_cli; -- 1K különböző külső kulcs

CREATE INDEX ON tbl(fk_org); -- index a külső kulcshoz
CREATE INDEX ON tbl(fk_cli); -- index a külső kulcshoz

SELECT
  *
FROM
  tbl
WHERE
(fk_org, fk_cli) = (1, 999); -- szűrés adott párra 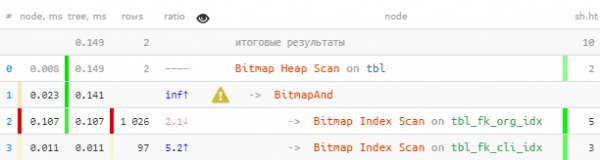
Javítjuk:
DROP INDEX tbl_fk_org_idx;
CREATE INDEX ON tbl(fk_org, fk_cli);
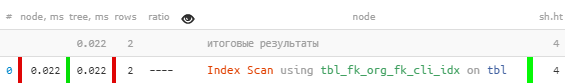
Itt a nyereség kisebb, mivel a Bitmap Heap Scan önállóan is eléggé hatékony. De mindenesetre 7-szer gyorsabb és 2,5-szer kevesebb olvasás.
#3: объединение индексов (BitmapOr)
Amikor felmerül
Az első 20 legidősebb „saját” vagy nem címzett kérelem megjelenítése a feldolgozáshoz, prioritással a sajátok számára.
Hogyan ismerjük fel
-> BitmapOr
   -> Bitmap Index Scan
   -> Bitmap Index Scan
Ajánlások
Használja a UNION [ALL] a feltételek minden OR-blokk al-lekérdezéseinek egyesítéséhez.
Példa:
CREATE TABLE tbl AS
SELECT
  generate_series(1, 100000) pk  -- 100K "adat"
, CASE
    WHEN random() < 1::real/16 THEN NULL -- 1:16 arányban "döntetlen"
    ELSE (random() * 100)::integer -- 100 különböző külső kulcs
  END fk_own;

CREATE INDEX ON tbl(fk_own, pk); -- index "szerint szimpatikus" rendezéssel

SELECT
  *
FROM
  tbl
WHERE
  fk_own = 1 OR -- saját
  fk_own IS NULL -- ... vagy "döntetlen"
ORDER BY
  pk
, (fk_own = 1) DESC -- először a "saját"
LIMIT 20;
Javítjuk:
(
  SELECT
    *
  FROM
    tbl
  WHERE
    fk_own = 1 -- először a "saját" 20
  ORDER BY
    pk
  LIMIT 20
)
UNION ALL
(
  SELECT
    *
  FROM
    tbl
  WHERE
    fk_own IS NULL -- utána a "döntetlen" 20
  ORDER BY
    pk
  LIMIT 20
)
LIMIT 20; -- de összesen 20, több nem is kell 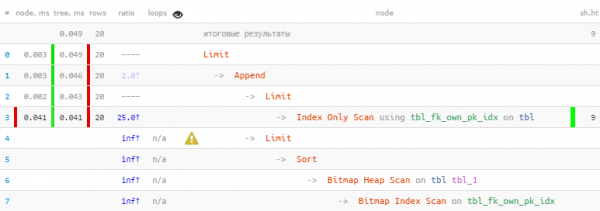
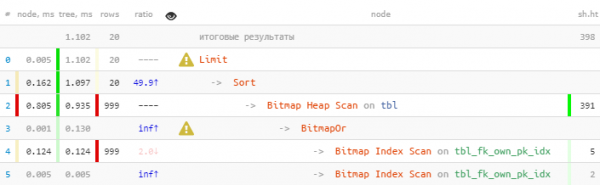
Ki tudtuk használni, hogy az összes 20 szükséges rekord az első blokkból érkezett, így a második, a drágább Bitmap Heap Scan, még csak nem is futott — így 22-szer gyorsabb, 44-szer kevesebb olvasás!
Részletesebb beszámoló erről az optimalizálási módszerről konkrét példákon olvasható az írásokban és .
Általánosított változat több kulcs szerinti rendszerezés (és nem csak egy pár const/NULL) a cikkben tárgyaltak szerint .
#4: читаем много лишнего
Amikor felmerül
Általában a már meglévő lekérdezéshez "még egy szűrőt" szeretnénk hozzáadni.
Azt mondja: „Nincs hasonló, de gyöngyházgombokkal?» a „Gyémántkészlet” című film
Például a fenti feladat módosításával az első 20 legidősebb „kritikus” kérés megjelenítése a feldolgozáshoz, függetlenül attól, hogy hová vannak címkézve.
Hogyan ismerjük fel
-> Seq Scan | Bitmap Heap Scan | Index [Only] Scan [Backward]
   && 5 × sorok < RRbF -- szűrve >80% az olvasott
   && ciklusok × RRbF > 100 -- és e mellett több mint 100 nyilvántartás összesen
Ajánlások
Létrehozni [saját] specializált indexet WHERE-állítással vagy további mezők indexbe való beillesztése.
Ha a szűrési feltétel „statikus” a feladatokhoz — vagyis nem terveznek bővítést értéklistájának a jövőben — akkor jobb, ha WHERE-indexet használunk. Ebbe a kategóriába jól illeszkednek a különböző boolean/enum státuszok.
Ha azonban a szűrési feltétel különböző értékeket vehet fel, akkor jobb, ha ezeket a mezőket hozzáadjuk az indexhez — mint a BitmapAnd esetében.
Példa:
CREATE TABLE tbl AS
SELECT
  generate_series(1, 100000) pk -- 100K "tények"
, CASE
    WHEN random() < 1::real/16 THEN NULL
    ELSE (random() * 100)::integer -- 100 különböző külső kulcs
  END fk_own
, (random() < 1::real/50) critical; -- 1:50, hogy a kérés "kritikus"

CREATE INDEX ON tbl(pk);
CREATE INDEX ON tbl(fk_own, pk);

SELECT
  *
FROM
  tbl
WHERE
  critical
ORDER BY
  pk
LIMIT 20; 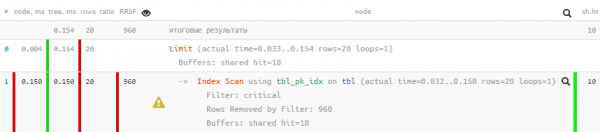
Javítjuk:
CREATE INDEX ON tbl(pk)
  WHERE critical; -- hozzáadott "statikus" szűrési feltétel
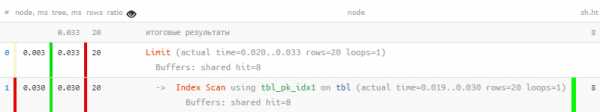
Ahogy látjuk, a szűrés a tervből teljesen eltűnt, és a lekérdezés 5-ször gyorsabb lett..
#5: разреженная таблица
Amikor felmerül
Különböző kísérletek a saját feladatkezelő sor létrehozására, amikor a táblázat sok frissítése/eltávolítása helyzetet teremt a sok „halott” rekord miatt.
Hogyan ismerjük fel
-> Seq Scan | Bitmap Heap Scan | Index [Only] Scan [Backward]
   && loops × (rows + RRbF)  64
Ajánlások
Rendszeresen kézzel végrehajtani VACUUM [FULL] vagy elérni, hogy megfelelő gyakorisággal működjön a paraméterek finomhangolásával, beleértve .
A legtöbb esetben az ilyen problémák a lekérdezések rossz összeállításának következményei, a bizniszlogika hívásaiból, mint amiket az előzőekben tárgyaltunk. .
De meg kell érteni, hogy még a VACUUM FULL sem mindig segít. Az ilyen esetekre érdemes megismerkedni a cikk algoritmusával. .
#6: чтение с «середины» индекса
Amikor felmerül
Úgy tűnik, hogy kicsit olvastunk, és mindent index szerint, és senkit nem szűrtünk ki — de mégis jelentősen több oldalt olvastunk el, mint amennyit szeretnénk.
Hogyan ismerjük fel
-> Index [Only] Scan [Backward]
   && loops × (rows + RRbF)  64
Ajánlások
Alaposan meg kell vizsgálni a használt index felépítését és azokat a kulcsmezőket, amelyeket a lekérdezésben adtak meg — valószínűleg az index egy része nincs meghatározva.Valószínűleg hasonló indexet kell létrehoznia, de prefix mezők nélkül, vagy .
Példa:
Hozz létre egy tbl táblát
SELECT
  generate_series(1, 100000) pk      -- 100K "tény"
, (random() *  100)::integer fk_org  -- 100 különböző külső kulcs
, (random() * 1000)::integer fk_cli; -- 1K különböző külső kulcs

Hozz létre indexet a tbl(fk_org, fk_cli) táblán; -- minden majdnem mint a #2
-- csak az fk_cli-nek külön indexet már feleslegesnek tartottuk és eltávolítottuk

SELECT
  *
FROM
  tbl
WHERE
  fk_cli = 999 -- az fk_org nincs megadva, bár az indexben előrébb van
LIMIT 20; 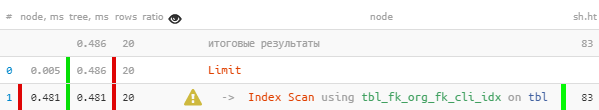
Úgy tűnik minden rendben van, akár az index szempontjából is, de valahogy gyanús — minden 20 elolvasott rekordhoz 4 adatoldalt kellett betölteni, 32KB írásra — nem sok ez? És az index neve tbl_fk_org_fk_cli_idx elmélkedésre ad okot.
Javítjuk:
Hozz létre indexet a tbl(fk_cli) táblán; 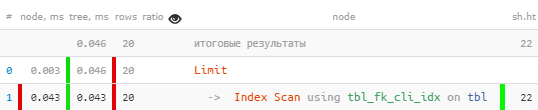
Hirtelen — 10-szer gyorsabb, és 4-szer kevesebbet olvasni!
Más példákat az indexek hatékonytalan használatára láthatunk a cikkben .
#7: CTE × CTE
Amikor felmerül
A lekérdezésben betettünk "zsíros" CTE-ket különböző táblákból, majd úgy döntöttünk, hogy létrehozunk közöttük JOIN.
Az eset aktuális a v12-es vagy alatti verziókra, vagy a következő lekérdezések esetében WITH MATERIALIZED.
Hogyan ismerjük fel
-> CTE Scan
   && loopok > 10
   && loopok × (sorok + RRbF) > 10000
      -- túl nagy kartéziánus szorzat CTE
Ajánlások
Alaposan elemezd a lekérdezést — nem szükségesek-e itt egyáltalán a CTE-k ? Если все-таки да, то a modell szerint, amely le van írva a Egyszeri feldolgozás (rendezés vagy egyedi azonosítás) nagyszámú rekord esetén nem fér el a kijelölt memóriában. .
#8: swap на диск (temp written)
Amikor felmerül
-> * && ideiglenes írás > 0
Hogyan ismerjük fel
Ha a művelet által használt memória mennyisége nem lépi túl jelentősen a beállított paraméterétAjánlások
work_mem SET [LOCAL] konkrét lekérdezéshez/tranzakcióhoz. SHOW work_mem; -- "16MB"SELECT random() FROM generate_series(1, 1000000) ORDER BY 1;
Példa:
SET work_mem = '128MB'; -- lekérdezés végrehajtása előtt 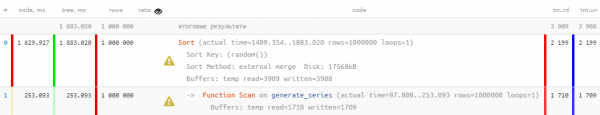
Javítjuk:
Nyilvánvaló okokból, ha csak memóriát használsz, és nem a lemezt, akkor a lekérdezés is sokkal gyorsabban fog futni. Emellett a HDD-re nehezedő terhelés egy része is csökkenthető. 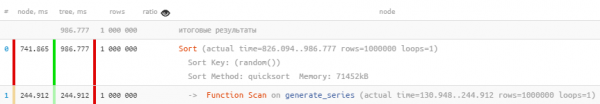
De meg kell érteni, hogy mindig nem lehet sok-sok memóriát biztosítani — egyszerűen nem lesz elég az összes számára.
A táblába egyszerre sokat töltöttek be, de nem volt idejük futtatni
#9: неактуальная статистика
Amikor felmerül
ANALYZE -> Seq Scan | Bitmap Heap Scan | Index [Only] Scan [Backward] && arány >> 10.
Hogyan ismerjük fel
Vegyetek átAjánlások
Bővebb részletezés erről a helyzetről található a -> Seq Scan | Bitmap Heap Scan | Index [Only] Scan [Backward] && arány >> 10.
PostgreSQL Antipatterns: a statisztika mindennek a feje .
#10: «что-то пошло не так»
Amikor felmerül
A lekérdezés várakozása, amelyet elhelyezett konkurens lekérdezés okozott, vagy nem volt elegendő CPU/hypervisor erőforrás.
Hogyan ismerjük fel
-> *
   && (megosztott hit / 8K) + (megosztott olvasás / 1K) < idő / 1000
      -- RAM hit = 64MB/s, HDD olvasás = 8MB/s
   && idő > 100ms -- keveset olvastunk, de túl sokáig
Ajánlások
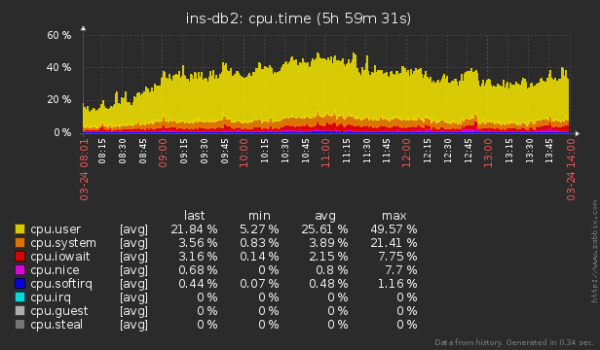
Használja a külső monitorozó rendszert a szerverek blokkolásainak vagy szokatlan erőforrás-felhasználásának ellenőrzésére. A több száz szerver ilyen folyamatának megszervezéséről már beszéltünk és .
Forrás: habr.com
