

Csomag tidyr az R nyelv egyik legnépszerűbb könyvtárának, a tidyverse.
fő funkciója az adatok rendezett megjelenése.
A Habr-on már van egy e csomagnak szentelt bejegyzés, de az 2015-ből datálódik. Én azonban szeretném bemutatni a legfrissebb változásokat, amelyeket néhány nappal ezelőtt Hadley Wickham, a csomag szerzője jelentett be.
SJK: Az gather() és spread() funkciók elavultnak számítanak majd?
Hadley Wickham: Valamilyen szempontból. Megszüntetjük a használatuk ajánlását és a bennük lévő hibák javítását, de továbbra is jelen lesznek a csomagban a jelenlegi állapotukban.
Tartalom
Ha érdeklik az adatelemzés, talán érdekesek lesznek a és csatornáim. A tartalom nagy része az R nyelvnek szentelt.
A TidyData koncepciója
Cél tidyr – segíteni fog önnek az adatok úgynevezett rendezett megjelenésének kialakításában. A rendezett adatok azok, ahol:
- Minden változó oszlopban található.
- Minden megfigyelés egy sor.
- Minden érték egy cella.
A rendezett adatokkal jelentősen egyszerűbb és kényelmesebb dolgozni az elemzés során.
A tidyr csomagba tartozó főbb funkciók
A tidyr egy funkciókészletet tartalmaz, amely a táblázatok átalakítására szolgál:
fill()– hiányzó értékek kitöltése egy oszlopban az előző értékekkel;separate()– egy mező felosztása több részre egy elválasztó segítségével;unite()– több mező egybevonása egybe, ennek hatása ellentétes aseparate();pivot_longer()– funkció, amely az adatokat széles formátumból hosszúvá alakítja;pivot_wider()— funkció, amely az adatokat hosszú formátumból széles formátumba alakítja. A művelet ellentétes azzal, amit a funkció végezpivot_longer().gather()elavult – funkció, amely az adatokat széles formátumból hosszúvá alakítja;spread()elavult — funkció, amely az adatokat hosszú formátumból széles formátumba alakítja. A művelet ellentétes azzal, amit a funkció végezgather().
Új koncepció az adatok széles formátumból hosszúba és vissza átalakítására
Korábban hasonló típusú átalakításra használták a funkciókat gather() és spread(). Az évek során világossá vált, hogy a felhasználók többsége, beleértve a csomag szerzőjét is, számára a funkciók elnevezései és paraméterei nem voltak egyértelműek, és nehézséget okoztak a keresésben és abban, hogy megértsék, melyik funkció alakítja át az adatkeretet szélesből hosszú formátumba, és fordítva.
Ezért a tidyr csomagba két új, fontos funkciót adtak hozzá, amelyek az adatkeretek átalakítására szolgálnak.
Az új funkciók pivot_longer() és pivot_wider() a cdata csomag bizonyos funkcióinak ihletése nyomán készültek , amelyet John Mount és Nina Zumel készített.A csomag legújabb verziójának telepítéséhez, amely tartalmazza az új funkciókat, használja az alábbi kódot.
A legfrissebb tidyr 0.8.3.9000 verzió telepítése
devtools::install_github("tidyverse/tidyr") tidyr 0.8.3.9000A cikk írásának időpontjában ezek a funkciók csak a csomag dev verziójában érhetők el GitHubon.
Valójában a régi szkriptek új funkciókkal való használatához való átállás nem nehéz, hogy jobban megértsük, például egy régi funkciók dokumentációs példát fogok venni, és megmutatom, hogyan hajthatók végre ugyanazok a műveletek az új
pivot_*()
Áttérés az új funkciókra
funkciókkal. A széles formátum hosszú formátumba alakítása. Példa a gather funkció dokumentációjából
A hosszú formátum széles formátumba alakítása.
Példa a spread funkció dokumentációjából
# example
library(dplyr)
stocks <- data.frame(
  time = as.Date('2009-01-01') + 0:9,
  X = rnorm(10, 0, 1),
  Y = rnorm(10, 0, 2),
  Z = rnorm(10, 0, 4)
)

# old
stocks_gather <- stocks %>% gather(key   = stock,
                                   value = price,
                                   -time)

# new
stocks_long   <- stocks %>% pivot_longer(cols      = -time,
                                       names_to  = "stock",
                                       values_to = "price")
Mivel a fenti példákban dolgoztunk
, az eredeti táblázatban
# old
stocks_spread <- stocks_gather %>% spread(key = stock,
                                          value = price)

# new
stock_wide    <- stocks_long %>% pivot_wider(names_from  = "stock",
                                            values_from = "price")
stocks pivot_longer() és pivot_wider()nincsenek az arguments paramétereiben felsorolt oszlopok names_to values_to neveit idézőjelekben kell megadni. és Az a táblázat, amellyel a legkönnyebben megértheti, hogyan állhat át az új koncepcióra. Megjegyzés a szerzőtől
A következőt tudományos szöveg szabad fordítása tidyr.
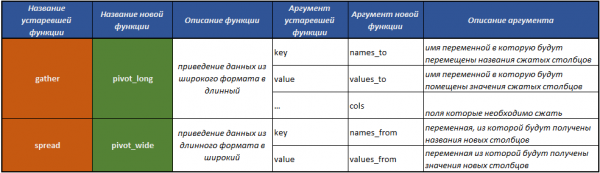
a tidyverse könyvtár hivatalos weboldaláról.
pivot_longer () A cikkben bemutatott példák végrehajtásához először be kell tölteni a szükséges csomagokat:
Egyszerű példa az adatok széles formátumból hosszúba való átalakítására
library(tidyr)
library(dplyr)
library(readr)
Tegyük fel, hogy van egy táblázatunk a felmérés eredményeiről, amelyben (többek között) megkérdezték az embereket vallásukról és éves jövedelmükről:
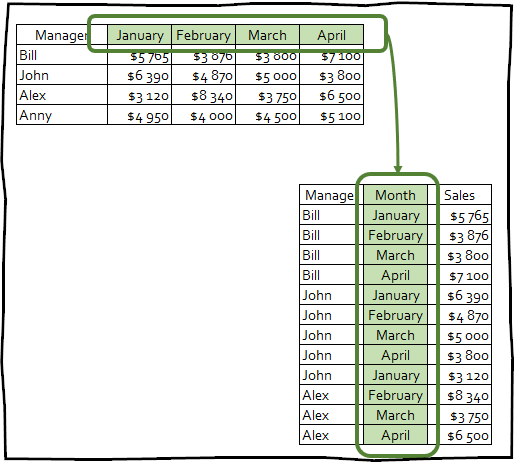
A cikkben bemutatott példák végrehajtásához először a szükséges csomagokat kell telepíteni:
library(tidyr)
library(dplyr)
library(readr)Tegyük fel, hogy van egy táblázatunk a felmérés eredményeivel, ahol (többek között) arra kérdeztük az embereket, hogy mi a vallásuk és milyen éves jövedelmük van:
#> # A tibble: 18 x 11
#>    religion `<$10k` `$10-20k` `$20-30k` `$30-40k` `$40-50k` `$50-75k`
#>    <chr>      <dbl>     <dbl>     <dbl>     <dbl>     <dbl>     <dbl>
#>  1 Agnostic      27        34        60        81        76       137
#>  2 Atheist       12        27        37        52        35        70
#>  3 Buddhist      27        21        30        34        33        58
#>  4 Catholic     418       617       732       670       638      1116
#>  5 Don’t k…      15        14        15        11        10        35
#>  6 Evangel…     575       869      1064       982       881      1486
#>  7 Hindu          1         9         7         9        11        34
#>  8 Histori…     228       244       236       238       197       223
#>  9 Jehovah…      20        27        24        24        21        30
#> 10 Jewish        19        19        25        25        30        95
#> # … with 8 more rows, and 4 more variables: `$75-100k` <dbl>,
#> #   `$100-150k` <dbl>, `>150k` <dbl>, `Don't know/refused` <dbl>
Ez a táblázat a válaszadók vallási hovatartozásáról tartalmaz adatokat a sorokban, míg a jövedelem szintje az oszlopnevek között található. Minden kategóriából származó válaszadók száma a vallás és a jövedelem szintjének metszéspontjában található cellák értékeiben tárolódik. A táblázat helyes, rendezett formátumban való megjelenítéséhez elegendő használni pivot_longer():
pew %>%
  pivot_longer(cols = -religion, names_to = "income", values_to = "count")
pew %>%
pivot_longer(cols = -religion, names_to = "income", values_to = "count")
# A tibble: 180 x 3
# religion income count
#
# 1 Agnostic 150k 84
# 10 Agnostic Don't know/refused 96
# … with 170 more rowsA függvény argumentumai pivot_longer()
- Az első argumentum cols, leírja, hogy mely oszlopokat kell egyesíteni. Jelen esetben az összes oszlop, kivéve time.
- Az argumentum neveit idézőjelekben kell megadni. nevet ad a változónak, amely a kombinált oszlopnevekből származik.
- Az a táblázat, amellyel a legkönnyebben megértheti, hogyan állhat át az új koncepcióra. nevet ad a változónak, amely az egyesített oszlopok cellaértékeiből származik.
Specifikációk
Ez a funkció a tidyr, amely korábban elérhetetlen volt a régi függvények használata során.
A specifikáció egy adathalmaz, amelynek minden sora egy új kimeneti adathalmaz egy oszlopához kapcsolódik, és két speciális oszlopa van, amelyek .-val kezdődnek:
- .név tartalmazza az eredeti oszlop nevét.
- .value tartalmazza azt az oszlopnevet, ahová a cellák értékei kerülnek.
A specifikáció többi oszlopa azt mutatja, hogy az új oszlopban hogyan jelennek meg a tömörített oszlopnevek .név.
A specifikáció leírja a metadatákat, amelyek az oszlopnevében tárolódnak, minden oszlophoz egy sor, és egy oszlop az egyesített változók számára, valószínűleg most ez a meghatározás zavarosnak tűnik, de néhány példa után sokkal világosabbá válik.
A specifikáció lényege, hogy lehetővé teszi az új metadaták kinyerését, módosítását és beállítását a konvertált adathalmazon.
A táblázat széles formátumból hosszú formátumba való átalakításához a speciifikációkkal a következő függvény szolgál pivot_longer_spec().
Hogyan működik ez a funkció, veszi bármely adatkeretet, és létrehozza annak metaadatait a fent leírt módon.
Például vegyük a who adatbázist, amely a csomaggal együtt érkezik. tidyrEz az adatbázis az Egészségügyi Világszervezet által szolgáltatott tuberkulózis előfordulási adatait tartalmazza.
who
#># A tibble: 7,240 x 60
#>#    country iso2  iso3   year new_sp_m014 new_sp_m1524 new_sp_m2534
#>#        <chr> <int>       <int>        <int>        <int>
#>#  1 Afghan… AF    AFG    1980          NA           NA           NA
#>#  2 Afghan… AF    AFG    1981          NA           NA           NA
#>#  3 Afghan… AF    AFG    1982          NA           NA           NA
#>#  4 Afghan… AF    AFG    1983          NA           NA           NA
#>#  5 Afghan… AF    AFG    1984          NA           NA           NA
#>#  6 Afghan… AF    AFG    1985          NA           NA           NA
#>#  7 Afghan… AF    AFG    1986          NA           NA           NA
#>#  8 Afghan… AF    AFG    1987          NA           NA           NA
#>#  9 Afghan… AF    AFG    1988          NA           NA           NA
#># 10 Afghan… AF    AFG    1989          NA           NA           NA
#># # … with 7,230 more rows, and 53 more variables
Készítsük el a specifikációját.
spec <- who %>%
  pivot_longer_spec(new_sp_m014:newrel_f65, values_to = "count")
#> # A tibble: 56 x 3
#> .name .value name
#> <chr> <chr> <chr>
#> 1 new_sp_m014 count new_sp_m014
#> 2 new_sp_m1524 count new_sp_m1524
#> 3 new_sp_m2534 count new_sp_m2534
#> 4 new_sp_m3544 count new_sp_m3544
#> 5 new_sp_m4554 count new_sp_m4554
#> 6 new_sp_m5564 count new_sp_m5564
#> 7 new_sp_m65 count new_sp_m65
#> 8 new_sp_f014 count new_sp_f014
#> 9 new_sp_f1524 count new_sp_f1524
#> 10 new_sp_f2534 count new_sp_f2534
#> # … with 46 more rowsMezők country, iso2, iso3 már változók. Feladatunk az oszlopok megfordítása a new_sp_m014 hogy newrel_f65.
Ezekben az oszlopok neveiben a következő információk találhatók:
- Prefix
new_arra utal, hogy az oszlop a tuberkulózis új esetformáiról tartalmaz adatokat, a jelenlegi adatkeret csak új megbetegedésekről tartalmaz információt, ezért a jelen kontextusban ez a prefix nem hordoz jelentéstartalmat. sp/rel/sp/epleírja a betegség diagnosztizálásának módját.m/fa beteg neme.014/1524/2535/3544/4554/65a beteg életkora.
Ezeket az oszlopokat a extract()segítségével el tudjuk választani, használva egy reguláris kifejezést.
spec <- spec %>%
        extract(name, c("diagnosis", "gender", "age"), "new_?(.*)_(.)(.*)")
#> # A tibble: 56 x 5
#> .name .value diagnosis gender age
#> <chr> <chr> <chr> <chr> <chr>
#> 1 new_sp_m014 count sp m 014
#> 2 new_sp_m1524 count sp m 1524
#> 3 new_sp_m2534 count sp m 2534
#> 4 new_sp_m3544 count sp m 3544
#> 5 new_sp_m4554 count sp m 4554
#> 6 new_sp_m5564 count sp m 5564
#> 7 new_sp_m65 count sp m 65
#> 8 new_sp_f014 count sp f 014
#> 9 new_sp_f1524 count sp f 1524
#> 10 new_sp_f2534 count sp f 2534
#> # … with 46 more rowsNe feledje, hogy az oszlop .név változatlan marad, mivel ez a mi indexünk az eredeti adatbázis oszlopneveiben.
A nem és az életkor (oszlopok gender és age) változó értékekkel rendelkeznek, ezért ajánlott ezeket az oszlopokat faktorként kezelni:
spec <-  spec %>%
            mutate(
              gender = factor(gender, levels = c("f", "m")),
              age = factor(age, levels = unique(age), ordered = TRUE)
            )
Végül, hogy az általunk létrehozott specifikációt alkalmazzuk az eredeti adatkeretre, who használni kell az argumentumot spec a funkcióban pivot_longer().
who %>% pivot_longer(spec = spec)
#> # A tibble: 405,440 x 8
#>    country     iso2  iso3   year diagnosis gender age   count
#>    <chr>       <chr> <chr> <int> <chr>     <fct>  <ord> <int>
#>  1 Afghanistan AF    AFG    1980 sp        m      014      NA
#>  2 Afghanistan AF    AFG    1980 sp        m      1524     NA
#>  3 Afghanistan AF    AFG    1980 sp        m      2534     NA
#>  4 Afghanistan AF    AFG    1980 sp        m      3544     NA
#>  5 Afghanistan AF    AFG    1980 sp        m      4554     NA
#>  6 Afghanistan AF    AFG    1980 sp        m      5564     NA
#>  7 Afghanistan AF    AFG    1980 sp        m      65       NA
#>  8 Afghanistan AF    AFG    1980 sp        f      014      NA
#>  9 Afghanistan AF    AFG    1980 sp        f      1524     NA
#> 10 Afghanistan AF    AFG    1980 sp        f      2534     NA
#> # … with 405,430 more rows
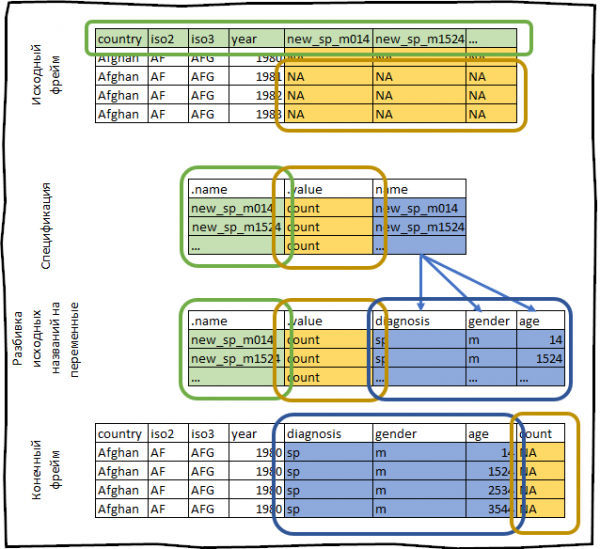
Amit éppen most tettünk, azt vázlatosan a következőképpen ábrázolhatjuk:
Specifikáció több érték (.value) használatával
A fenti példában a specifikációs oszlop .value csak egy értéket tartalmazott, ami a legtöbb esetben így van.
De ritkán előfordulhat olyan helyzet, amikor többféle adatot kell összegyűjteni oszlopokból különböző adattípusokkal. A régi funkcióval spread() ez meglehetősen bonyolult lett volna.
Az alábbi példa a csomagból származik. data.table.
Hozzunk létre egy gyakorlati adatkeretet.
family <- tibble::tribble(
  ~family,  ~dob_child1,  ~dob_child2, ~gender_child1, ~gender_child2,
       1L, "1998-11-26", "2000-01-29",             1L,             2L,
       2L, "1996-06-22",           NA,             2L,             NA,
       3L, "2002-07-11", "2004-04-05",             2L,             2L,
       4L, "2004-10-10", "2009-08-27",             1L,             1L,
       5L, "2000-12-05", "2005-02-28",             2L,             1L,
)
family % mutate_at(vars(starts_with("dob")), parse_date)
#> # A tibble: 5 x 5
#> family dob_child1 dob_child2 gender_child1 gender_child2
#> <int> <date> <date> <int> <int>
#> 1 1 1998-11-26 2000-01-29 1 2
#> 2 2 1996-06-22 NA 2 NA
#> 3 3 2002-07-11 2004-04-05 2 2
#> 4 4 2004-10-10 2009-08-27 1 1
#> 5 5 2000-12-05 2005-02-28 2 1A létrehozott adatkeretben minden sor egy család gyermekeihez tartozó adatokat tartalmaz. A családokban lehet egy vagy két gyermek. Minden gyermek esetében rendelkezésre állnak a születési dátummal és nemmel kapcsolatos adatok, és ezek az adatok külön oszlopokban találhatók, a feladatunk pedig az, hogy ezeket az adatokat a megfelelő elemzési formátumba hozzuk.
Vegyük észre, hogy két változónk van minden gyermek információjára: a neme és a születési dátuma (a dob előtagú oszlopok tartalmazzák a születési dátumot, míg az gender előtagú oszlopok a gyermek nemét tartalmazzák). A várt eredményben ezek külön oszlopokban kellene, hogy szerepeljenek. Ezt úgy érhetjük el, hogy egy specifikációt generálunk, amelyben a .value oszlopnak két különböző értéke lesz.
spec %
  pivot_longer_spec(-family) %>%
  separate(col = name, into = c(".value", "child")) %>%
  mutate(child = parse_number(child))
#> # A tibble: 4 x 3
#>   .name         .value child
#>   <chr>         <chr>  <dbl>
#> 1 dob_child1    dob        1
#> 2 dob_child2    dob        2
#> 3 gender_child1 gender     1
#> 4 gender_child2 gender     2
Tehát nézzük lépésről lépésre, hogy a fenti kód mit csinál.
pivot_longer_spec(-family)— egy specifikációt hozunk létre, amely összevonja az összes meglévő oszlopot, kivéve a family oszlopot.separate(col = name, into = c(".value", "child"))— szeparáljuk a .névoszlopot, amely az eredeti mezők neveit tartalmazza, alsó vonalas elválasztással, és az így kapott értékeket oszlopokba helyezzük. .value és child.mutate(child = parse_number(child))— a child mező értékeit szövegesből numerikus adattípusra konvertáljuk.
Most alkalmazhatjuk a megadott specifikációt az eredeti adatkeretre, és átalakíthatjuk a táblázatot a kívánt formátumba.
family %>%
    pivot_longer(spec = spec, na.rm = T)
#> # A tibble: 9 x 4
#> family child dob gender
#> <int> <dbl> <date> <int>
#> 1 1 1 1998-11-26 1
#> 2 1 2 2000-01-29 2
#> 3 2 1 1996-06-22 2
#> 4 3 1 2002-07-11 2
#> 5 3 2 2004-04-05 2
#> 6 4 1 2004-10-10 1
#> 7 4 2 2009-08-27 1
#> 8 5 1 2000-12-05 2
#> 9 5 2 2005-02-28 1A na.rm = TRUE paramétert használjuk. na.rm = TRUE, mert a jelenlegi adatforma szükségtelen sorok létrehozását kényszeríti a nem létező megfigyelésekhez. Mivel a 2. családnak csak egy gyermeke van, na.rm = TRUE garantálja, hogy a 2. családnak egy sora lesz a kimeneti adatokban.
Adatkeretek átalakítása hosszú formátumból széles formátumba
pivot_wider() — a visszafelé történő átalakítás, és ezáltal növeli az adatkeret oszlopainak számát a sorok számának csökkentésével.
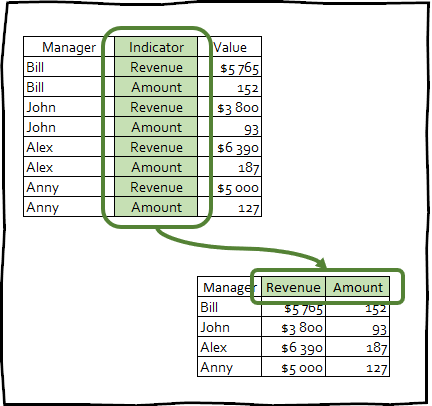
Az ilyen típusú átalakítás rendkívül ritkán használatos az adatok megfelelő formába hozására, mindazonáltal ez a technika hasznos lehet a prezentációkhoz használt összesítő táblázatok készítéséhez, vagy más eszközökkel való integrációhoz.
Valójában a funkciók pivot_longer() és pivot_wider() szimmetrikusak, és egymásnak ellentétes hatásokat gyakorolnak, vagyis: df %>% pivot_longer(spec = spec) %>% pivot_wider(spec = spec) és df %>% pivot_wider(spec = spec) %>% pivot_longer(spec = spec) visszaadja az eredeti df-t.
Egyszerű példa egy táblázat széles formátumba való átalakítására
A funkció működésének bemutatásához pivot_wider() az alábbi adathalmazon fogunk dolgozni fish_encounters, amely egy olyan információt tárol, hogy különböző állomások hogyan rögzítik a halak mozgását a folyóban.
#> # A tibble: 114 x 3
#>    fish  station  seen
#>    <fct> <fct>   <int>
#>  1 4842  Release     1
#>  2 4842  I80_1       1
#>  3 4842  Lisbon      1
#>  4 4842  Rstr        1
#>  5 4842  Base_TD     1
#>  6 4842  BCE         1
#>  7 4842  BCW         1
#>  8 4842  BCE2        1
#>  9 4842  BCW2        1
#> 10 4842  MAE         1
#> # … with 104 more rows
Többnyire ez a táblázat informatívabb és használhatóbb lesz, ha az információt minden állomásra külön oszlopban mutatjuk be.
fish_encounters %>% pivot_wider(names_from = station, values_from = seen)
fish_encounters %>% pivot_wider(names_from = station, values_from = seen)
#> # A tibble: 19 x 12
#>    fish  Release I80_1 Lisbon  Rstr Base_TD   BCE   BCW  BCE2  BCW2   MAE
#>        &
#>  1 4842        1     1      1     1       1     1     1     1     1     1
#>  2 4843        1     1      1     1       1     1     1     1     1     1
#>  3 4844        1     1      1     1       1     1     1     1     1     1
#>  4 4845        1     1      1     1       1    NA    NA    NA    NA    NA
#>  5 4847        1     1      1    NA      NA    NA    NA    NA    NA    NA
#>  6 4848        1     1      1     1      NA    NA    NA    NA    NA    NA
#>  7 4849        1     1     NA    NA      NA    NA    NA    NA    NA    NA
#>  8 4850        1     1     NA     1       1     1     1    NA    NA    NA
#>  9 4851        1     1     NA    NA      NA    NA    NA    NA    NA    NA
#> 10 4854        1     1     NA    NA      NA    NA    NA    NA    NA    NA
#>  # … 9 további sorral, és 1 további változó: MAW
Ez az adathalmoz csak akkor rögzíti az információt, amikor a halat az állomás észlelte, vagyis ha bármilyen hal nem volt rögzítve akármelyik állomás által, akkor ezek az adatok nem lesznek a táblázatban. Ez azt jelenti, hogy a kimeneti adatok NA értékekkel lesznek kitöltve.
Mindazonáltal ebben az esetben tudjuk, hogy a rögzítés hiánya azt jelenti, hogy a hal nem volt észlelve, ezért használhatjuk az argumentumot values_fill a funkcióban pivot_wider() és a hiányzó értékeket nullákra kitölteni:
fish_encounters %>% pivot_wider(
  names_from = station,
  values_from = seen,
  values_fill = list(seen = 0)
)
#> # A tibble: 19 x 12
#> fish Release I80_1 Lisbon Rstr Base_TD BCE BCW BCE2 BCW2 MAE
#> <fct> <int> <int> <int> <int> <int> <int> <int> <int> <int> <int>
#> 1 4842 1 1 1 1 1 1 1 1 1 1
#> 2 4843 1 1 1 1 1 1 1 1 1 1
#> 3 4844 1 1 1 1 1 1 1 1 1 1
#> 4 4845 1 1 1 1 1 0 0 0 0 0
#> 5 4847 1 1 1 0 0 0 0 0 0 0
#> 6 4848 1 1 1 1 0 0 0 0 0 0
#> 7 4849 1 1 0 0 0 0 0 0 0 0
#> 8 4850 1 1 0 1 1 1 1 0 0 0
#> 9 4851 1 1 0 0 0 0 0 0 0 0
#> 10 4854 1 1 0 0 0 0 0 0 0 0
#> # … with 9 more rows, and 1 more variable: MAW <int>Oszlopnév generálása több forrásváltozóból
Képzeljük el, hogy van egy táblázatunk, amely a termék, az ország és az év kombinációját tartalmazza. A teszt adatkeret generálásához a következő kódot futtathatjuk:
df %
  filter((product == "A" & country == "AI") | product == "B") %>%
  mutate(value = rnorm(nrow(.)))
#> # A tibble: 45 x 4
#> product country year value
#> <chr> <chr> <int> <dbl>
#> 1 A AI 2000 -2.05
#> 2 A AI 2001 -0.676
#> 3 A AI 2002 1.60
#> 4 A AI 2003 -0.353
#> 5 A AI 2004 -0.00530
#> 6 A AI 2005 0.442
#> 7 A AI 2006 -0.610
#> 8 A AI 2007 -2.77
#> 9 A AI 2008 0.899
#> 10 A AI 2009 -0.106
#> # … with 35 more rowsA feladatunk az, hogy kiterjesszük az adatkeretet úgy, hogy egy oszlop tartalmazza az összes termék és ország kombináció adatait. Ehhez elegendő átadni az names_from vektort, amely az egyesített mezők neveit tartalmazza.
df %>% pivot_wider(names_from = c(product, country),
                 values_from = "value")
#> # A tibble: 15 x 4
#> year A_AI B_AI B_EI
#> <int> <dbl> <dbl> <dbl>
#> 1 2000 -2.05 0.607 1.20
#> 2 2001 -0.676 1.65 -0.114
#> 3 2002 1.60 -0.0245 0.501
#> 4 2003 -0.353 1.30 -0.459
#> 5 2004 -0.00530 0.921 -0.0589
#> 6 2005 0.442 -1.55 0.594
#> 7 2006 -0.610 0.380 -1.28
#> 8 2007 -2.77 0.830 0.637
#> 9 2008 0.899 0.0175 -1.30
#> 10 2009 -0.106 -0.195 1.03
#> # … with 5 more rowsA funkcióra specifikációkat is alkalmazhat: pivot_wider(). De a megadáskor pivot_wider() a specifikáció olyan átalakítást hajt végre, amely ellentétes pivot_longer(): oszlopokat hoz létre, amelyek a .névszámos mezőből és az .value más oszlopokból származik.
Ehhez az adathalmazhoz testreszabott specifikációt generálhat, ha azt szeretné, hogy minden lehetséges ország és termék kombináció saját oszlopa legyen, nem pedig csak azok, amelyek az adatokban szerepelnek:
spec %
  expand(product, country, .value = "value") %>%
  unite(".name", product, country, remove = FALSE)
#> # A tibble: 4 x 4
#> .name product country .value
#> <chr> <chr> <chr> <chr>
#> 1 A_AI A AI value
#> 2 A_EI A EI value
#> 3 B_AI B AI value
#> 4 B_EI B EI valuedf %>% pivot_wider(spec = spec) %>% head()#> # A tibble: 6 x 5
#> year A_AI A_EI B_AI B_EI
#> <int> <dbl> <dbl> <dbl> <dbl>
#> 1 2000 -2.05 NA 0.607 1.20
#> 2 2001 -0.676 NA 1.65 -0.114
#> 3 2002 1.60 NA -0.0245 0.501
#> 4 2003 -0.353 NA 1.30 -0.459
#> 5 2004 -0.00530 NA 0.921 -0.0589
#> 6 2005 0.442 NA -1.55 0.594Több haladó példa az új tidyr koncepció működésére
Adatok rendezett megjelenése az Egyesült Államok jövedelmi és bérleti adatainak népszámlálása alapján
Az adathalmaz us_rent_income információt tartalmaz az átlagos jövedelemről és a bérleti díjról az Egyesült Államok minden államában 2017-re vonatkozóan (az adathalmaz elérhető a tidycensus).
us_rent_income
#> # A tibble: 104 x 5
#>    GEOID NAME       variable estimate   moe
#>
#>  1 01    Alabama    income      24476   136
#>  2 01    Alabama    rent          747     3
#>  3 02    Alaska     income      32940   508
#>  4 02    Alaska     rent         1200    13
#>  5 04    Arizona    income      27517   148
#>  6 04    Arizona    rent          972     4
#>  7 05    Arkansas   income      23789   165
#>  8 05    Arkansas   rent          709     5
#>  9 06    California income      29454   109
#> 10 06    California rent         1358     3
#> # … további 94 sor
A formátumban, ahogyan az adatok tárolva vannak az adatkeretben us_rent_income nagyon kényelmetlen velük dolgozni, ezért szeretnénk létrehozni egy adathalmazt az alábbi oszlopokkal: rent, rent_moe, come, income_moe. Számos módja van ennek a specifikációnak a létrehozására, de a lényeg az, hogy meg kell generálni minden változó és a estimate/moe, majd létrehozni a oszlop nevét.
  spec %
    expand(variable, .value = c("estimate", "moe")) %>%
    mutate(
      .name = paste0(variable, ifelse(.value == "moe", "_moe", ""))
    )
#> # A tibble: 4 x 3
#> variable .value .name
#> <chr> <chr> <chr>
#> 1 income estimate income
#> 2 income moe income_moe
#> 3 rent estimate rent
#> 4 rent moe rent_moeA specifikáció megadása pivot_wider() az eredményt ad, amit keresünk:
us_rent_income %>% pivot_wider(spec = spec)
#> # A tibble: 52 x 6
#>    GEOID NAME                 income income_moe  rent rent_moe
#>    <chr> <chr>                 <dbl>      <dbl> <dbl>    <dbl>
#>  1 01    Alabama               24476        136   747        3
#>  2 02    Alaska                32940        508  1200       13
#>  3 04    Arizona               27517        148   972        4
#>  4 05    Arkansas              23789        165   709        5
#>  5 06    California            29454        109  1358        3
#>  6 08    Colorado              32401        109  1125        5
#>  7 09    Connecticut           35326        195  1123        5
#>  8 10    Delaware              31560        247  1076       10
#>  9 11    District of Columbia  43198        681  1424       17
#> 10 12    Florida               25952         70  1077        3
#> # … with 42 more rows
Világbank
Néha az adathalmaz megfelelő formába hozása több lépést igényel.
Adathalmaz world_bank_pop tartalmazza a világbank adatait minden ország népességéről 2000 és 2018 között.
#> # A tibble: 1,056 x 20
#>    country indicator `2000` `2001` `2002` `2003`  `2004`  `2005`   `2006`
#>    <chr>   <chr>      <dbl>  <dbl>  <dbl>  <dbl>   <dbl>   <dbl>    <dbl>
#>  1 ABW     SP.URB.T… 4.24e4 4.30e4 4.37e4 4.42e4 4.47e+4 4.49e+4  4.49e+4
#>  2 ABW     SP.URB.G… 1.18e0 1.41e0 1.43e0 1.31e0 9.51e-1 4.91e-1 -1.78e-2
#>  3 ABW     SP.POP.T… 9.09e4 9.29e4 9.50e4 9.70e4 9.87e+4 1.00e+5  1.01e+5
#>  4 ABW     SP.POP.G… 2.06e0 2.23e0 2.23e0 2.11e0 1.76e+0 1.30e+0  7.98e-1
#>  5 AFG     SP.URB.T… 4.44e6 4.65e6 4.89e6 5.16e6 5.43e+6 5.69e+6  5.93e+6
#>  6 AFG     SP.URB.G… 3.91e0 4.66e0 5.13e0 5.23e0 5.12e+0 4.77e+0  4.12e+0
#>  7 AFG     SP.POP.T… 2.01e7 2.10e7 2.20e7 2.31e7 2.41e+7 2.51e+7  2.59e+7
#>  8 AFG     SP.POP.G… 3.49e0 4.25e0 4.72e0 4.82e0 4.47e+0 3.87e+0  3.23e+0
#>  9 AGO     SP.URB.T… 8.23e6 8.71e6 9.22e6 9.77e6 1.03e+7 1.09e+7  1.15e+7
#> 10 AGO     SP.URB.G… 5.44e0 5.59e0 5.70e0 5.76e0 5.75e+0 5.69e+0  4.92e+0
#> # … with 1,046 more rows, and 11 more variables: `2007` <dbl>,
#> #   `2008` <dbl>, `2009` <dbl>, `2010` <dbl>, `2011` <dbl>, `2012` <dbl>,
#> #   `2013` <dbl>, `2014` <dbl>, `2015` <dbl>, `2016` <dbl>, `2017` <dbl>
Célunk egy rendezett adathalmaz létrehozása, ahol minden változó külön oszlopban található. Jelenleg nem világos, hogy pontosan milyen lépések szükségesek, de a legnyilvánvalóbb problémával kezdjük: az év több oszlopra van osztva.
Ehhez a hiba javításához az alábbi függvényt kell használni. pivot_longer().
pop2 %
  pivot_longer(`2000`:`2017`, names_to = "year")
#> # A tibble: 19,008 x 4
#> country indicator year value
#> <chr> <chr> <chr> <dbl>
#> 1 ABW SP.URB.TOTL 2000 42444
#> 2 ABW SP.URB.TOTL 2001 43048
#> 3 ABW SP.URB.TOTL 2002 43670
#> 4 ABW SP.URB.TOTL 2003 44246
#> 5 ABW SP.URB.TOTL 2004 44669
#> 6 ABW SP.URB.TOTL 2005 44889
#> 7 ABW SP.URB.TOTL 2006 44881
#> 8 ABW SP.URB.TOTL 2007 44686
#> 9 ABW SP.URB.TOTL 2008 44375
#> 10 ABW SP.URB.TOTL 2009 44052
#> # … with 18,998 more rowsA következő lépés az indicator változó megvizsgálása.
pop2 %>% count(indicator)
#> # A tibble: 4 x 2
#>   indicator       n
#>   <chr>       <int>
#> 1 SP.POP.GROW  4752
#> 2 SP.POP.TOTL  4752
#> 3 SP.URB.GROW  4752
#> 4 SP.URB.TOTL  4752
Ahol SP.POP.GROW – népességnövekedés, SP.POP.TOTL – teljes népesség, SP.URB. * pedig ugyanaz, de csak a városi területekre vonatkozik. Osszuk el ezeket az értékeket két változóra: area – terület (total vagy urban) és a tényleges adatokat tartalmazó változóra (population vagy growth):
pop3 %
  separate(indicator, c(NA, "area", "variable"))
#> # A tibble: 19,008 x 5
#> country area variable year value
#> <chr> <chr> <chr> <chr> <dbl>
#> 1 ABW URB TOTL 2000 42444
#> 2 ABW URB TOTL 2001 43048
#> 3 ABW URB TOTL 2002 43670
#> 4 ABW URB TOTL 2003 44246
#> 5 ABW URB TOTL 2004 44669
#> 6 ABW URB TOTL 2005 44889
#> 7 ABW URB TOTL 2006 44881
#> 8 ABW URB TOTL 2007 44686
#> 9 ABW URB TOTL 2008 44375
#> 10 ABW URB TOTL 2009 44052
#> # … with 18,998 more rowsMost már csak a variable változót kell két oszlopra osztanunk:
pop3 %>%
  pivot_wider(names_from = variable, values_from = value)
#> # A tibble: 9,504 x 5
#> country area year TOTL GROW
#> <chr> <chr> <chr> <dbl> <dbl>
#> 1 ABW URB 2000 42444 1.18
#> 2 ABW URB 2001 43048 1.41
#> 3 ABW URB 2002 43670 1.43
#> 4 ABW URB 2003 44246 1.31
#> 5 ABW URB 2004 44669 0.951
#> 6 ABW URB 2005 44889 0.491
#> 7 ABW URB 2006 44881 -0.0178
#> 8 ABW URB 2007 44686 -0.435
#> 9 ABW URB 2008 44375 -0.698
#> 10 ABW URB 2009 44052 -0.731
#> # … with 9,494 more rowsKapcsolatok listája
Az utolsó példa, képzelje el, hogy van egy kontaklista, amit egy weboldalról másolt be:
contacts <- tribble(
  ~field, ~value,
  "name", "Jiena McLellan",
  "company", "Toyota",
  "name", "John Smith",
  "company", "google",
  "email", "john@google.com",
  "name", "Huxley Ratcliffe"
)
Ezt a listát táblázatos formájúvá alakítani elég bonyolult, mert nincs olyan változó, ami azonosítaná, hogy melyik adat melyik kontaktra vonatkozik. Ezen segíthetünk azzal, hogy észrevesszük, hogy minden új kontakt adat kezdődik egy névvel ("name"), így létrehozhatunk egy egyedi azonosítót, és növelhetjük azt egy egységgel, amikor a field oszlopban "name" értéket látunk:
contacts %
  mutate(
    person_id = cumsum(field == "name")
  )
contacts
#> # A tibble: 6 x 3
#> field value person_id
#> <chr> <chr> <int>
#> 1 name Jiena McLellan 1
#> 2 company Toyota 1
#> 3 name John Smith 2
#> 4 company google 2
#> 5 email john@google.com 2
#> 6 name Huxley Ratcliffe 3Most, hogy van egyedi azonosítónk minden kontaktra, megfordíthatjuk a field és value mezőket oszlopokká:
contacts %>%
  pivot_wider(names_from = field, values_from = value)
#> # A tibble: 3 x 4
#> person_id name company email
#> <int> <chr> <chr> <chr>
#> 1 1 Jiena McLellan Toyota <NA>
#> 2 2 John Smith google john@google.com
#> 3 3 Huxley Ratcliffe <NA> <NA>Zárás
Személy szerint véleményem szerint az új koncepció tidyr valóban intuitívabb, és jelentősen meghaladja a régi funkciók teljesítményét. spread() és gather()Remélem, ez a cikk segített az Ön számára a megértésben. pivot_longer() és pivot_wider().
Forrás: habr.com
