

Folytatva a témát a nagy adatfolyamok rögzítéséről, amelyet , ebben a cikkben megvizsgáljuk azokat a módszereket, amelyekkel csökkenthetjük a PostgreSQL-ben tárolt adatok 'fizikai' méretét, és ezek hatását a szerver teljesítményére.
A TOAST beállításokról és az adatok igazításáról lesz szó. . 'Átlagosan' ezek a módszerek nem fognak túl sok erőforrást megtakarítani, de — teljesen kódmódosítás nélkül.Azonban tapasztalataink ezen a téren meglehetősen eredményesek voltak, mivel szinte bármely monitorozás tárolója alapvetően
többnyire append-only az írt adatok szempontjából. És ha érdekli, hogyan tudja megtanítani az adatbázist, hogy a lemezre írjon a helyett, hogy 200MB/s a felére — kérem, olvassa tovább. Kis titkok a nagy adatok világában
A szolgáltatásunk profilja
, rendszeresen kap Mivel a Sbis rendszere, amelynek adatbázisait figyeljük, egy többkomponensű termék összetett adatstruktúrákkal, ezért a lekérdezések.
a maximális teljesítmény elérése érdekében 'több kötetűek' bonyolult algoritmikus logikával . Így a kérés vagy a kapott végrehajtási terv egyes példányainak mérete a hozzánk érkező naplóban 'átlagosan' meglehetősen nagy. Nézzük meg az egyik táblázat struktúráját, ahová az 'nyers' adatokat írjuk — azaz az eredeti szöveget a naplóbejegyzésből: Tipikus ilyen táblázat (már szekcionálva, természetesen, így ez egy szekciós sablon), ahol a legfontosabb a szöveg. Néha meglehetősen terjedelmes.
Emlékezzünk, hogy a PostgreSQL-ben egy bejegyzés 'fizikai' mérete nem lehet több egy adatoldalnál, de a 'logikai' méret — egészen más dolog. A terjedelmes érték ('varchar/text/bytea') mezőbe írásához a
TOAST technológiát használjuk.Tipikus ilyen táblázat (már szekcionált, természetesen, ezért ez egy szekciós sablon), ahol a legfontosabb a szöveg. Néha elegendő egy terjedelmesebb.
Emlékezzünk arra, hogy a PG „fizikai” mérete egy rekordnak nem foglalhat el többet egy adatoldalnál, de a „logikai” méret egészen más dolog. Ahhoz, hogy egy mezőbe terjedelmes értéket írjunk (varchar/text/bytea), a következőt használjuk :
A PostgreSQL fixált méretű oldalakat használ (általában 8 KB), és nem engedi meg, hogy a tuple-ök több oldalt foglaljanak el. Ezért nem lehet közvetlenül nagyon nagy mezőértékeket tárolni. E korlát leküzdésére a nagy mezőértékek tömörítve és/vagy több fizikai sorra bontva kerülnek tárolásra. Ez a felhasználó számára észrevétlenül zajlik, és a szerver kódjának nagy részére alig van hatással. Ezt a módszert TOAST-nak hívják …
Valójában, minden „potenciálisan nagy” mezővel rendelkező táblához automatikusan minden „nagy” rekord 2KB-ra bontva:
TOAST(
  chunk_id
    integer
, chunk_seq
    integer
, chunk_data
    bytea
, PRIMARY KEY(chunk_id, chunk_seq)
);
Tehát, ha be kell írnunk egy sort „nagy” értékkel data, akkor a tényleges bejegyzés nemcsak a fő táblába és annak PK-jába, hanem a TOAST-ba és annak PK-jába is megtörténik. A TOAST-hatás csökkentése.
De a legtöbb rekordunk valójában nem olyan nagy,
8KB-ba kellene férnie — hogyan takaríthatunk meg ennyit?.. Itt jön a segítségünkre a táblázat oszlopának
STORAGE EXTENDED
- tömörítést és külön tárolást is megenged. Ez a legtöbb, TOAST-tal kompatibilis adattípus standard változata. Először a tömörítés megkísérlése történik, majd – ha a sor még mindig túl nagy – a táblán kívüli tárolás. MAIN tömörítést enged, de nem külön tárolást. (Valójában a külön tárolás, mindazonáltal, végrehajtásra kerül az ilyen oszlopoknál, de csak
- végső megoldásként , ha nincs más lehetőség a sor méretének csökkentésére, hogy az a lapra illeszkedjen.) Valójában, ez pontosan az, amire szükségünk van a szöveges adatainkhoz —a lehető legnagyobb tömörítés, ha pedig abszolút nem fér el — ki kellene helyezni a TOAST-ba.
Ezt „elektronikus úton”, egy parancs segítségével megtehetjük: ALTER TABLE rawdata_orig ALTER COLUMN data SET STORAGE MAIN;A hatás értékelése
Mivel minden nap az adatáramlás változik, nem tudunk abszolút számokat összehasonlítani, de relatív értelemben minélkisebb részesedést
tároltunk a TOAST-ban — annál jobb. De itt van egy veszély — minél nagyobb a „fizikai” mérete minden egyes bejegyzésnek, annál „szélesebb” lesz az index, mivel több adatlapot kell takarni. Szakasz a változtatások előtt
heap = 37GB (39%) TOAST = 54GB (57%) PK = 4GB ( 4%) változtatások után:
heap  = 37GB (67%)
TOAST = 16GB (29%)
PK    =  2GB ( 4%)
heap = 37GB (39%) TOAST = 54GB (57%) PK = 4GB ( 4%) Valójában, mi:
heap  = 37GB (67%)
TOAST = 16GB (29%)
PK    =  2GB ( 4%)
Valójában mi A TOAST-hoz való írás gyakorisága a felére csökkent., ami nemcsak a lemezt, hanem a CPU-t is tehermentesítette:
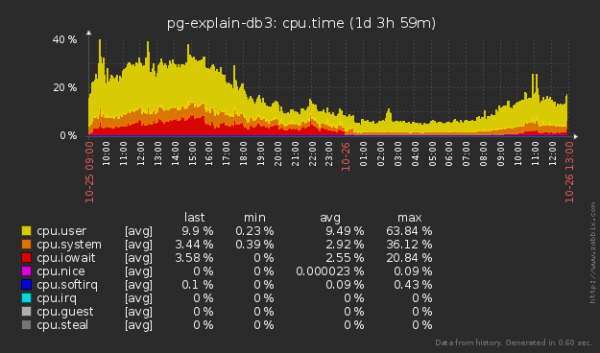
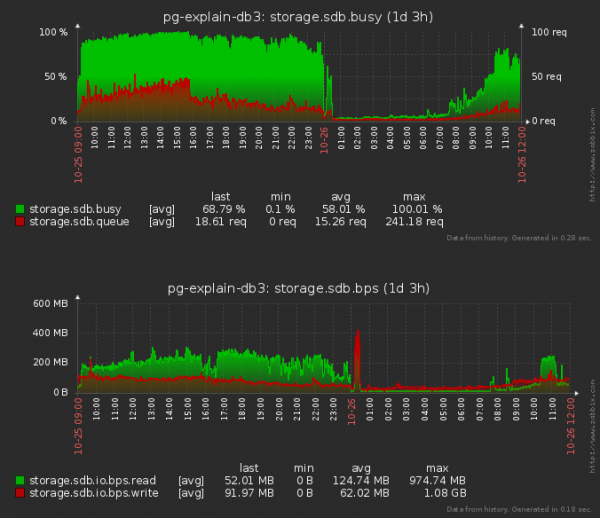
Megjegyzem, hogy a lemezt is kevesebbszer "olvassuk", nemcsak "írunk" - mivel egy rekord táblába való beillesztésekor a fa egy részét is "ki kell olvasnunk", hogy meghatározzuk annak jövőbeli pozícióját az indexekben.
Kinek jó élni PostgreSQL 11 alatt
A PG11-re való frissítés után úgy döntöttünk, hogy folytatjuk a TOAST "finomhangolását", és észrevettük, hogy ettől a verziótól elérhetővé vált egy paraméter beállítása, :
A TOAST feldolgozási kód csak akkor lép életbe, ha a táblázatban tárolni kívánt sor értéke nagyobb, mint a TOAST_TUPLE_THRESHOLD bájt (általában ez 2 Kb). A TOAST kód tömöríti és/vagy a táblázaton kívülre helyezi a mező értékeit, amíg a sor értéke nem lesz kisebb, mint a TOAST_TUPLE_TARGET bájt (változó méret, szintén általában 2 Kb), vagy amíg nem lehet csökkenteni a méretét.
Úgy döntöttünk, hogy az adatok általában vagy "nagyon rövidek", vagy "nagyon hosszúak", ezért a lehető legkisebb értéket állapítottuk meg:
ALTER TABLE rawplan_orig SET (toast_tuple_target = 128);Nézzük meg, hogyan hatottak az új beállítások a lemez terhelésére az újra beállítás után:
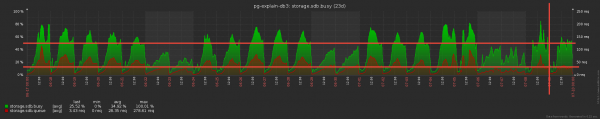
Nem rossz! Az átlagos lemezhez való várakozás körülbelül 1,5-szer csökkent, míg a lemez "kihasználtsága" - 20%-kal! De lehet, hogy ez valahogy hatott a CPU-ra?
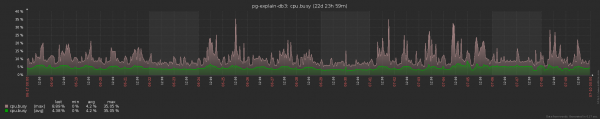
Legalábbis rosszabb nem lett. Bár nehéz megítélni, ha még ezek a mennyiségek sem tudják felemelni a CPU átlagos terhelését a 5%.
A helyeik felcserélésével az összeg... változik!
Mint tudjuk, a fillér is forintot megtakarít, és a mi tárolási mennyiségeink körülbelül 10TB/hónap még egy kis optimalizálás is jelentős hasznot hozhat. Ezért figyeltünk a fizikai adatszerkezetünkre - konkrétan arra, hogyan "helyezkednek el" a mezők egy-egy rekordban a táblák mindegyikében.
Mert a közvetlenül :
Sok architektúra megköveteli az adatok gépi szóhatárok szerinti igazítását. Például egy 32 bites x86 rendszeren az egész számok (integer típus, 4 bájt) 4 bájtos szavak határain lesznek igazítva, akárcsak a dupla pontosságú lebegőpontos számok (double precision típus, 8 bájt). Egy 64 bites rendszerben a double értékek 8 bájtos szavak határain lesznek igazítva. Ez egy másik ok a kompatibilitási problémákra.
A táblázatsor mérete a mezők elhelyezkedésének sorrendjétől függ. Ez a hatás általában nem túl észlelhető, de bizonyos esetekben jelentős méretnövekedést idézhet elő. Például, ha a char(1) és integer típusú mezőket keverve helyezzük el, közöttük általában 3 bájt vész el.
Kezdjük a szintetikus modellekkel:
SELECT pg_column_size(ROW(
  '0000-0000-0000-0000-0000-0000-0000-0000'::uuid
, 0::smallint
, '2019-01-01'::date
));
-- 48 bájt

SELECT pg_column_size(ROW(
  '2019-01-01'::date
, '0000-0000-0000-0000-0000-0000-0000-0000'::uuid
, 0::smallint
));
-- 46 bájt
Honnan jött a pár plusz bájt az első esetben? Egyszerű — A 2 bájtos smallint 4 bájtos határra van igazítva a következő mező előtt, de amikor az utolsóként áll, akkor nincs mit igazítani és miért. Elméletben minden rendben van, és a mezőket szabadon áthelyezhetjük. Nézzük meg valós adatokon egy tábla példájával, amelynek napi része 10-15GB-ot foglal el.
Eredeti struktúra:
CREATE TABLE public.plan_20190220 ( -- Örökölve a plan táblából: pack uuid NOT NULL, -- Örökölve a plan táblából: recno smallint NOT NULL, -- Örökölve a plan táblából: host uuid, -- Örökölve a plan táblából: ts timestamp with time zone, -- Örökölve a plan táblából: exectime numeric(32,3), -- Örökölve a plan táblából: duration numeric(32,3), -- Örökölve a plan táblából: bufint bigint, -- Örökölve a plan táblából: bufmem bigint, -- Örökölve a plan táblából: bufdsk bigint, -- Örökölve a plan táblából: apn uuid, -- Örökölve a plan táblából: ptr uuid, -- Örökölve a plan táblából: dt date, CONSTRAINT plan_20190220_pkey PRIMARY KEY (pack, recno), CONSTRAINT chck_ptr CHECK (ptr IS NOT NULL), CONSTRAINT plan_20190220_dt_check CHECK (dt = '2019-02-20'::date) ) INHERITS (public.plan)
Az oszlopok sorrendjének megváltozása után — pontosanugyanazok a mezők, csak más sorrendben CREATE TABLE public.plan_20190221 ( -- Örökölve a plan táblából: dt date NOT NULL, -- Örökölve a plan táblából: ts timestamp with time zone, -- Örökölve a plan táblából: pack uuid NOT NULL, -- Örökölve a plan táblából: recno smallint NOT NULL, -- Örökölve a plan táblából: host uuid, -- Örökölve a plan táblából: apn uuid, -- Örökölve a plan táblából: ptr uuid, -- Örökölve a plan táblából: bufint bigint, -- Örökölve a plan táblából: bufmem bigint, -- Örökölve a plan táblából: bufdsk bigint, -- Örökölve a plan táblából: exectime numeric(32,3), -- Örökölve a plan táblából: duration numeric(32,3), CONSTRAINT plan_20190221_pkey PRIMARY KEY (pack, recno), CONSTRAINT chck_ptr CHECK (ptr IS NOT NULL), CONSTRAINT plan_20190221_dt_check CHECK (dt = '2019-02-21'::date) ) INHERITS (public.plan):
A szekció összterjedelmét a "tények" száma határozza meg, és csak a külső folyamatoktól függ, ezért oszd el a heap méretét ( pg_relation_sizepg_relation_size) a bejegyzések számának megfelelően - tehát kaptunk a valódi tárolt bejegyzés átlagos méretét:
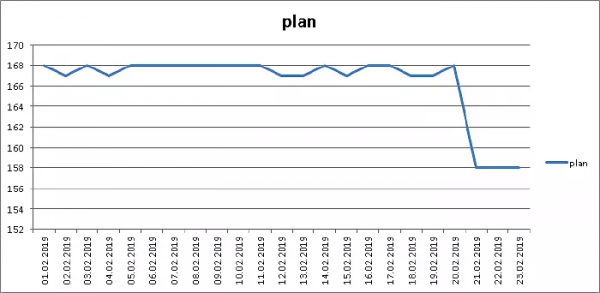
Minusz 6% térfogatot, kiváló!
De persze nem minden olyan rózsás - hiszen az indexekben nem tudjuk megváltoztatni a mezők sorrendjét, ezért 'összességében' (pg_total_relation_size)…
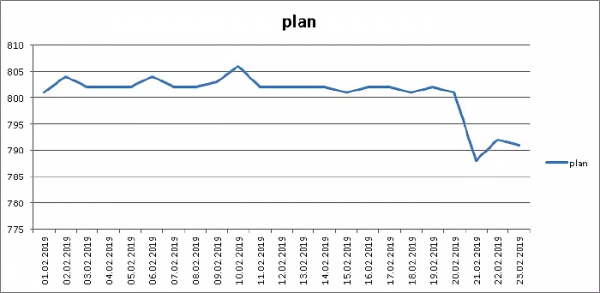
… mégis itt is megtakarítottunk 1.5%-ot, anélkül hogy egy sor kódot is megváltoztattunk volna. Igenis!
Megjegyzem, hogy a fent említett mezőelrendezés nem biztos, hogy a legoptimálisabb. Mivel néhány mezőblokkot esztétikai okokból nem szeretnénk 'szétválasztani' - például egy pár (pack, recno), ami a PK ennek a táblázatnak.
Összességében a 'minimális' mezőelrendezés meghatározása egy viszonylag egyszerű 'próbálgatási' feladat. Ezért a saját adataidon jobb eredményeket is elérhetsz, mint nálunk - próbáld ki!
Forrás: habr.com
