

Javaslatom van, hogy ismerkedjen meg Vladimir Sitnikov 2016 eleji "PostgreSQL és JDBC: minden cseppjét kihasználva" előadásának átírásával.
Jó napot! A nevem Vladimir Sitnikov. 10 éve dolgozom a NetCracker cégnél, és főként a teljesítményre specializálódtam. Minden, ami a Java-hoz és SQL-hez kapcsolódik, az, amit szeretek.
Ma arról fogok beszélni, hogy mikkel szembesültünk a cégnél, amikor elkezdtük a PostgreSQL-t adatbáziszolgáltatóként használni. Főként Java-val dolgozunk, de amit ma elmondok, az nemcsak a Java-hoz kapcsolódik. A gyakorlat azt mutatja, hogy ez más nyelvekben is előfordul.
A következőkről fogunk beszélni:
- az adatok lekérdezéséről.
- az adatok tárolásáról.
- valamint a teljesítményről.
- És a rejtett buktatókról, amelyek ott megbújnak.
Kezdjük egy egyszerű kérdéssel. Egy sor lekérdezését végezzük a táblázat elsődleges kulcsa alapján.
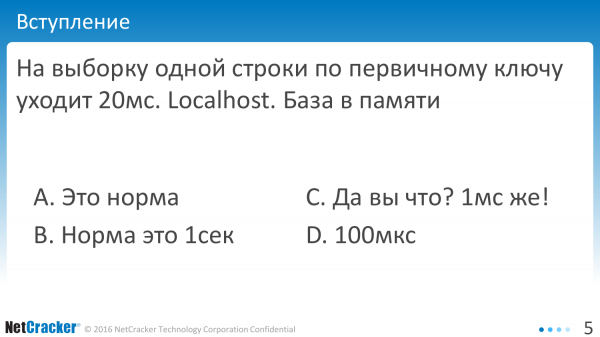
Az adatbázis ugyanazon a hoszton található. És mindez 20 milliszekundumot vesz igénybe.
Ez a 20 milliszekundum nagyon sok. Ha ilyen 100 lekérdezésed van, akkor másodperceket veszítesz azzal, hogy ezeket a lekérdezéseket futtatod, tehát időt pazarolsz.
Ezt nem szeretjük, és megnézzük, mit kínál az adatbázis számunkra ehhez. Az adatbázis két lekérdezési végrehajtási lehetőséget kínál.
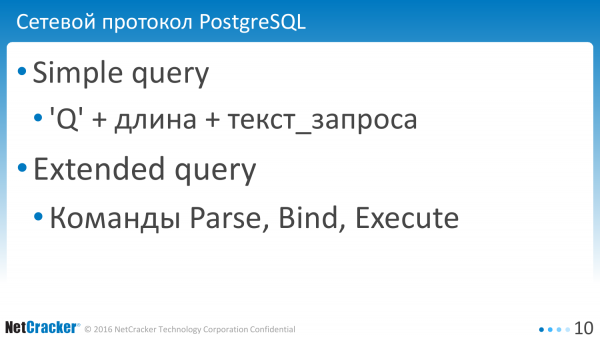
Az első lehetőség egy egyszerű lekérdezés. Miért jó ez? Mert egyszerűen csak elküldjük, és semmi más.
Az adatbázisnak van egy kiterjesztett lekérdezése is, amely okosabb, de funkcionálisabb. Lehetőséged van külön lekérdezéseket küldeni elemzésre, végrehajtásra, változók összekapcsolására stb.
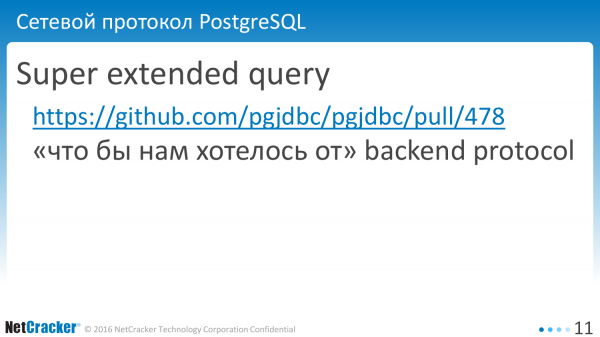
A super extended query az, amiről a jelenlegi előadásunkban nem fogunk beszélni. Lehet, hogy valamit szeretnénk az adatbázistól, és van egy olyan kívánságlista, ami valamilyen formában létrejött, tehát ez az, amit szeretnénk, de jelenleg és a következő évben nem lehetséges. Ezért egyszerűen feljegyeztük és járunk, hogy megpróbáljuk megrázni a kulcsszereplőket.
Ami viszont megtehető, az a simple query és az extended query.
Milyen jellemzői vannak minden egyes megközelítésnek?
Az egyszerű lekérdezést jól lehet használni egyszeri végrehajtásra. Egyszer végrehajtottuk és elfelejtettük. A probléma az, hogy nem támogatja a bináris adatformátumokat, tehát bizonyos nagy teljesítményű rendszerekhez nem alkalmas.
A kiterjesztett lekérdezés lehetővé teszi az időmegtakarítást a parse-nál. Ezt csináltuk és kezdtük el használni. Nagyon-nagyon segített nekünk. Nemcsak a parse-nál van megtakarítás. Az adatátvitelben is van megtakarítás. Az adatok bináris formátumban történő továbbítása lényegesen hatékonyabb.
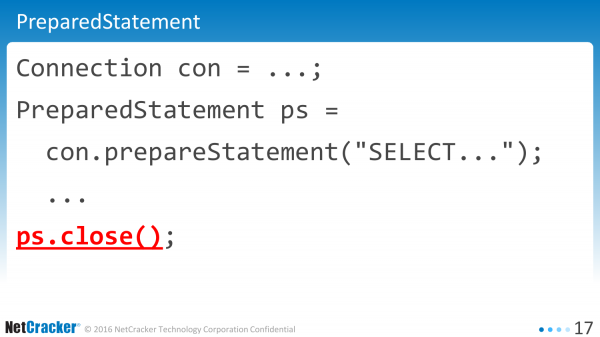
Nézzük a gyakorlatot. Így néz ki egy tipikus alkalmazás. Ez lehet Java stb.
Létrehoztunk egy statementet. Végrehajtottuk a parancsot. Létrehoztunk egy close-t. Hol van itt a hiba? Mi a probléma? Nincsenek problémák. Így van leírva az összes könyvben. Így kell írni. Ha maximális teljesítményt szeretne, akkor így írjon.
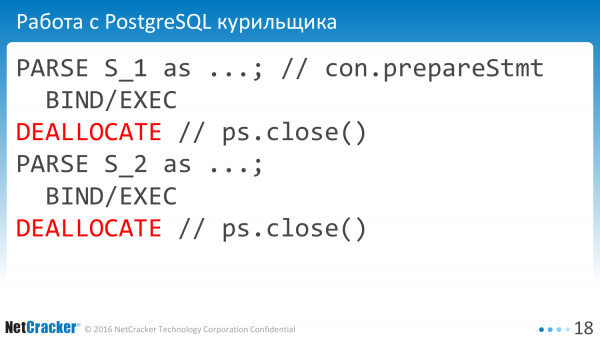
De a gyakorlat azt mutatta, hogy ez nem működik. Miért? Mert van egy ‘close’ metódusunk. És amikor így csináljuk, az adatbázis szempontjából úgy tűnik, mint egy dohányos munkája az adatbázissal. Azt mondtuk: ‘PARSE EXECUTE DEALLOCATE’.
Miért vannak ezek a felesleges létrehozások és statementek kivitele? Senkinek sincs szüksége rá. De általában a PreparedStatement esetében ez történik, amikor bezárjuk, az összeset bezárja az adatbázison. Ez nem az, amit szeretnénk.
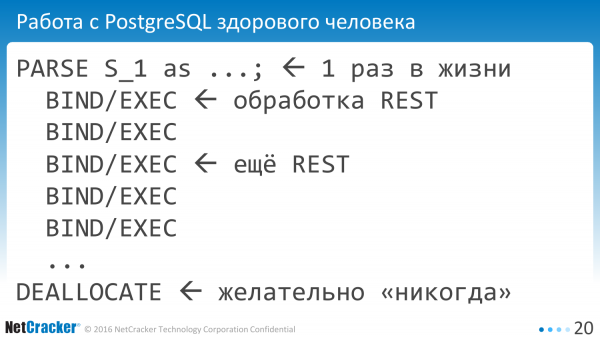
Azt szeretnénk, hogy mint egészséges emberek, dolgozzunk az adatbázissal. Egyszer elkészítettük a statementet, majd sokszor végrehajtjuk. Valójában sokszor – ez egyszer van az alkalmazás élete alatt, és különböző REST esetén azonos statement id-t használunk. Ez a célunk.
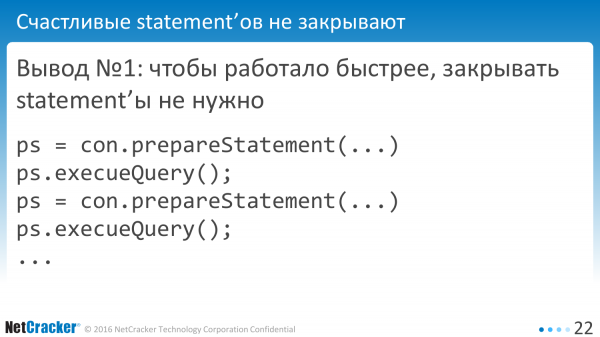
Hogyan érhetjük el ezt?
Nagyon egyszerű – nem kell bezárni a statementeket. Írjuk így: ‘prepare’ ‘execute’.
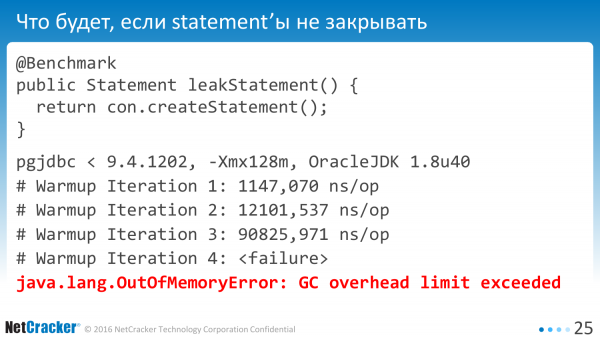
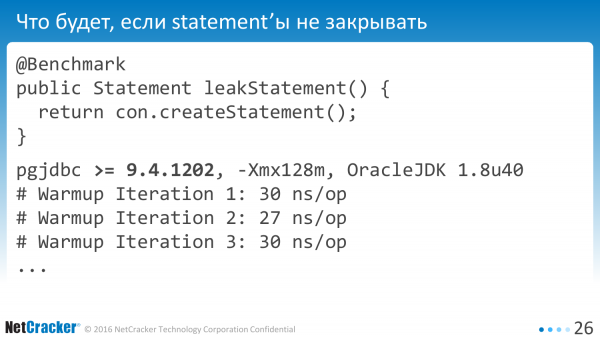
Ha ezt fogjuk futtatni, világos, hogy valahol valami túlcsordul. Ha nem világos, akkor lemérhetjük. Válasszunk egy benchmarkot, amelyben egy ilyen egyszerű metódus van. Létrehozunk egy statementet. Futtatjuk valamelyik driver verzión, és megkapjuk, hogy elég gyorsan megborul az összes memória, ami a megszűnt.
Nyilvánvaló, hogy az ilyen hibák könnyen javíthatók. Erről nem fogok beszélni. De azt mondom, hogy az új verzió sokkal gyorsabban működik. A metódus értelmetlen, de mégis.
Hogyan kell helyesen dolgozni? Mit kell tennünk ezért?
A gyakorlatban az alkalmazások mindig bezárják a statementeket. Minden könyvben azt írják, hogy be kell zárni, különben szivárog a memória.
A PostgreSQL pedig nem tudja cache-elni a lekérdezéseket. Mindegyik session-nek magának kell létrehoznia ezt a cache-t.
Az időt sem akarjuk a parse-ra pazarolni.
És ahogy általában, két lehetőségünk van.
Az első lehetőség – azt mondjuk, hogy mindent csavarjunk be PgSQL-be. Ott van cache. Minden cache-el. Remekül fog működni. Megnéztük ezt. 100500 lekérdezésünk van. Nem működik. Nem értünk egyet – kézzel eljárásokká alakítani a lekérdezéseket. Nem-nem.
Van egy második lehetőség – vegyük és csináljuk meg magunk. Megnyitjuk a forráskódot, és elkezdjük csinálni. Csináljuk-csináljuk. Kiderült, hogy nem is olyan nehéz ezt megtenni.
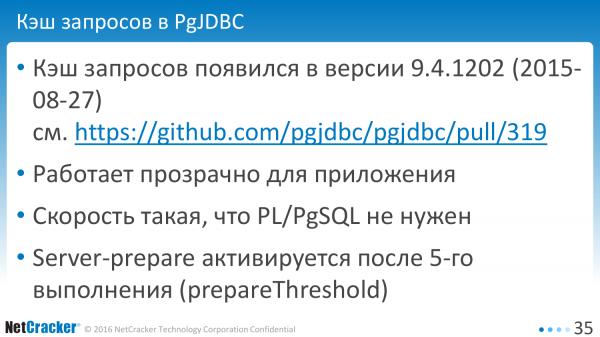
Ez 2015 augusztusában jelent meg. Most már egy modernebb verzió van. És minden szuper. Olyan jól működik, hogy semmit sem változtatunk az alkalmazásban. Még abbahagytuk a PgSQL irányába való gondolkodást is, vagyis ez elég volt ahhoz, hogy a minden költséget gyakorlatilag nullára csökkentsünk.
Ezért a server-prepared statements az 5. végrehajtásnál aktiválódik, hogy ne pazaroljunk memóriát az adatbázisban minden egyes egyszeri lekérdezésre.
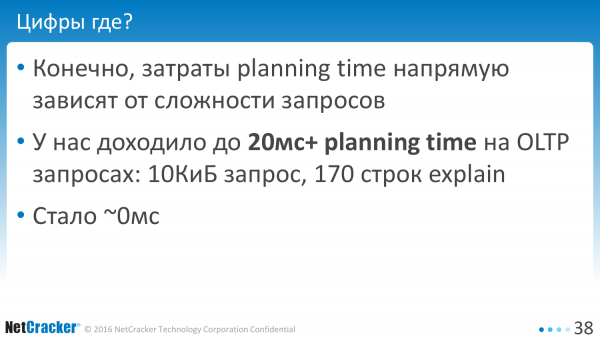
Kérdezheti – hol vannak a számok? Mit kap? Itt viszont számokat nem mondok, mert minden lekérdezésnek saját számai vannak.
Olyan lekérdezéseink voltak, hogy az OLTP lekérdezések parsingjára körülbelül 20 milliszekundumot töltöttünk. Ott volt 0,5 milliszekundum a végrehajtásra, 20 milliszekundum a parsingra. A lekérdezés – 10 KiB szöveg, 170 soros terv. Ez egy OLTP lekérdezés. Kérdez 1, 5, 10 sort, néha többet.
De egyáltalán nem akartuk 20 milliszekundumot pazarolni. Nulla másodpercre csökkentettük. Minden szuper.
Mit vihet innen? Ha Java-ja van, akkor vegye a modern verziójú drivert, és örüljön neki.
Ha más nyelvvel dolgozik, akkor gondolkodjon el – lehet, hogy ezt is meg kellene tennie? Mert a végső nyelv szempontjából, például, ha PL 8 vagy LibPQ van, nem nyilvánvaló, hogy az időt nem a végrehajtásra, hanem a parsingra pazarolja, és ezt érdemes átnézni. Hogyan? Minden ingyenes.
Kivéve, ha vannak hibák, valamilyen sajátosságok. Ezekről most fogunk beszélni. A nagy része az ipari régészethez kapcsolódik, arról, amit felfedeztünk, amibe beleütköztünk.
Ha a lekérdezés dinamikusan generálódik. Ilyen is előfordul. Valaki concatenálja a sorokat, és SQL-lekérdezés lesz belőle.
Miért rossz ez? Azért rossz, mert minden alkalommal végül különböző sorokat kapunk.
És ennek a különböző sorozatnak újra kell számolnia a hashCode-ot. Ez valóban CPU feladat – találni egy hosszú lekérdezést még a meglévő hash-ben sem olyan egyszerű. Tehát a következtetés egyértelmű – ne generálj lekérdezéseket. Tárold őket egy változóban. És örülj neki.
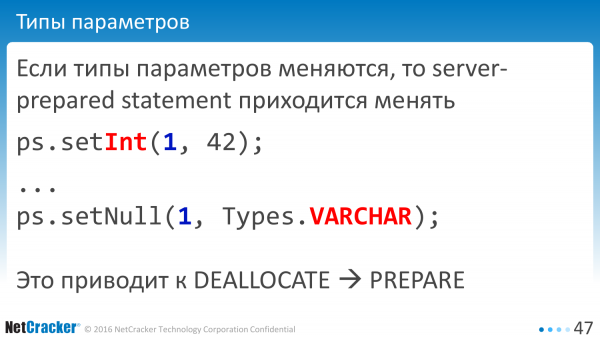
A következő probléma. Az adat típusa fontos. Vannak ORM-ek, amelyek azt mondják, hogy nem mindegy, milyen NULL, legyen csak valamilyen. Ha Int, akkor azt mondjuk, setInt. Ha pedig NULL, akkor legyen mindig VARCHAR. És végül miért is számít, hogy milyen NULL van ott? Az adatbázis magától mindent megért.
A gyakorlatban az adatbázisnak egyáltalán nem mindegy. Ha első alkalommal azt mondtad, hogy ez egy szám, majd a második alkalommal azt mondtad, hogy ez VARCHAR, akkor lehetetlen újra felhasználni a Server-prepared statements-t. Ilyen esetben újra kell létrehozni a statementünket.
Ha ugyanazt a lekérdezést hajtod végre, figyelj arra, hogy az oszlop adat típusa ne keveredjen. Figyelned kell a NULL-ra. Ez gyakori hiba volt nálunk, miután elkezdtük használni a PreparedStatements-t.
Rendben, bekapcsoltuk. Talán vettünk egy drivert. És a teljesítmény csökkent. Minden rossz lett.
Hogy lehet ez? Hiba vagy funkció? Sajnos nem tudtuk megérteni – hiba vagy funkció. De van egy meglehetősen egyszerű reprodukálási forgatókönyv ennek a problémának. Teljesen váratlanul elkapott minket. És ez egy táblából való lekérdezésről szól. Persze, több ilyen lekérdezésünk volt. Ezek általában két-három táblát tartalmaztak, de van egy ilyen reprodukálási forgatókönyv. Vedd le bármelyik verziójú adatbázison és reprodukáld azt.
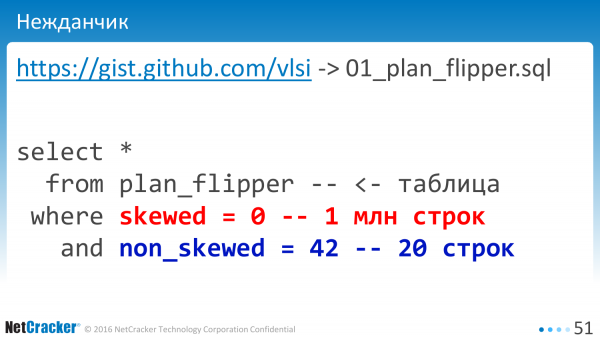
A lényege az, hogy van két oszlopunk, mindkettő indexelve van. Az egyik oszlopban a NULL érték alatt egymillió sor van. A másik oszlopban csak 20 sor van. Amikor összefüggő változók nélkül hajtjuk végre, minden jól működik.
Ha összefüggő változókkal kezdjük el végrehajtani, azaz a lekérdezésünk számára „?” vagy „$1” jelet használunk, akkor mit kapunk végül?
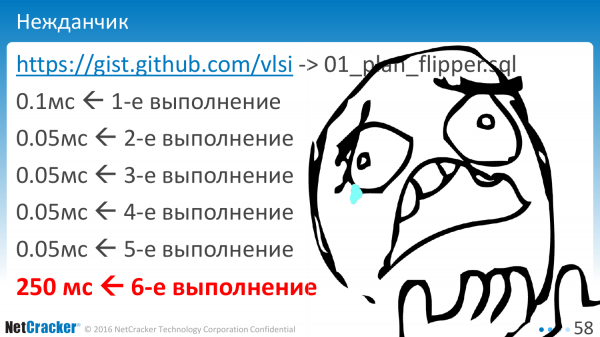
Első végrehajtás – ahogyan kell. Második – kicsit gyorsabb. Valami cache-elt. Harmadik-négyedik-ötödik. Aztán puff – és így. A legrosszabb pedig az, hogy ez a hatodik végrehajtásnál történik. Ki tudta, hogy hat végrehajtásra van szükség ahhoz, hogy megértsük, valójában mi a végrehajtási terv?
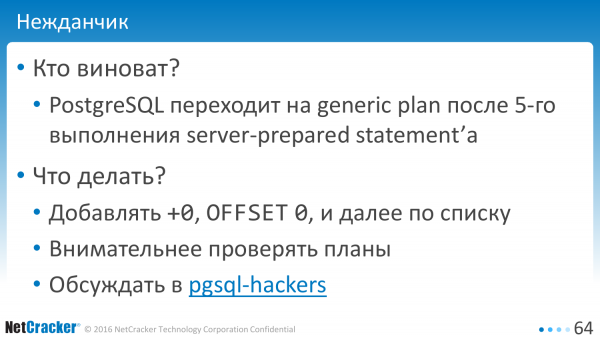
Ki a hibás? Mi történt? Az adatbázis tartalmaz optimalizálást. És úgy van optimalizálva, hogy általános esetben jól működjön. Ennek megfelelően, egy bizonyos alkalomtól kezdve átmegy az általános tervre, ami sajnos lehet más. Lehet ugyanolyan, vagy lehet más. Van egy küszöbérték, ami ezt a viselkedést okozza.
Mit lehet ezzel tenni? Itt persze nehéz valamit feltételezni. Van egy egyszerű megoldás, amit használunk. Ez a +0, OFFSET 0. Biztosan ismered ezeket a megoldásokat. Csak hozzáadjuk a lekérdezéshez a „+0”-t, és minden rendben van. Később megmutatom.
És van egy másik lehetőség is – figyelmesebben kell nézni a terveket. A fejlesztőnek nemcsak a lekérdezést kell megírni, hanem hatszor el kell mondania: „explain analyze”. Ha ötször, az nem megfelelő.
És van egy harmadik lehetőség – levelet írni a pgsql-hackersnek. Írtam, de még nem világos, hogy ez hiba vagy funkció.
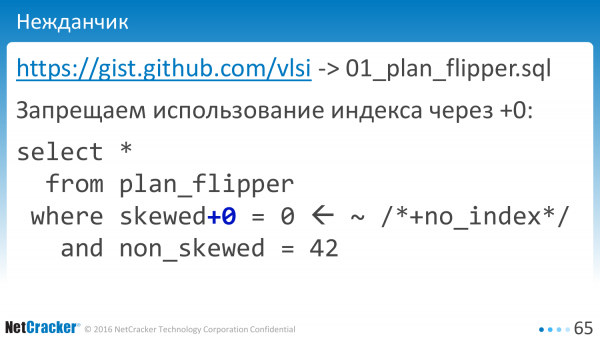
Míg azon gondolkodunk, hogy hiba vagy funkció, javítsuk meg. Vegyük a lekérdezésünket, és adjunk hozzá egy „+0”-t. Minden rendben van. Két karakter, és még csak azon sem kell gondolkodni, hogy mi van ott. Nagyon egyszerű. Csak letiltottuk az adatbázis számára, hogy használja az indexet ezen az oszlopon. Nincs indexünk a „+0” oszlopra, és az adatbázis nem használ indexet, minden rendben van.
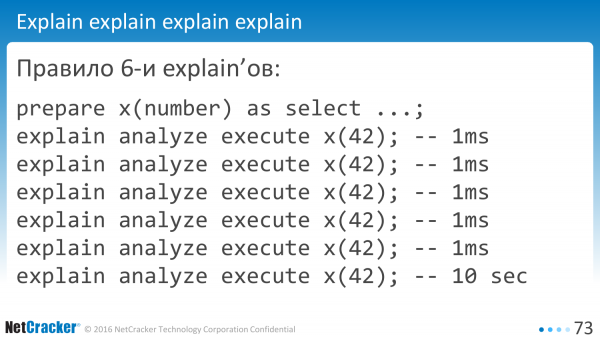
Ez a 6 explain szabály. Jelenlegi verziókban hatszor kell végrehajtani, ha kapcsolódó változók vannak. Ha nincsenek kapcsolódó változók, akkor így csináljuk. A végén pontosan ez a lekérdezés fog megbukni. Nem nagy ügy.
Kinek tűnik ez lehetetlennek? Itt van hiba, ott hiba. Valójában mindenhol hiba van.
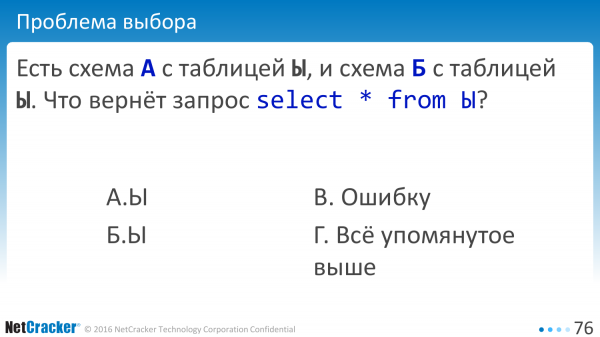
Nézzünk még egy példát. Például van két sémánk. Az „A” séma egy X táblával, a „B” séma szintén egy X táblával. A lekérdezés – adatok kiválasztása a táblából. Mi fog történni? Hibánk lesz. Minden felsorolt hiba jelentkezni fog. A szabály az, hogy mindenhol hiba van, minden felsorolt hiba meg fog jelenni.
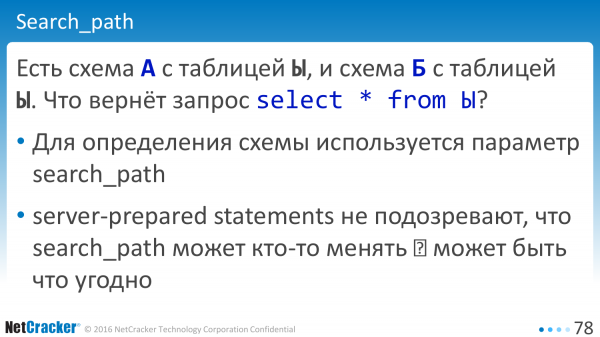
Most a kérdés: „Miért?”. Úgy tűnik, van dokumentáció, hogy ha van sémánk, van egy „search_path” nevű változó, amely megmondja, hol kell keresni a táblát. Úgy tűnik, a változó létezik.
Mi a probléma? A probléma az, hogy a server-prepared statements nem gyanítják, hogy a search_path-t bárki megváltoztathatja. Ez az érték konstanst jelent az adatbázis számára. És bizonyos részek nem tudják átkapcsolni az új értékeket.
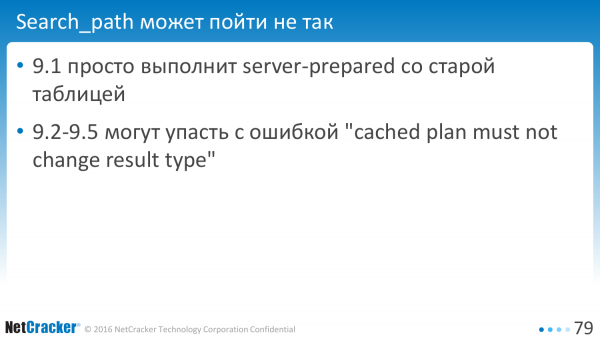
Természetesen ez attól függ, hogy melyik verzión tesztelsz. Attól függ, mennyire komolyan különböznek az adataid. A 9.1-es verzió egyszerűen végrehajtja a régóta használt lekérdezéseket. Az újabb verziók felfedezhetik a csapdát és jelezhetik, hogy hiba történt.
Hogyan lehet ezt orvosolni? Van egy egyszerű recept – ne tedd ezt. Ne változtasd meg a search_path-ot az alkalmazás futása közben. Ha változtatod, akkor inkább hozz létre új kapcsolatot.
Beszélhetünk róla, azaz megnyithatjuk, megbeszélhetjük, kiegészíthetjük. Talán meggyőzzük az adatbázis-fejlesztőket, hogy amikor valaki megváltoztat egy értéket, az adatbázisnak erre figyelmeztetnie kellene a klienst: „Nézd, megváltozott az értéked. Talán újra kellene kezdened a statements-t?” Jelenleg az adatbázis titokban viselkedik és nem közöl semmit arról, hogy a statements-ek valahol belül megváltoztak.
Ismét hangsúlyozni szeretném – ez nem tipikus Java-ra. Ugyanezt látni fogjuk PL/pgSQL esetén is, egy az egyben. De ott reprodukálódni fog.
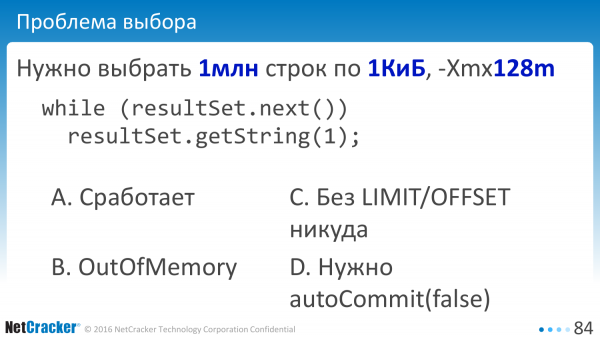
Próbáljuk meg újra kiválasztani az adatokat. Válogatunk–válogatunk. Van egy táblánk millió sorral. Minden sor egy kilobyte. Körülbelül egy gigabyte adatunk van. És van 128 megabyte munkamemóriánk a Java gépen.
A javaslatok szerint, amit az összes könyv mond, folyamatos feldolgozást használunk. Azaz megnyitjuk a resultSet-et és fokozatosan olvassuk ki az adatokat. Működni fog ez? Nem fog hibaüzenetet dobni a memória miatt? Fokozatosan olvasni fog? Higgyünk az adatbázisban, higgyünk a Postgres-ben. De nem hiszünk. Ki esett már OutOfMemory hibába? Ki tudta azt javítani?
Ha van egy millió sorod, akkor nem szabad csak úgy kiválasztani. Mindig szükséges a OFFSET/LIMIT. Ki támogatja ezt a megoldást? Ki játszana az autoCommit-tal?
Itt, mint mindig, a legmeglepőbb változat bizonyul helyesnek. Ha esetleg kikapcsolod az autoCommit-ot, az segíteni fog. Miért van ez? A tudomány erről nem tud.
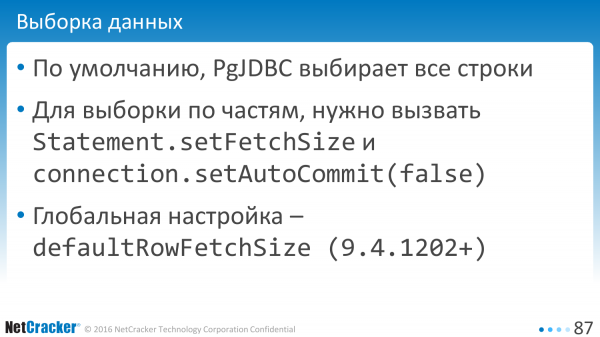
De alapértelmezés szerint minden kliens, amely csatlakozik a Postgres adatbázishoz, teljes adatokat választ ki. A PgJDBC ezen a téren nem kivétel, minden sort választ.
Van egy variáció a FetchSize témájára, azaz egy adott statement szintjén jelezhetjük, hogy itt, kérlek, válassza ki az adatokat 10, 50-es csoportokban. De ez nem működik, amíg nem kapcsolod ki az autoCommit-ot. Amint kikapcsoltad az autoCommit-ot – elkezd működni.
De a kódot végigjárni és mindenhol setFetchSize-t beállítani – ez kényelmetlen. Ezért készítettünk egy olyan beállítást, ami az egész kapcsolatra vonatkozó alapértelmezett értéket fogja megadni.
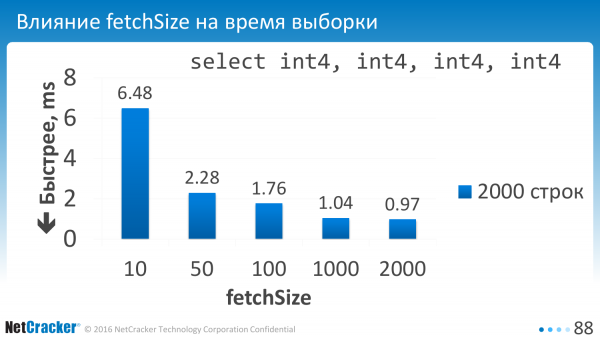
Nos, ezt mondtuk. Beállítottuk a paramétert. És mi lett az eredmény? Ha kicsire választunk, például 10 sorra, akkor elég magasak a ráfordítások. Ezért ezt az értéket körülbelül százra kellene állítani.
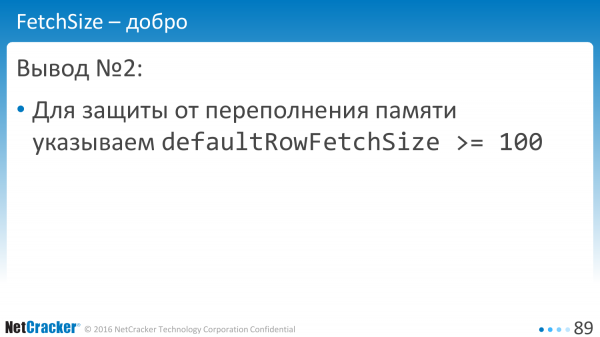
Ideálisan, persze, byte-ban is korlátozni kellene, de a recept a következő: állítsuk be a defaultRowFetchSize-t százhúszra és örüljünk.
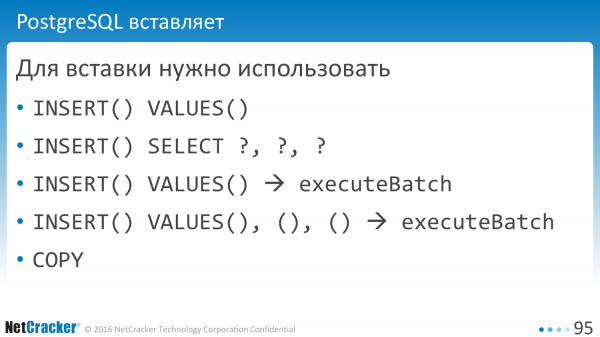
Most térjünk át az adatok beszúrására. A beszúrás egyszerűbb, vannak különböző lehetőségek. Például, INSERT, VALUES. Ez egy jó lehetőség. Mondhatjuk, hogy 'INSERT SELECT'. A gyakorlatban ez egy és ugyanaz. Nincs különbség a teljesítményben.
A könyvek azt mondják, hogy Batch utasítást kell végrehajtani, a könyvek azt mondják, hogy bonyolultabb parancsokat is végrehajthatunk több zárójel között. És a Postgres-ban van egy csodálatos funkció – a COPY, azaz ezt gyorsabban tudjuk végrehajtani.

Ha megmérjük, akkor újabb érdekes felfedezéseket tehetünk. Hogyan szeretnénk, hogy ez működjön? Szeretnénk, ha nem kellene parszolni és felesleges parancsokat végrehajtani.
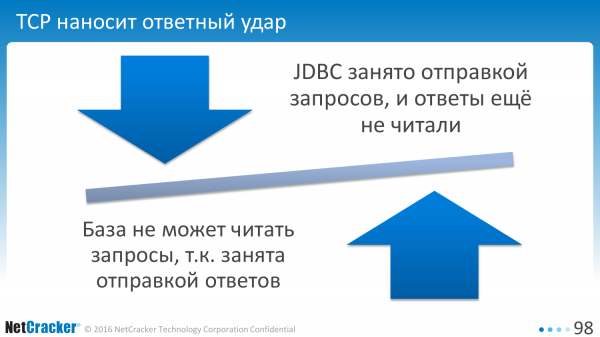
A gyakorlatban a TCP ezt nem teszi lehetővé. Ha az ügyfél éppen a kérés elküldésével foglalkozik, akkor az adatbázis a válaszok visszaküldésére tett kísérletekben nem olvassa el a kérdéseket. Végső soron az ügyfél vár az adatbázisra, amíg az elolvassa a kérdést, míg az adatbázis vár az ügyfélre, amíg elolvassa a választ.
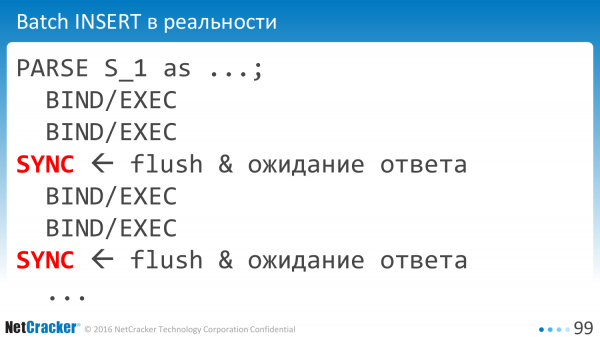
Ezért az ügyfélnek időnként szinkronizáló csomagokat kell küldenie. Felesleges hálózati interakciók, felesleges időveszteség.
 Minél többet adunk hozzá, annál rosszabb lesz. A meghajtó meglehetősen pesszimista, és elég gyakran, körülbelül 200 soronként, méretétől és hasonlóktól függően, hozzáadja ezeket.
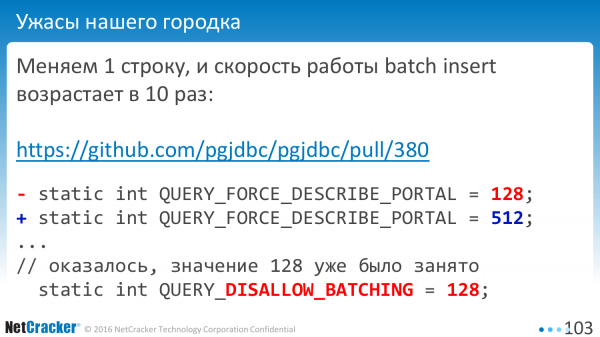
Előfordul, hogy csak egy sort módosítunk, és tízszer gyorsabbá válik minden. Ez néha megtörténik. Miért? Általában azért, mert egy konstans már meglévő volt valahol. És a '128' érték azt jelentette – ne használj batching-et.
Jó, hogy ez nem került be az hivatalos verzióba. Felfedeztük, mielőtt elkezdtük volna a kiadást. Az összes érték, amit említek, a modern verziókon alapul.
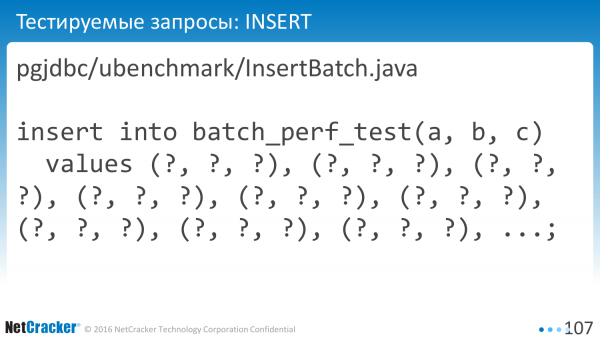
Nézzük meg. Az egyszerű InsertBatch-t mérjük. A többszörös InsertBatch-t mérjük, azaz ugyanaz, de sok values-szal. Trükkös lépés. Nem mindenki tudja ezt, de ez egy egyszerű lépés, sokkal könnyebb, mint a COPY.
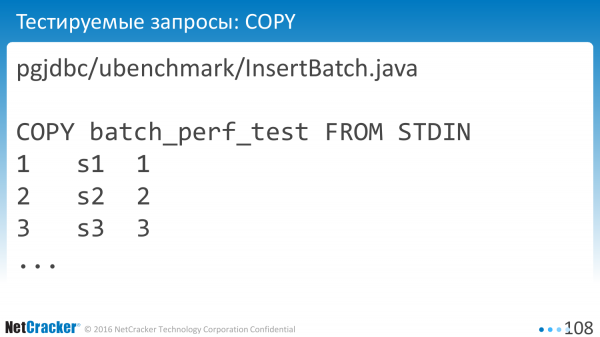
Lehet COPY-t használni.
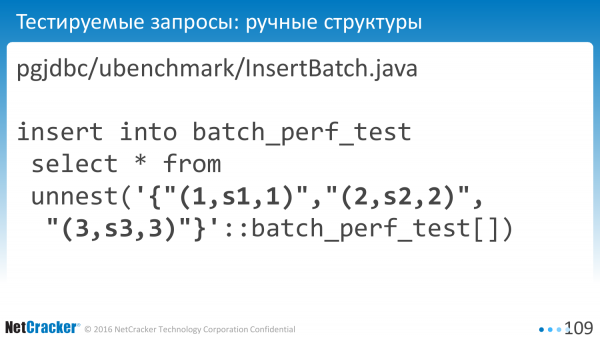
És ezt a struktúrákon is meg lehet csinálni. Be kell jelenteni a User alapértelmezett típust, átadni egy tömböt, és közvetlenül INSERT-álni a táblába.
Ha megnyitja a következő linket: pgjdbc/ubenchmsrk/InsertBatch.java, akkor ez a kód megtalálható a GitHub-on. Meg lehet nézni, hogy pontosan milyen lekérdezések generálódnak ott. Nem ez a lényeg.
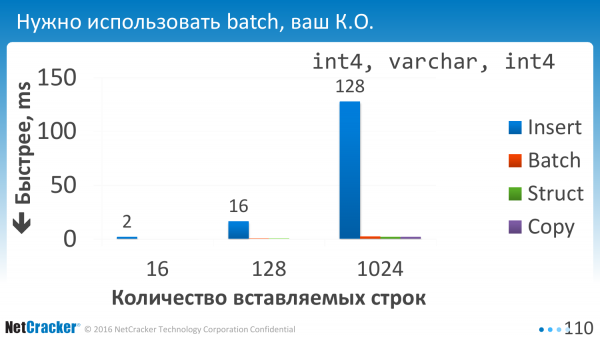
Elindítottuk. És az első dolog, amit észrevettünk, hogy a batch használata elengedhetetlen. Minden batch-elési változat nullának számít, azaz a végrehajtási idő szinte nulla egy nagyobb végrehajtáshoz képest.
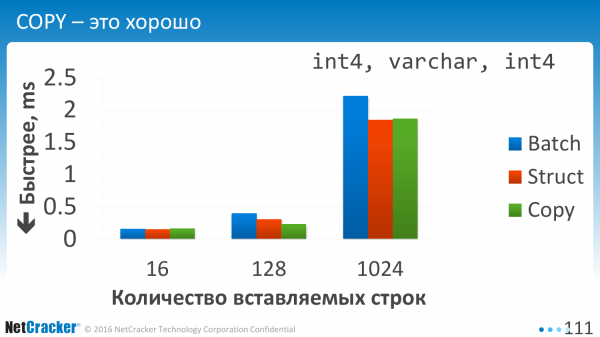
Adatokat illesztünk be. Éppen egy egyszerű táblázatról van szó. Három oszlop. És mit látunk itt? Látjuk, hogy mindhárom változat körülbelül hasonló. És a COPY természetesen a legjobb.
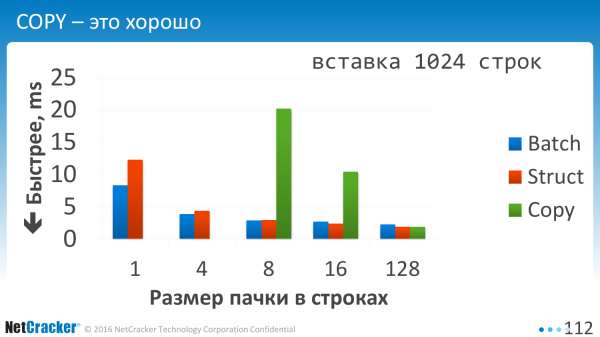
Ez amikor darabokban illesztünk be. Amikor azt mondtuk, hogy egy érték VALUES, két érték VALUES, három érték VALUES, vagy ha ott 10-et vesszük vesszővel elválasztva. Most éppen vízszintesen. 1, 2, 4, 128. Egyértelmű, hogy a Batch Insert, ami kék színnel van ábrázolva, sokkal könnyebb lesz tőle. Azaz, amikor egyesével illeszt be, vagy akár négyet is, akkor ez kétszer olyan jobb, csak attól, hogy a VALUES-ba egy kicsit többet betettünk. Kevesebb EXECUTE művelet.
A COPY használata kis mennyiségekben rendkívül nem célszerű. Az első kettőt még fel sem rajzoltam. Azok az ég felé mutatnak, vagyis ezek a zöld számok a COPY számára.
A COPY-t akkor kell használni, ha az adatmennyiség legalább több mint száz sor. A kapcsolat megnyitására fordított költségek magasak. Őszintén szólva, ebbe az irányba nem mélyedtem el. A batch-t optimalizáltam, a COPY-t nem.
Mit teszünk ezután? Megmértük. Értjük, hogy vagy struktúrákat, vagy egy ügyes batch-et kell használnunk, amely egyesíti a különböző értékeket.
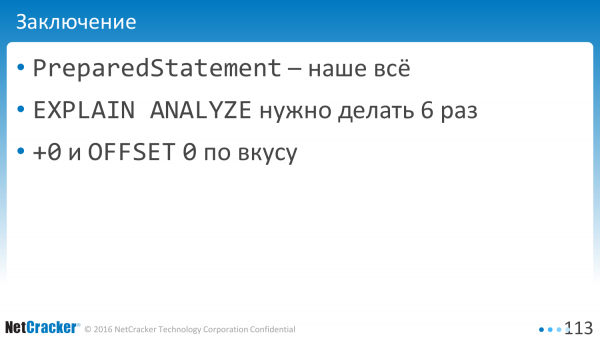
Mi az, amit ki kell emelni a mai előadásból?
- A PreparedStatement a mi mindenünk. Nagyon sokat hozzájárul a teljesítményhez. Nagy tartály méretű pluszokat ad.
- És 6 alkalommal kell EXPLAIN ANALYZE-t végezni.
- És az OFFSET 0-át kell hígítani, és olyan trükkökkel, mint a +0, hogy kezeljük a problémás lekérdezések megmaradó százalékát.
Forrás: habr.com
