

Valószínűleg senki számára nem titok, hogy az elmúlt év az Apache Hadoop számára a nagy változások éve volt. Tavaly a Cloudera és a Hortonworks összeolvadása (gyakorlatilag a második megszívása) történt, míg a Mapr, súlyos pénzügyi problémái miatt, a Hewlett Packardnak lett eladva. Ha néhány évvel ezelőtt a helyszíni telepítések esetében a választás gyakran a Cloudera és a Hortonworks között kellett, ma sajnos már nincs ilyen választási lehetőségünk. A meglepetés az is, hogy a Cloudera februártól bejelentette, hogy leállítja disztribúciójának bináris kiadását a nyilvános tárolóban, és mostantól csak előfizetés ellenében érhetők el. Természetesen a 2019 végéig kiadott legfrissebb CDH és HDP verziók letölthetők, és ezekhez egy-két évig támogatást kínálnak. De mi a teendő ezután? Akik korábban előfizettek, azok számára nem változott semmi. Azok számára pedig, akik nem szeretnének a disztribúció fizetős verziójára váltani, de friss verziókat, patcheket és egyéb frissítéseket szeretnének kapni, ezt a cikket készítettük el. Itt megvizsgáljuk a kialakult helyzetből való lehetséges kiutakat.
A cikk inkább áttekintő jellegű. Nem lesz összahasonlítás a disztribúciók között, és részletes értékelésük sem, valamint telepítési és beállítási receptek sem lesznek. De miről lesz szó? Röviden bemutatjuk az Arenadata Hadoop disztribúciót, amely joggal érdemelte ki figyelmünket megfizethetősége miatt, ami ma már nagy ritkaságnak számít. Aztán pedig a Vanilla Hadoopról fogunk beszélni, főleg arról, hogyan készíthetjük el az Apache Bigtop segítségével. Készen áll? Akkor üdvözöljük a bejegyzés alatt.
Arenadata Hadoop
Ez egy teljesen új, és egyelőre még alig ismert hazai fejlesztésű disztribúció. Sajnos jelenleg a Habron csak .
több információt található az hivatalos projektről. A disztribúció legújabb verziói a 3.1.2-es Hadoopra épülnek a 3. változathoz, és a 2.8.5-re a 2. változathoz.
A roadmap információkat .
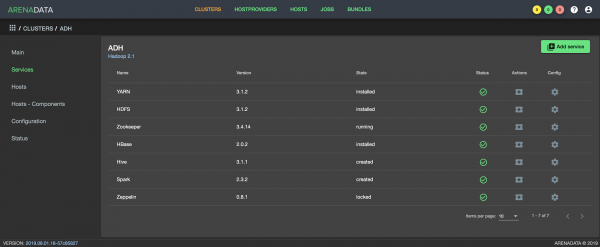
Arenadata Cluster Manager felület
Az Arenadata kulcsfontosságú terméke , amelyet különféle szoftvermegoldások telepítésére, konfigurálására és monitorozására használnak. Az ADCM ingyenesen terjesztésre kerül, funkcióit pedig bővíthetjük olyan bundle-ök hozzáadásával, amelyek ansible-playbookokat tartalmaznak. A bundleket két típusra osztják: enterprise és community. Az utóbbiak ingyenesen letölthetők az Arenadata webhelyéről. Ezen kívül lehetőség van saját bundle kifejlesztésére és az ADCM-hez csatlakoztatására.
A Hadoop 3 telepítéséhez és kezeléséhez community verziójú bundle javasolt az ADCM-mel együtt, míg a Hadoop 2-höz csak mint alternatíva áll rendelkezésre. A csomagokhoz kapcsolódó tárolók nyilvános hozzáféréssel rendelkeznek, a csomagokat pedig a szokásos módon tölthetjük le és telepíthetjük a klaszter minden komponensére. Összességében a disztribúció meglehetősen érdekesnek tűnik. Biztos vagyok benne, hogy vannak, akik hozzászoktak az olyan megoldásokhoz, mint a Cloudera Manager és az Ambari, és akiket vonz az ADCM. Valakinek hatalmas előny lesz az is, hogy a disztribúció tartozik az importálás helyettesítése céljából.
Ha a hátrányokról beszélünk, akkor azok megegyeznek a többi Hadoop disztribúció hátrányaival. Nevezetesen:
- Az úgynevezett „vendor lock-in”. A Cloudera és a Hortonworks példáján láttuk, hogy mindig van kockázat a vállalat politikájának megváltozására.
- Jelentős lemaradás az Apache upstream-től.
Vanilla Hadoop
Ahogy tudja, a Hadoop nem egy monolitikus termék, hanem valójában egy sor szolgáltatás a HDFS elosztott fájlrendszere körül. Kevés ember lesz elégedett csupán egy fájlközzétevő klaszterrel. Egyeseknek szükségük van Hive-ra, másoknak Presto-ra, míg mások gyakrabban használják a HBase-t és a Phoenix-et, míg a Spark is egyre népszerűbb. Az adatok orchestrálására és betöltésére néha Oozie, Sqoop és Flume található. Ha pedig a biztonság biztosításáról van szó, azonnal eszünkbe jut a Kerberos és a Ranger.
A Hadoop komponensek bináris verziói az egyes ökoszisztéma projektek webhelyein elérhetőek tarball formájában. Töltsd le és kezdj hozzá az installációnak, de egy feltétellel: a 'nyers' binárisokból történő csomagok saját kézi összeállítása mellett, amelyet valószínűleg szeretnél elvégezni, nem lesz semmiféle biztosítékod arra, hogy a letöltött verziók kompatibilisek egymással. Az előnyösebb megoldás az Apache Bigtop használata. A Bigtop lehetővé teszi a csomagok összeállítását az Apache maven-tárolókból, a tesztek futtatását és a csomagok összeállítását. De ami számunkra nagyon fontos, a Bigtop olyan verziókat fog összeállítani, amelyek közötti kompatibilitás biztosított. Erről beszélünk részletesebben a továbbiakban.
Apache Bigtop
Az Apache Bigtop egy eszköz, amely lehetővé teszi számos
nyílt forráskódú projekt, mint például a Hadoop és a Greenplum, összeállítását, csomagolását és tesztelését. A Bigtopnak számos
kiadása van. A cikk írásakor az utolsó stabil kiadás a 1.4 verzió volt,
míg a master 1.5-ön állt. Különböző kiadásokban más-más verziójú
komponensek találhatók. Például a 1.4 fő komponensei a Hadoop esetében a 2.8.5-ös verzióval rendelkeznek, míg a masterben
2.10.0. A támogatott komponensek összetétele is változik. Az elavult és
nem frissítendő elemek eltűnnek, és a helyükre újabb, keresettebb elemek lépnek, nem feltétlenül az Apache család tagjai.
Ezen kívül a Bigtopnak számos
forkja van. .
Mint teaser – azok számára, akik valaha kedvelik a Linux univerzumból származó projekteket, például a Gentoo-t és az LFS-t, nosztalgikusan kellemes élmény lehet ezzel a dologgal dolgozni, és felidézni azokat az 'időket', amikor mi magunk kerestük (sőt írtuk) az ebuildokat és rendszeresen újraépítettük a Mozilla-t új javításokkal.
Mint a téma olyanoknak szól, akik egykor élvezték az olyan Linux-projekteket, mint a Gentoo és az LFS. Talán nosztalgikus élmény lesz számukra, hogy újra felfedezzék ezt a rendszert, és felidézzék azokat az "aranykor" időszakokat, amikor maguk keresték (vagy meg is írták) a build fájlokat, és rendszeresen újraépítették a Firefoxot új javításokkal.
A Bigtop nagy előnye a nyitottság és a rugalmas eszközök, amelyekre épül. Alapját a Gradle és az Apache Maven alkotja. A Gradle jól ismert eszköz, amelyet a Google az Android összegyűjtésére használ. Rugalmas, és ahogy mondani szokták, „harci teszten átment”. A Maven az Apache hivatalos eszköze a projektek építésére, és mivel a legtöbb termékét éppen Maven-en keresztül adják ki, így ez is nélkülözhetetlen. Figyelmet érdemel a POM (project object model) – az a „fundamentális” xml-fájl, amely mindent leír, ami a Maven működéséhez szükséges a projektjével, köré épül az egész munka. Kifejezetten
a Maven részeiben merülnek fel azok az akadályok, amelyekkel általában először találkoznak a Bigtop használatakor.
Gyakorlat
Szóval, honnan érdemes kezdeni? Elmegyünk a letöltési oldalra, és letöltjük a legutolsó stabil verziót archívum formájában. Ott további bináris artefaktumokat is találhatunk, amelyeket a Bigtop állított össze. Egyébként a népszerű csomagkezelők közül a YUM és az APT támogatott.
Alternatív megoldásként közvetlenül letölthetjük az utolsó stabil kiadást a következő linken:
github:
$ git clone --branch branch-1.4 https://github.com/apache/bigtop.gitKlónozás a „bigtop”-ba...
remote: Obiektumok összeszámlálása: 46, kész.
remote: Objektumok megszámlálása: 100% (46/46), kész.
remote: Objektumok tömörítése: 100% (41/41), kész.
remote: Összesen 40217 (delta 14), újrahasznosítva 10 (delta 1), pack-reused 40171
Objektumok megszerzése: 100% (40217/40217), 43.54 MiB | 1.05 MiB/s, kész.
Változások meghatározása: 100% (20503/20503), kész.
Fájlok frissítése: 100% (1998/1998), kész.
A létrejött mappa ./bigtop körülbelül így néz ki:
. /bigtop-bigpetstore — bemutató alkalmazások, szintetikus példák
. /bigtop-ci — CI eszköztár, jenkins
. /bigtop-data-generators — adatok generálása, szintetikus, smoke teszteléshez stb.
. /bigtop-deploy — telepítési eszközök
. /bigtop-packages — konfigurációk, szkriptek, javítások az építéshez, az eszköz fő része
. /bigtop-test-framework — tesztelési keretrendszer
. /bigtop-tests — maguk a tesztek, terhelési és smoke
. /bigtop_toolchain — építési környezet, az eszköz működéséhez szükséges környezet előkészítése
. /build — építési munkakönyvtár
. /dl — letöltött forráskódok könyvtára
. /docker — docker-képek építése, tesztelés
. /gradle — gradle konfiguráció
. /output – könyvtár, ahová az építési artefaktumok kerülnek
. /provisioner — provisioning
A jelen szakaszban a legérdekesebb számunkra a fő konfiguráció . /bigtop/bigtop.bom, amelyben látjuk az összes támogatott komponenst a verziókkal. Itt tudjuk megadni egy másik termékverziót (ha esetleg ki szeretnénk próbálni egy másik összeállítást) vagy az összeállítás verzióját (például, ha jelentős javítást adtunk hozzá).
Nagy érdeklődés övezi a könyvtárat .\/bigtop\/bigtop-packages, amely közvetlen kapcsolatban áll a komponensek és csomagok összeállítási folyamatával.
Tehát, letöltöttük a archívumot, kicsomagoltuk, vagy készítettünk egy klónt a githubon, akkor kezdhetjük az összeállítást?
Nem, előbb készítsük elő a környezetet.
Környezet előkészítése
Itt egy kis kitérőre van szükség. Szinte bármilyen bonyolultabb termék összeállításához szükséges egy adott környezet — esetünkben ez a JDK, ugyanazok a megosztott könyvtárak, fejlécek stb., eszközök, például ant, ivy2 és még sok más. Az egyik lehetőség a Bigtop környezetének beszerzésére az, ha a kívánt komponenseket telepítjük az összeállító gazdagépre. Lehet, hogy tévedek a kronológiában, de úgy tűnik, hogy az 1.0 verziótól kezdve lehetőség nyílt a már előre konfigurált és elérhető docker-imagekben való összeállításra, amelyekkel itt ismerkedhetünk meg.
A környezet előkészítésével kapcsolatban van egy segédprogram — Puppet.
A következő parancsokat használhatjuk, a futtatás a gyökérkönyvtárból történik
az eszköz, .\/bigtop:
.\/gradlew toolchain\n.\/gradlew toolchain-devtools\n.\/gradlew toolchain-puppetmodules
Vagy közvetlenül a puppet-en keresztül:
puppet apply --modulepath=<path_to_bigtop> -e "include bigtop_toolchain::installer"\npuppet apply --modulepath=<path_to_bigtop> -e "include bigtop_toolchain::deployment-tools"\npuppet apply --modulepath=<path_to_bigtop> -e "include bigtop_toolchain::development-tools"Sajnos már ezen a ponton nehézségek léphetnek fel. Az általános tanács itt – használjon támogatott disztribúciót, friss állapotban az összeállító gazdagépen, vagy próbálja meg a docker-alapú utat.
Összeállítás
Mivel próbálhatjuk az összeállítást? A kérdésre a parancs kimenete adja meg a választ
.\/gradlew tasks A Package tasks szekcióban számos olyan termék található, amelyek a Bigtop végtermékei.
Ezeket a -rpm vagy -pkg-ind végződés alapján lehet azonosítani (docker alapú összeállítás esetén). Az esetünkben a legérdekesebb a Hadoop.
Próbáljuk meg végrehajtani az összeállítást a build-szerverünk környezetében:
.\/gradlew hadoop-rpm
A Bigtop automatikusan letölti a szükséges forrásokat, amelyek a konkrét komponenshez kellenek, és elkezdi az összeállítást. Így az eszköz működése a Maven és egyéb források tárolóira épül, tehát szüksége van internet-hozzáférésre.A Bigtop automatikusan letölti az adott komponenshez szükséges forráskódokat, és elindítja a buildelést. Így az eszköz működése a Maven-tárolókra és más forrásokra épül, tehát internet-hozzáférésre van szüksége.
A munka során standard kimenet keletkezik. Néha ebből és a hibaüzenetekből kiderül, mi ment rosszul. Máskor azonban további információra van szükség. Ilyen esetekben érdemes argumentumokat hozzáadni. --info vagy --debug, és hasznos lehet –stacktrace. Van egy kényelmes módszer az adathalmozásra a későbbi levelezőlistákhoz, amelynek kulcsa --scan.
Ezzel a bigtop összegyűjti az összes információt és a gradle-be helyezi, majd megad egy hivatkozást,
amin keresztül egy szakértő megértheti, miért nem sikerült a build.
Figyelembe kell venni, hogy ez az opció nyilvánossá teheti az Ön számára nem kívánt információkat, például felhasználóneveket, csomópontokat, környezeti változókat stb., így érdemes óvatosnak lenni.
Gyakran a hibák azoknak a szükséges összetevőknek a hiányából erednek, amelyek elengedhetetlenek a buildhez. Általában a probléma javítható egy javítócsomag létrehozásával az eredeti forráskód javítására, például egy cím módosításával a pom.xml fájlban a gyökérforráskódban. Ezt úgy kell megtenni, hogy létrehozzák és elhelyezik a megfelelő mappában .\/bigtop\/bigtop-packages\/src\/common\/oozie\/ javítócsomagként, például a következő formában patch2-fix.diff.
--- a\/pom.xml
+++ b\/pom.xml
@@ -136,7 +136,7 @@


central
- http:\/\/repo1.maven.org\/maven2
+ https:\/\/repo1.maven.org\/maven2

false
Valószínűleg, amikor ezt a cikket olvassa, a fent említett javítást Önnek nem kell elvégeznie.
Bármilyen javítócsomag vagy módosítás bevezetése esetén szükség lehet a build "visszaállítására" a tisztítók parancsával:
.\/gradlew hadoop-clean
> Task :hadoop_vardefines
> Task :hadoop-clean
BUILD SUCCESSFUL in 5s
2 actionable tasks: 2 executed
Ez a művelet visszaállítja az összes változtatást ennek az összetevőnek a buildjén, majd a buildet újra végrehajtja. Ezúttal próbáljuk meg összegyűjteni a projektet docker-image-ben:
.\/gradlew -POS=centos-7 -Pprefix=1.2.1 hadoop-pkg-ind
> Feladat :hadoop-pkg-ind
Az 1.2.1-es hadoop-pkg építése centos-7 alatt Docker környezetben...
+++ dirname .\/bigtop-ci\/build.sh
++ cd .\/bigtop-ci\/..
++ pwd
+ BIGTOP_HOME=\/tmp\/bigtop
+ '[' 6 -eq 0 ']'
+ [[ 6 -gt 0 ]]
+ key=--prefix
+ case $key in
+ PREFIX=1.2.1
+ shift
+ shift
+ [[ 4 -gt 0 ]]
+ key=--os
+ case $key in
+ OS=centos-7
+ shift
+ shift
+ [[ 2 -gt 0 ]]
+ key=--target
+ case $key in
+ TARGET=hadoop-pkg
+ shift
+ shift
+ [[ 0 -gt 0 ]]
+ '[' -z x ']'
+ '[' -z x ']'
+ '[' '' == true ']'
+ IMAGE_NAME=bigtop\/slaves:1.2.1-centos-7
++ uname -m
+ ARCH=x86_64
+ '[' x86_64 '!=' x86_64 ']'
++ docker run -d bigtop\/slaves:1.2.1-centos-7 \/sbin\/init
+
CONTAINER_ID=0ce5ac5ca955b822a3e6c5eb3f477f0a152cd27d5487680f77e33fbe66b5bed8
+ trap 'docker rm -f
0ce5ac5ca955b822a3e6c5eb3f477f0a152cd27d5487680f77e33fbe66b5bed8' EXIT
....
Sok kimenet
....
Írta: \/bigtop\/build\/hadoop\/rpm\/RPMS\/x86_64\/hadoop-2.8.5-1.el7.x86_64.rpm
Írta: \/bigtop\/build\/hadoop\/rpm\/RPMS\/x86_64\/hadoop-hdfs-2.8.5-1.el7.x86_64.rpm
Írta: \/bigtop\/build\/hadoop\/rpm\/RPMS\/x86_64\/hadoop-yarn-2.8.5-1.el7.x86_64.rpm
Írta: \/bigtop\/build\/hadoop\/rpm\/RPMS\/x86_64\/hadoop-mapreduce-2.8.5-1.el7.x86_64.rpm
Írta: \/bigtop\/build\/hadoop\/rpm\/RPMS\/x86_64\/hadoop-hdfs-namenode-2.8.5-1.el7.x86_64.rpm
Írta: \/bigtop\/build\/hadoop\/rpm\/RPMS\/x86_64\/hadoop-hdfs-secondarynamenode-2.8.5-
1.el7.x86_64.rpm
Írta: \/bigtop\/build\/hadoop\/rpm\/RPMS\/x86_64\/hadoop-hdfs-zkfc-2.8.5-1.el7.x86_64.rpm
Írta: \/bigtop\/build\/hadoop\/rpm\/RPMS\/x86_64\/hadoop-hdfs-journalnode-2.8.5-
1.el7.x86_64.rpm
Írta: \/bigtop\/build\/hadoop\/rpm\/RPMS\/x86_64\/hadoop-hdfs-datanode-2.8.5-1.el7.x86_64.rpm
Írta: \/bigtop\/build\/hadoop\/rpm\/RPMS\/x86_64\/hadoop-httpfs-2.8.5-1.el7.x86_64.rpm
Írta: \/bigtop\/build\/hadoop\/rpm\/RPMS\/x86_64\/hadoop-yarn-resourcemanager-2.8.5-
1.el7.x86_64.rpm
Írta: \/bigtop\/build\/hadoop\/rpm\/RPMS\/x86_64\/hadoop-yarn-nodemanager-2.8.5-
1.el7.x86_64.rpm
Írta: \/bigtop\/build\/hadoop\/rpm\/RPMS\/x86_64\/hadoop-yarn-proxyserver-2.8.5-
1.el7.x86_64.rpm
Írta: \/bigtop\/build\/hadoop\/rpm\/RPMS\/x86_64\/hadoop-yarn-timelineserver-2.8.5-
1.el7.x86_64.rpm
Írta: \/bigtop\/build\/hadoop\/rpm\/RPMS\/x86_64\/hadoop-mapreduce-historyserver-2.8.5-
1.el7.x86_64.rpm
Írta: \/bigtop\/build\/hadoop\/rpm\/RPMS\/x86_64\/hadoop-client-2.8.5-1.el7.x86_64.rpm
Írta: \/bigtop\/build\/hadoop\/rpm\/RPMS\/x86_64\/hadoop-conf-pseudo-2.8.5-1.el7.x86_64.rpm
Írta: \/bigtop\/build\/hadoop\/rpm\/RPMS\/x86_64\/hadoop-doc-2.8.5-1.el7.x86_64.rpm
Írta: \/bigtop\/build\/hadoop\/rpm\/RPMS\/x86_64\/hadoop-libhdfs-2.8.5-1.el7.x86_64.rpm
Írta: \/bigtop\/build\/hadoop\/rpm\/RPMS\/x86_64\/hadoop-libhdfs-devel-2.8.5-1.el7.x86_64.rpm
Írta: \/bigtop\/build\/hadoop\/rpm\/RPMS\/x86_64\/hadoop-hdfs-fuse-2.8.5-1.el7.x86_64.rpm
Írta: \/bigtop\/build\/hadoop\/rpm\/RPMS\/x86_64\/hadoop-debuginfo-2.8.5-1.el7.x86_64.rpm
+ umask 022
+ cd \/bigtop\/build\/hadoop\/rpm\/\/BUILD
+ cd hadoop-2.8.5-src
+ \/usr\/bin\/rm -rf \/bigtop\/build\/hadoop\/rpm\/BUILDROOT\/hadoop-2.8.5-1.el7.x86_64
Futtatás (%clean): \/bin\/sh -e \/var\/tmp\/rpm-tmp.uQ2FCn
+ exit 0
+ umask 022
Futtatás (--clean): \/bin\/sh -e \/var\/tmp\/rpm-tmp.CwDb22
+ cd \/bigtop\/build\/hadoop\/rpm\/\/BUILD
+ rm -rf hadoop-2.8.5-src
+ exit 0
[ant:touch] Létrehozva: \/bigtop\/build\/hadoop\/.rpm
:hadoop-rpm (Szál[Feladat végrehajtó a ':',5,main]) befejezve. Időtartam: 38 perc 1.151 másodperc.
:hadoop-pkg (Szál[Feladat végrehajtó a ':',5,main]) elindult.
> Feladat :hadoop-pkg
A ':hadoop-pkg' feladat nincs naprakészen, mert:
A feladat nem deklarált kimenetet, annak ellenére, hogy végrehajtott akciókat.
:hadoop-pkg (Szál[Feladat végrehajtó a ':',5,main]) befejezve. Időtartam: 0.0 másodperc.
ÉPÍTÉS SIKERES 40m 37s alatt
6 végrehajtható feladat: 6 végrehajtva
+ RESULT=0
+ mkdir -p output
+ docker cp
ac46014fd9501bdc86b6c67d08789fbdc6ee46a2645550ff6b6712f7d02ffebb:\/bigtop\/build .
+ docker cp
ac46014fd9501bdc86b6c67d08789fbdc6ee46a2645550ff6b6712f7d02ffebb:\/bigtop\/output .
+ docker rm -f ac46014fd9501bdc86b6c67d08789fbdc6ee46a2645550ff6b6712f7d02ffebb
ac46014fd9501bdc86b6c67d08789fbdc6ee46a2645550ff6b6712f7d02ffebb
+ '[' 0 -ne 0 ']'
+ docker rm -f ac46014fd9501bdc86b6c67d08789fbdc6ee46a2645550ff6b6712f7d02ffebb
Hiba: Nincs ilyen tartály:
ac46014fd9501bdc86b6c67d08789fbdc6ee46a2645550ff6b6712f7d02ffebb
ÉPÍTÉS SIKERES 41m 24s alatt
1 végrehajtható feladat: 1 végrehajtva
A telepítés CentOS alatt zajlott, de Ubuntu alatt is elvégezhető:
.\/gradlew -POS=ubuntu-16.04 -Pprefix=1.2.1 hadoop-pkg-indA különböző Linux disztribúciókhoz csomagok összeállítása mellett az eszköz képes tároló létrehozására a létrehozott csomagokkal, például:
.\/gradlew yumEmellett meg lehet említeni a smoke-teszteket és a dockerben való telepítést.
Hozzon létre egy három nódusú klasztert:
.\/gradlew -Pnum_instances=3 docker-provisionerFuttassa a smoke-teszteket a három nódusú klaszterben:
.\/gradlew -Pnum_instances=3 -Prun_smoke_tests docker-provisionerTörölje a klasztert:
.\/gradlew docker-provisioner-destroySzerezze meg a parancsokat a docker-konténerek belső eléréséhez:
.\/gradlew docker-provisioner-sshMutassa a státuszt:
.\/gradlew docker-provisioner-statusA Telepítési feladatokról részletesebben olvashat a dokumentációban.
A tesztekről beszélve, elég nagy számú van belőlük, főleg smoke és integrációs tesztek. Az elemzésük meghaladja ennek a cikknek a kereteit. Csak annyit mondhatok, hogy a disztribúció összeállítása nem olyan nehéz feladat, mint ahogyan első pillantásra tűnik. Minden olyan komponenst, amit a produkciónkban használunk, sikerült összeállítani és teszteken keresztülvinni, és nem volt probléma a telepítésükkel vagy alapvető műveletek végrehajtásával a tesztkörnyezetben.
A Bigtop által biztosított összes komponens mellett lehetőség van bármi mást hozzáadni, még saját szoftverfejlesztést is. Mindez remekül automatizálható és belefér a CI/CD koncepcióba.
Zárás
Nyilvánvaló, hogy egy ilyen módon összeállított disztribúciót nem szabad azonnal a produkciós környezetbe küldeni. Fontos megérteni, hogy ha valódi szükség van saját disztribúció összeállítására és fenntartására, akkor ez pénzbe és időbe kerül.
Ennek ellenére helyes megközelítéssel és egy profi csapattal el lehet kerülni a kereskedelmi megoldásokat.
Fontos megemlíteni, hogy a Bigtop projekt fejlesztésre szorul, és úgy tűnik, jelenleg nincs aktív fejlesztés. Nem világos a Hadoop 3 megjelenésének kilátása sem. Ha valódi szükség van a Hadoop 3 összeállítására, érdemes megfontolni az Arenadata megoldását, amely a standard komponensek mellett számos további komponenst is tartalmaz (Ranger, Knox, NiFi). Ami a Rostelekomot illeti, a Bigtop a mai napon egy a megfontolt lehetőségek közül számunkra. Hogy döntenek-e mellette vagy sem, az idő fogja megmutatni.
Appendix
Ami a Rostelekomot illeti, a Bigtop az egyik lehetőség, amelyet jelenleg mérlegelünk. Hogy végül így döntünk-e, azt majd az idő megmutatja.
Appendix
Egy új komponens bekapcsolásához hozzá kell adni a leírását a bigtop.bom-hoz és a ./bigtop-packages-hoz. Próbálkozhatunk úgy, hogy a meglévő komponensek alapján dolgozunk. Próbálja megérteni. Nem olyan nehéz, mint elsőre tűnik.
Mit gondoltok? Örülnénk, ha megláthatnánk a véleményeteket a hozzászólásokban, és köszönjük a figyelmet!
A cikket a „Rostelecom” adatkezelő csapata készítette.
Forrás: habr.com
